Article original
The Marginal Value of Adaptive Gradient Methods in Machine Learning
- Publication
- NeurIPS 2017Conférence
- Premier dépôt sur arXiv
- arXiv:1705.08292
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersmarginalvalue2017,
  title = {{The Marginal Value of Adaptive Gradient Methods in Machine Learning}},
  author = {Ashia C. Wilson and Rebecca Roelofs and Mitchell Stern and Nathan Srebro and Benjamin Recht},
  year = {2017},
  eprint = {1705.08292},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1705.08292}
}
« These results suggest that practitioners should reconsider the use of adaptive methods to train neural networks. »
C'est la dernière phrase du résumé de l'article, qui invite à reconsidérer l'usage des méthodes adaptatives pour entraîner les réseaux de neurones.
En mai 2017, Adam n'a guère plus de deux ans, et l'introduction de l'article note déjà qu'il est l'algorithme par défaut de nombreux frameworks de deep learning. Deux idées circulaient alors, l'une que les méthodes adaptatives comme AdaGrad, RMSProp et Adam convergent vite, l'autre qu'elles ne demandent presque aucun réglage. Ashia Wilson, Rebecca Roelofs, Mitchell Stern et Benjamin Recht, de Berkeley, et Nathan Srebro, du TTIC, soumettent ces deux idées à l'examen.
Ils construisent d'abord un problème de classification simple, sur lequel SGD a un taux d'erreur de test nul alors que les méthodes adaptatives se trompent près d'une fois sur deux ; ils mènent ensuite des expériences en classification d'images, en modélisation du langage au niveau des caractères et sur deux types d'analyse syntaxique, et concluent à chaque fois qu'un SGD bien réglé l'emporte.
Cette note décortique d'abord cet exemple construit, puis les expériences et la façon dont les hyperparamètres ont été réglés, et enfin la manière dont, deux ans plus tard, une autre équipe a fait disparaître l'écart avec le même code.
Définir le problème
Le nombre de paramètres d'un réseau profond dépasse généralement de loin le nombre d'exemples d'entraînement ; les solutions qui annulent la perte d'entraînement ne sont pas une seule, mais toute une étendue. Celle où l'optimiseur finit par s'arrêter dépend du chemin qu'il emprunte ; des solutions également bonnes sur le jeu d'entraînement peuvent se comporter très différemment sur de nouvelles données.
L'article demande si, dans ce contexte, les méthodes adaptatives et SGD choisissent des solutions différentes, et si ces solutions généralisent différemment.
Pour les comparer, l'article écrit d'abord les différentes méthodes dans un même cadre. SGD suit directement le gradient ; les méthodes adaptatives multiplient le gradient par l'inverse d'une matrice diagonale,
Le choix des détermine s'il s'agit d'AdaGrad, de RMSProp ou d'Adam ; le terme de momentum s'ajoute à part. SGD correspond à , et utilise la géométrie d'origine de l'espace des paramètres ; les méthodes adaptatives, elles, donnent à chaque coordonnée sa propre règle graduée, en fonction des gradients passés.
Résoudre le problème
SGD trouve la solution de norme minimale
Commençons par le cas le plus simple, une classification binaire par moindres carrés :
Quand , dès qu'une solution annule la perte, il y en a une infinité.
Chaque gradient de SGD est de la forme , et appartient à l'espace engendré par les lignes de . En partant de et en n'utilisant que des combinaisons linéaires des gradients et des itérés précédents, on ne quitte jamais cet espace. Dans cet espace, une seule solution satisfait , ; c'est justement la solution de plus petite norme , et aussi celle de plus grande marge (margin).
SGD, le momentum, SGD par mini-lots, Nesterov, et même la méthode du gradient conjugué aboutissent donc tous au même point. D'après l'article, que la descente de gradient trouve naturellement la solution de marge maximale est une heureuse surprise.
Les méthodes adaptatives trouvent la solution des signes
Le dénominateur des méthodes adaptatives diffère d'une coordonnée à l'autre, et la contrainte de l'espace des lignes disparaît. Dans le cas général, il est difficile de calculer où elles convergent ; l'article choisit un cas particulier calculable (Lemma 3.1) :
S'il existe un scalaire tel que , alors, en partant de , AdaGrad, Adam et RMSProp convergent tous vers l'unique solution .
L'idée de la preuve est directe. Quand est proportionnel à , le gradient est proportionnel à , et le dénominateur à ; en divisant l'un par l'autre, la mise à jour a la même amplitude sur chaque coordonnée, et ne diffère que par le signe. Après chaque pas, reste donc proportionnel à , et la conclusion suit par récurrence.
Autrement dit, dans ce cas particulier, les méthodes adaptatives traitent toutes les caractéristiques comme également importantes, et tous les poids ont la même valeur absolue. Selon l'article, elles convergent vers des solutions de petite norme , tandis que SGD converge vers des solutions de petite norme .
Construire des données qui les piègent
L'article conçoit ensuite un jeu de données qui transforme cette différence en taux d'erreur de test.
L'étiquette de chaque exemple vaut avec une probabilité , et sinon. Le vecteur de caractéristiques est long ; on regarde séparément les trois premières dimensions et le reste :
- la 1re dimension est l'étiquette elle-même, ;
- les 2e et 3e dimensions valent toujours 1 ;
- au-delà, chaque exemple possède un segment de caractéristiques qui n'appartient qu'à lui, 1 caractéristique pour un exemple positif et 5 pour un exemple négatif, toutes de valeur 1.
Seule la 1re dimension est vraiment utile ; les 2e et 3e sont constantes, et les caractéristiques suivantes n'apparaissent chacune que sur un seul exemple. Sur le jeu d'entraînement, elles semblent très discriminantes, chacune « reconnaissant » un exemple donné, mais elles ne servent à rien sur un nouvel exemple.
Ce jeu de données satisfait justement la condition du Lemma 3.1, avec . Prenons 10 exemples d'entraînement (6 positifs, 4 négatifs) et faisons réellement le calcul. En partant de , la descente de gradient et Adam annulent tous deux la perte d'entraînement, et les poids appris sont les suivants :
| Caractéristique | SGD | Adam |
|---|---|---|
| 1re dimension (étiquette) | 0.756 | 0.25 |
| 2e et 3e dimensions (constantes) | 0.087 | 0.25 |
| Caractéristique propre d'un exemple positif | 0.070 | 0.25 |
| Caractéristique propre d'un exemple négatif | −0.084 | −0.25 |
Calcul fait pour cette note. La colonne SGD donne la solution de norme minimale ; la descente de gradient itérée jusqu'à convergence donne le même résultat que la solution analytique. La colonne Adam est obtenue avec les par défaut et un taux d'apprentissage de , sur vingt mille pas ; AdaGrad donne les mêmes poids.
SGD place l'essentiel du poids sur la 1re dimension. Adam donne à chaque caractéristique un poids de même amplitude, dont le signe suit la relation de cette caractéristique avec l'étiquette sur le jeu d'entraînement.
Arrive maintenant un nouvel exemple. Ses caractéristiques propres sont entièrement nouvelles, jamais vues à l'entraînement ; seules les trois premières dimensions recoupent :
- SGD : le score vaut . Un exemple positif obtient , un négatif ; les deux sont bien classés.
- Adam : le score vaut . Un exemple positif obtient , un négatif ; les deux sont classés positifs.
Sur ce jeu de données, les méthodes adaptatives classent positif tout exemple jamais vu, et leur taux d'erreur de test est la proportion d'exemples négatifs, . Plus est proche de , plus ce taux approche la moitié ; celui de SGD est nul. L'annexe en donne aussi une version où les exemples sont tirés d'une distribution fixe, avec la même conclusion.
La dimension de cet exemple n'a pas besoin d'être réellement infinie ; d'après l'article, dimensions suffisent, et le nombre de paramètres d'un réseau profond atteint souvent 25 fois le nombre d'exemples, ou plus. Selon l'interprétation des auteurs, les données réelles comportent souvent un petit nombre de caractéristiques fréquentes et vraiment utiles, et un grand nombre de caractéristiques creuses. Sur un jeu d'entraînement fini, les caractéristiques creuses semblent très bien distinguer les exemples, mais ce n'est que du surapprentissage.
Si l'on suit le mécanisme du Lemma 3.1 (c'est l'interprétation de cette note), le dénominateur des méthodes adaptatives vient des gradients passés de chaque coordonnée ; une caractéristique creuse, rarement présente, a un petit dénominateur, donc un pas relatif plus grand, et finit poussée jusqu'à un poids aussi grand que celui des caractéristiques vraiment utiles, ce qui aggrave justement le problème.
Cette construction a ses prérequis. Elle exige de partir de , avec des données ayant la structure particulière , et l'analyse retire le du dénominateur. Elle démontre que « les méthodes adaptatives peuvent très mal généraliser » ; quant à savoir si cela se produit sur les réseaux de neurones, c'est aux expériences de le dire.
Discussion
Dispositif expérimental
L'article compare deux méthodes non adaptatives (SGD, et heavy-ball avec un momentum fixé à 0.9, ci-après HB) et trois méthodes adaptatives (AdaGrad, RMSProp, Adam), plus une courbe d'Adam avec toutes ses valeurs par défaut. Les quatre tâches utilisent du code disponible en ligne, en modifiant le moins possible l'architecture et le prétraitement :
| Tâche | Modèle | Données |
|---|---|---|
| Classification d'images | VGG+BN+Dropout | CIFAR-10 |
| Modèle de langage au niveau des caractères | LSTM à 2 couches | Guerre et Paix |
| Analyse syntaxique discriminative | LSTM à 2 couches + feed-forward | Penn Treebank |
| Analyse syntaxique générative | LSTM à 3 couches | Penn Treebank |
D'après la Table 2 de l'article. Les quatre codes utilisent trois frameworks, Torch, DyNet et TensorFlow ; les deux premières tâches sont en Torch.
L'analyse syntaxique consiste à découper une phrase en un arbre imbriqué de propositions, de syntagmes et de mots. L'approche discriminative transforme la construction de l'arbre en prédiction d'une suite d'actions, évaluée par le F1 ; l'approche générative écrit l'arbre sous forme de séquence de parcours en profondeur, et le note comme le ferait un modèle de langage, évalué par la perplexité.
Chaque configuration est lancée 5 fois depuis une initialisation aléatoire. Le nombre d'époques est fixé à l'avance ; pour les tâches qui ont un jeu de validation, on retient la configuration au meilleur score de validation dans ce budget ; CIFAR-10 n'ayant pas de jeu de validation séparé, on y retient la configuration à la perte d'entraînement la plus basse.
Le réglage des hyperparamètres
Les auteurs constatent que les deux hyperparamètres les plus influents sont le taux d'apprentissage initial et le mode de décroissance ; ils ne règlent que ces deux-là, et gardent pour le reste les valeurs par défaut de chaque framework.
Le taux d'apprentissage est échantillonné en 5 points sur une échelle logarithmique. Si le meilleur point tombe en bordure, on ajoute des points vers l'extérieur jusqu'à ce que le meilleur soit au milieu ; par exemple, si l'on a essayé 2, 1, 0.5, 0.25 et 0.125 et que 2 est le meilleur, on essaie 4, puis 8 si 4 est meilleur. Il y a deux modes de décroissance :
- dev-decay : on garde le meilleur score de validation obtenu jusqu'ici ; si une époque ne le bat pas, on multiplie le taux d'apprentissage par ;
- fixed-decay : on multiplie par toutes les époques.
Les auteurs recommandent dev-decay quand on dispose d'un jeu de validation ; il a moins d'hyperparamètres, et ses résultats valent ceux de fixed-decay. L'annexe liste les taux d'apprentissage essayés pour chaque méthode. Sur CIFAR-10, par exemple, le meilleur taux de SGD est 0.5, celui d'Adam 0.0003, plus de trois fois plus petit que la valeur par défaut de 0.001.
CIFAR-10
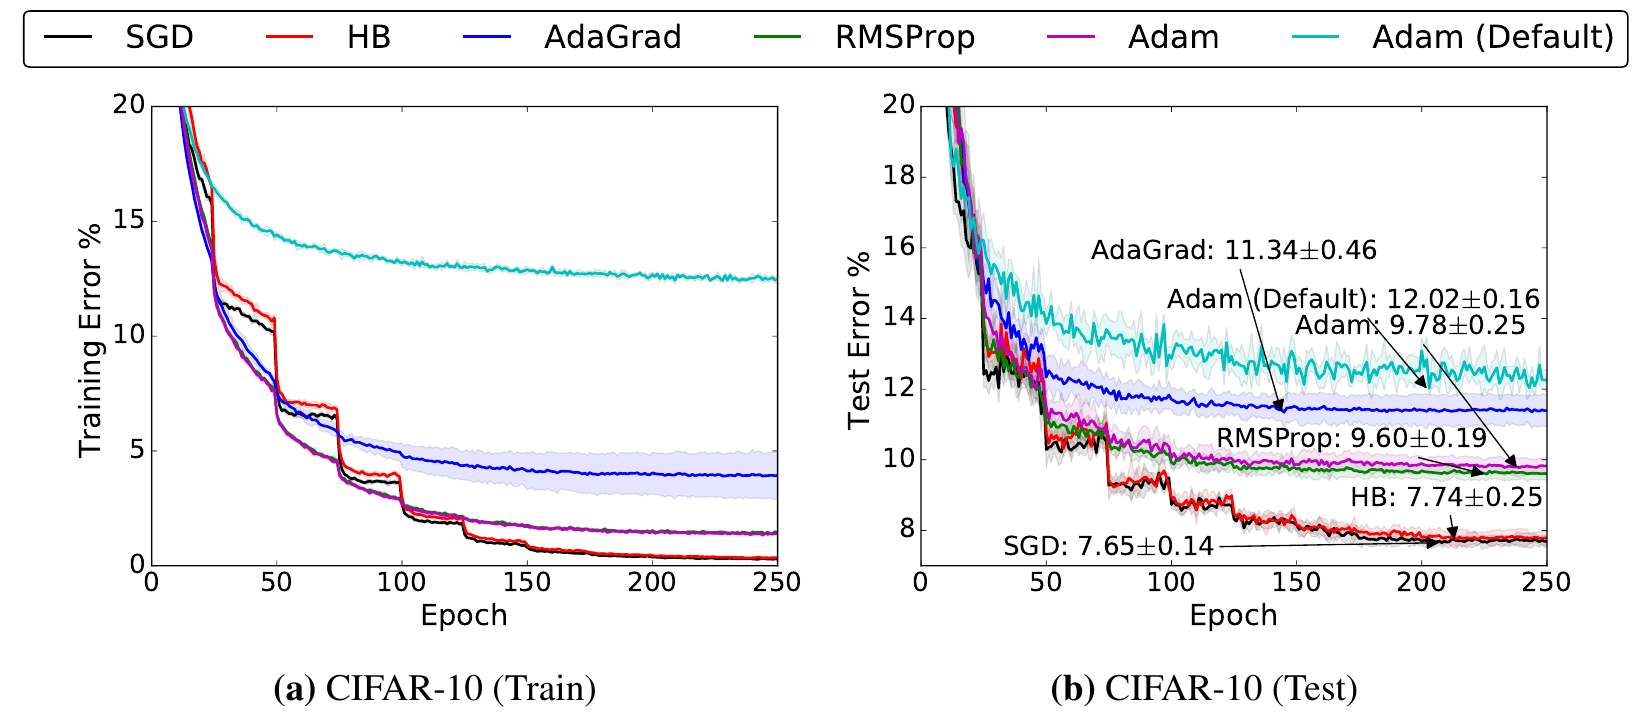
Le modèle est le VGG+BN+Dropout du blog de Torch, dont le taux d'erreur de test d'origine est de 7.55 %. Le graphique de droite indique le meilleur taux d'erreur de test de chaque méthode ; il est de pour SGD, de pour RMSProp, la meilleure des méthodes adaptatives, de pour Adam réglé, et de pour Adam par défaut.
Suivre l'évolution dans le temps est plus intéressant encore. Pendant les 50 premières époques, les méthodes adaptatives ont une nette avance en erreur d'entraînement, et font jeu égal avec SGD et HB en erreur de test. À partir de la 50e époque environ, les méthodes adaptatives ont encore une erreur d'entraînement plus basse, mais SGD et HB commencent à prendre l'avantage en test ; à la 100e époque, SGD et HB l'emportent à l'entraînement comme en test. Dans le graphique de gauche, SGD et HB descendent d'une marche toutes les 25 époques, sous l'effet de la décroissance du taux d'apprentissage ; Choi et al., qui ont refait cette expérience deux ans plus tard, ont noté comme réglage une multiplication du taux par 0.5 toutes les 25 époques. Aux mêmes endroits, les courbes des méthodes adaptatives sont bien plus plates.
Les auteurs ont aussi essayé d'augmenter le taux d'apprentissage des méthodes adaptatives. Elles progressent alors bien pendant les 50 premières époques, mais stagnent ensuite encore davantage, et aucun mode de décroissance ne les rattrape.
Les trois tâches de langage
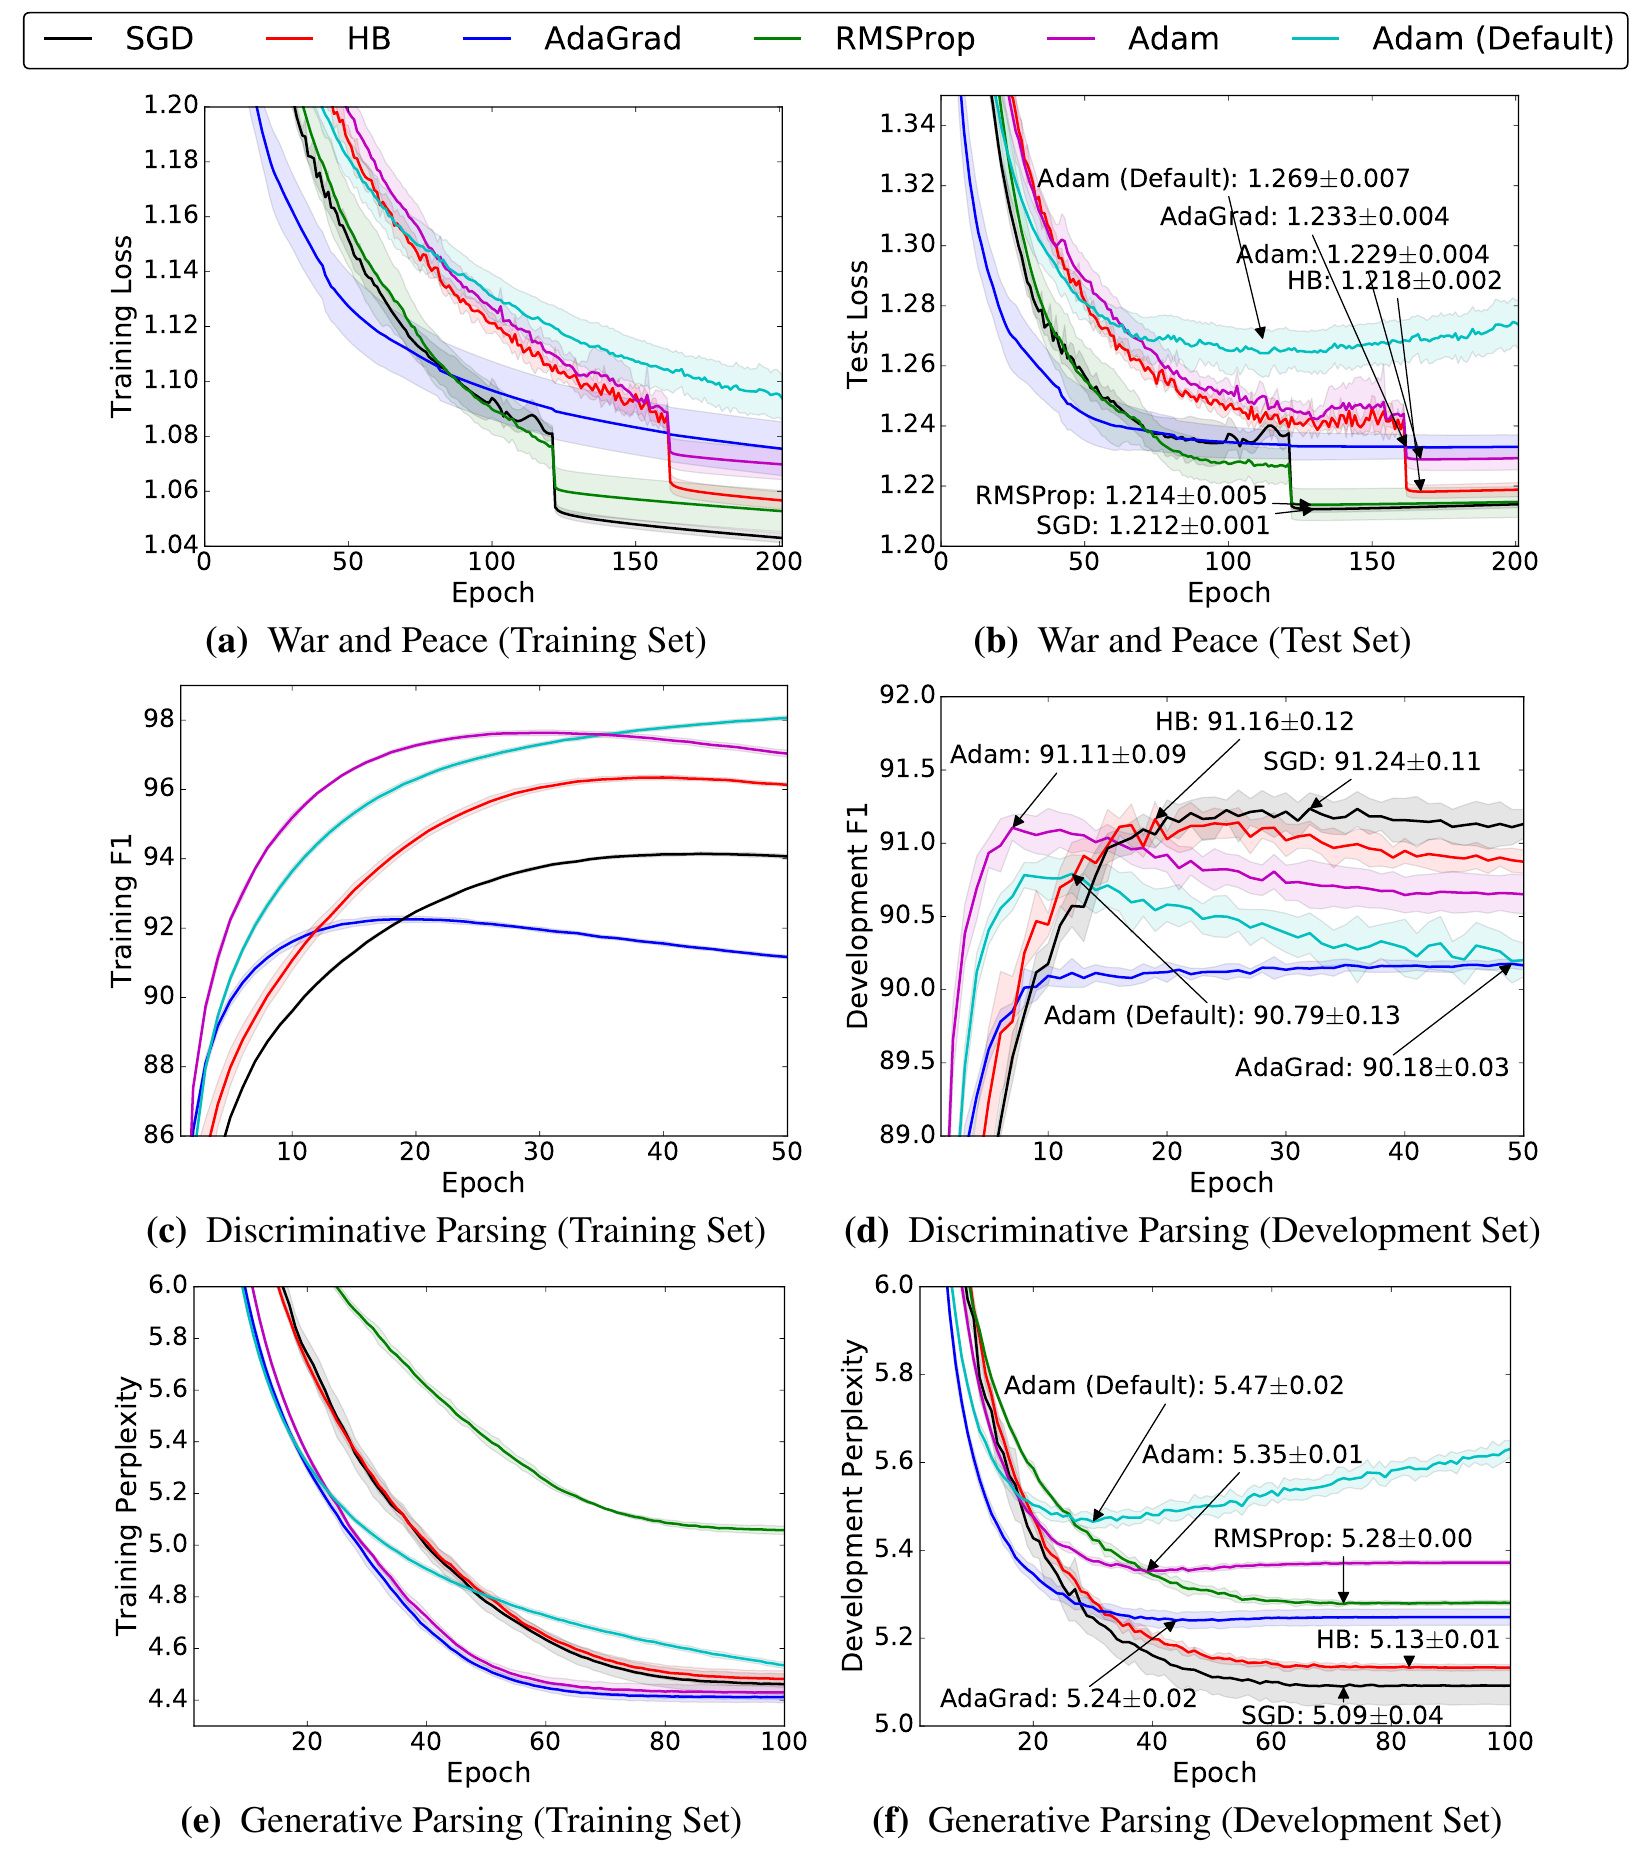
Dans chaque ligne, le graphique de gauche montre le jeu d'entraînement, celui de droite le jeu de validation ou de test, avec la meilleure valeur de chaque méthode.
- Modèle de langage au niveau des caractères (première ligne). Entraîné 200 époques avec torch-rnn sur le texte intégral de Guerre et Paix. SGD a la perte de test la plus basse, ; RMSProp suit de près avec , et les auteurs précisent que cela prouve qu'il n'est pas impossible, pour les méthodes adaptatives, de trouver des solutions qui généralisent bien. La recherche avec fixed-decay révèle aussi qu'à l'exception d'AdaGrad, la meilleure configuration de chaque méthode divise le taux d'apprentissage par 10 en une seule fois, à 60 % ou à 80 % de l'entraînement.
- Analyse discriminative (deuxième ligne). Le parseur de Cross et Huang, entraîné 50 époques sur Penn Treebank, avec dev-decay et ; DyNet n'avait alors pas de RMSProp. SGD a le meilleur F1 de validation, 91.24, suivi de près par HB et Adam. Adam atteint sa meilleure valeur, 91.11, en seulement 6 époques ; SGD met 18 époques à rattraper ce chiffre, et 31 pour atteindre 91.24. Ensuite, Adam continue de progresser sur le jeu d'entraînement, mais son score de validation baisse.
- Analyse générative (troisième ligne). Le modèle de Choe et Charniak ; pour économiser du calcul, la dimension cachée du LSTM passe de 1500 à 500 et le dropout de 0.7 à 0.5, avec 100 époques d'entraînement. SGD a la meilleure perplexité de validation, 5.09 ; la courbe d'entraînement d'Adam est parmi les meilleures, mais sa perplexité de validation est la pire des méthodes réglées, 5.35.
Les quatre tâches se résument en quatre points :
- Les solutions trouvées par les méthodes adaptatives généralisent moins bien que celles des méthodes non adaptatives.
- Même avec une perte d'entraînement aussi basse, voire plus basse, les méthodes adaptatives ont des scores de validation ou de test moins bons.
- Les méthodes adaptatives progressent vite sur le jeu d'entraînement au début, mais leur score de validation plafonne rapidement.
- Régler le taux d'apprentissage et la décroissance améliore nettement Adam sur chaque tâche. Adam avec ses valeurs par défaut est dernier ou presque sur les quatre graphiques ; l'idée qu'« Adam n'a pas besoin de réglage » ne tient pas.
Dans leur conclusion, les auteurs avouent ne pas bien comprendre pourquoi Adam reste si populaire. Après en avoir discuté avec d'autres chercheurs, ils supposent qu'Adam est surtout répandu pour les GAN et le Q-learning avec approximation de fonction, deux cas qui, à strictement parler, ne résolvent pas un problème d'optimisation ; la dynamique d'Adam leur conviendrait peut-être particulièrement.
Refaire la comparaison avec réglé
Deux ans plus tard, Dami Choi, Christopher Shallue, George Dahl et leurs collègues de l'université de Toronto et de Google Brain répondent à cet article dans « On Empirical Comparisons of Optimizers for Deep Learning ».
Leur point de départ est la relation d'inclusion entre optimiseurs. Avec un momentum nul, on retrouve SGD ; le momentum le mieux réglé ne peut donc pas faire moins bien que le SGD le mieux réglé. Adam peut aussi imiter le momentum. En fixant à 0 et en prenant un très grand, le dénominateur devient presque la constante ; avec une planification du taux d'apprentissage qui compense la correction du biais, la mise à jour d'Adam devient un SGD avec momentum. Si l'on règle tous les hyperparamètres, Adam ne devrait donc pas faire moins bien que le momentum.
Wilson et al. n'ont réglé que le taux d'apprentissage et la décroissance, en gardant le par défaut de chaque framework ; l'analyse de l'exemple construit retire elle aussi . Choi et al. reprennent le code CIFAR-10 publié par Wilson et al. :
- en ne balayant que le taux d'apprentissage, comme dans l'article d'origine, ils reproduisent le résultat où RMSProp et Adam font moins bien ;
- en réglant aussi par recherche aléatoire les paramètres liés au momentum et , ils obtiennent des taux d'erreur de test presque identiques pour SGD, le momentum, RMSProp et Adam ;
- avec leur propre code et une recherche sur la planification du taux d'apprentissage, les quatre méthodes tombent aussi dans la marge d'erreur.
Ils notent aussi que Wilson et al. choisissent les configurations de CIFAR-10 d'après la perte d'entraînement ; en les choisissant sur un jeu de validation, la conclusion ne change pas. L'influence de est plus grande qu'on ne le croit ; sur quatre tâches, les meilleurs qu'ils trouvent s'étendent sur 10 ordres de grandeur.
Comment concilier les conclusions des deux articles ? Choi et al. proposent eux-mêmes une lecture. Si l'on considère « Adam avec le par défaut » et « Adam avec un réglé » comme deux optimiseurs différents, les conclusions ne se contredisent plus. Il faut pousser la réflexion un cran plus loin. Un Adam au agrandi voit aussi l'effet adaptatif de son dénominateur se diluer, et se rapproche de plus en plus d'un SGD avec momentum. En réglant le d'Adam sur le code de Wilson, Choi et al. aboutissent à une plage de recherche finale de à , plusieurs ordres de grandeur au-dessus de l'échelle du gradient ; le dénominateur est alors presque constant. Lus ensemble, les deux articles disent donc qu'avec les réglages par défaut, la mise à jour adaptative peut effectivement moins bien généraliser, et que le jeu d'hyperparamètres qui permet à Adam d'égaler SGD consiste en partie à le rendre moins adaptatif.
Autres réponses
À la même période, d'autres pistes abordent cet écart sous des angles différents.
- Écrire correctement la décroissance des poids. En novembre 2017, Loshchilov et Hutter citent cet article, et estiment qu'une grande part de la moins bonne généralisation d'Adam vient de ce que la régularisation L2 n'y joue pas son rôle ; ils proposent AdamW.
- Passer à SGD en fin d'entraînement. SWATS, de Keskar et Socher, entraîne d'abord avec Adam, puis bascule vers SGD quand une condition se déclenche ; AdaBound, lui, encadre le taux d'apprentissage de chaque paramètre d'Adam entre des bornes inférieure et supérieure qui se resserrent progressivement, ce qui fait passer en douceur d'Adam à SGD.
- Recomparer à grande échelle. Schmidt et al. comparent 15 optimiseurs sur plus de cinquante mille entraînements ; aucun ne l'emporte nettement sur toutes les tâches, et Adam reste un choix solide.
Les Transformers ont apporté une évolution en sens inverse. Sur un modèle de langage Transformer entraîné sur LM1B, Choi et al. observent déjà un classement net ; Adam n'a besoin que de 60 % des pas du momentum pour atteindre l'erreur cible, et de 25 % de ceux de SGD pour atteindre le même résultat final. Zhang et al. estiment en 2019 que le bruit du gradient des modèles à attention suit une distribution à queue lourde, ce qui explique en partie les mauvaises performances de SGD ; Kunstner et al., en 2023, augmentent la taille de lot jusqu'au jeu de données entier, et constatent que, quand le bruit diminue, Adam progresse davantage que SGD, et que l'écart ne se réduit pas pour autant. Les expériences de cet article s'arrêtent aux CNN et aux LSTM de 2017, et sa conclusion ne s'extrapole pas directement à ce type de modèle.
Conclusion
Avec un exemple construit, cet article démontre que, sur un problème surparamétré, les méthodes adaptatives et SGD aboutissent à des solutions différentes ; pour une structure de données particulière, la solution apprise par les méthodes adaptatives peut se tromper sur la moitié des nouvelles données, quand celle de SGD est parfaitement juste. Sur quatre expériences, en ne réglant que le taux d'apprentissage et la décroissance, SGD et HB obtiennent de meilleurs scores de test, et Adam par défaut est nettement en retrait. Deux ans plus tard, Choi et al. relancent le même code en réglant aussi et d'autres hyperparamètres, et l'écart disparaît sur CIFAR-10.
Quand vous lisez un article qui compare des optimiseurs, cherchez d'abord le passage sur le réglage, et regardez quels hyperparamètres ont été réglés, combien de valeurs ont été essayées pour chacun, et sur quel critère les configurations ont été choisies. Il en va de même pour vos propres comparaisons ; pour Adam, réglez au moins le taux d'apprentissage, sa planification et , et, comme dans l'annexe de cet article, écrivez la grille réellement essayée pour chaque méthode.
Choi et al. entraînent un ResNet-50 sur ImageNet ; la meilleure configuration, avec NAdam, a un de 9475. Cette constante, censée seulement éviter la division par zéro, n'avait même pas sa place dans la grille de Wilson et al.