Article original
On the Variance of the Adaptive Learning Rate and Beyond
- Publication
- ICLR 2020Conférence
- Premier dépôt sur arXiv
- arXiv:1908.03265
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersradam2019,
  title = {{On the Variance of the Adaptive Learning Rate and Beyond}},
  author = {Liyuan Liu and Haoming Jiang and Pengcheng He and Weizhu Chen and Xiaodong Liu and Jianfeng Gao and Jiawei Han},
  year = {2019},
  eprint = {1908.03265},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1908.03265}
}
If warmup is the answer, what is the question?
C'est la phrase d'ouverture de RAdam sur GitHub. À l'époque, l'échauffement (warmup) fait déjà partie de l'équipement standard des Transformers. Pendant les quelques milliers de premières étapes, on fait monter lentement le taux d'apprentissage depuis une valeur proche de 0, faute de quoi Adam n'arrive pas à entraîner le modèle. Quant à savoir pourquoi c'est indispensable, l'explication théorique manque encore, et chacun règle la durée de l'échauffement surtout par tâtonnements.
En août 2019, Liyuan Liu et ses collègues de l'université de l'Illinois et de Microsoft publient cet article. Selon eux, la cause se trouve dans le taux d'apprentissage adaptatif d'Adam ; en début d'entraînement, celui-ci a vu trop peu de gradients, et sa variance s'emballe. Au passage, ils proposent une version corrigée, baptisée Rectified Adam, ou RAdam.
Environ une semaine après la mise en ligne sur arXiv, Less Wright le présente sur le forum fast.ai et sur Medium comme « le nouvel optimiseur état de l'art », et des membres du forum ne tardent pas à le tester. Deux mois plus tard, Jerry Ma et Denis Yarats publient une réfutation selon laquelle RAdam, une fois démonté, n'est rien d'autre qu'Adam auquel on ajoute un échauffement fixe.
Dans cette note, nous examinons les deux camps.
Définir le problème
Le taux d'apprentissage adaptatif d'Adam
Les auteurs commencent par écrire les divers optimiseurs adaptatifs dans un même cadre (Algorithm 1). À chaque étape, on calcule le momentum et le taux d'apprentissage adaptatif , puis on met à jour . Toutes les opérations se font élément par élément. Pour Adam, vaut :
C'est l'inverse de la racine carrée de l'estimation du moment d'ordre deux ; le du numérateur est la correction du biais. Un paramètre dont le gradient reste grand fait des pas plus petits ; un paramètre dont le gradient reste petit fait des pas plus grands.
Que se passe-t-il sans échauffement ?
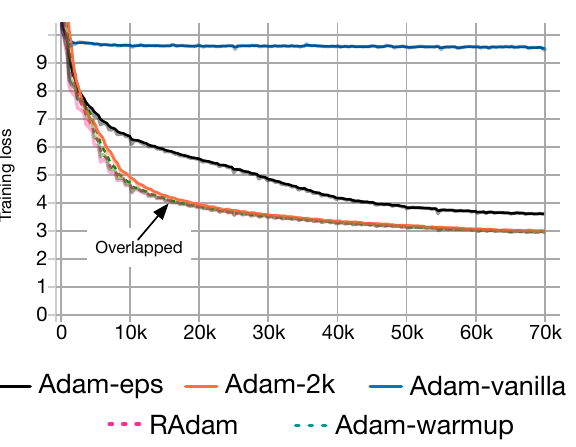
Regardons d'abord la courbe bleue d'Adam-vanilla et celle d'Adam-warmup, tout en bas. Avec le même Transformer et les mêmes données IWSLT'14 allemand-anglais, la perte d'entraînement reste bloquée vers 10 sans échauffement, et descend sous 3 avec échauffement. Les trois autres courbes sont des expériences de contrôle des auteurs ; nous y viendrons.
Les auteurs tracent la distribution des valeurs absolues du gradient à chaque étape et constatent que, sans échauffement, cette distribution se déforme dès les 10 premières étapes, son centre de masse se tassant vers de très petites valeurs. Selon leur interprétation, Adam effectue des mises à jour nuisibles lors des toutes premières étapes et entraîne le modèle dans une mauvaise région ; l'échauffement sert à atténuer l'effet de ces mises à jour.
Mais pourquoi les mises à jour des premières étapes sont-elles nuisibles ?
Résoudre le problème
À la première étape, un seul échantillon
Prenons le cas le plus extrême, . On a alors ; tout le taux d'apprentissage adaptatif est estimé à partir d'un seul gradient.
Si l'on suppose que le gradient suit , alors suit une loi du khi-deux inverse mise à l'échelle à 1 degré de liberté, et la variance de diverge. Intuitivement, cela se comprend sans peine ; il suffit que tombe tout près de 0 pour que devienne énorme.
Un petit taux d'apprentissage peut contenir cette variance, puisque . Voilà l'explication que les auteurs donnent de l'échauffement. En début d'entraînement, la variance du taux d'apprentissage adaptatif est trop grande, et l'échauffement la comprime avec un petit .
Deux expériences de contrôle
Si le problème vient vraiment de la variance, la réduire autrement devrait aussi le résoudre. Les auteurs conçoivent deux variantes d'Adam.
- Adam-2k : pendant les 2 000 premières itérations, seul est mis à jour, le momentum et les paramètres restant gelés ; cela revient à observer 2 000 échantillons de plus pour bien estimer le moment d'ordre deux avant de commencer l'entraînement.
- Adam-eps : on porte le du dénominateur de à , ce qui plafonne directement .
Dans la figure précédente, Adam-2k, sans échauffement, se superpose pourtant à Adam-warmup ; la distribution des gradients n'est plus déformée non plus. Adam-eps évite lui aussi le blocage vers 10, mais finit autour de 3.6, moins bien qu'avec échauffement. Les auteurs supposent qu'un trop grand introduit un biais dans le taux d'apprentissage adaptatif et ralentit l'optimisation ; il faut donc une méthode plus fondée.
La variance diminue avec le nombre d'échantillons
Il reste à calculer cette variance. Adam utilise une moyenne mobile exponentielle (EMA), difficile à analyser ; les auteurs l'approchent par une moyenne mobile simple (SMA) et supposent que suit une loi du khi-deux inverse mise à l'échelle à degrés de liberté. On peut lire comme « le nombre d'échantillons effectivement utilisés pour estimer le moment d'ordre deux ».
Le Theorem 1 établit que, sous cette hypothèse, la variance de décroît de façon monotone quand augmente, et en donne une forme close pour (équation (2)). Autrement dit, moins il y a d'échantillons, moins le taux d'apprentissage adaptatif est fiable ; pour , l'article considère cette variance comme impossible à traiter (intractable).
À combien d'échantillons équivaut une EMA ?
À quelle longueur de SMA correspond alors l'EMA de l'étape ? Les auteurs imposent aux deux le même « centre de masse », c'est-à-dire la même position temporelle moyenne des échantillons, pondérée par leurs poids, et obtiennent :
est la limite quand . Avec la valeur par défaut , on obtient . Pour les premières étapes, vaut :
| 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|
| 1.000 | 1.999 | 2.999 | 3.997 | 4.996 |
Calculé d'après la définition de dans l'article, avec .
En début d'entraînement, est presque égal à , ce qui colle bien à l'intuition, puisque chaque gradient vu compte pour un échantillon. Plus est proche de 1, plus la mémoire de l'EMA est longue, et plus met de temps à approcher sa limite.
Le terme de rectification
Une fois connu, les auteurs se fixent pour objectif une variance du taux d'apprentissage adaptatif identique à chaque étape, égale à sa valeur minimale , atteinte en . Pour cela, ils multiplient par un facteur d'échelle .
La forme close de l'équation (2) étant numériquement instable, les auteurs passent à une approximation du premier ordre, ce qui donne l'équation (5) :
En l'évaluant une fois en et une fois en , puis en divisant, disparaît :
C'est la rectification qui donne son nom à RAdam, au sens où un redresseur rectifie un courant. Calculons quelques points pour voir son allure :
| Étape | 5 | 10 | 100 | 1 000 | 2 000 | 5 000 |
|---|---|---|---|---|---|---|
| 0.017 | 0.049 | 0.215 | 0.645 | 0.828 | 0.983 |
Calculé d'après le de la section 4.2 de l'article, avec .
Il est minuscule au départ, vaut environ 0.65 à 1 000 étapes, et n'approche 1 qu'à 5 000 étapes. Multipliée par le taux d'apprentissage, cette courbe a tout l'air d'un échauffement.
L'algorithme complet
Le tout forme l'Algorithm 2. À chaque étape :
- Calculer le gradient , mettre à jour le moment d'ordre deux et le moment d'ordre un .
- Corriger le biais du moment d'ordre un, .
- Calculer .
- Si , calculer et , puis mettre à jour .
- Sinon, se passer du taux d'apprentissage adaptatif et faire directement .
Le point 5 est le cas où RAdam dégénère en SGD avec momentum. D'après le tableau de plus haut, avec , seules les étapes à 4 vérifient ; les 4 premières étapes sont donc un SGD avec momentum et correction du biais, et l'Adam rectifié ne prend le relais qu'à partir de la 5e étape. Ma et Yarats démontreront plus tard que, dès que , équivaut exactement à . L'article note en outre que si , alors et RAdam dégénère entièrement en SGD avec momentum.
Le lien avec l'échauffement
Dans la section 4.3, les auteurs comparent directement à un échauffement linéaire. Celui-ci revient à multiplier le taux d'apprentissage par , une forme très proche de ; ils y voient la confirmation que « l'échauffement est une technique de réduction de la variance ». La différence est que RAdam n'a pas besoin de l'hyperparamètre , la durée d'échauffement, et s'ajuste automatiquement à .
Ils soulignent aussi que cette correction est indépendante des autres techniques de stabilisation de l'entraînement, comme l'écrêtage du gradient, l'augmentation de , l'initialisation ou les couches de normalisation, et peut s'y combiner.
Discussion
Configuration expérimentale
Les expériences se répartissent en trois catégories ; pour les méthodes de la famille Adam, la décroissance des poids suit toujours la forme découplée d'AdamW.
- Modèle de langage : One Billion Word, LSTM à deux couches de 2 048 unités cachées, taux d'apprentissage 0.001, taille de lot 128.
- Classification d'images : ResNet-20 sur CIFAR-10 (186 époques), ResNet-18 sur ImageNet (90 époques), taux d'apprentissage décroissant par paliers, décroissance des poids de .
- Traduction automatique : Transformer de fairseq, IWSLT'14 allemand-anglais dans les deux sens et WMT'16 anglais→allemand ; Adam avec 4 000 étapes d'échauffement linéaire.
Dans les expériences de modèle de langage et d'images, les d'Adam et de RAdam valent tous deux .
Face à l'Adam d'origine
Sans échauffement, RAdam bat l'Adam d'origine sur les trois jeux de données. Sur One Billion Word, la perplexité de test passe de 36.92 à 35.70 ; RAdam est plus lent qu'Adam pendant les premières époques, puis converge plus vite. Voici la précision de test en classification d'images :
| Jeu de données | SGD | Adam | RAdam |
|---|---|---|---|
| CIFAR-10 | 91.51 | 90.54 | 91.38 |
| ImageNet | 69.86 | 66.54 | 67.62 |
D'après la Table 1 de l'article (%).
RAdam fait mieux qu'Adam, mais ne bat SGD sur aucun des deux jeux de données. Les auteurs rapportent aussi la précision d'entraînement sur ImageNet ; SGD, Adam et RAdam obtiennent respectivement 69.57, 69.12 et 70.30, RAdam étant le plus haut. Puisqu'il s'entraîne mieux que SGD mais fait moins bien au test, l'écart semble venir de la généralisation ; c'est toutefois une déduction tirée de la précision d'entraînement, et l'article lui-même ne fait pas cette analyse.
Peu sensible au taux d'apprentissage
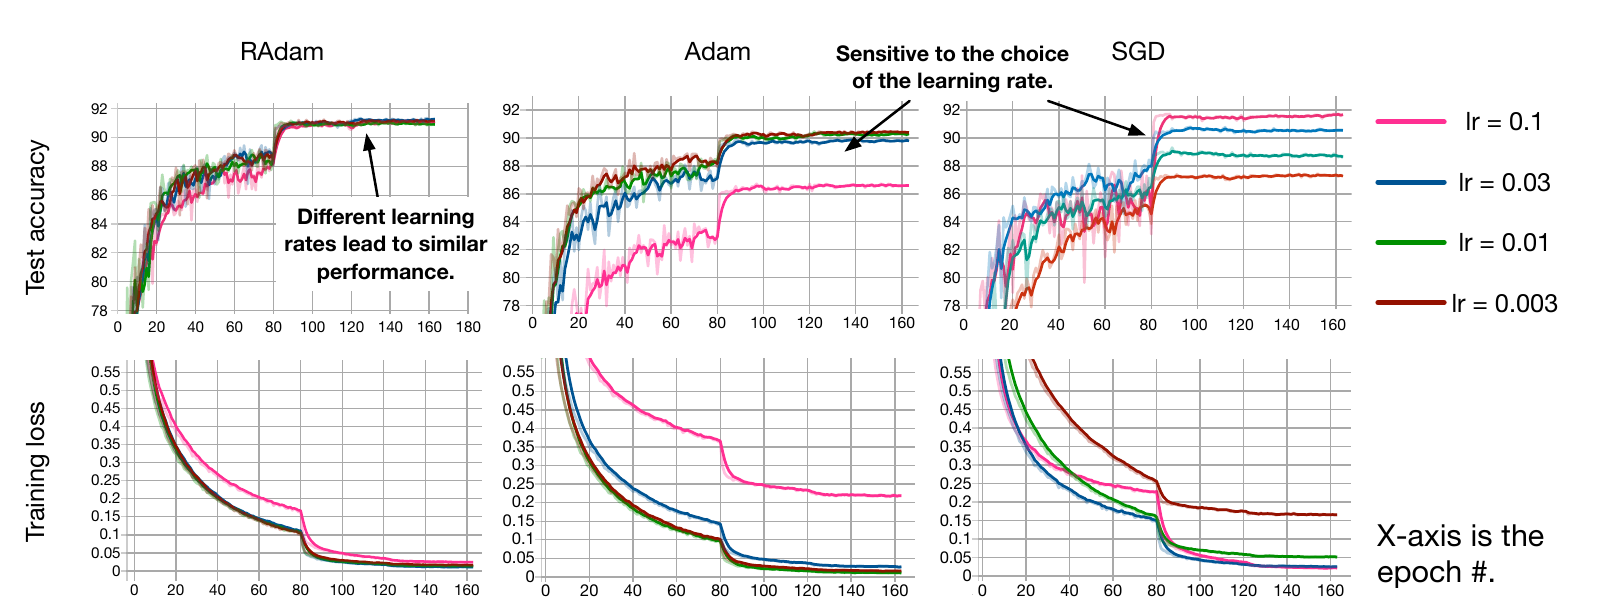
Quand le taux d'apprentissage varie de 0.1 à 0.003, les quatre courbes de précision de test de RAdam se superposent presque ; Adam tombe à environ 86 % avec un taux de 0.1, et les quatre courbes de SGD partent chacune de leur côté. Les auteurs en concluent que la rectification permet à RAdam de s'accommoder d'une plage plus large de taux d'apprentissage. La FAQ du README reconnaît toutefois honnêtement que la robustesse de RAdam a ses limites ; il faut quand même régler le taux d'apprentissage.
Face à l'échauffement
La traduction est le domaine où l'échauffement est le plus indispensable ; l'adversaire devient donc un Adam bien réglé, avec échauffement :
| Tâche | Adam + échauffement | RAdam |
|---|---|---|
| IWSLT'14 allemand→anglais | 34.66 | 34.76 |
| IWSLT'14 anglais→allemand | 28.56 | 28.48 |
| WMT'16 anglais→allemand | 27.03 | 27.27 |
D'après la Table 2 de l'article ; BLEU, moyenne de 5 graines aléatoires pour IWSLT.
Les deux font jeu égal, et les auteurs concluent eux aussi à « des performances comparables à celles de l'échauffement ». Il y a ici un réglage qu'on ne voit qu'en annexe. Dans les expériences de traduction, vaut 0.9995, et l'annexe justifie ce choix par la volonté d'obtenir . Reporté dans , cela donne exactement 3 999, aligné sur les 4 000 étapes d'échauffement du groupe Adam. Autrement dit, dans cette comparaison, la durée de l'« échauffement automatique » de RAdam a été alignée par l'intermédiaire de .
Sur CIFAR-10, la meilleure précision d'Adam avec échauffement est de 91.29 %, comparable aux 91.38 % de RAdam ; mais la durée d'échauffement se choisit parmi 100, 200, 500 et 1 000 étapes, et avec un taux d'apprentissage de 0.1 et 100 étapes d'échauffement, on n'obtient que 90.13 %, contre 91.06 % pour RAdam au même taux. Formulée plus précisément, la thèse des auteurs est donc que RAdam supprime un hyperparamètre à régler, les meilleurs scores restant à peu près les mêmes.
Le SGD avec momentum des premières étapes
Les étapes où RAdam dégénère en SGD avec momentum comptent-elles ? L'annexe C mène une expérience de substitution sur CIFAR-10 avec un taux d'apprentissage de 0.1 (moyenne de 5 exécutions). Avec RAdam du début à la fin, la précision de test est de 91.08 % ; en remplaçant les 4 premières étapes par un Adam ordinaire, elle tombe à 89.98 % ; avec SGD pour les 4 premières étapes et un Adam non rectifié pour les étapes 5 à 8, elle est de 90.29 %. Les auteurs y voient une confirmation de la théorie, les mises à jour les plus précoces étant les plus nuisibles, mais précisent que cette partie n'est qu'un élément secondaire de l'algorithme ; l'essentiel est le mécanisme de l'échauffement et la dérivation du terme de rectification.
La réfutation de Ma et Yarats
En octobre 2019, Jerry Ma (université de Chicago) et Denis Yarats (université de New York, Facebook AI Research) publient sur arXiv « On the Adequacy of Untuned Warmup for Adaptive Optimization » (AAAI 2021). Le résumé annonce sans détour qu'ils entendent réfuter cette analyse. L'argument se déploie en trois temps.
Premièrement, RAdam est un échauffement fixe. ne dépend que de et de , et pas du tout de l'allure réelle des gradients. Comme on l'a vu, correspond exactement aux 4 premières étapes ; RAdam se résume donc en une phrase, 4 étapes de SGD avec momentum, puis Adam avec une planification d'échauffement fixe. Ils ont aussi essayé de remplacer les 4 premières étapes par rien du tout, ou par Adam avec un très petit taux d'apprentissage ; la différence est chaque fois négligeable.
Deuxièmement, l'argument de la variance a une faille. RAdam suppose des gradients de moyenne nulle, mais en début d'entraînement, le modèle est loin d'un minimum et la moyenne du gradient dépasse généralement son écart-type ; sur EMNIST, ils mesurent qu'il faut attendre environ la 50e étape pour que le coefficient de variation de la plupart des paramètres dépasse durablement 1. Plus décisif encore, la mise à jour effective d'Adam est , et est fortement corrélé à . À la première étape, les deux sont même exactement égaux, et la mise à jour de chaque paramètre vaut exactement (pour ). Autrement dit, à l'étape même où la variance du taux d'apprentissage adaptatif « diverge », la variance de la mise à jour effective est nulle.
Troisièmement, c'est l'amplitude de la mise à jour qu'il faut regarder. Ils simulent des gradients qui, autour d'un minimum, ne sont qu'un bruit de moyenne nulle, et observent les mises à jour d'Adam. Celles-ci partent de et ne se stabilisent autour de qu'après environ 40 étapes. Même si le modèle est déjà posé sur un minimum, Adam fait donc des pas trop grands pendant ses premières dizaines d'étapes ; SGD, dans la même situation, n'a pas besoin d'échauffement, ce qui explique en partie pourquoi Adam en a plus besoin que SGD.
Sur la base de ces analyses, ils proposent deux règles empiriques sans réglage :
La constante de temps de la première est choisie par analogie avec le terme de correction du biais du moment d'ordre deux d'Adam, , une intuition que les auteurs eux-mêmes qualifient de purement spéculative ; la seconde est un échauffement linéaire de étapes, soit 2 000 étapes pour .
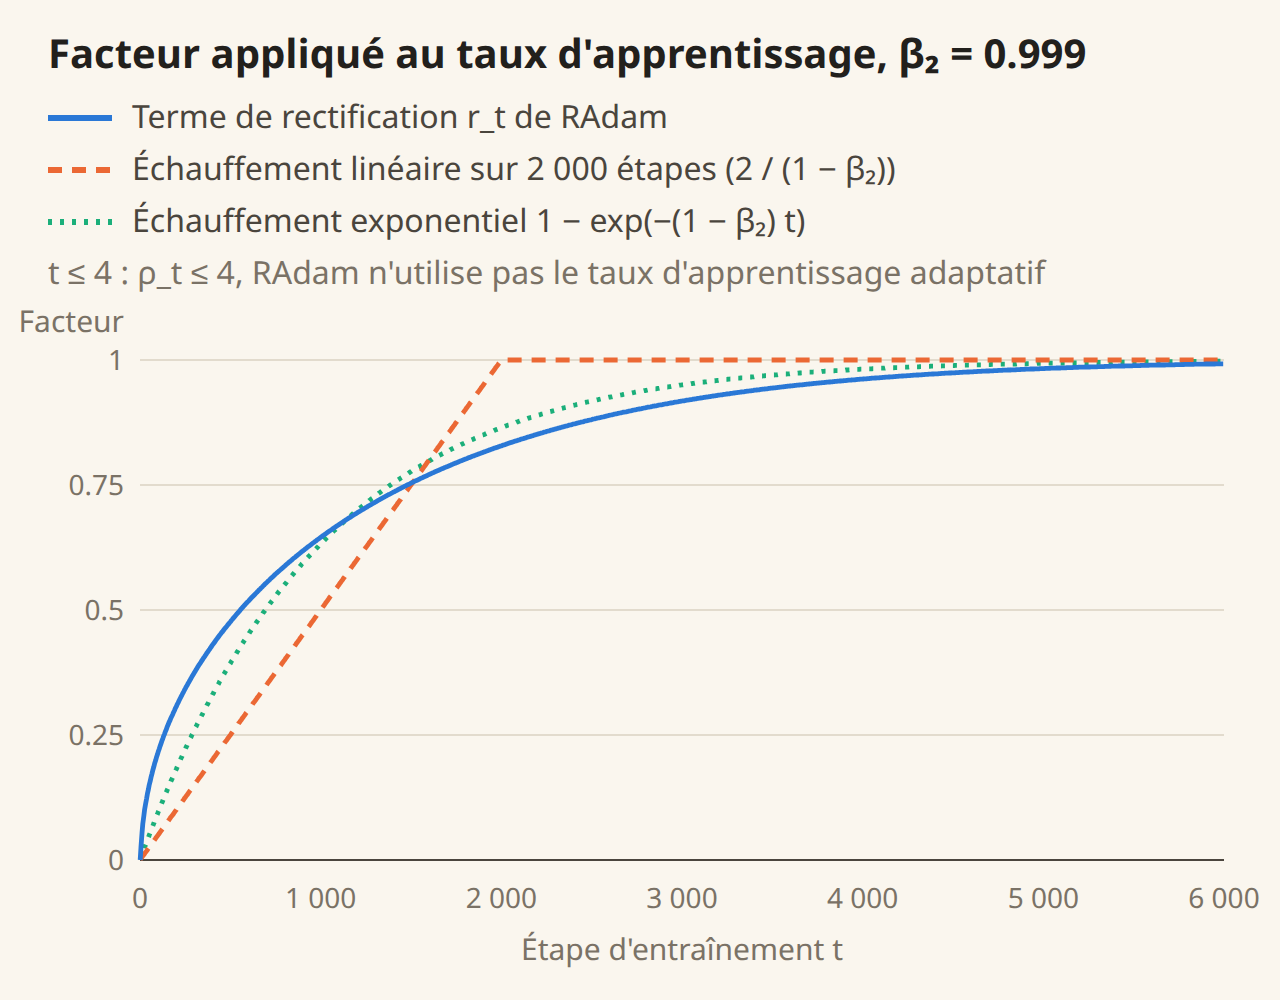
Les trois courbes n'ont pas exactement la même forme ; RAdam monte le plus vite pendant les premières centaines d'étapes, mais passe en dernière position au-delà d'environ 1 500 étapes. Ma et Yarats les comparent par leur « durée d'échauffement effective » , c'est-à-dire le nombre total d'étapes de taux d'apprentissage que l'échauffement retranche ; pour , les trois tournent autour de 1 000 étapes (d'après la formule, environ 1 033 étapes pour RAdam), et restent presque identiques quel que soit .
Les expériences vont dans le même sens. Sur un ResNet-50 pour ImageNet, un modèle de langage Transformer sur WikiText-103 et un Transformer de traduction WMT16 anglais→allemand, ils balaient chaque fois 9 à 12 combinaisons de taux d'apprentissage et de ; les écarts entre les trois méthodes ne dépassent généralement pas quelques dixièmes. Prenons l'erreur top-1 sur ImageNet (5 graines aléatoires) :
| Taux d'apprentissage | Exponentiel | Linéaire | RAdam | |
|---|---|---|---|---|
| 0.99 | 27.9 | 28.0 | 28.4 | |
| 0.997 | 27.9 | 27.9 | 28.3 | |
| 0.999 | 28.2 | 28.3 | 28.4 |
D'après la Table 1 de Ma & Yarats ; extrait des trois lignes à taux d'apprentissage (%).
Sur ces trois lignes, RAdam est même un peu moins bon. Le plus grand écart de tout le tableau apparaît avec un taux d'apprentissage de et , où l'erreur de RAdam dépasse d'environ 1 point celle des deux règles empiriques. Ils recommandent, avec Adam, un échauffement linéaire de étapes.
Qui a raison ?
Les deux articles s'accordent sur le fait qu'Adam a besoin d'un taux d'apprentissage plus faible pendant ses premiers milliers d'étapes ; ils divergent sur la raison.
Côté RAdam, les preuves sont les expériences de contrôle comme Adam-2k, et le match nul avec un échauffement bien réglé en traduction et en images. Côté Ma et Yarats, ils montrent que n'est qu'une planification fixe déterminée par , et s'appuient sur l'analyse de l'amplitude des mises à jour et sur des expériences couvrant trois tâches pour établir qu'un échauffement linéaire sans réglage fait la même chose. La version définitive de l'article RAdam ne répond pas à cette réfutation ; la FAQ du README admet en revanche que, lorsque la moyenne du gradient est bien plus grande que sa variance, le problème de variance n'est peut-être pas très important, et y voit une explication possible au fait que certains modèles ont davantage besoin d'échauffement.
L'hypothèse de moyenne nulle, l'article RAdam l'a lui-même vérifiée par simulation dans sa section 5.3. Les gradients y sont tirés de , avec six valeurs de (0, 0.001, 0.01, 0.1, 1 et 10), , et 5 000 trajectoires de 6 000 étapes chacune ; dans les six cas, la variance du taux d'apprentissage adaptatif brut est trop grande au début, et reste à peu près constante après rectification. La même section confirme aussi que l'approximation du premier ordre de l'équation (5) se superpose presque à la forme close de l'équation (2). Ces simulations mesurent cependant toujours la variance du taux d'apprentissage adaptatif lui-même, sans toucher à la corrélation entre et relevée par Ma et Yarats.
Ma et Yarats n'ont pas non plus entièrement résolu la question. Leur simulation montre que l'amplitude des mises à jour se stabilise en 40 étapes environ ; selon cette logique, quelques centaines d'étapes d'échauffement devraient suffire. Or, qu'il s'agisse de RAdam ou de leurs règles empiriques, l'échauffement effectif tourne autour de 1 000 étapes, et certains échauffements réglés à la main vont jusqu'à 10 000 étapes. Ils écrivent eux-mêmes dans leur discussion que la raison pour laquelle Adam a besoin d'un échauffement aussi long reste une question ouverte.
D'un point de vue d'ingénieur, les deux camps s'accordent en pratique pour dire que RAdam équivaut à un échauffement d'environ étapes. Il en découle une conséquence facile à négliger. Les grands modèles de langage ultérieurs fixent souvent à 0.95, comme GPT-3 et LLaMA ; on a alors , et d'après la formule, l'échauffement effectif intégré à RAdam n'est plus que d'environ 24 étapes, alors que LLaMA utilise en réalité 2 000 étapes d'échauffement.
Le terme de rectification, lui, est resté. PyTorch intègre torch.optim.RAdam ; fin 2024, le paquet officiel de Schedule-Free a aussi accueilli une version RAdam proposée par la communauté, dont la description affirme qu'on peut même se passer d'échauffement.
Conclusion
RAdam part du taux d'apprentissage adaptatif d'Adam, estime par une approximation SMA le nombre d'échantillons équivalent à l'étape , puis ramène la variance à un niveau constant avec le terme de rectification ; pendant les premières étapes où , il dégénère directement en SGD avec momentum. En traduction et en classification d'images, il rattrape un Adam bien réglé avec échauffement sans qu'il faille fixer de durée d'échauffement (le des expériences de traduction a toutefois été spécialement aligné). Ma et Yarats montrent ensuite que n'est qu'un échauffement fixe déterminé par , et qu'un simple échauffement linéaire obtient des résultats presque identiques.
Si vous avez déjà un échauffement bien réglé, passer à RAdam ne vous apportera probablement pas grand-chose ; sinon, RAdam et « un échauffement linéaire de étapes » sont deux points de départ à peu près aussi fiables l'un que l'autre. Retenez simplement qu'avec RAdam, modifier revient à modifier en même temps la durée d'échauffement.
Le README s'ouvre en demandant quelle est la question, si l'échauffement est la réponse. Ma et Yarats répondent que les mises à jour d'Adam sont trop grandes au début ; quant à savoir pourquoi l'échauffement doit durer si longtemps, ils reconnaissent eux-mêmes ne pas le savoir.