Article original
Finetuned Language Models Are Zero-Shot Learners
- Publication
- ICLR 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2109.01652
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningflan2021,
  title = {{Finetuned Language Models Are Zero-Shot Learners}},
  author = {Jason Wei and Maarten Bosma and Vincent Y. Zhao and Kelvin Guu and Adams Wei Yu and Brian Lester and Nan Du and Andrew M. Dai and Quoc V. Le},
  year = {2021},
  eprint = {2109.01652},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2109.01652}
}
GPT-3 a fait découvrir à tout le monde l'apprentissage à partir de quelques exemples (few-shot learning). On place quelques exemples dans le prompt, et le modèle fait pareil.
Sans les exemples, c'est une autre histoire. Sur des tâches comme la compréhension de lecture, les questions-réponses ou l'inférence en langage naturel (NLI), les scores zero-shot de GPT-3 restent nettement en dessous des scores few-shot. Les auteurs supposent que, sans exemples, le prompt que voit le modèle est trop éloigné du format des données de préentraînement. La NLI, par exemple, demande de juger si une phrase peut se déduire d'une autre, un type de question qui n'apparaît presque jamais sous une forme naturelle dans les textes du web.
En septembre 2021, Wei, Bosma, Zhao, Guu et leurs collègues de Google proposent une approche très directe. Puisque beaucoup de tâches de NLP peuvent se décrire en une phrase, comme « Cette critique de film est-elle positive ou négative ? », il suffit de réécrire quelques dizaines de jeux de données existants sous forme d'instructions en langage naturel, d'affiner un modèle de langage dessus, puis de voir s'il sait faire des tâches qu'il n'a jamais vues. Ils appellent cette approche l'instruction tuning (affinage par instructions), et le modèle affiné FLAN (Finetuned Language Net). Le nom est ensuite devenu plus célèbre que le modèle lui-même, repris par Flan-T5 comme par Flan-PaLM.
Définir le problème
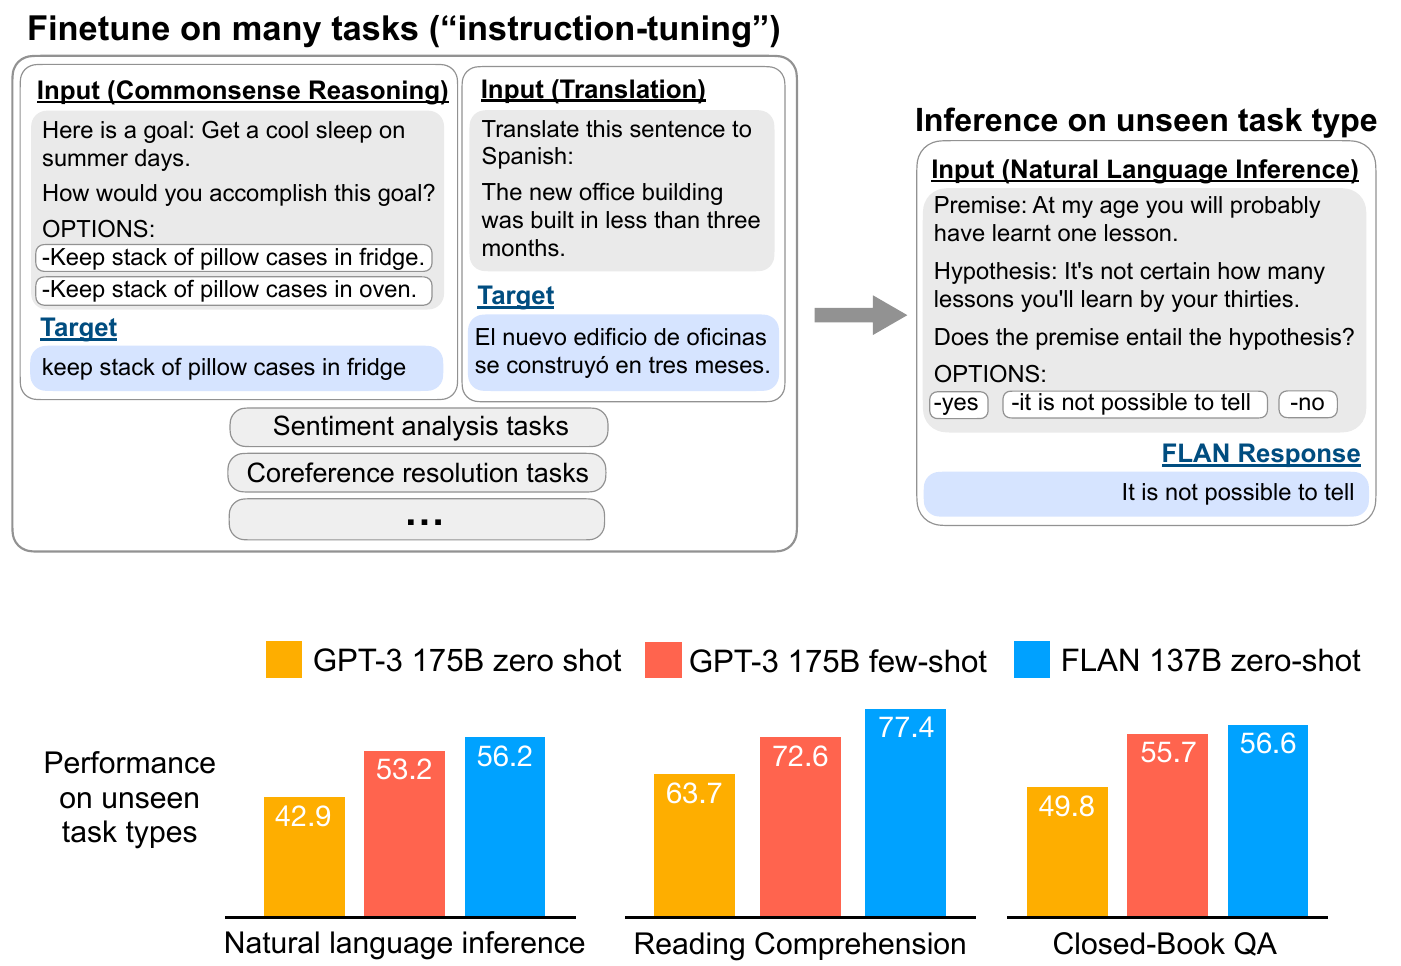
La moitié supérieure de la figure présente la conception de toute l'expérience. À l'entraînement, le modèle voit de nombreuses tâches, raisonnement de sens commun, traduction, analyse de sentiment et bien d'autres, chaque question étant rédigée comme une instruction ; au test, on lui donne une question d'inférence en langage naturel, alors qu'il n'a jamais vu la moindre tâche d'inférence pendant l'entraînement.
La moitié inférieure annonce les résultats. Sur trois types de tâches jamais vus, FLAN 137B en zero-shot dépasse GPT-3 175B en zero-shot, et même GPT-3 en few-shot.
Les auteurs situent l'instruction tuning entre deux approches existantes. La première est le « préentraînement puis affinage » de BERT ou T5, qui demande beaucoup de données annotées pour chaque tâche et aboutit à un modèle spécialisé. La seconde est le « prompting » de GPT-3, sans affinage, qui repose sur des exemples few-shot ou des prompts soigneusement conçus. L'instruction tuning affine le modèle avec la supervision de nombreuses tâches, mais son but est que le modèle, à l'inférence, comprenne la description en langage naturel d'une tâche qu'il n'a jamais vue.
Le point à bien préciser, c'est ce qu'on entend par « jamais vu ». Exiger seulement que le jeu de test n'apparaisse pas à l'entraînement ne suffit pas. Si le modèle s'est entraîné sur MNLI et qu'on le teste sur RTE, les deux relèvent de la NLI, et on peut difficilement dire qu'il fait une nouvelle tâche.
Résoudre le problème
Réécrire les jeux de données en instructions
Les auteurs réunissent 62 jeux de données textuels publics tirés de TensorFlow Datasets, couvrant à la fois des tâches de compréhension et de génération, et les répartissent en 12 groupes (clusters) selon le type de tâche, par exemple 7 jeux de données d'inférence en langage naturel, 5 de compréhension de lecture, 3 de questions-réponses en livre fermé, 8 de traduction et 11 de résumé.
Pour chaque jeu de données, 10 gabarits d'instruction différents sont écrits à la main. La plupart décrivent la tâche d'origine, mais pour augmenter la diversité, jusqu'à 3 gabarits par jeu de données « inversent la tâche » ; un jeu de classification de sentiment sert par exemple aussi à demander au modèle d'écrire une critique de film. Un même exemple de NLI peut ainsi être formulé de plusieurs façons :
Gabarit 1 :
<premise>
Based on the paragraph above, can we conclude that <hypothesis>?
<options>

Gabarit 3 :
Read the following and determine if the hypothesis can be inferred from the premise:
Premise: <premise>
Hypothesis: <hypothesis>
<options>
À l'entraînement, chaque exemple reçoit un gabarit tiré au hasard parmi ceux de son jeu de données.
Joindre les options aux questions de classification
FLAN est un modèle de langage à décodeur seul ; pour les tâches de génération, il répond directement. Les questions de classification sont plus délicates. GPT-3 utilise une « classification par classement » (rank classification), qui compare par exemple seulement les probabilités des mots « yes » et « no » et retient la plus élevée. Les auteurs font remarquer qu'il peut y avoir bien des façons de dire « yes », et que la probabilité se disperse entre elles.
FLAN ajoute donc à la fin des questions de classification OPTIONS: suivi de toutes les classes, pour que le modèle sache parmi quelles réponses choisir, comme le « yes / it is not possible to tell / no » de la question de NLI de la figure.
Mettre de côté tout un type de tâche pour le test
Pour l'évaluation, les auteurs adoptent une définition plutôt prudente. Un jeu de données ne compte comme tâche inédite que si tout le groupe auquel il appartient est absent de l'affinage. Pour tester la NLI, on retire les 7 jeux de données du groupe NLI et on affine sur les autres groupes ; les groupes de nature proche sont exclus eux aussi, si bien que pour tester la NLI, on n'utilise pas non plus le groupe « détection de paraphrase ».
Pour évaluer groupes, il faut donc entraîner FLAN différents, chacun mettant un groupe de côté. C'est plus cher, mais ce qu'on mesure est bien « un type de tâche jamais vu ».
Configuration d'entraînement
Le modèle de base est LaMDA-PT, un modèle de langage à décodeur seul de 137 milliards de paramètres. Il a été préentraîné sur des pages web (code compris), des données de dialogue et Wikipédia, soit 2 490 milliards de tokens BPE au total, dont environ 10 % ne sont pas en anglais. LaMDA-PT n'a reçu que le préentraînement de modèle de langage, sans l'affinage pour le dialogue qu'a reçu ensuite LaMDA.
Pour équilibrer les tailles des jeux de données, on prend au plus 30 000 exemples par jeu, puis on applique le « mélange proportionnel à la taille des données » de T5 (celui-là même que l'article T5 comparait point par point), avec un taux de mélange plafonné à 3 000. Par exemple, trois jeux de données de 100 000, 20 000 et 1 000 exemples deviennent 30 000, 20 000 et 1 000 après troncature ; le plafond ramène les deux premiers à 3 000 chacun, et les proportions d'échantillonnage sont donc de 3:3:1. Les grands jeux de données n'écrasent pas les petits.
L'affinage dure 30 000 pas, avec des lots de 8 192 tokens, Adafactor et un taux d'apprentissage de , et des longueurs d'entrée et de sortie de 1 024 et 256. Il faut environ 60 heures sur un TPUv3 à 128 cœurs ; le nombre de pas de mise à jour du gradient représente moins de 2 % de celui du préentraînement.
Discussion
Résultats principaux
Il y a trois points de comparaison. Le plus direct est le même LaMDA-PT sans affinage, évalué en zero-shot et en few-shot avec les prompts de l'article GPT-3 ; cette comparaison mesure directement ce qu'apporte l'instruction tuning lui-même. Les deux autres sont GPT-3 175B et GLaM 64B/64E, dont les chiffres viennent de leurs articles respectifs.
Les scores de FLAN sont calculés de deux façons. La première est la moyenne sur tous les gabarits, qui donne une idée de ce qu'on obtient en écrivant une instruction naturelle quelconque ; la seconde choisit le meilleur gabarit sur l'ensemble de développement, puis rapporte le score sur l'ensemble de test, ce qui correspond au cas de l'article GPT-3 où « l'on dispose d'un ensemble de développement pour régler le prompt ». Avec le meilleur gabarit, FLAN en zero-shot bat GPT-3 en zero-shot sur 20 des 25 jeux de données, et même GPT-3 en few-shot sur 10 d'entre eux.
Quelques jeux de données en détail :
| Jeu de données | LaMDA-PT zero-shot | GPT-3 zero-shot | GPT-3 few-shot | FLAN zero-shot (moyenne des gabarits) | FLAN zero-shot (meilleur gabarit) |
|---|---|---|---|---|---|
| ANLI R1 | 39.6 | 34.6 | 36.8 | 47.7 ± 1.4 | 46.4 |
| RTE | 73.3 | 63.5 | 72.9 | 78.3 ± 7.9 | 84.1 |
| CB | 42.9 | 46.4 | 82.1 | 64.1 ± 14.7 | 83.9 |
| BoolQ | 81.0 | 60.5 | 77.5 | 80.2 ± 3.1 | 82.9 |
| OBQA | 41.8 | 57.6 | 65.4 | 77.4 ± 1.3 | 78.4 |
| ARC-c | 42.0 | 51.4 | 51.5 | 61.7 ± 1.4 | 63.1 |
| HellaSwag | 57.0 | 78.9 | 79.3 | 56.4 ± 0.5 | 56.7 |
| Winogrande | 68.3 | 70.2 | 77.7 | 67.3 ± 2.5 | 71.2 |
Précision, d'après la Table 2 de l'annexe de l'article.
C'est en NLI que le progrès est le plus net. Les auteurs reprennent une observation de l'article GPT-3, selon laquelle les questions de NLI apparaissent rarement de façon naturelle dans les textes du web, et deviennent maladroites quand on les écrit comme une phrase à compléter ; FLAN, lui, peut demander directement « Est-ce que <prémisse> veut dire que <hypothèse> ? ». Les questions-réponses en livre fermé (ARC) et la compréhension de lecture (MultiRC, OBQA) progressent aussi fortement.
Le tableau montre aussi la sensibilité aux instructions. Sur CB, la moyenne des gabarits est de 64.1, avec un écart-type de 14.7 ; changer de formulation peut faire varier le score d'une bonne dizaine de points. Le meilleur gabarit, lui, atteint 83.9.
Les deux dernières lignes sont des contre-exemples. HellaSwag et Winogrande sont par nature des tâches de « complétion de phrase », presque identiques à l'objectif de préentraînement d'un modèle de langage, et l'instruction y est superflue. Sur ce genre de tâches de raisonnement de sens commun et de résolution de coréférence, FLAN ne bat LaMDA-PT non affiné que sur 3 des 7. Sur HellaSwag, les 78.9 de GPT-3 dépassent de loin LaMDA-PT ; cet écart vient du modèle de base, et l'instruction tuning n'y change rien.
La traduction se situe entre les deux. FLAN bat GPT-3 en zero-shot dans les 6 directions de traduction, mais perd le plus souvent face à GPT-3 en few-shot. Il s'en sort bien vers l'anglais, moins bien depuis l'anglais, ce que les auteurs attribuent à un vocabulaire SentencePiece et à des données de préentraînement dominés par l'anglais.
Ablations : nombre de groupes, taille du modèle, instructions
Plus de groupes, meilleurs résultats. Les auteurs mettent toujours de côté les trois mêmes groupes, NLI, questions-réponses en livre fermé et raisonnement de sens commun, et ajoutent un à un les autres groupes à l'affinage, de 1 à 7 (soit de 11 à 39 jeux de données). La performance moyenne sur les trois groupes mis de côté monte de 49.9 à 63.5, avec une seule exception, l'ajout du groupe d'analyse de sentiment, qui n'aide presque pas. À 7 groupes, la courbe n'est pas encore saturée.
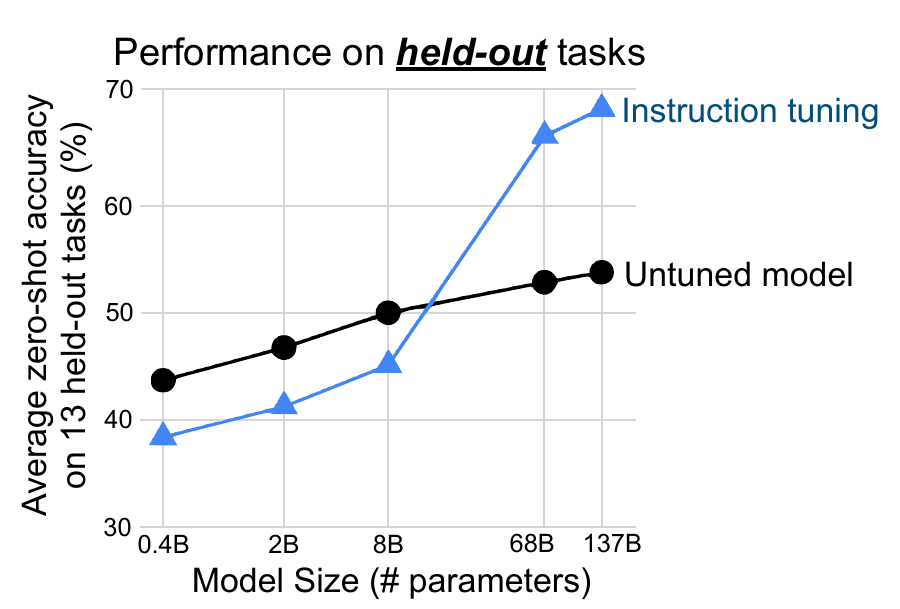
Les petits modèles font au contraire moins bien. Avec le même découpage en groupes, les auteurs appliquent l'instruction tuning à cinq modèles de 422 millions à 137 milliards de paramètres. La ligne noire correspond au modèle non affiné, la ligne bleue au modèle affiné. Les gains sont importants pour 68B et 137B, ce dernier passant d'environ 54 à environ 68 ; mais à 8B et en dessous, les scores après instruction tuning sont même inférieurs à ceux du modèle non affiné.
Les auteurs avancent une hypothèse. Pour un petit modèle, apprendre la quarantaine de tâches d'affinage épuise sa capacité, et il ne lui reste rien pour généraliser à de nouvelles tâches ; un grand modèle, une fois ces tâches apprises, garde de la capacité en réserve et apprend au passage à « suivre les instructions ». L'article ne vérifie pas davantage cette explication.
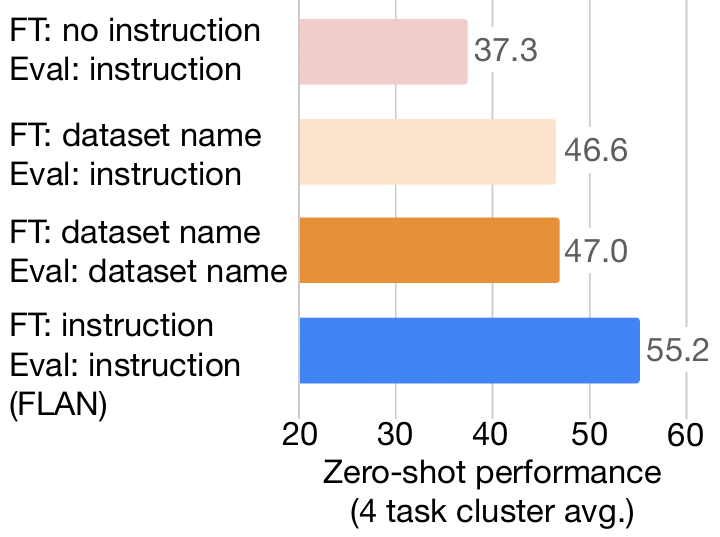
Les instructions elles-mêmes sont décisives. Le progrès ne viendrait-il pas simplement de l'affinage multitâche, indépendamment des instructions ? Les auteurs essaient deux affinages sans instructions. L'un ne donne que l'entrée et la sortie, par exemple, pour la traduction, l'entrée « The dog runs. » et la sortie « Le chien court. » ; l'autre ajoute devant l'entrée le nom de la tâche et du jeu de données, par exemple « [Translation: WMT'14 to French] The dog runs. ».
La version entrée-sortie seule, évaluée avec des instructions, n'obtient en moyenne que 37.3. La version avec le nom du jeu de données obtient 46.6 et 47.0, selon qu'on l'évalue avec des instructions ou avec le nom. FLAN, affiné et évalué avec des instructions, atteint 55.2. Les données multitâches aident bel et bien, mais pour généraliser à des tâches jamais vues, il faut décrire les tâches en langage naturel dès l'entraînement.
Combiner avec d'autres méthodes
L'instruction tuning se combine aussi avec des exemples few-shot. À l'inférence, les auteurs placent devant la question jusqu'à 16 exemples mis au même format d'instruction. Les scores progressent encore dans chaque groupe, surtout pour les tâches au format de sortie plus complexe comme la traduction, la conversion de données structurées en texte ou les questions-réponses en livre fermé ; l'écart-type entre gabarits diminue aussi, et le modèle devient moins sensible à la formulation du prompt.
Une autre expérience porte sur le prompt tuning, qui fige le modèle et n'entraîne qu'une courte séquence de vecteurs continus placée devant l'entrée. Sur SuperGLUE, le prompt tuning à partir de FLAN fait toujours mieux qu'à partir de LaMDA-PT ; les auteurs notent que, surtout avec seulement 32 exemples d'entraînement, l'amélioration dépasse souvent 10 %.
Limites
Les auteurs en listent eux-mêmes plusieurs. L'affectation d'une tâche à un groupe comporte une part de subjectivité. Les instructions sont courtes, souvent une seule phrase, très loin des consignes détaillées données aux annotateurs en crowdsourcing. Des questions de test peuvent figurer dans les pages web du préentraînement ; l'analyse a posteriori de l'annexe ne trouve aucun recouvrement de données qui influe nettement sur les résultats. Enfin, un modèle de 137 milliards de paramètres coûte cher à déployer.
Comment la suite a répondu à cet article
À la même époque, BigScience, emmené par Hugging Face, publie T0, qui applique une méthode similaire, un entraînement multitâche par prompts sur un T5 de 11 milliards de paramètres, et observe lui aussi un gain de capacité zero-shot. Cela ne concorde pas tout à fait avec le résultat de FLAN selon lequel les modèles de 8B et moins se dégradent ; les deux travaux diffèrent par le modèle de base et par le nombre de tâches et de gabarits.
Un an plus tard, Chung et al., chez Google, étendent dans Scaling Instruction-Finetuned Language Models les tâches d'affinage à 1 836, en y ajoutant des données de chaîne de pensée. Sur des évaluations comme MMLU ou BBH, même Flan-T5-Small, avec 80 millions de paramètres, progresse par rapport au T5-Small d'origine. Ces évaluations diffèrent du cadre « mettre de côté tout un type de tâche » de cet article, et les conclusions des deux ne se comparent pas directement ; ce qu'elles montrent, c'est que la capacité d'un petit modèle à profiter de l'instruction tuning dépend beaucoup du nombre et de la diversité des tâches.
OpenAI a abordé la question sous un autre angle dans l'article InstructGPT. L'équipe a affiné GPT-3 175B sur les données de FLAN et de T0, puis comparé les résultats sur de vrais prompts d'utilisateurs de l'API. Ces deux modèles font mieux que le GPT-3 d'origine, mais perdent face au modèle affiné de façon supervisée sur les seules démonstrations des annotateurs ; les sorties d'InstructGPT sont préférées dans 78 % des cas face à la version FLAN, et dans 79 % face à la version T0. Leur explication est que les jeux de données NLP publics sont surtout des tâches de classification et de questions-réponses faciles à noter automatiquement, qui ne représentent qu'environ 18 % des usages réels, alors que la génération ouverte et le brainstorming en représentent environ 57 %.
Conclusion
Réécrivez 62 jeux de données existants sous forme d'instructions, affinez dessus un modèle de 137B, et il bat GPT-3 en zero-shot sur des types de tâches qu'il n'a jamais pratiqués. Tout le soin est mis dans la conception expérimentale, avec un type de tâche entier mis de côté comme sujet d'examen, et une démonstration en règle que le progrès vient des instructions elles-mêmes.
Quand vous préparez vous-même des données d'instructions, deux choses sont à reprendre telles quelles. Plus les types de tâches sont variés, mieux c'est ; et pour une même tâche, mieux vaut préparer plusieurs formulations, car un simple changement de formulation peut faire varier le score d'une bonne dizaine de points.
Aujourd'hui, quand on parle d'instruction tuning, tout le monde pense aux chatbots. Sous sa forme d'origine, c'était une pile de sujets d'examen de NLP réécrits.