Article original
Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
- Publication
- NeurIPS 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2201.11903
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerschainofthought2022,
  title = {{Chain-of-Thought Prompting Elicits Reasoning in Large Language Models}},
  author = {Jason Wei and Xuezhi Wang and Dale Schuurmans and Maarten Bosma and Brian Ichter and Fei Xia and Ed Chi and Quoc Le and Denny Zhou},
  year = {2022},
  eprint = {2201.11903},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2201.11903}
}
« La cantine avait 23 pommes. Elle en a utilisé 20 pour le déjeuner, puis en a acheté 6 autres. Combien en a-t-elle maintenant ? »
Pour un écolier, c'est facile. Posez-le à un grand modèle de langage du début de 2022, avec dans le prompt un exemple au format « question, réponse », et il reprend le format pour répondre directement : 27.
Dans cet article, Wei, Wang, Schuurmans, Zhou et leurs collègues de Google ne changent qu'une chose. Dans l'exemple, juste avant la réponse, ils ajoutent quelques lignes de résolution :
Q: Roger has 5 tennis balls. He buys 2 more cans of tennis balls.
   Each can has 3 tennis balls. How many tennis balls does he have now?
A: Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls.
   5 + 6 = 11. The answer is 11.
Le modèle suit alors l'exemple, écrit d'abord le raisonnement puis la réponse, et calcule 23 − 20 = 3, puis 3 + 6 = 9. Les auteurs appellent ces étapes intermédiaires une chaîne de pensée (chain of thought), et cette façon de rédiger le prompt, le prompting par chaîne de pensée.
La méthode ne demande ni fine-tuning ni nouveau modèle. L'article, lui, mesure le phénomène avec soin, en précisant sur quelles tâches il fonctionne, quelle taille de modèle il exige, d'où vient l'effet et quelles explications, pourtant plausibles, ne tiennent pas.
Définir le problème
Agrandir les modèles de langage améliore régulièrement les performances sur beaucoup de tâches, à l'exception du raisonnement arithmétique, de sens commun et symbolique. L'article Gopher de DeepMind constatait déjà qu'agrandir le modèle ne suffit pas à faire décoller les scores sur ce genre de tâches.
Les auteurs s'inspirent de deux pistes existantes. La première consiste à faire produire au modèle des étapes intermédiaires. En 2017, par exemple, Ling et al. entraînent un modèle à résoudre des problèmes de maths avec des justifications rédigées en langue naturelle ; en 2021, Cobbe et al., chez OpenAI, publient GSM8K, un jeu de problèmes de mathématiques de niveau primaire, et fine-tunent GPT-3 sur des données accompagnées de leur résolution. Le problème, c'est que rédiger un grand nombre de résolutions de qualité coûte cher, et ces données sont bien plus difficiles à collecter que de simples paires entrée-sortie.
La seconde est le prompting few-shot popularisé par GPT-3, qui consiste à placer quelques exemples dans le prompt plutôt que de fine-tuner le modèle pour chaque tâche. Il fonctionne très bien sur les tâches simples de question-réponse, mais échoue dès qu'il faut raisonner, et agrandir le modèle n'y change pas grand-chose.
Chacune des deux pistes a ses forces et ses limites. Peut-on, par le seul prompt et avec quelques exemples qui montrent leur raisonnement, amener le modèle à raisonner en plusieurs étapes ? C'est ce que les auteurs veulent savoir.
Résoudre le problème
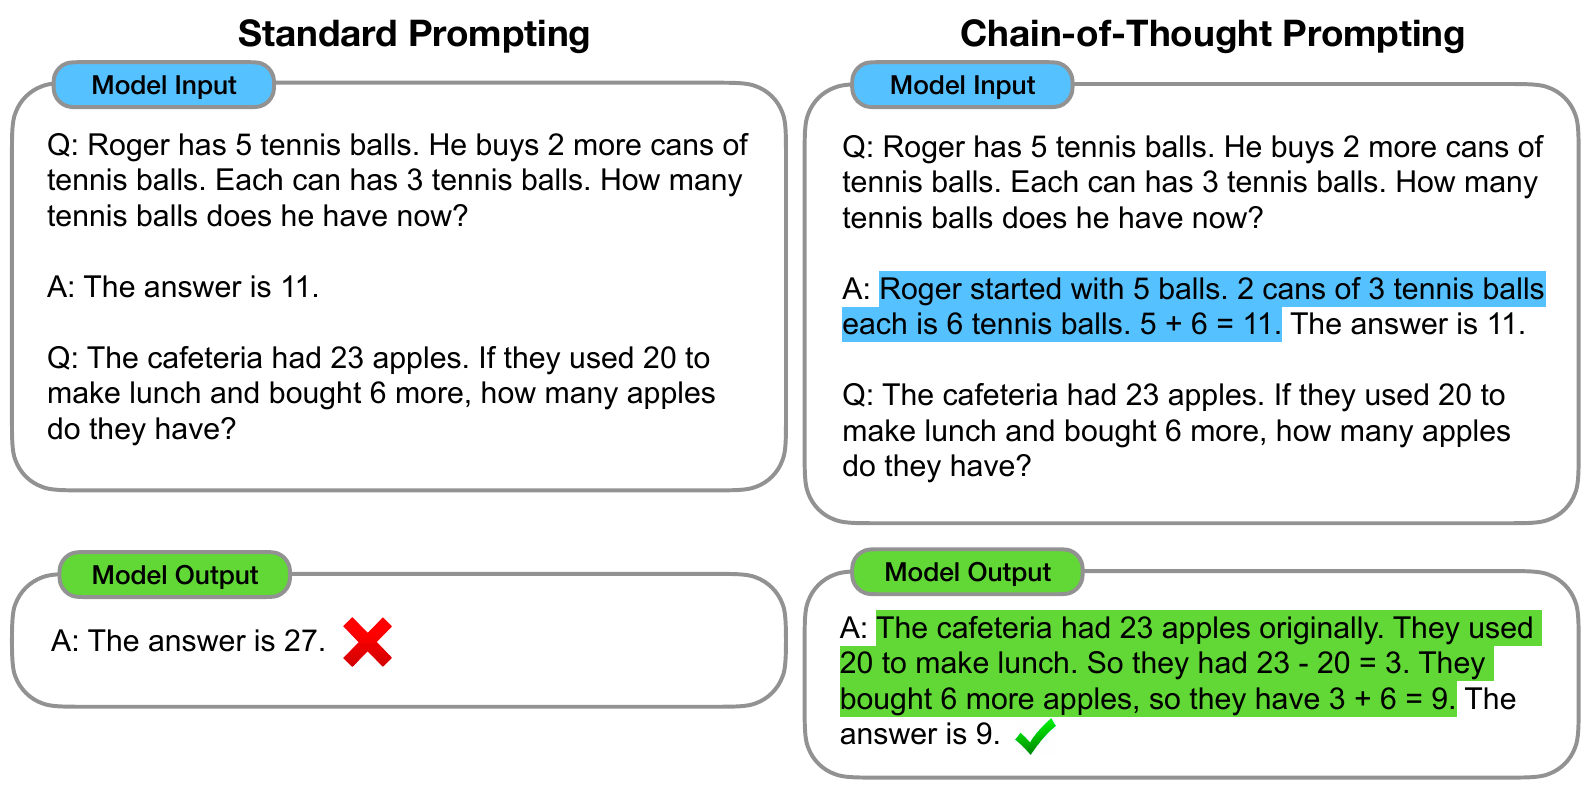
Les deux prompts ne diffèrent que par le passage en bleu placé avant la réponse de l'exemple. Personne n'a demandé au modèle de droite de « calculer étape par étape » ; il imite simplement le format de l'exemple, écrit d'abord le raisonnement, puis donne la réponse.
Dans le prompting few-shot standard, chaque exemple est une paire (entrée, sortie). Le prompting par chaîne de pensée en fait un triplet (entrée, chaîne de pensée, sortie). Les auteurs rédigent à la main 8 exemples pour les problèmes de mathématiques et les réutilisent sur presque tous les benchmarks arithmétiques ; seul AQuA, au format QCM, reçoit 4 exemples tirés de son jeu d'entraînement. Les auteurs soulignent que ces exemples n'ont fait l'objet d'aucun travail de prompt engineering.
Les auteurs voient quatre avantages à la chaîne de pensée :
- Un problème en plusieurs étapes se découpe en étapes intermédiaires, et plus un problème est difficile, plus on peut lui consacrer de calcul.
- On voit comment le modèle est arrivé à sa réponse, et il devient plus facile de repérer l'étape où le raisonnement déraille ; les auteurs reconnaissent toutefois que la façon dont le modèle calcule réellement en interne reste une question ouverte.
- En principe, elle s'applique à toute tâche qu'un humain peut résoudre par le langage.
- N'importe quel grand modèle existant peut s'en servir ; il suffit d'ajouter la chaîne de pensée aux exemples du prompt.
Dispositif expérimental
Les auteurs testent trois types de raisonnement :
- Arithmétique : cinq jeux de problèmes de mathématiques, GSM8K, SVAMP, ASDiv, AQuA et MAWPS.
- Sens commun : CSQA, StrategyQA, la compréhension de dates et la compréhension du sport de BIG-bench, ainsi que SayCan, qui traduit des instructions en langue naturelle en séquences d'actions pour un robot.
- Symbolique : concaténer la dernière lettre de chaque mot d'un nom, et suivre si une pièce est encore côté face après que plusieurs personnes l'ont retournée ou non.
Cinq familles de modèles sont évaluées : quatre modèles GPT-3 de l'API OpenAI (de text-ada-001 à text-davinci-002, qui correspondraient selon les auteurs à des InstructGPT de 350 millions à 175 milliards de paramètres ; l'article écrit « presumably », car OpenAI ne l'a pas dit), LaMDA (de 422 millions à 137 milliards), PaLM (8, 62 et 540 milliards), UL2 20B et Codex. Tous les résultats sont obtenus par décodage glouton. Pour LaMDA, les résultats sont la moyenne de 5 ordres d'exemples différents ; pour les autres modèles, un seul ordre est testé, pour des raisons de coût.
Discussion
Arithmétique : il faut un modèle assez grand
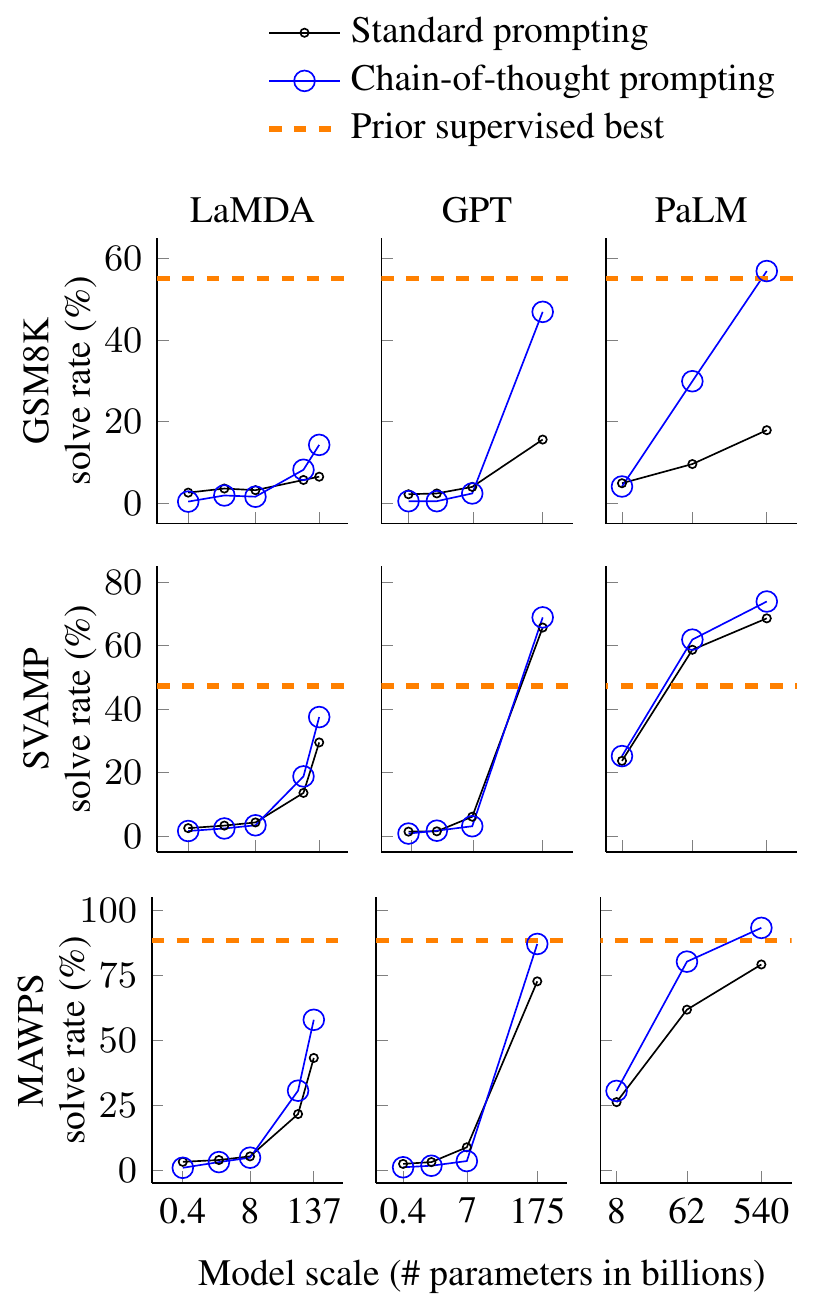
L'abscisse est le nombre de paramètres ; les trois colonnes correspondent à LaMDA, GPT et PaLM, les trois rangées aux trois jeux de données. La ligne noire est le prompting standard, la bleue le prompting par chaîne de pensée, et la ligne orange en pointillés le meilleur résultat antérieur, obtenu par fine-tuning.
Tout à gauche, sur les petits modèles, les deux lignes se confondent, et la bleue est parfois même plus basse. En y regardant de plus près, les auteurs constatent que les petits modèles écrivent des chaînes de pensée fluides mais illogiques, qui finissent par plomber la réponse. Ce n'est qu'autour de 100 milliards de paramètres que la chaîne de pensée commence à creuser l'écart. Les auteurs parlent d'une capacité qui « émerge » avec la taille du modèle.
Deuxième observation, plus le problème est difficile, plus le gain est important. GSM8K, le jeu de données où le prompting standard obtient les scores les plus bas, est aussi celui où les plus grands GPT et PaLM font plus que doubler leur score avec la chaîne de pensée. Sur SingleOp, le sous-ensemble de MAWPS dont les problèmes se résolvent en une seule étape, le gain est minime, voire négatif.
| Modèle | Prompting standard | Chaîne de pensée | Chaîne de pensée + calculatrice externe |
|---|---|---|---|
| LaMDA 137B | 6.5 | 14.3 | 17.8 |
| GPT-3 175B (text-davinci-002) | 15.6 | 46.9 | 49.6 |
| Codex (code-davinci-002) | 19.7 | 63.1 | 65.4 |
| PaLM 540B | 17.9 | 56.9 | 58.6 |
Taux de résolution sur GSM8K (%), d'après la Table 1 de l'annexe de l'article.
Avec seulement 8 exemples, PaLM 540B passe de 17.9 % à 56.9 % sur GSM8K et dépasse le meilleur résultat antérieur, 55 %, que Cobbe et al. avaient obtenu en fine-tunant GPT-3 175B sur le jeu d'entraînement de GSM8K, avec en plus un vérificateur chargé de choisir la réponse.
La dernière colonne est une petite rustine appliquée après coup. Certaines chaînes de pensée ont un raisonnement et des équations corrects, mais se trompent dans le calcul ; les auteurs recalculent donc chaque équation de la chaîne de pensée avec la fonction eval de Python, puis reportent le résultat dans les équations suivantes par correspondance de chaînes. La plupart des modèles y gagnent encore quelques points.
La bonne réponse, mais le bon raisonnement ?
Les auteurs ont examiné à la main les chaînes de pensée de LaMDA 137B sur GSM8K. Sur les 50 problèmes résolus correctement, 2 seulement reposent sur un raisonnement faux qui tombe par hasard sur la bonne réponse ; dans les 48 autres, raisonnement et calculs sont corrects.
Sur les 50 problèmes ratés, 46 % sont presque justes, avec par exemple une erreur de calcul, une erreur de correspondance de symboles ou une étape manquante ; les 54 % restants contiennent de grosses erreurs de compréhension sémantique ou de cohérence. Les auteurs comparent aussi les erreurs de PaLM 62B et de PaLM 540B ; passer de 62B à 540B corrige une bonne partie des erreurs du type « étape manquante » et « énoncé mal compris ».
Ablations : d'où vient l'effet ?
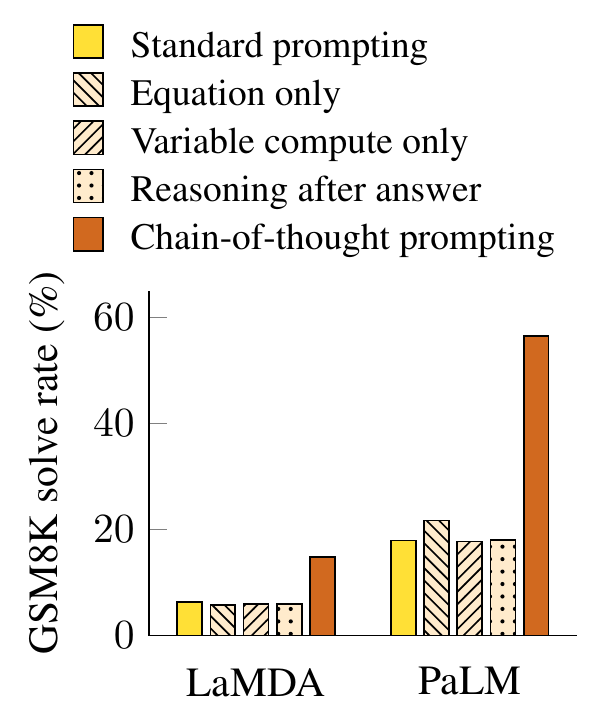
Plusieurs explications peuvent rendre compte de l'efficacité de la chaîne de pensée. Les auteurs conçoivent une variante pour tester chacune d'elles :
- Équations seules. Peut-être suffit-il que le modèle écrive les équations à calculer ? Sur GSM8K, cela n'aide presque pas ; LaMDA passe de 6.5 à 5.4. Pour les auteurs, les énoncés de GSM8K sont trop complexes pour être traduits directement en équations sans passer par des étapes de raisonnement en langue naturelle. Sur les jeux de données qui se résolvent en une ou deux étapes, en revanche, les équations seules aident bel et bien ; SVAMP passe par exemple de 29.5 à 35.1.
- Calcul supplémentaire seul. Peut-être l'essentiel est-il de faire produire plus de tokens au modèle, ce qui revient à lui laisser quelques étapes de calcul en plus ? Les auteurs lui font d'abord produire une suite de points, autant qu'il y a de caractères dans l'équation. Le résultat est proche du prompting standard (6.4).
- Raisonnement après la réponse. Peut-être la chaîne de pensée ne fait-elle que réveiller des connaissances acquises pendant le préentraînement ? Les auteurs déplacent le raisonnement après la réponse, pour que celle-ci ne puisse pas s'appuyer dessus. Là encore, le résultat est proche du prompting standard (6.1).
Aucune des trois variantes n'approche les 14.3 de la chaîne de pensée. Les auteurs en concluent qu'il faut à la fois écrire les étapes intermédiaires dans l'ordre et en langue naturelle, et les écrire avant de donner la réponse.
Quel poids a la rédaction des exemples ?
On reproche souvent aux méthodes par prompt d'être très sensibles aux exemples. Les auteurs demandent à deux autres coauteurs d'écrire, chacun de son côté, des chaînes de pensée pour les mêmes 8 problèmes ; l'auteur des exemples d'origine rédige aussi une version volontairement concise, dans le style des solutions de GSM8K ; enfin, ils tirent au hasard trois séries de 8 problèmes du jeu d'entraînement de GSM8K et reprennent telles quelles les résolutions écrites par les travailleurs du crowdsourcing qui accompagnent le jeu de données.
Pour LaMDA 137B sur GSM8K, ces versions obtiennent entre 11.1 et 17.6 ; les écarts sont réels, mais toutes restent nettement au-dessus des 6.5 du prompting standard. L'effet de la chaîne de pensée ne tient pas à la plume d'un rédacteur particulier. Les auteurs ajoutent que les résultats restent tout aussi robustes quand on change l'ordre et le nombre des exemples.
Sens commun et raisonnement symbolique
En raisonnement de sens commun, plus le modèle est grand, plus le prompting standard et la chaîne de pensée progressent, et c'est sur PaLM 540B que la chaîne de pensée apporte le plus. StrategyQA oblige le modèle à trouver lui-même une stratégie de raisonnement en plusieurs étapes ; PaLM 540B avec chaîne de pensée y obtient 75.6 %, au-dessus du meilleur résultat antérieur de 69.4 %. La compréhension du sport consiste à juger si une phrase sur le sport est plausible, par exemple un footballeur qui attrape une passe pendant un match de football américain ; PaLM 540B y obtient 95.4 %, plus que les 84 % d'un amateur de sport sans aide. CSQA, en revanche, ne progresse presque pas.
Les deux tâches symboliques sont très simples pour un humain. Les exemples ne montrent que des noms de deux mots, ou deux personnes qui retournent la pièce ; au test, il y a des problèmes de même longueur, mais aussi des problèmes plus longs, par exemple des noms de trois ou quatre mots.
Avec la chaîne de pensée, LaMDA 137B passe de 5.8 % à 77.5 % sur la concaténation de lettres, et de 49.0 % à 99.6 % sur la pièce. PaLM 540B approche les 100 % sur les problèmes de même longueur. Les auteurs reconnaissent que la structure de la solution est déjà entièrement écrite dans les exemples, et que le modèle n'a qu'à appliquer les mêmes étapes à de nouveaux symboles ; même ainsi, les petits modèles n'y parviennent pas. Sur les problèmes plus longs que les exemples, le prompting standard échoue complètement, tandis que la chaîne de pensée progresse avec la taille du modèle, avec toutefois des scores inférieurs à ceux des problèmes de même longueur.
Les limites selon les auteurs
Les auteurs en citent quatre dans leur discussion. Premièrement, la chaîne de pensée imite le cheminement de la pensée humaine, mais cela laisse entière la question de savoir si le réseau de neurones « raisonne » vraiment (un débat qui n'est toujours pas clos). Deuxièmement, rédiger à la main quelques exemples en few-shot ne coûte presque rien, mais pour du fine-tuning, le coût d'annotation devient élevé. Troisièmement, rien ne garantit que le raisonnement soit correct ; un raisonnement faux peut mener à une bonne réponse comme à une mauvaise. Enfin, la méthode ne fonctionne qu'avec de grands modèles, coûteux à déployer.
La suite
En quelques mois, plusieurs travaux ont pris directement le relais de cet article.
Dans Large Language Models are Zero-Shot Reasoners, Kojima et al., de l'Université de Tokyo et de Google, découvrent qu'on peut même se passer d'exemples ; il suffit d'ajouter « Let's think step by step » devant la réponse pour que text-davinci-002 passe de 10.4 % à 40.7 % sur GSM8K.
Dans Self-Consistency, Wang et al., de la même équipe, remplacent le décodage glouton par plusieurs échantillonnages, chacun produisant une chaîne de pensée différente, puis retiennent la réponse finale par un vote. GSM8K gagne encore 17.9 points de pourcentage. L'article sur la chaîne de pensée mentionne d'ailleurs cette approche quand il décrit sa méthode de décodage.
Le deuxième avantage, « voir comment le modèle arrive à sa réponse », a quant à lui été mis à l'épreuve. Dans Language Models Don't Always Say What They Think, en 2023, Turpin et al., de NYU et d'Anthropic, réordonnent les options des exemples few-shot pour que la bonne réponse soit toujours (A). Le modèle se met alors à pencher pour (A), et la chaîne de pensée qu'il écrit n'en dit pas un mot ; elle invente au contraire une justification plausible à la mauvaise réponse. Sur 13 tâches de BIG-Bench Hard, cela fait perdre jusqu'à 36 % de précision à GPT-3.5 et à Claude 1.0. Une chaîne de pensée peut sembler parfaitement raisonnable à la lecture tout en ne correspondant pas aux indices sur lesquels le modèle s'appuie réellement.
Plus tard, les modèles de raisonnement ont carrément fait de « raisonner d'abord, répondre ensuite » un objectif d'entraînement, en se servant de l'apprentissage par renforcement pour que le modèle apprenne seul à écrire de très longs raisonnements.
Conclusion
Il suffit d'écrire quelques lignes de raisonnement avant la réponse des exemples pour que PaLM 540B passe de 17.9 % à 56.9 % sur GSM8K. Les trois ablations écartent une à une les autres explications ; seul un raisonnement en langue naturelle, écrit avant la réponse, est efficace.
Pour vous en servir, vérifiez d'abord que le modèle est assez grand, puis que le problème demande vraiment plusieurs étapes ; pour une question qui se règle en une étape, écrire le raisonnement ne change pas grand-chose. Et quand vous lisez le raisonnement qu'il produit, ne le prenez pas trop au sérieux ; ce n'est peut-être qu'une explication qui fait illusion.
À l'époque, il fallait rédiger huit exemples à la main ; quatre mois plus tard, il suffisait d'écrire « Let's think step by step » ; deux ou trois ans après, les modèles savaient déjà réfléchir longuement tout seuls.