Article original
Direct Preference Optimization: Your Language Model is Secretly a Reward Model
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2305.18290
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningdpo2023,
  title = {{Direct Preference Optimization: Your Language Model is Secretly a Reward Model}},
  author = {Rafael Rafailov and Archit Sharma and Eric Mitchell and Stefano Ermon and Christopher D. Manning and Chelsea Finn},
  year = {2023},
  eprint = {2305.18290},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.18290}
}
En 2023, le pipeline RLHF est bien rodé. On commence par un fine-tuning supervisé (SFT), on collecte ensuite les préférences humaines entre deux réponses pour entraîner un modèle de récompense, et l'on finit avec PPO, qui pousse le modèle de langage à décrocher de bons scores tout en le retenant par une pénalité KL, pour qu'il ne s'éloigne pas trop du modèle d'origine.
Ce pipeline marche bien, c'est ainsi qu'a été entraîné ChatGPT, mais il est lourd. Pendant l'entraînement PPO, il faut garder plusieurs grands modèles en mémoire à la fois, à savoir la politique en cours d'entraînement, le modèle de référence figé, le modèle de récompense et, en général, une fonction de valeur ; il faut aussi échantillonner sans cesse la politique pendant l'entraînement, les hyperparamètres sont nombreux, et l'entraînement devient facilement instable.
Dans cet article, Rafailov, Sharma, Mitchell et leurs collègues de Stanford présentent un résultat un peu surprenant. L'objectif que RLHF cherche à optimiser peut en fait se résoudre directement, sans apprentissage par renforcement, avec une simple perte de classification binaire. Pas besoin non plus d'entraîner un modèle de récompense à part, puisque le modèle de langage en contient déjà un, implicitement.
Définir le problème
Commençons par mettre RLHF en équations.
Pour un prompt , le modèle SFT produit deux réponses ; l'annotateur désigne la meilleure, , et la moins bonne, . On suppose que ces préférences reposent sur une récompense réelle non observée et suivent le modèle de Bradley-Terry, c'est-à-dire que la probabilité que « l'emporte sur » dépend de l'écart entre leurs récompenses :
La première étape entraîne le modèle de récompense par maximum de vraisemblance :
La seconde étape pousse la politique vers les scores élevés, sans la laisser trop s'éloigner du modèle de référence (en général le modèle SFT lui-même) :
règle la longueur de la laisse. Comme la génération de texte est discrète, cet objectif n'est pas directement dérivable ; c'est pour cela qu'il faut des algorithmes d'apprentissage par renforcement comme PPO.
Peut-on alors fusionner ces deux étapes en une seule ?
Résoudre le problème
La politique optimale a une forme close
Tout se joue dans le problème de maximisation sous contrainte KL de la deuxième étape. Des travaux antérieurs ont montré que sa solution optimale s'écrit explicitement :
Autrement dit, on part du modèle de référence, on multiplie la probabilité de chaque réponse par un facteur d'autant plus grand que sa récompense est élevée, puis on renormalise l'ensemble.
Si la solution a une forme close, pourquoi tout le monde utilise-t-il encore PPO ? Parce que exige de sommer sur toutes les réponses possibles, ce qui est tout simplement incalculable pour un modèle de langage.
L'écrire dans l'autre sens
Les auteurs retournent l'équation ci-dessus ; en prenant le logarithme des deux côtés, ils expriment la récompense à partir de la politique :
est toujours là, mais il ne dépend que du prompt , et pas de la réponse . Or le modèle de Bradley-Terry ne regarde que l'écart de récompense entre deux réponses ; quand on fait la différence entre deux réponses au même prompt, disparaît :
La récompense implicite ne diffère de la récompense d'origine que de . Cette constante est la même pour toutes les réponses à un même prompt ; elle s'annule donc dans la différence entre deux récompenses, et la formule ci-dessus donne, à partir de la seule politique, exactement la même probabilité de préférence que la récompense d'origine.
La perte DPO
Puisque la probabilité de préférence s'écrit uniquement avec la politique, on peut s'en servir directement à la place du maximum de vraisemblance de l'étape du modèle de récompense. On remplace par la politique à entraîner, :
C'est exactement la perte du modèle de récompense, avec à la place de . Entraîner le modèle de langage revient à entraîner un modèle de récompense, dont la politique optimale est le modèle de langage lui-même. C'est tout le sens du sous-titre de l'article, « votre modèle de langage est en secret un modèle de récompense ».
Les auteurs démontrent aussi que ce changement de variable ne restreint pas les fonctions de récompense représentables. Toute partie qui, comme , ne dépend que du prompt est de toute façon sans effet sur la probabilité de préférence comme sur la politique optimale ; chaque classe de fonctions de récompense équivalentes peut s'écrire sous la forme .
L'implémentation tient en quelques lignes, et l'annexe de l'article donne directement le code PyTorch. Faisons l'essai avec deux paires de préférences ; la log-probabilité de chaque réponse est la somme sur toute la phrase :
import torch
import torch.nn.functional as F

def dpo_loss(pi_logps, ref_logps, yw_idxs, yl_idxs, beta):
    """Implémentation de l'annexe B de l'article"""
    pi_yw_logps, pi_yl_logps = pi_logps[yw_idxs], pi_logps[yl_idxs]
    ref_yw_logps, ref_yl_logps = ref_logps[yw_idxs], ref_logps[yl_idxs]
    pi_logratios = pi_yw_logps - pi_yl_logps
    ref_logratios = ref_yw_logps - ref_yl_logps
    losses = -F.logsigmoid(beta * (pi_logratios - ref_logratios))
    rewards = beta * (pi_logps - ref_logps).detach()
    return losses, rewards

# deux paires de préférences : la réponse 0 l'emporte sur la 1, la 2 sur la 3 (log-probabilités des réponses entières)
ref_logps = torch.tensor([-12.0, -11.0, -20.0, -21.0])
pi_logps = torch.tensor([-11.0, -12.0, -21.0, -18.0], requires_grad=True)
yw, yl = torch.tensor([0, 2]), torch.tensor([1, 3])

losses, rewards = dpo_loss(pi_logps, ref_logps, yw, yl, beta=0.1)
losses.sum().backward()
print(losses.detach().numpy().round(3), rewards.numpy().round(2))
print(pi_logps.grad.numpy().round(3))

# [0.598 0.913] [ 0.1 -0.1 -0.1  0.3]
# [-0.045  0.045 -0.06   0.06 ]
Dans la première paire, la politique préfère déjà la bonne réponse plus nettement que le modèle de référence ; les récompenses implicites valent 0.1 contre −0.1, l'ordre est correct, et la perte vaut 0.598. Dans la seconde, la politique a au contraire augmenté la probabilité de la mauvaise réponse, la 3 ; les récompenses implicites valent −0.1 contre 0.3, l'ordre est faux, et la perte vaut 0.913.
Les gradients vont dans le même sens, ils poussent vers le haut la probabilité de la bonne réponse et vers le bas celle de la mauvaise. La différence tient à leur amplitude, 0.06 pour la seconde paire contre 0.045 pour la première. En développant le gradient, on voit pourquoi :
est la récompense implicite. Plus la récompense implicite classe mal une paire, plus cette paire pèse lourd ; celles qui sont déjà bien classées pèsent peu. Les auteurs signalent aussi qu'une version simplifiée, sans ce poids, fait dégénérer le modèle de langage ; l'annexe contient l'expérience correspondante.
Le pipeline se réduit à deux étapes. Pour chaque prompt, on échantillonne deux réponses et l'on fait annoter la préférence, puis on entraîne directement avec la perte DPO. En pratique, on réutilise plus souvent un jeu de préférences existant ; le modèle de référence est idéalement le modèle SFT qui a produit ces réponses, et à défaut, on fait d'abord un fine-tuning supervisé sur les réponses préférées du jeu de données pour obtenir le modèle de référence.
Les hyperparamètres ne demandent presque aucun réglage. Par défaut, l'article utilise (et pour la tâche de résumé), une taille de lot de 64, RMSprop, un taux d'apprentissage de et un échauffement linéaire sur les 150 premières étapes.
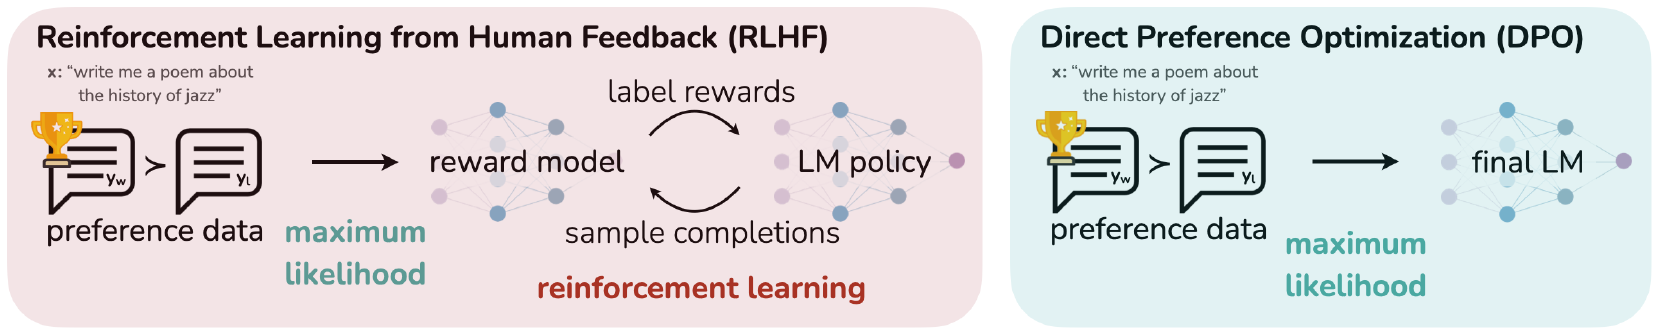
Mis côte à côte, les deux schémas parlent d'eux-mêmes. Le modèle de récompense et la boucle d'apprentissage par renforcement de RLHF sont remplacés en bloc par une seule étape de maximum de vraisemblance.
Discussion
Les auteurs comparent les méthodes sur trois tâches, avec des modèles d'au plus 6 milliards de paramètres.
Même objectif, qui l'optimise le mieux ?
La première tâche est la génération à sentiment contrôlé. À partir du début d'une critique IMDb, le modèle doit poursuivre avec une critique positive. Les préférences y sont produites par un classifieur de sentiment préentraîné ; la « récompense réelle » est donc connue, ce qui permet de comparer précisément les algorithmes. Le modèle est GPT-2-large.
L'objectif de RLHF demande à la fois un score élevé et une politique proche du modèle de référence ; pour comparer, il faut donc regarder le compromis entre récompense et divergence KL, et pas seulement le score. Les auteurs balaient différents hyperparamètres pour chaque méthode, soit 22 entraînements au total.
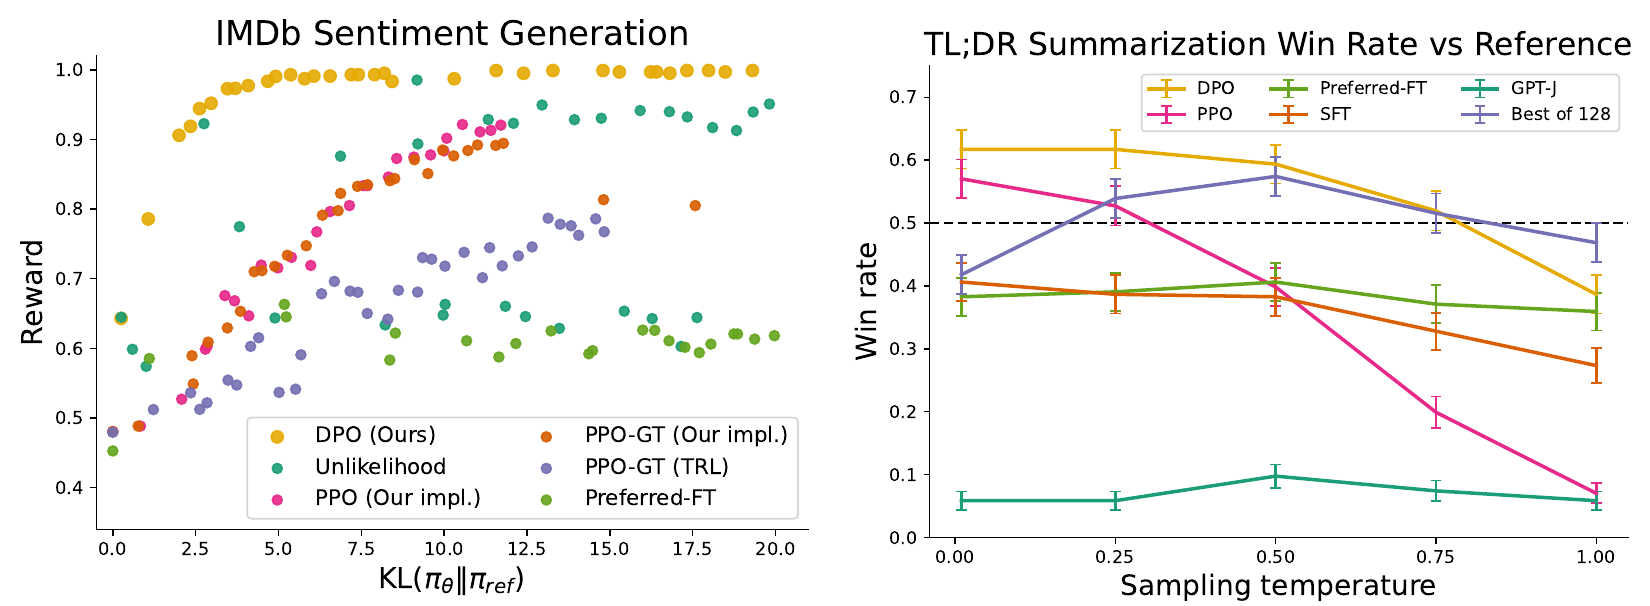
Commençons par la figure de gauche. L'abscisse est la divergence KL par rapport au modèle de référence, l'ordonnée la récompense ; plus on est en haut à gauche, mieux c'est. DPO, en jaune, pousse la récompense près de 1 alors que le KL est encore très faible, et toute sa frontière passe au-dessus des autres méthodes. PPO optimise le même objectif, mais nettement moins efficacement ; même PPO-GT, qui lit directement la récompense réelle, a une frontière moins bonne que DPO.
Résumé et dialogue
La figure de droite porte sur la deuxième tâche, le résumé Reddit TL;DR, avec justement les préférences humaines collectées par Stiennon et al. Toutes les méthodes partent du même modèle SFT GPT-J, et GPT-4 juge lequel est meilleur, du résumé du modèle ou du résumé de référence écrit par un humain.
À température 0, DPO atteint un taux de victoire d'environ 61 %, contre environ 57 % pour PPO à sa meilleure température (0 également). La différence la plus nette apparaît quand la température monte ; PPO dégringole jusqu'au niveau d'un GPT-J non fine-tuné, alors que DPO reste bien plus stable. Les auteurs ont aussi mené une évaluation humaine ; face à PPO (température 0), DPO (température 0.25) est préféré dans 58 % des cas.
La troisième tâche est le dialogue à un tour d'Anthropic HH, environ 170 000 conversations, chacune terminée par deux réponses et une préférence humaine. Faute de modèle SFT disponible, les auteurs fine-tunent d'abord Pythia-2.8B sur les réponses préférées du jeu de données pour en faire le modèle de référence, puis appliquent DPO.
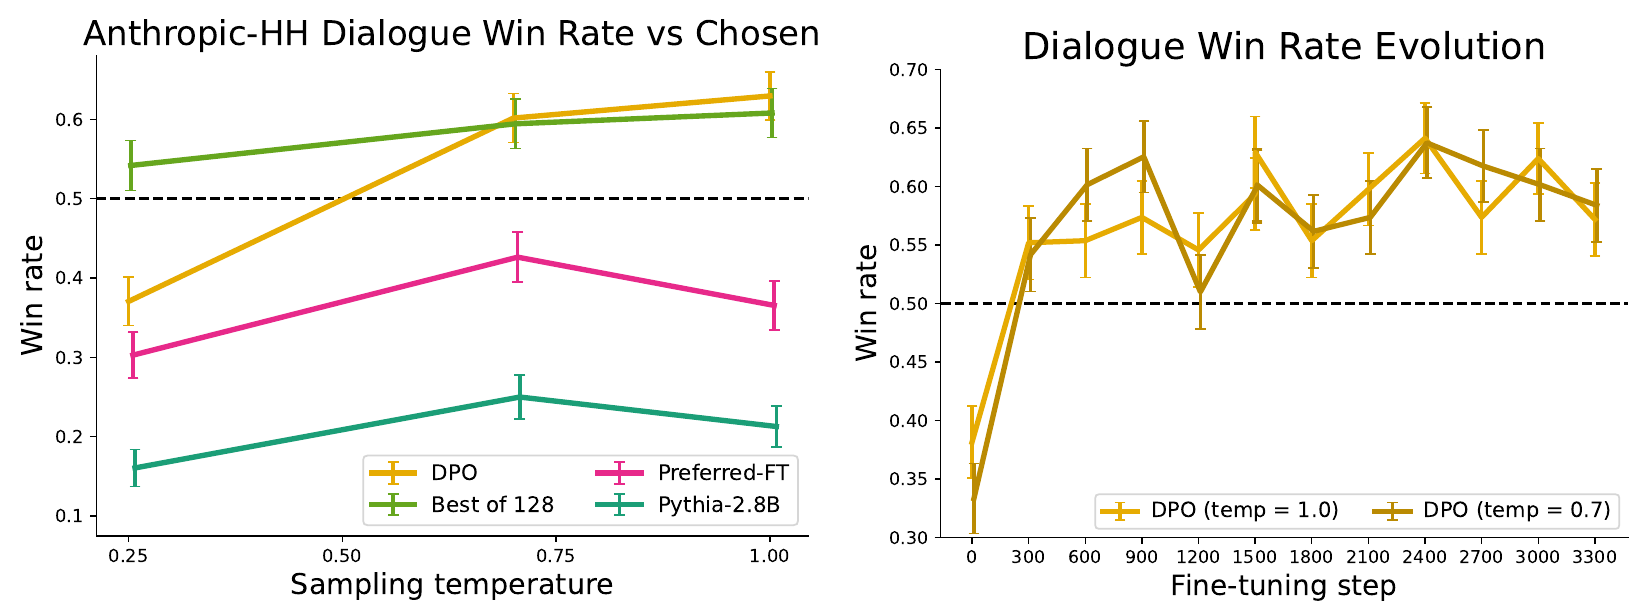
La ligne pointillée à 0.5 correspond à l'égalité avec les réponses retenues dans le jeu de données. DPO est la seule méthode à passer au-dessus sans échantillonnage massif ; best of 128 la dépasse aussi, mais il faut tirer 128 réponses par question et laisser le modèle de récompense choisir, pour un coût d'inférence bien plus élevé. Les auteurs ont aussi essayé une version publique de PPO, sans trouver ni prompt ni température qui lui permette de battre le Pythia-2.8B de départ. La figure de droite montre que DPO converge vite ; quelques centaines d'étapes suffisent pour approcher son meilleur niveau.
Sur des données jamais vues
Les auteurs reprennent tels quels les modèles entraînés sur TL;DR pour résumer des articles de presse de CNN/DailyMail, histoire de voir s'ils n'ont appris que le style de Reddit. Avec GPT-4 comme juge, le taux de victoire face aux résumés écrits par des humains est de 0.36 pour DPO contre 0.26 pour PPO à température 0, et de 0.31 contre 0.23 à température 0.25. DPO reste devant, alors même que PPO a utilisé en plus, pendant son entraînement, des prompts Reddit non annotés.
Peut-on se fier à GPT-4 comme juge ?
Toutes ces expériences reposent sur GPT-4 comme juge ; les auteurs ont donc vérifié son accord avec les humains. Avec le prompt le plus simple, qui demande « quel résumé couvre le mieux l'essentiel », GPT-4 apprécie plus que les humains les résumés longs et répétitifs ; avec un prompt qui demande aussi la concision, ses jugements se rapprochent de ceux des humains. Sur trois comparaisons, l'accord entre GPT-4 et les humains va de 67 % à 86 %, et celui des humains entre eux de 65 % à 87 %, soit à peu près le même niveau.
Questions encore ouvertes
Les auteurs en dressent eux-mêmes la liste :
- Sur des données jamais vues, une politique DPO fera-t-elle toujours aussi bien que les méthodes entraînées avec un modèle de récompense explicite ? L'expérience de résumé d'articles de presse ci-dessus n'en est qu'un premier indice.
- Sous quelle forme la sur-optimisation de la récompense se manifeste-t-elle avec DPO ? La légère baisse du taux de victoire de DPO en fin d'entraînement, dans l'expérience de dialogue, en est-elle un exemple ?
- Les expériences s'arrêtent à 6B ; peut-on passer à des modèles plus grands de plusieurs ordres de grandeur ?
- Les notes de GPT-4 varient selon le prompt ; comment obtenir des jugements fiables d'un évaluateur automatique ?
La suite
DPO a très vite été adopté à grande échelle. En 2024, le post-entraînement de Llama 3 se compose de plusieurs tours de SFT et de DPO ; Meta l'a aussi comparé à PPO, et a conclu que DPO demande moins de calcul sur les grands modèles et donne de meilleurs résultats en suivi d'instructions. La même année, Tülu 3 place DPO après le SFT, comme une étape de sa recette de post-entraînement entièrement publique.
Les voix critiques existent aussi. En 2024, Is DPO Superior to PPO for LLM Alignment? soutient que DPO peut trouver des solutions biaisées, qui exploitent des réponses hors de la distribution des données de préférence ; quand les sorties du modèle s'écartent beaucoup de cette distribution, ses performances baissent nettement. Avec un PPO soigneusement réglé, les auteurs de cette étude battent DPO en dialogue comme en génération de code, et l'écart est le plus grand sur les problèmes de programmation compétitive les plus difficiles.
Puis, en 2025, les modèles de raisonnement ont fait revenir l'apprentissage par renforcement, à ceci près que la récompense vient désormais souvent de réponses vérifiables automatiquement, plutôt que de préférences humaines.
Conclusion
Au cœur de DPO, il y a un changement de variable. La politique optimale sous contrainte KL a une forme close ; si on la retourne pour exprimer la récompense à partir de la politique, la fonction de partition, impossible à calculer, s'annule dans la soustraction de Bradley-Terry, et RLHF devient une perte de classification binaire. Plus de modèle de récompense à entraîner, plus d'échantillonnage pendant l'entraînement, plus de cette ribambelle d'hyperparamètres de PPO.
Si vous disposez de données de préférences par paires, DPO est la première méthode à essayer ; veillez seulement à ce que le modèle de référence soit aussi proche que possible du modèle qui a produit ces données, car si les distributions s'écartent trop, ses performances en pâtissent.
L'article affirmait qu'on pouvait se passer d'apprentissage par renforcement ; un an plus tard, le post-entraînement de Llama 3 remplaçait bel et bien PPO par DPO.