Article original
Learning to summarize from human feedback
- Publication
- NeurIPS 2020Conférence
- Premier dépôt sur arXiv
- arXiv:2009.01325
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuninglearningtosummarize2020,
  title = {{Learning to summarize from human feedback}},
  author = {Nisan Stiennon and Long Ouyang and Jeff Wu and Daniel M. Ziegler and Ryan Lowe and Chelsea Voss and Alec Radford and Dario Amodei and Paul Christiano},
  year = {2020},
  eprint = {2009.01325},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2009.01325}
}
La méthode standard pour entraîner un modèle de résumé consiste à faire de l'apprentissage supervisé sur des résumés de référence écrits par des humains, puis à l'évaluer avec ROUGE.
Ces deux étapes ne sont que des approximations d'un « bon résumé ». Le maximum de vraisemblance oblige le modèle à répartir de la probabilité sur chacun des résumés écrits par des humains, y compris les très mauvais. Il ne distingue pas non plus les erreurs graves des erreurs sans importance ; inventer un fait et choisir le mauvais synonyme pèsent à peu près autant dans la fonction de perte. ROUGE compte les mots en commun avec le résumé de référence, et sa corrélation avec le jugement humain est critiquée depuis longtemps.
Stiennon, Ouyang, Wu, Ziegler et leurs collègues d'OpenAI publient cet article en septembre 2020. Ils font directement comparer deux résumés par des humains, apprennent un modèle de récompense qui prédit les préférences humaines, puis cherchent à en maximiser le score par apprentissage par renforcement. Résultat, un modèle de 1.3 milliard de paramètres est préféré par les annotateurs plus souvent qu'un modèle supervisé 10 fois plus grand, et même plus souvent que les résumés de référence écrits par des humains dans le jeu de données.
Ce processus reprend l'« apprentissage de la récompense à partir de préférences » de Christiano et al. (2017), en remplaçant les extraits vidéo par des résumés de texte ; le chef d'équipe n'est autre que Christiano. Un an et demi plus tard, InstructGPT reprendra ces trois étapes presque à l'identique.
Définir le problème
Les auteurs ont choisi le résumé comme tâche de test parce que le sujet a une longue histoire de recherche, et que la qualité y est très subjective, difficile à mesurer sans jugement humain.
Le jeu de données est TL;DR, tiré de Reddit, avec environ 3 millions de publications, chacune accompagnée d'un résumé « trop long ; pas lu » écrit par son propre auteur. Les auteurs écartent les sous-forums incompréhensibles pour le commun des lecteurs, et ne gardent que les publications dont le résumé de référence fait entre 24 et 48 tokens, afin de limiter autant que possible l'influence de la longueur sur le jugement de qualité ; il en reste 123 169. (Ces données filtrées sont ensuite devenues un banc d'essai classique du RLHF ; trois ans plus tard, les expériences de résumé de l'article DPO s'appuient elles aussi dessus.)
Ils ont délibérément évité CNN/DailyMail, le jeu de résumé d'actualités plus courant. Sur CNN/DM, la baseline lead-3, qui prend simplement les trois premières phrases de l'article, est déjà très forte ; les annotateurs préfèrent même lead-3 aux résumés de référence du jeu de données. T5 échantillonné à basse température dépasse déjà les résumés de référence, tout en recopiant massivement le texte source. Sur TL;DR, en revanche, les baselines extractives donnent de mauvais résultats, ce qui fait mieux ressortir la vraie capacité de résumé d'un modèle.
La tâche est définie comme la production d'un résumé de moins de 48 tokens, de la meilleure qualité possible. La qualité se mesure à la fidélité avec laquelle un lecteur qui ne lit que le résumé, sans le texte d'origine, comprend de quoi parle le texte.
L'année précédente, Ziegler et al., de la même équipe, avaient déjà essayé les retours humains sur TL;DR et CNN/DM, mais s'étaient heurtés à un problème. Ils rapportaient que la « qualité » apprise par le modèle différait de celle que voulaient les chercheurs. Les résumés jugés bons par les annotateurs semblaient médiocres aux yeux des chercheurs, et le modèle s'était mis à recopier presque uniquement le texte d'origine. Comment faire, alors, pour que les retours humains reflètent vraiment la qualité voulue par les chercheurs ?
Résoudre le problème
Trois étapes
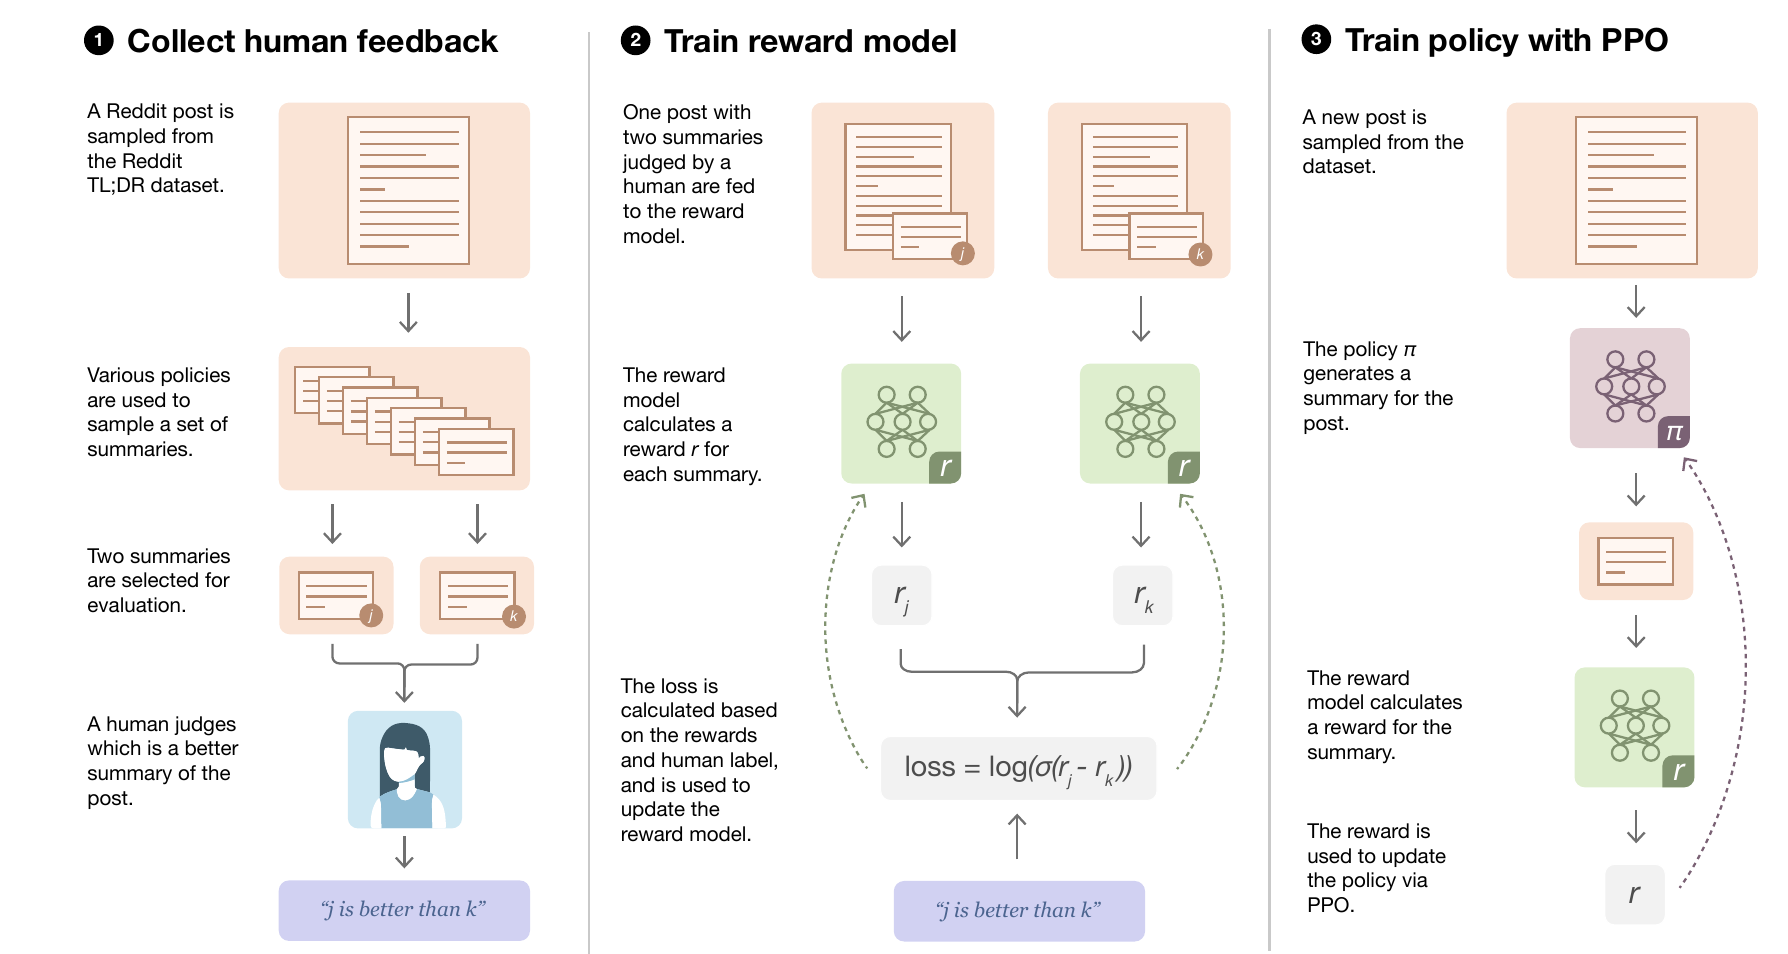
- Recueillir des comparaisons humaines : pour chaque publication, on échantillonne des résumés auprès de la politique courante, de la politique initiale, des résumés de référence et de diverses baselines, que l'on soumet deux à deux aux annotateurs pour qu'ils choisissent le meilleur.
- Entraîner le modèle de récompense : étant donné une publication et un résumé, prédire le log-odds que ce résumé soit choisi par un humain.
- Optimiser la politique avec PPO : la sortie du modèle de récompense sert de récompense pour entraîner le modèle de résumé par apprentissage par renforcement.
Ces trois étapes peuvent être répétées, les échantillons de la nouvelle politique étant à leur tour soumis aux humains pour comparaison. Les auteurs reconnaissent qu'en pratique, ils n'ont pas suivi strictement des cycles successifs, mais ont sans cesse ajusté la collecte des données et l'entraînement à mesure que les annotations s'accumulaient.
Tous les modèles sont des décodeurs Transformer de style GPT-3 ; les expériences principales utilisent 1.3 milliard (1.3B) et 6.7 milliards (6.7B) de paramètres. Le point de départ est un modèle affiné de façon supervisée sur TL;DR, appelé ensuite modèle SFT ; il sert à la fois à produire les premiers échantillons de comparaison et à initialiser la politique et le modèle de récompense, et il tient aussi lieu de baseline de comparaison.
Le modèle de récompense
Le modèle de récompense part du modèle SFT, auquel on ajoute en sortie une couche linéaire initialisée au hasard, qui produit un scalaire , où est la publication et le résumé. Si l'humain a choisi , la perte est :
C'est la même chose que la perte de Bradley–Terry de l'article de 2017, à ceci près que la somme des récompenses de deux segments de trajectoire est remplacée par les scores respectifs de deux résumés. est la sigmoïde ; plus l'écart de score entre deux résumés est grand, plus le modèle est sûr de celui que l'humain choisira. Une fois l'entraînement terminé, les auteurs décalent la sortie pour que le score moyen des résumés de référence soit 0.
La politique : PPO plus une pénalité KL
La politique est elle aussi initialisée à partir du modèle SFT. Chaque token BPE généré compte pour un pas, et un résumé terminé (émission d'EOS) forme un épisode ; le modèle de récompense ne note le résumé entier qu'une seule fois, à la fin, avec un facteur d'actualisation .
L'élément de conception clé est l'ajout d'une pénalité KL à la récompense :
est la politique en cours d'entraînement, le modèle SFT figé. Si la politique génère un résumé que le modèle SFT juge très peu probable, le second terme devient grand, et la pénalité aussi.
Faisons le calcul sur un résumé de seulement 4 tokens. En pratique, on répartit souvent la pénalité KL sur chaque token, et le score du modèle de récompense n'est ajouté qu'au dernier token :
import torch

beta = 0.05
rm_score = torch.tensor(2.0)                       # score du modèle de récompense pour le résumé entier
logp_rl = torch.tensor([-1.2, -0.4, -2.0, -0.7])   # log-probabilité de chaque token généré par la politique RL
logp_sft = torch.tensor([-1.5, -0.5, -3.1, -0.9])  # log-probabilité des mêmes tokens sous le modèle SFT

log_ratio = logp_rl - logp_sft     # tensor([0.3000, 0.1000, 1.1000, 0.2000])
rewards = -beta * log_ratio        # chaque token reçoit d'abord la pénalité KL
rewards[-1] += rm_score            # le score du modèle de récompense ne s'ajoute qu'au dernier token
print(rewards)                     # tensor([-0.0150, -0.0050, -0.0550,  1.9900])
print(rewards.sum())               # tensor(1.9150)
La somme donne le ci-dessus. Le troisième token est une formulation que la politique RL favorise bien plus que le modèle SFT, avec un log-rapport de 1.1 ; c'est lui qui est le plus pénalisé. Dans les expériences principales de l'article, vaut 0.05.
Selon les auteurs, cette pénalité joue deux rôles. D'abord, comme un bonus d'entropie, elle encourage l'exploration et empêche la politique de s'effondrer sur une seule formulation. Ensuite, elle empêche les sorties de la politique de trop s'éloigner des résumés que le modèle de récompense a vus à l'entraînement ; le modèle de récompense n'a appris que sur des résumés proches du modèle SFT, et trop loin de ceux-ci, ses scores ne sont plus fiables.
La fonction de valeur de PPO est elle aussi un Transformer distinct, qui ne partage aucun paramètre avec la politique, et elle est initialisée avec les poids du modèle de récompense. Les ablations des auteurs montrent qu'avec des paramètres partagés, les mises à jour de la fonction de valeur en début d'entraînement abîment la politique préentraînée. Le prix à payer est un modèle entier de plus en mémoire pendant la phase de RL ; politique, fonction de valeur, modèle de récompense et modèle SFT servant au calcul de la KL, cela fait quatre modèles de même taille.
La qualité des annotations
Le problème des travaux précédents venait des annotations. Les auteurs ont fait deux changements. D'abord, la collecte se fait entièrement hors ligne. On envoie un gros lot de comparaisons aux annotateurs, puis, une fois tout reçu, on réentraîne sur l'ensemble des données accumulées, au lieu de collecter pendant l'entraînement. Ensuite, ils travaillent en étroite collaboration avec les annotateurs.
Les chercheurs ont d'abord fait eux-mêmes de nombreuses comparaisons et discuté de leurs désaccords pour rédiger des consignes d'annotation. Les annotateurs passent par une phase de formation rémunérée, au début de laquelle ils voient immédiatement quel résumé les chercheurs ont choisi et pourquoi ; seuls restent ceux qui franchissent des seuils de vitesse et de taux d'accord. Pendant l'annotation proprement dite, l'annotateur doit d'abord écrire, sans voir le texte d'origine, sa « lecture naïve » du résumé, puis indiquer sur une échelle à 9 niveaux à quel point il est sûr que A est meilleur que B. Chacun reçoit 10 % à 20 % de questions communes servant à l'étalonnage ; l'équipe a ouvert un salon de discussion partagé pour répondre aux questions, organise de temps en temps des appels vidéo individuels avec les annotateurs pour discuter des désaccords, et écarte les moins performants.
Résultat, le taux d'accord entre annotateurs et chercheurs atteint 77 % ± 2 %, alors que les chercheurs ne s'accordent entre eux qu'à 73 % ± 4 %. Les comparaisons sont très subjectives, et les chercheurs eux-mêmes sont souvent en désaccord ; ces chiffres montrent que l'accord entre annotateurs et chercheurs est déjà comparable à celui des chercheurs entre eux. Le jeu de données finalement publié contient 64 832 comparaisons de résumés.
Discussion
Résultat principal : mieux que les résumés de référence
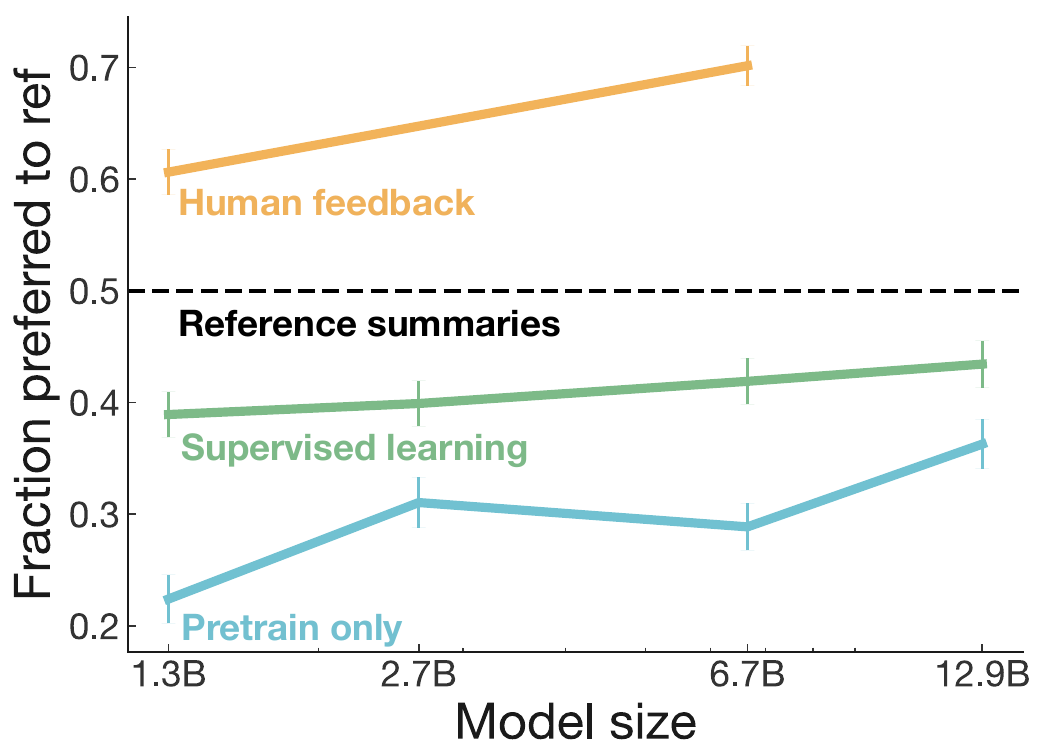
L'ordonnée donne la proportion des cas où les annotateurs préfèrent le résumé du modèle au résumé de référence ; la ligne pointillée à 0.5 marque l'égalité avec les résumés écrits par des humains. Les trois courbes correspondent au préentraînement seul (zero-shot, avec des exemples glissés dans le prompt), à l'affinage supervisé et au modèle entraîné par retours humains.
Le modèle à retours humains de 1.3B est préféré dans 61 % des cas, nettement devant le modèle supervisé 10 fois plus grand (12.9B, 43 %). Le modèle à retours humains de 6.7B monte encore à environ 70 %, ce qui montre que la méthode profite aussi de l'échelle. Le modèle supervisé, même porté à 12.9B, reste battu par les résumés de référence.
La longueur est un facteur de confusion. Le modèle à retours humains a appris à écrire des résumés plus longs ; dans la limite des 48 tokens, écrire un peu plus permet généralement de couvrir plus d'information. Après avoir contrôlé la longueur par une régression logistique, les auteurs voient le taux de préférence du modèle à retours humains face aux résumés de référence baisser d'environ 5 % ; le modèle 6.7B reste à environ 65 %. La légende de la figure précise aussi qu'à 6.7B, la longueur explique environ un tiers de l'écart entre le modèle à retours humains et le modèle supervisé.
Les auteurs ont aussi demandé aux annotateurs de noter sur une échelle de 7 points quatre aspects, la couverture, l'exactitude, la cohérence et la qualité globale. Le modèle à retours humains bat la baseline supervisée sur chacun d'eux, l'écart le plus grand portant sur la couverture. Pour le modèle PPO 6.7B, 45 % des résumés obtiennent la note globale maximale de 7, contre 20 % pour la baseline supervisée et 23 % pour les résumés de référence.
Transfert vers les articles de presse
Le modèle à retours humains entraîné uniquement sur Reddit, sans aucun affinage sur des articles de presse, est utilisé tel quel pour résumer les articles de CNN/DM. Il bat nettement le modèle supervisé entraîné lui aussi sur TL;DR, et la version 6.7B rattrape presque le modèle 6.7B affiné de façon supervisée directement sur CNN/DM, avec des résumés environ deux fois plus courts.
Cette comparaison utilise l'échelle de 7 points, parce que les distributions de longueur des deux modèles ne se recouvrent presque pas, ce qui rend difficile une comparaison directe par paires. En regroupant par longueur, les auteurs constatent que le modèle à retours humains pourrait obtenir de meilleurs scores s'il écrivait plus long.
Que se passe-t-il quand on optimise trop ?
Le modèle de récompense n'est qu'une approximation des préférences des annotateurs. Sa capacité est limitée, et il n'a vu qu'un éventail étroit de résumés. Jusqu'où peut-on l'optimiser avant que ses scores cessent d'être fiables ?
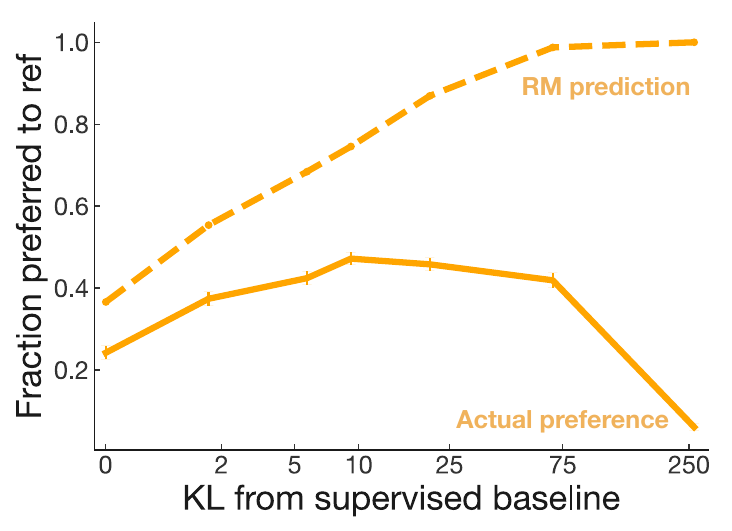
Les auteurs utilisent une version antérieure du modèle de récompense pour entraîner une série de politiques avec différents coefficients KL . Plus est petit, plus la politique s'éloigne du modèle SFT, et plus la KL en abscisse est grande. La ligne pointillée est le taux de préférence prédit par le modèle de récompense lui-même, qui monte jusqu'à près de 100 % à l'extrême droite. La ligne continue est la préférence réelle des annotateurs. Elle monte avec une optimisation légère, plafonne vers une KL de 10, puis commence à décliner, et tombe presque à zéro à une KL de 250. Le modèle de récompense finit par être négativement corrélé aux préférences humaines.
L'annexe donne des résumés produits par la politique à KL 250. Une publication d'un homme de 28 ans qui veut se mettre à la gymnastique est résumée en « 28yo dude stubbornly postponees start pursuing gymnastics hobby citing logistics reasons despite obvious interest??? », suivi d'une série de phrases à la grammaire déglinguée, émaillées de jurons. Dans les quelques résumés donnés en annexe, presque chacun contient la même phrase « want change this ... ». Le verdict des auteurs est que ces résumés sont longs et bizarres, mais qu'ils saisissent encore à peu près l'idée générale.
C'est exactement ce que la pénalité KL vue plus haut doit empêcher. En 2022, avec Scaling Laws for Reward Model Overoptimization, OpenAI a ensuite mesuré cette courbe de façon systématique, en faisant jouer le rôle des humains à un modèle de récompense « étalon-or » fixe ; la forme de la courbe dépend de la méthode d'optimisation, et ses coefficients varient régulièrement avec le nombre de paramètres du modèle de récompense. ROUGE a le même problème. Quand on optimise ROUGE par échantillonnage best-of-N, la qualité plafonne plus tôt qu'en optimisant le modèle de récompense, et à un niveau bien plus bas.
Ce que le modèle de récompense a appris
Les auteurs ont entraîné 7 modèles de récompense, de 160 millions à 13 milliards de paramètres, sur 8k à 64k comparaisons. Doubler les données améliore la précision de validation d'environ 1.1 % ; doubler le modèle, d'environ 1.8 %. Le modèle de récompense 6.7B entraîné sur toutes les données commence à approcher le niveau d'un annotateur isolé.
Sur CNN/DM, jamais vu à l'entraînement, les modèles de récompense 1.3B et 6.7B s'accordent avec les annotateurs dans 62.4 % et 66.5 % des cas respectivement ; entre annotateurs, l'accord est de 66.9 %.
Le modèle de récompense est aussi sensible aux détails. Quand on demande aux annotateurs d'apporter une amélioration minimale à un résumé, le modèle de récompense 6.7B choisit la version améliorée dans 82.8 % des cas, contre 84.1 % pour un autre groupe d'évaluateurs humains. Quand on intervertit les rôles de deux personnages dans un résumé de référence, le modèle 6.7B choisit la version d'origine, la bonne, dans 97.2 % des cas.
On lui trouve aussi des biais. Pour les améliorations qui consistent à « raccourcir le résumé », le modèle de récompense 6.7B n'est d'accord que dans 62.6 % des cas, contre 76.4 % pour les humains. Le modèle de récompense préfère les résumés longs, ce qui fait écho à la tendance du modèle à retours humains à écrire long, vue plus haut.
ROUGE, lui, se dégrade à mesure que les modèles s'améliorent. Pour départager deux échantillons du modèle supervisé, ROUGE s'accorde avec les annotateurs dans environ 57 % des cas ; pour deux échantillons du modèle à retours humains, ce taux tombe à environ 50 %, autant jouer à pile ou face. La log-probabilité du modèle supervisé utilisée comme métrique se comporte de même, et tombe sous 50 % sur les échantillons du modèle à retours humains, alors que le modèle de récompense reste à 62 %.
Ce que cela coûte
La limite la plus directe est le coût. L'affinage par RL du modèle 6.7B demande environ 320 jours-GPU ; le jeu d'entraînement a coûté des milliers d'heures aux annotateurs, et beaucoup de temps aux chercheurs pour maintenir la qualité. C'est aussi parce que c'était trop cher que les auteurs n'ont pas pu faire une comparaison importante, à savoir ce que donnerait un apprentissage supervisé sur autant de démonstrations humaines de haute qualité.
En 2024, Huang et al. ont reproduit tout ce processus à partir de zéro, en recensant plus d'une vingtaine de détails d'implémentation clés, et ont retrouvé avec des modèles Pythia la tendance d'une qualité qui croît avec la taille du modèle. Leurs modèles 2.8B et 6.9B battent le checkpoint 1.3B publié par OpenAI.
Conclusion
Le modèle à retours humains de 1.3B est préféré à un modèle supervisé 10 fois plus grand, et même aux TL;DR écrits par les auteurs des publications Reddit eux-mêmes. Pour les tâches dont on ne sait pas écrire les critères de notation, faire comparer par des humains, puis faire courir le modèle après ces comparaisons, ça marche.
Si vous voulez le faire vous-même, ce qui mérite le plus d'être copié dans cet article, c'est finalement le processus d'annotation. Rédiger les consignes avant tout, étalonner en amont, garder des questions communes, surveiller l'accord avec les chercheurs ; c'est seulement ainsi que le modèle de récompense apprend la qualité que vous voulez. En comparaison, la partie PPO est bien plus facile à gérer.
Et surtout, ne vous passez jamais de la pénalité KL. Sans elle, le modèle apprend très vite à écrire des phrases que le modèle de récompense adore et que les humains ne comprennent pas.