Article original
Proximal Policy Optimization Algorithms
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:1707.06347
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{reinforcementlearningppo2017,
  title = {{Proximal Policy Optimization Algorithms}},
  author = {John Schulman and Filip Wolski and Prafulla Dhariwal and Alec Radford and Oleg Klimov},
  year = {2017},
  eprint = {1707.06347},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1707.06347}
}
En 2017, pour entraîner une politique par apprentissage par renforcement profond, on avait en gros trois options, chacune avec ses défauts.
DQN est très fort sur Atari, mais peine dès qu'il s'agit de contrôle continu (par exemple, la force que doit produire chaque articulation d'un robot). Les méthodes de gradient de politique ordinaires sont simples à implémenter, mais gaspillent beaucoup de données, chaque lot d'interactions ne servant qu'à une seule mise à jour. TRPO est plus économe en données et plus stable, mais il doit résoudre un problème d'optimisation sous contrainte, en approchant l'information du second ordre par la méthode du gradient conjugué, ce qui complique le code ; et si le réseau contient du dropout, ou si la politique et la fonction de valeur partagent des paramètres, TRPO s'en accommode mal.
Schulman, d'OpenAI, est le premier auteur de TRPO. PPO (Proximal Policy Optimization) en est la version simplifiée qu'il propose avec ses collègues. Le but est de garder l'efficacité en données et la stabilité de TRPO en n'utilisant que de l'optimisation du premier ordre, c'est-à-dire SGD ou Adam tout ce qu'il y a de plus ordinaires. Dans leur conclusion, les auteurs affirment que passer d'une implémentation de gradient de politique ordinaire à PPO ne demande de modifier que quelques lignes de code. (En réalité, il y a bien plus à changer ; on y reviendra)
InstructGPT a ensuite utilisé PPO pour affiner des modèles de langage, et PPO est ainsi devenu l'algorithme d'apprentissage par renforcement le plus courant du RLHF.
Définir le problème
L'estimateur de gradient de politique le plus courant s'écrit :
désigne la moyenne sur un lot d'échantillons. Avec la différenciation automatique, on écrit une fonction objectif dont le gradient est exactement l'expression ci-dessus :
Collecter des données coûte cher, et l'on est naturellement tenté de faire plusieurs pas d'optimisation sur le même lot de trajectoires. Selon les auteurs, cela n'a aucun fondement théorique, et en pratique cela provoque souvent des mises à jour destructrices de grande ampleur. La politique saute trop loin d'un coup, ses performances s'effondrent, et comme toutes les données collectées ensuite viennent de cette mauvaise politique, il est difficile de s'en remettre.
TRPO, lui, ajoute une contrainte à la mise à jour :
La divergence KL entre l'ancienne et la nouvelle politique ne doit pas dépasser . C'est la « région de confiance » : on ne cherche une meilleure politique qu'au voisinage de l'ancienne.
La théorie plaide en fait plutôt pour une pénalité que pour une contrainte, c'est-à-dire maximiser l'objectif moins . TRPO ne le fait pas, parce qu'il est difficile de choisir un qui convienne à tous les problèmes ; même sur un seul problème, le bon change d'une phase de l'entraînement à l'autre. Les auteurs ont aussi essayé un fixe avec SGD, sans obtenir de résultats satisfaisants.
Peut-on alors, avec des méthodes du premier ordre seulement, faire plusieurs passes sur le même lot de données en toute sérénité, sans que la politique saute trop loin ?
Résoudre le problème
Rapport de probabilités et écrêtage
On définit d'abord le rapport de probabilités entre la nouvelle et l'ancienne politique :
Au début de la mise à jour, , donc . L'objectif que maximise TRPO peut s'écrire , où CPI désigne conservative policy iteration. Sans contrainte, le maximiser pousse très loin.
L'objectif principal de PPO est :
est un hyperparamètre, que l'article fixe par défaut à 0.2. Le premier terme du min est ; le second écrête le rapport de probabilités dans ; on garde ensuite le plus petit des deux.
Pourquoi prendre le min ? Faisons le calcul sur quelques nombres. Supposons que l'ancienne politique choisisse chaque fois l'action avec une probabilité de 0.30, que la mise à jour fasse passer cette probabilité à des valeurs différentes, et donnons à chaque cas un avantage positif ou négatif :
import torch

eps = 0.2
logp_old = torch.log(torch.tensor([0.30, 0.30, 0.30, 0.30, 0.30]))
p_new = torch.tensor([0.33, 0.39, 0.18, 0.45, 0.18], requires_grad=True)
adv = torch.tensor([2.0, 2.0, -1.0, -1.0, 2.0])

ratio = torch.exp(torch.log(p_new) - logp_old)
unclipped = ratio * adv
clipped = torch.clamp(ratio, 1 - eps, 1 + eps) * adv
objective = torch.min(unclipped, clipped)
objective.sum().backward()

print(ratio.detach())      # tensor([1.1000, 1.3000, 0.6000, 1.5000, 0.6000])
print(objective.detach())  # tensor([ 2.2000,  2.4000, -0.8000, -1.5000,  1.2000])
print(p_new.grad)          # tensor([ 6.6667,  0.0000,  0.0000, -3.3333,  6.6667])
En pratique, on stocke généralement les log-probabilités, d'où un rapport écrit comme l'exponentielle de leur différence. Examinons les cinq échantillons un par un :
- Bonne action, un peu plus probable (, ) : on reste dans l'intervalle, les deux termes sont égaux, le gradient est normal et continue de pousser la probabilité vers le haut.
- Bonne action, déjà trop augmentée () : le terme écrêté vaut , moins que les 2.6 du terme non écrêté, et le min retient le terme écrêté. Le gradient du terme écrêté par rapport aux paramètres est nul ; cet échantillon ne contribue plus à la mise à jour.
- Mauvaise action, déjà assez abaissée (, ) : le terme écrêté est plus petit que le terme non écrêté ; là encore, le min retient le terme écrêté, et le gradient s'annule.
- Mauvaise action dont la probabilité a au contraire augmenté () : le terme non écrêté, , est le plus petit ; le min le retient, le gradient est négatif et tire la probabilité vers le bas.
- Bonne action dont la probabilité a au contraire baissé (, ) : le terme non écrêté, 1.2, est plus petit que le terme écrêté, 1.6 ; le min le retient, et le gradient continue de pousser la probabilité vers le haut.
Les échantillons 2 et 3 montrent l'effet de l'écrêtage. Un échantillon déjà allé trop loin dans la bonne direction ne peut plus fournir de récompense supplémentaire. Les échantillons 4 et 5 montrent l'effet du min. Un échantillon parti dans la mauvaise direction n'est pas protégé par l'écrêtage et reste pénalisé. Pour reprendre la formulation des auteurs, les variations du rapport de probabilités ne sont ignorées que lorsqu'elles améliorent l'objectif, et toujours prises en compte lorsqu'elles le dégradent. est donc une borne inférieure pessimiste de l'objectif non écrêté.
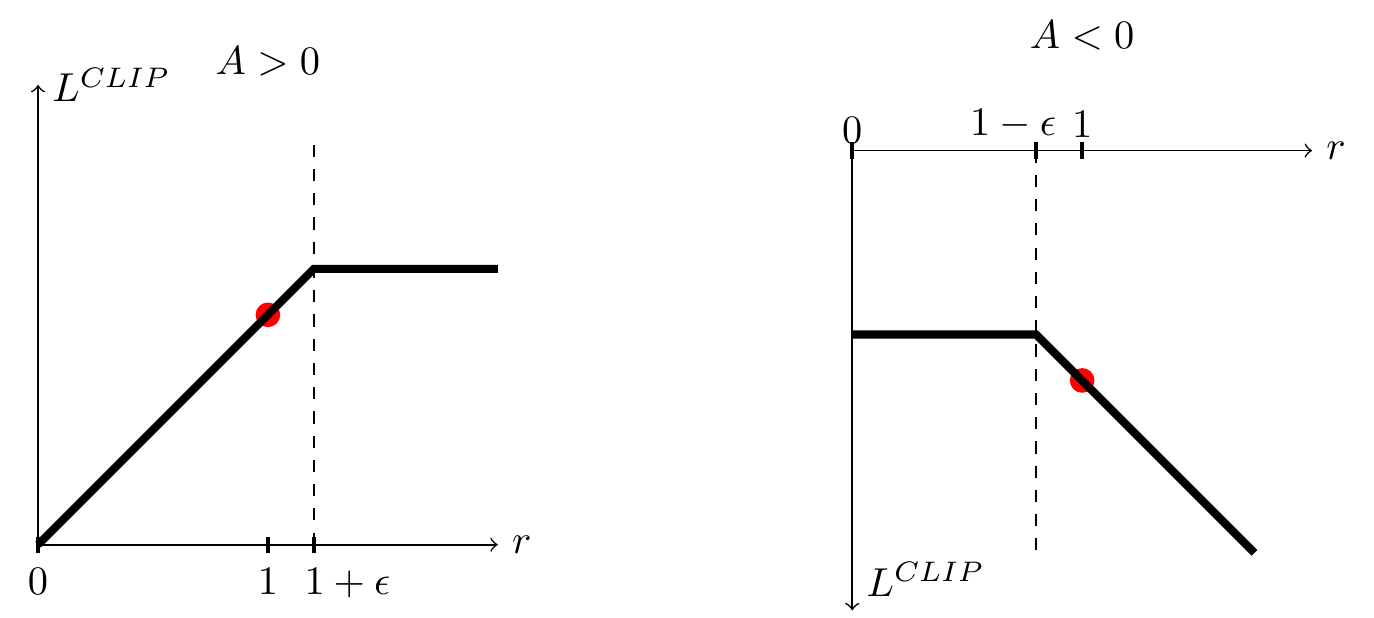
Cette figure trace les cinq échantillons précédents sous forme de courbes. À gauche, l'avantage est positif. Partant du point rouge en , l'objectif croît linéairement vers la droite, devient plat au-delà de , et aller plus à droite n'apporte plus rien ; vers la gauche (probabilité en baisse), il décroît sans aucune protection. À droite, l'avantage est négatif et tout s'inverse, avec un plateau en dessous de .
Au voisinage de , et ont la même approximation du premier ordre ; le gradient du premier pas est donc le même que sans écrêtage. Les deux ne se séparent qu'une fois que les paramètres ont quitté .
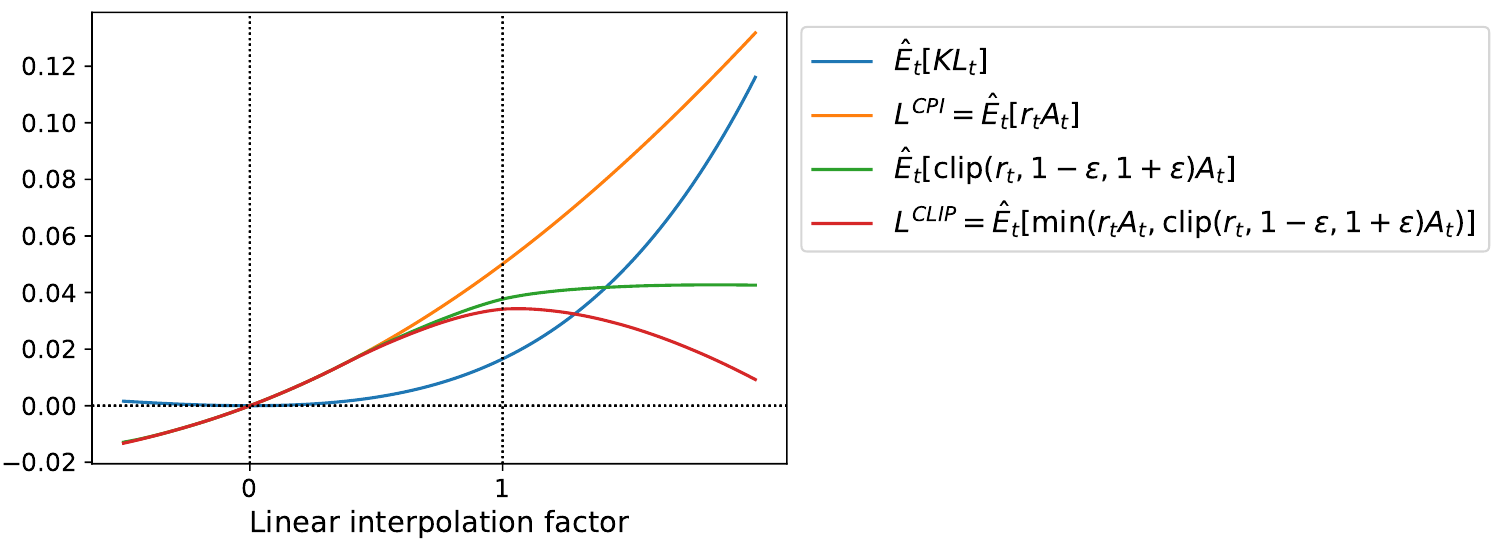
Cette figure montre la même chose sous un autre angle. Les auteurs effectuent une première mise à jour PPO sur Hopper-v1, puis interpolent les paramètres depuis l'ancienne valeur (abscisse 0) jusqu'à la nouvelle (abscisse 1), le long de la direction de mise à jour, et prolongent au-delà. La courbe orange monte sans arrêt, comme si aller plus loin était toujours mieux ; la KL, en bleu, augmente elle aussi continûment. La courbe rouge , en revanche, atteint son maximum vers 1, puis redescend ; la KL y vaut environ 0.02. L'objectif écrêté a de lui-même un sommet qui dit « inutile d'aller plus loin », sans qu'il faille ajouter de contrainte.
Autre option : une pénalité KL adaptative
Les auteurs proposent aussi une variante, qui sert de point de comparaison important. La fonction objectif est le rapport de probabilités multiplié par l'avantage, moins ; après chaque mise à jour, on mesure la KL moyenne effective , puis on ajuste :
- : , la pénalité est trop forte, on relâche un peu.
- : , la politique est allée trop loin, on pénalise davantage.
1.5 et 2 sont des valeurs empiriques ; selon les auteurs, l'algorithme y est peu sensible, et la valeur initiale de se corrige vite d'elle-même. Il arrive qu'une mise à jour ait une KL très éloignée de la cible, mais c'est rare.
L'algorithme complet
En pratique, le réseau de politique partage souvent ses paramètres avec le réseau de valeur ; l'objectif combine donc le terme de politique, l'erreur de la fonction de valeur et un bonus d'entropie :
est l'erreur quadratique de la fonction de valeur, et l'entropie, qui encourage l'exploration.
L'avantage est estimé avec une version tronquée de GAE (generalized advantage estimation) :
est l'erreur de différence temporelle sur un pas, et règle jusqu'où l'on regarde en avant ; avec , on retombe sur l'estimateur à horizon fini utilisé par A3C. Le désigne ici la récompense de l'environnement, à ne pas confondre avec le rapport de probabilités vu plus haut ; l'article original utilise pour les deux.
La procédure complète correspond à l'Algorithme 1 de l'article :
- acteurs (actors) parallèles exécutent chacun pas avec la politique courante , et calculent l'avantage à chaque pas.
- Sur ces exemples, on optimise l'objectif ci-dessus pendant époques, avec des mini-lots de taille .
- , puis retour à l'étape 1.
Faisons le calcul avec la configuration MuJoCo de l'article. Chaque itération collecte pas, avec des mini-lots de 64 et 10 époques, soit mises à jour de gradient par lot de données. Une méthode de gradient de politique ordinaire n'en fait qu'une seule sur le même lot. Sur Atari, 8 acteurs exécutent chacun 128 pas, soit 1 024 pas au total, avec des mini-lots de 256 et 3 époques, donc 12 mises à jour par lot ; le paramètre d'écrêtage vaut et décroît linéairement jusqu'à 0 au fil de l'entraînement.
(Chose amusante, quand InstructGPT a plus tard affiné des modèles de langage avec PPO, il n'a fait qu'une seule époque par lot de données ; le grand atout de PPO, « réutiliser plusieurs fois le même lot », est resté inexploité.)
Discussion
Quel objectif de substitution est le meilleur ?
La première série d'expériences compare différents objectifs de substitution (surrogate objective), chacun avec un balayage d'hyperparamètres. Le banc d'essai comprend 7 tâches de contrôle continu MuJoCo, chacune entraînée sur 1 million de pas avec 3 graines aléatoires. Le score est la récompense totale moyenne des 100 derniers épisodes, normalisée par environnement de sorte que la politique aléatoire vaille 0 et le meilleur résultat 1 ; les 21 résultats sont enfin moyennés en un seul nombre. La politique est un MLP à deux couches de 64 unités, sans partage de paramètres ni bonus d'entropie.
| Configuration | Score normalisé moyen |
|---|---|
| Sans écrêtage ni pénalité | -0.39 |
| Écrêtage, | 0.76 |
| Écrêtage, | 0.82 |
| Écrêtage, | 0.70 |
| KL adaptative, | 0.68 / 0.74 / 0.71 |
| KL fixe, | 0.62 / 0.71 / 0.72 / 0.69 |
D'après la Table 1 de l'article.
La version sans écrêtage ni pénalité obtient un score négatif, surtout parce que son score sur HalfCheetah est pire que celui de la politique aléatoire ; ce sont précisément les mises à jour destructrices évoquées plus haut. Parmi les versions écrêtées, est la meilleure ; les meilleures configurations des deux pénalités KL se situent entre 0.72 et 0.74, assez proches l'une de l'autre, mais toutes deux en dessous de l'écrêtage. Les auteurs ont aussi essayé d'écrêter dans l'espace logarithmique, sans faire mieux.
Face aux autres algorithmes
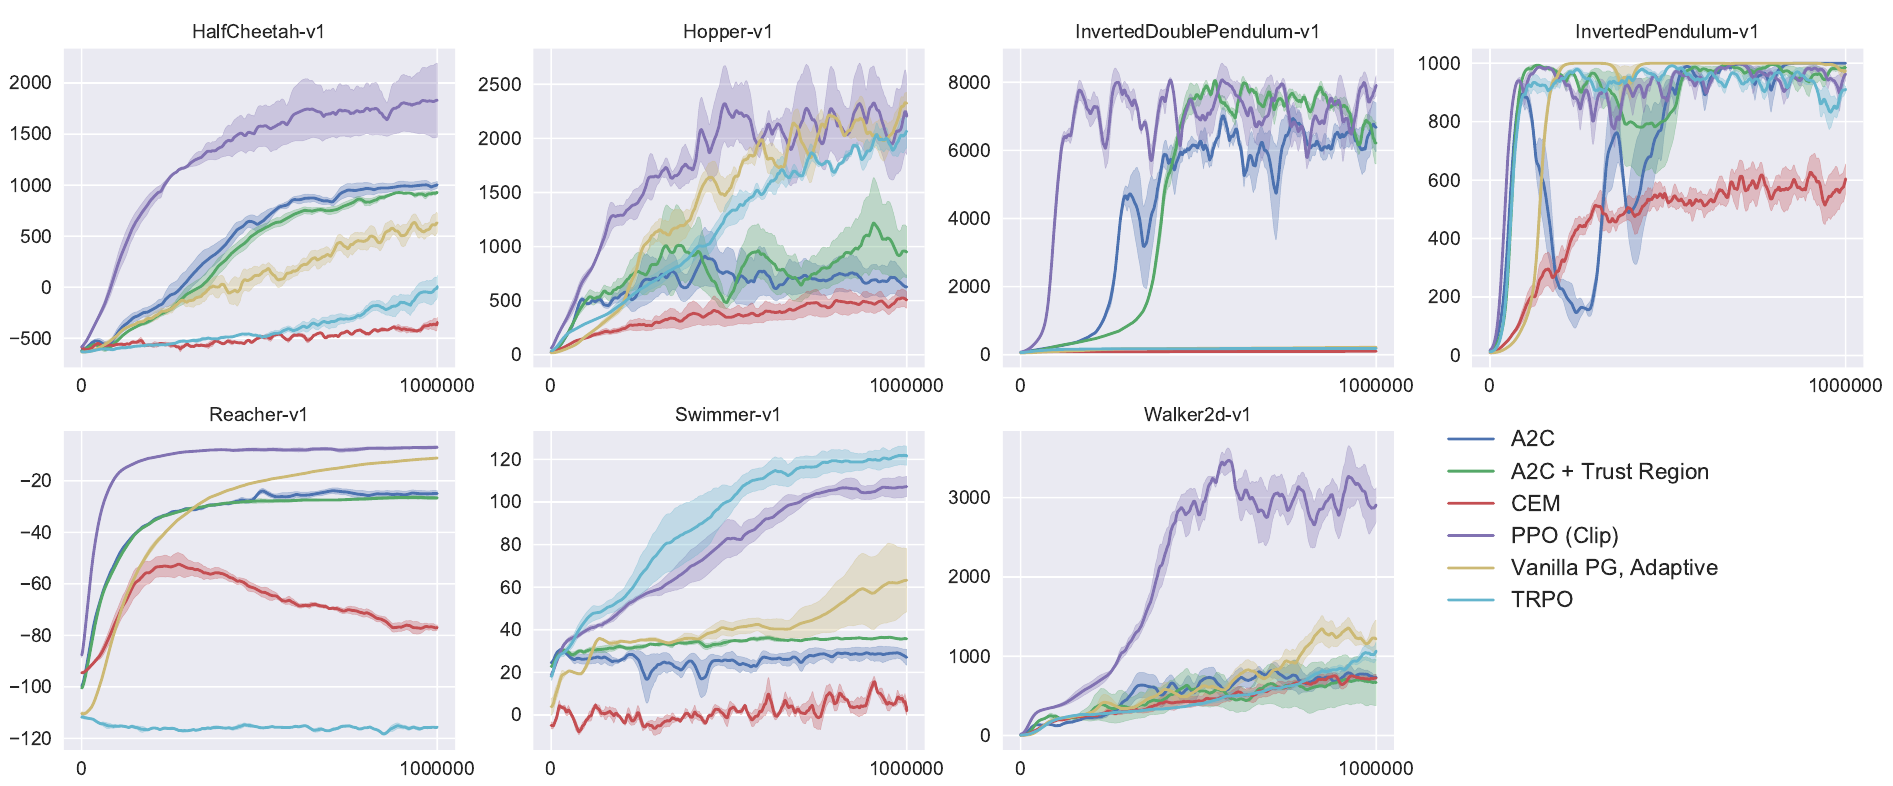
La courbe violette est PPO. Les points de comparaison sont un TRPO bien réglé, la méthode de l'entropie croisée (CEM), un gradient de politique ordinaire à pas adaptatif, A2C, et A2C avec région de confiance. La conclusion des auteurs est que PPO l'emporte dans presque tous les environnements. L'écart le plus grand est sur Walker2d, où PPO atteint environ 3 000 alors que toutes les autres méthodes restent sous 1 200 ; sur HalfCheetah aussi, PPO est nettement devant. Swimmer fait exception, TRPO (courbe bleu clair) finissant légèrement au-dessus de PPO.
Les auteurs font aussi la démonstration de PPO sur les humanoïdes 3D de Roboschool, avec des tâches comme courir vers l'avant, poursuivre une cible qui se déplace au hasard, ou se relever du sol tout en étant bombardé de cubes. Cette série ne présente que des courbes d'apprentissage et des images, sans comparaison avec d'autres algorithmes.
Atari : apprentissage rapide, scores finaux partagés
Sur Atari, la comparaison porte sur A2C et ACER ; les trois utilisent la même architecture de réseau, et les hyperparamètres d'A2C et d'ACER ont été réglés pour cet ensemble de jeux. Sur 49 jeux, avec 3 expériences par jeu, on compte selon deux métriques le nombre de jeux remportés par chaque algorithme :
| Métrique | A2C | ACER | PPO | Égalité |
|---|---|---|---|---|
| Récompense moyenne par épisode sur tout l'entraînement | 1 | 18 | 30 | 0 |
| Récompense moyenne des 100 derniers épisodes | 1 | 28 | 19 | 1 |
D'après la Table 2 de l'article.
La première métrique favorise les méthodes qui apprennent vite, la seconde la performance finale. PPO mène nettement sur la première, alors qu'ACER gagne plus souvent sur la seconde. Les scores jeu par jeu de l'annexe contiennent des cas extrêmes dans les deux sens. Sur Enduro, A2C et ACER font 0, PPO 758 ; sur Kangaroo, c'est 45 et 50 contre 9 929. À l'inverse, sur Gopher, ACER atteint 37 802 et PPO seulement 2 933 ; sur DemonAttack, c'est 38 808 contre 11 378. Face à ACER, les auteurs concluent à des performances comparables, avec un PPO bien plus simple.
L'écrêtage fait-il vraiment son travail ?
PPO est vite devenu l'algorithme par défaut, et les travaux suivants ont commencé à se demander d'où venait son efficacité.
En 2020, Engstrom et al., du MIT, se sont intéressés dans Implementation Matters in Deep Policy Gradients à certains « petits détails » de l'implémentation officielle. On y trouve l'écrêtage appliqué aussi à la perte de la fonction de valeur, la mise à l'échelle des récompenses par l'écart-type du retour actualisé, l'initialisation orthogonale, la décroissance du taux d'apprentissage d'Adam, la normalisation et l'écrêtage des observations, ou encore l'écrêtage de la norme globale du gradient à 0.5. L'article PPO lui-même ne met pas ces détails en avant. La conclusion d'Engstrom et al. est que l'essentiel de l'avantage de PPO sur TRPO en récompense cumulée vient de ces optimisations au niveau du code.
Ils ont aussi mesuré le rapport de probabilités. Pendant l'entraînement de PPO, le rapport maximal dépasse durablement ; l'écrêtage n'enferme donc pas la politique dans cet intervalle. Le code de tout à l'heure aide à comprendre pourquoi. L'écrêtage ne fait qu'annuler le gradient des échantillons sortis de l'intervalle, mais les paramètres sont partagés par tous les échantillons. Les gradients des autres échantillons continuent de pousser les paramètres, et entraînent au passage plus loin encore l'échantillon déjà hors de l'intervalle. Au début de la première époque, on a pour tous les échantillons ; ce pas est exactement le même que sans écrêtage, et sa taille dépend de la raideur de la fonction objectif.
Ils ont ensuite construit PPO-NoClip, qui garde ces détails d'implémentation mais retire l'écrêtage. Sur Walker2d, Hopper et Humanoid, il obtient respectivement 2 867, 2 371 et 831, contre 3 292, 2 513 et 806 pour le PPO standard. Sur Walker2d, l'écart reste d'environ 400 points ; sur Hopper, il est de l'ordre de l'intervalle de confiance ; sur Humanoid, c'est même la version sans écrêtage qui fait légèrement mieux. La version minimale PPO-M, qui garde l'écrêtage mais retire les détails d'implémentation, fait moins bien que PPO-NoClip sur les trois. Engstrom et al. en concluent que l'écrêtage compte souvent moins que ces détails d'implémentation.
Une autre synthèse souvent citée est The 37 Implementation Details of Proximal Policy Optimization, publiée par Huang et al. en 2022 sur le blog de l'ICLR. Ils comparent ligne par ligne l'implémentation d'OpenAI baselines et en tirent 13 détails essentiels, plus des détails supplémentaires pour Atari, le contrôle continu, les LSTM et d'autres cas. Par exemple, la normalisation de l'avantage se fait à l'intérieur de chaque mini-lot, et non sur le lot entier ; quant à l'écrêtage de la fonction de valeur, Engstrom et al. ne trouvent aucune preuve qu'il aide, et une autre étude à grande échelle le juge même nuisible. Ils notent aussi que même l'implémentation originale produit des résultats assez peu cohérents.
Ces travaux ne détrônent pas PPO, qui reste dans ces expériences l'une des configurations les plus performantes. Ce qu'ils corrigent, c'est l'explication de son efficacité. L'objectif écrêté rend plus sûres les mises à jour sur plusieurs époques, mais pour reproduire de façon stable les chiffres de l'article, les détails d'implémentation absents de l'article comptent tout autant.
Appliqué aux modèles de langage
Avec un modèle de langage, chaque token est une action, et la réponse entière une trajectoire. En plus de PPO, InstructGPT ajoute une pénalité KL par rapport au modèle SFT, pour éviter que le modèle ne s'éloigne trop en cherchant à plaire au modèle de récompense. Plus tard, GRPO, de DeepSeek, a supprimé le réseau de valeur et estimé l'avantage en comparant entre eux les scores de plusieurs réponses à une même question ; la formulation avec clip et min, elle, a été conservée.
Conclusion
Le cœur de PPO tient en une seule ligne de fonction objectif. Le clip fait qu'un échantillon allé trop loin dans la bonne direction ne gagne plus de points, le min fait qu'un échantillon parti dans la mauvaise direction continue d'en perdre, et l'on peut alors faire plusieurs passes sur le même lot de données en toute tranquillité.
Si vous devez vraiment l'écrire vous-même, les formules de l'article ne vous mènent qu'à mi-chemin. Normalisation de l'avantage, mise à l'échelle des récompenses, écrêtage de la fonction de valeur : l'article ne décrit pas ces détails, et pourtant les résultats en dépendent beaucoup. Le plus simple est de reprendre la liste des 37 détails et de la vérifier point par point.
Ces dernières années, on n'a cessé de démonter PPO pièce par pièce. DPO a supprimé l'apprentissage par renforcement, GRPO le réseau de valeur. Le clip, lui, est toujours là.