Article original
Training language models to follow instructions with human feedback
- Publication
- NeurIPS 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2203.02155
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuninginstructgpt2022,
  title = {{Training language models to follow instructions with human feedback}},
  author = {Long Ouyang and Jeff Wu and Xu Jiang and Diogo Almeida and Carroll L. Wainwright and Pamela Mishkin and Chong Zhang and Sandhini Agarwal and Katarina Slama and Alex Ray and John Schulman and Jacob Hilton and Fraser Kelton and Luke Miller and Maddie Simens and Amanda Askell and Peter Welinder and Paul Christiano and Jan Leike and Ryan Lowe},
  year = {2022},
  eprint = {2203.02155},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.02155}
}
Dans un billet de blog de janvier 2022, OpenAI donne un exemple. On demande à GPT-3 « Explique l'alunissage à un enfant de six ans en quelques phrases » ; au lieu de répondre, il enchaîne avec « Explique la théorie de la gravité à un enfant de six ans », « Explique la théorie de la relativité », « Explique la théorie du Big Bang ».
GPT-3 est entraîné à prédire le mot suivant sur des pages web. Le web regorge de listes de questions ; après une question, enchaîner sur la suivante est une continuation tout à fait raisonnable. Mais l'utilisateur, lui, veut une réponse. Les auteurs d'OpenAI parlent d'un modèle « désaligné » (misaligned), parce que l'objectif d'entraînement du modèle de langage ne coïncide pas avec « suivre les instructions de l'utilisateur de façon utile et sûre ».
Dans cet article, Ouyang, Wu, Jiang, Lowe, Leike, Christiano et leurs collègues de l'équipe d'alignement d'OpenAI reprennent le pipeline de retour humain validé au cours des deux années précédentes sur la tâche de résumé, et l'appliquent aux prompts réels que reçoit l'API d'OpenAI. Le résultat le plus cité est que les annotateurs préfèrent l'InstructGPT de 1.3 milliard de paramètres au GPT-3 de 175 milliards, alors qu'il a plus de cent fois moins de paramètres.
Neuf mois plus tard, OpenAI lance ChatGPT ; la présentation officielle le décrit comme un « modèle frère » d'InstructGPT, entraîné avec la même méthode RLHF, à quelques différences près dans le dispositif de collecte des données.
Définir le problème
Les auteurs reprennent la formulation d'Askell et al., chez Anthropic, et décomposent l'« alignement » en trois propriétés :
- Utile (helpful) : aider l'utilisateur à accomplir ce qu'il veut faire.
- Honnête (honest) : ne pas inventer d'informations ni induire l'utilisateur en erreur.
- Inoffensif (harmless) : ne causer de tort physique, psychologique ou social ni aux personnes ni à l'environnement.
Aucune des trois n'est facile à mesurer directement. L'indicateur principal des auteurs est la préférence des annotateurs, c'est-à-dire, pour un même prompt, laquelle des réponses de deux modèles est la meilleure. Pour l'honnêteté, les auteurs admettent qu'ils ne peuvent pas mesurer les « croyances » du modèle ; ils se rabattent sur la « véracité », autrement dit la conformité aux faits de ce que dit le modèle, mesurée de deux façons : la quantité d'informations absentes du texte source qu'il invente dans les tâches fermées (comme le résumé), et le benchmark TruthfulQA. Pour l'innocuité, les annotateurs devaient d'abord juger si une sortie était « potentiellement nuisible » ; comme cela obligeait à deviner l'usage qui en serait fait, les auteurs sont passés à des indicateurs indirects plus concrets, par exemple si la sortie est inappropriée dans un contexte de service client, si elle dénigre une catégorie protégée, ou si elle contient du contenu sexuel ou violent.
Sur les instructions que les utilisateurs envoient vraiment, de combien le retour humain peut-il améliorer GPT-3 ? Et à quel prix ? Voilà les questions auxquelles l'article veut répondre.
Résoudre le problème
Trois étapes
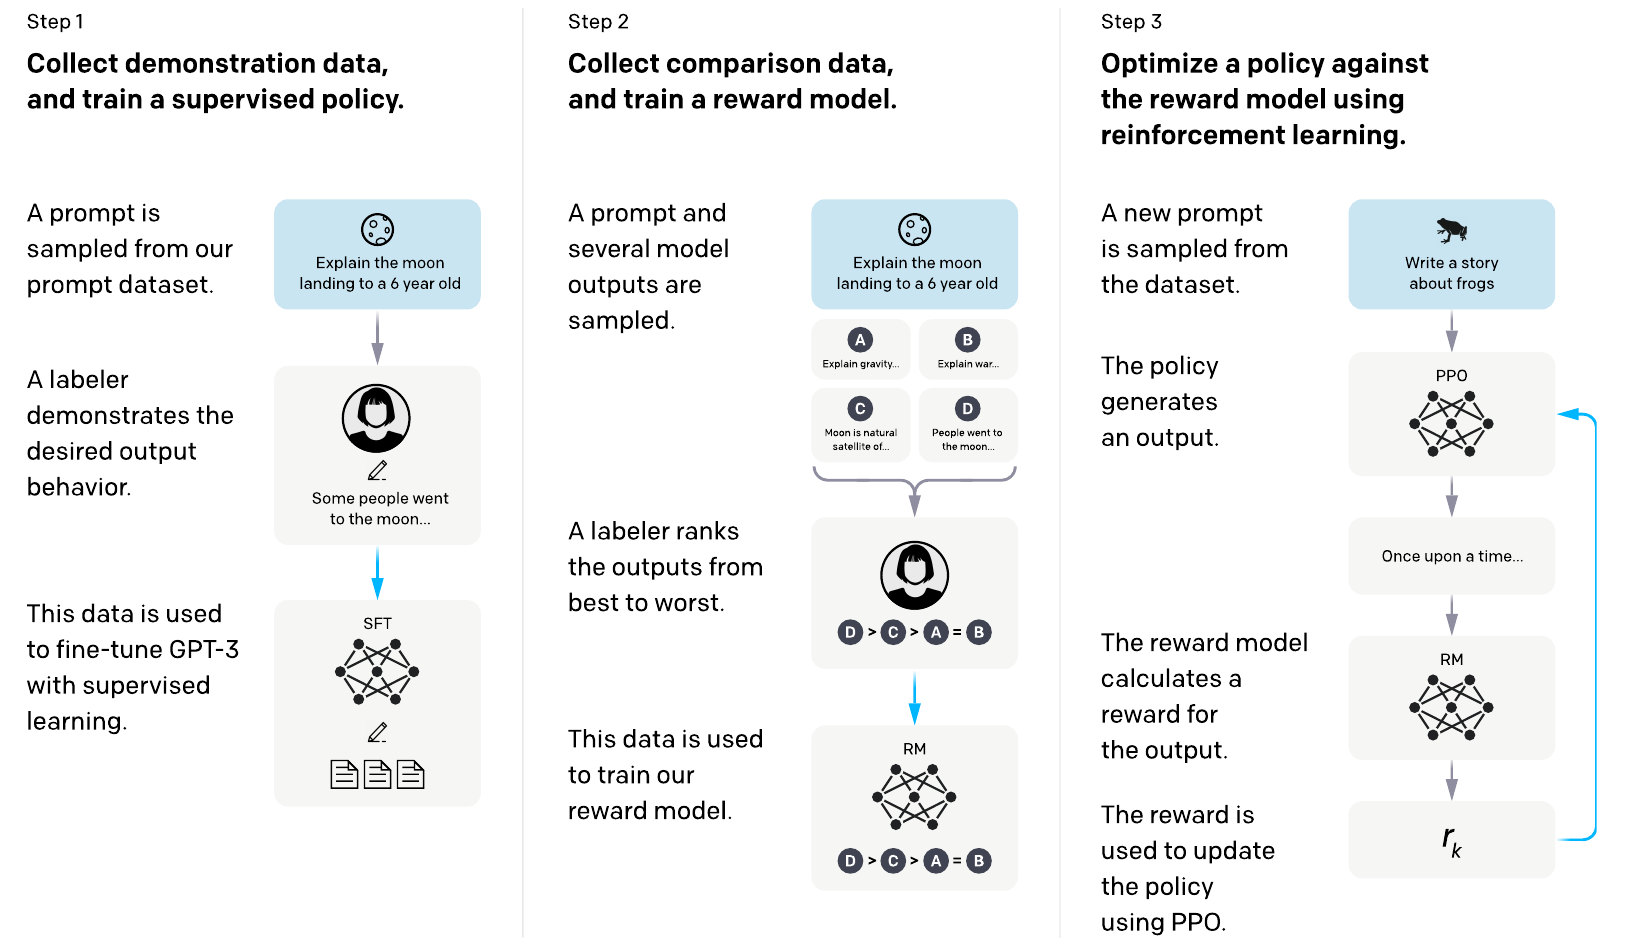
Le pipeline reprend celui de Ziegler et al. (2019) et de Stiennon et al. (2020), avec une étape de démonstration en plus au début :
- Collecter des démonstrations et faire un fine-tuning supervisé (SFT) : les annotateurs rédigent la réponse idéale à chaque prompt, et ces réponses servent à fine-tuner GPT-3.
- Collecter des comparaisons et entraîner un modèle de récompense (RM) : on échantillonne plusieurs sorties du modèle pour un même prompt, les annotateurs les classent, et l'on entraîne un modèle de récompense qui prédit les préférences humaines.
- Optimiser la politique avec PPO : le score du modèle de récompense sert de récompense, et l'on poursuit le fine-tuning du modèle SFT par apprentissage par renforcement.
Les étapes 2 et 3 peuvent être répétées, en échantillonnant avec la meilleure politique du moment pour collecter de nouvelles comparaisons. Les auteurs précisent qu'en pratique, la plupart des comparaisons portent sur des sorties du modèle SFT, et une petite partie sur celles des modèles PPO.
D'où viennent les données
Les prompts viennent surtout du Playground de l'API OpenAI. Les utilisateurs s'y servaient d'une version antérieure d'InstructGPT, entraînée uniquement par fine-tuning supervisé, et l'interface leur rappelait régulièrement que ces données pouvaient servir à entraîner de nouveaux modèles ; les données de l'API en production n'ont pas été utilisées. Les auteurs dédoublonnent les prompts qui partagent un préfixe commun, retiennent au plus 200 prompts par utilisateur, et répartissent les ensembles d'entraînement, de validation et de test par identifiant d'utilisateur, si bien que les prompts de test viennent d'utilisateurs absents de l'entraînement. Les informations personnelles identifiables ont aussi été filtrées de l'ensemble d'entraînement.
Au tout début, les prompts en forme d'instruction étaient encore rares sur l'API ; le premier lot de prompts a donc été écrit par les annotateurs eux-mêmes, en trois catégories : des tâches libres, une instruction suivie de plusieurs paires question-réponse en exemple, et des prompts inspirés des usages décrits par les candidats de la liste d'attente de l'API.
Les trois jeux de données finaux ont les tailles suivantes :
| Jeu de données | Contenu | Prompts d'entraînement |
|---|---|---|
| SFT | Démonstrations des annotateurs | environ 13 000 (11 295 écrits par les annotateurs, 1 430 de l'API) |
| RM | Classements des annotateurs | environ 33 000 (6 623 écrits par les annotateurs, 26 584 de l'API) |
| PPO | Prompts seuls, sans annotation | 31 144 (tous issus de l'API) |
D'après la Table 6 de l'annexe de l'article.
La répartition des usages de ces prompts est très différente de celle des jeux de données de NLP. Selon la classification des annotateurs, la génération représente 45.6 %, les questions ouvertes 12.4 %, le brainstorming 11.2 %, la conversation 8.4 % et la réécriture 6.6 % ; résumé, classification, questions fermées et extraction ne représentent à eux quatre qu'un peu plus de 10 %. Plus de 96 % des données sont en anglais.
L'équipe compte une quarantaine d'annotateurs, recrutés via Upwork et Scale AI. Ils passent d'abord un test de sélection qui vérifie s'ils savent repérer les prompts sensibles et juger si une sortie est nuisible, et dans quelle mesure ils sont d'accord avec les chercheurs. Pendant l'entraînement, la priorité est l'utilité pour l'utilisateur ; lors de l'évaluation finale, on demande aux annotateurs de donner la priorité à la véracité et à l'innocuité. Les auteurs recrutent aussi un groupe d'annotateurs « réservés » (held-out), qui n'ont participé ni aux données d'entraînement ni au test de sélection, pour vérifier que le modèle n'a pas seulement appris à plaire à un groupe de personnes particulier.
Modèle de récompense : classer plusieurs réponses d'un coup
Le modèle SFT est entraîné 16 époques sur les démonstrations des annotateurs. Les auteurs constatent que la perte de validation montre un surapprentissage dès la première époque, mais que prolonger l'entraînement améliore pourtant à la fois le score du modèle de récompense et les préférences humaines ; ils choisissent donc finalement le modèle SFT d'après le score du modèle de récompense.
Le modèle de récompense part du modèle SFT, dont on retire la couche de sortie finale pour la remplacer par une sortie scalaire. Pour accélérer la collecte, les annotateurs voient de 4 à 9 réponses à la fois et les classent directement. réponses donnent comparaisons par paires ; la perte est celle de Stiennon et al., moyennée sur toutes les paires :
est la meilleure réponse de la paire, la moins bonne. Faisons le calcul avec le classement D > C > A = B de la Figure 2 :
import itertools
import torch
import torch.nn.functional as F

# scores du modèle de récompense pour les quatre réponses au même prompt, une propagation avant chacune
r = {"A": torch.tensor(0.1), "B": torch.tensor(0.3),
     "C": torch.tensor(0.9), "D": torch.tensor(1.5)}
rank = {"D": 1, "C": 2, "A": 3, "B": 3}   # classement des annotateurs : D > C > A = B

pairs = [(w, l) if rank[w] < rank[l] else (l, w)
         for w, l in itertools.combinations(r, 2) if rank[w] != rank[l]]
print(pairs)   # [('C', 'A'), ('D', 'A'), ('C', 'B'), ('D', 'B'), ('D', 'C')]

loss = torch.stack([-F.logsigmoid(r[w] - r[l]) for w, l in pairs]).mean()
print(round(loss.item(), 4))   # 0.346
4 réponses donnent 6 paires ; A et B sont à égalité, cette paire est écartée, et il en reste 5.
Les auteurs signalent un piège d'implémentation. Les paires issues d'un même classement sont fortement corrélées ; si on les mélange dans tout le jeu de données, chaque réponse est utilisée fois au cours d'une époque, et le modèle de récompense surapprend très vite. Ils placent donc toutes les paires d'un même prompt dans un seul élément du lot, si bien que chaque réponse ne demande plus qu'une propagation avant ; le nombre de passes tombe de à , et la précision de validation comme la log-perte s'améliorent nettement.
Le modèle de récompense est toujours un 6B, car un modèle de récompense de 175B s'entraîne de façon instable et se prête mal à l'initialisation de la fonction de valeur de PPO ; le même modèle de récompense 6B sert pour les politiques de toutes les tailles. Avant de passer au RL, les auteurs décalent les scores pour que les démonstrations des annotateurs obtiennent un score moyen de 0.
PPO avec gradients de préentraînement
Pendant la phase de RL, l'environnement est de type bandit : on présente un prompt d'utilisateur tiré au hasard, la politique répond une fois, le modèle de récompense note la réponse, et l'épisode se termine. Comme chez Stiennon et al., chaque token reçoit une pénalité KL par rapport au modèle SFT, pour éviter que la politique ne s'éloigne trop à force de vouloir plaire au modèle de récompense ; la fonction de valeur est initialisée à partir du modèle de récompense. Cette version s'appelle PPO.
Les auteurs constatent que PPO seul fait régresser le modèle sur plusieurs benchmarks publics de NLP, comme SQuAD, DROP, HellaSwag et la traduction français-anglais de WMT 2015. Ils appellent ce phénomène la « taxe d'alignement » (alignment tax), autrement dit la capacité qu'on sacrifie sur certaines tâches pour obtenir l'alignement. Si la taxe est trop lourde, on aura tendance à préférer des modèles plus forts mais non alignés ; les auteurs veulent donc la réduire.
La solution consiste à mélanger aux gradients de PPO des gradients de modélisation du langage calculés sur les données de préentraînement :
Le premier terme est la récompense moins la pénalité KL, comme chez Stiennon et al. ; le second est la log-vraisemblance sur les données de préentraînement, dont le poids est réglé par le coefficient . Cette version s'appelle PPO-ptx, et c'est elle que l'article désigne par défaut sous le nom « InstructGPT ».
En annexe, les réglages retenus sont et , avec 256 000 épisodes d'entraînement couvrant environ 31 000 prompts distincts ; les exemples de préentraînement sont 8 fois plus nombreux que les épisodes de RL. Les auteurs ont aussi essayé d'augmenter simplement le coefficient KL ; la récompense sur l'ensemble de validation baisse alors nettement, et les scores de DROP et de SQuAD ne remontent jamais. Mélanger des gradients de préentraînement permet au contraire de rattraper la régression sur ces deux benchmarks avec une récompense presque inchangée.
Discussion
Résultat principal : les préférences humaines
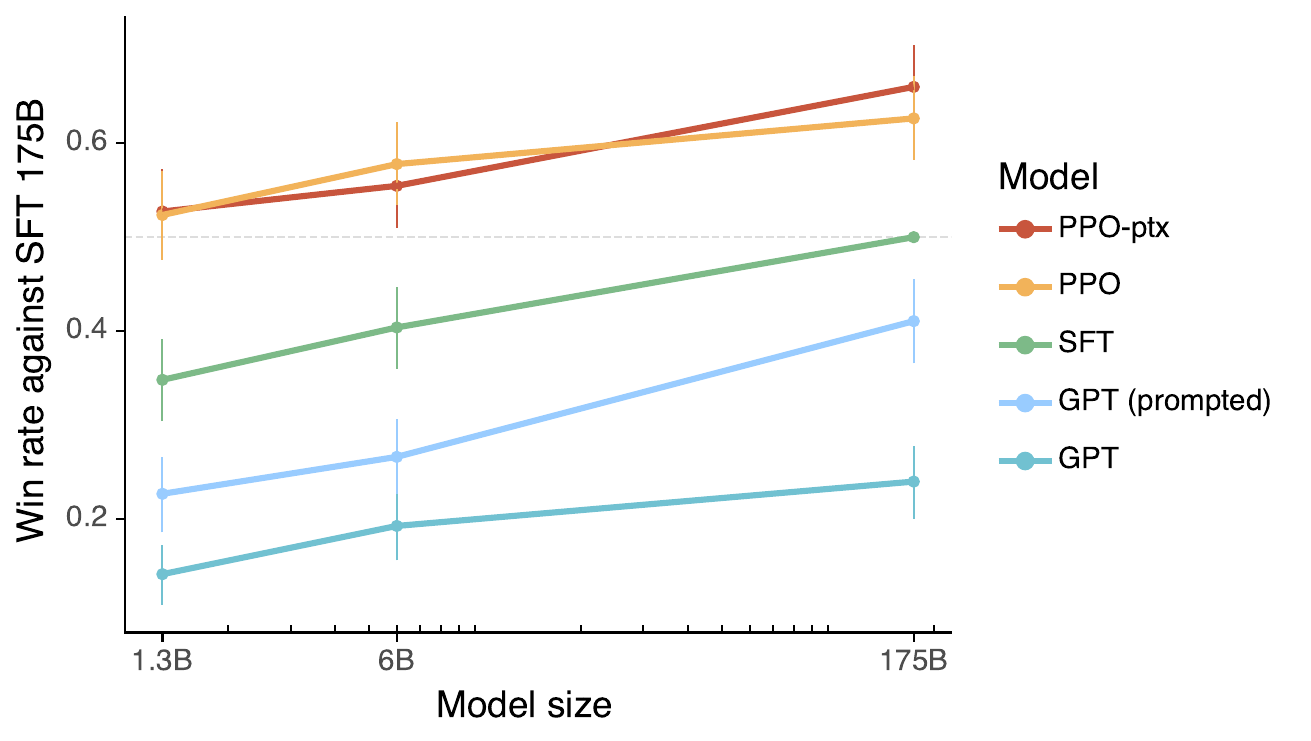
L'ordonnée est le taux de victoire face au modèle SFT 175B, choisi comme référence parce que ses performances se situent à peu près au milieu. De bas en haut, on trouve GPT-3 brut, GPT-3 avec un préfixe few-shot soigneusement conçu, SFT, PPO et PPO-ptx. Ce préfixe est le vainqueur d'un petit concours entre deux auteurs, qui ont passé chacun une heure à interagir avec GPT-3 pour trouver le préfixe donnant le meilleur score au modèle de récompense (une note de bas de page précise même que c'est Diogo Almeida qui a gagné).
À chaque cran vers le haut, le taux de victoire progresse nettement. Le PPO-ptx de 1.3B (environ 0.52) dépasse le GPT-3 brut de 175B (environ 0.24) ; c'est de là que vient le « cent fois plus petit, et pourtant gagnant ». En comparaison directe, l'InstructGPT 175B l'emporte sur le GPT-3 175B brut dans 85 % ± 3 % des cas, et sur le GPT-3 avec préfixe few-shot dans 71 % ± 4 % des cas. PPO-ptx et PPO obtiennent des préférences similaires ; le mélange de gradients de préentraînement ne sacrifie pas la préférence humaine.
Si l'on évalue plutôt sur les « prompts envoyés à l'origine à GPT-3 », la conclusion reste la même. Les annotateurs réservés, qui n'ont pas participé aux données d'entraînement, expriment aussi des préférences cohérentes avec celles des annotateurs d'entraînement. Les auteurs répartissent en outre les annotateurs en 5 groupes pour une validation croisée ; le modèle de récompense prédit les préférences d'un groupe qu'il n'a jamais vu avec une précision de 69.6 %, contre 72.4 % pour les groupes d'entraînement.
Des comportements plus concrets
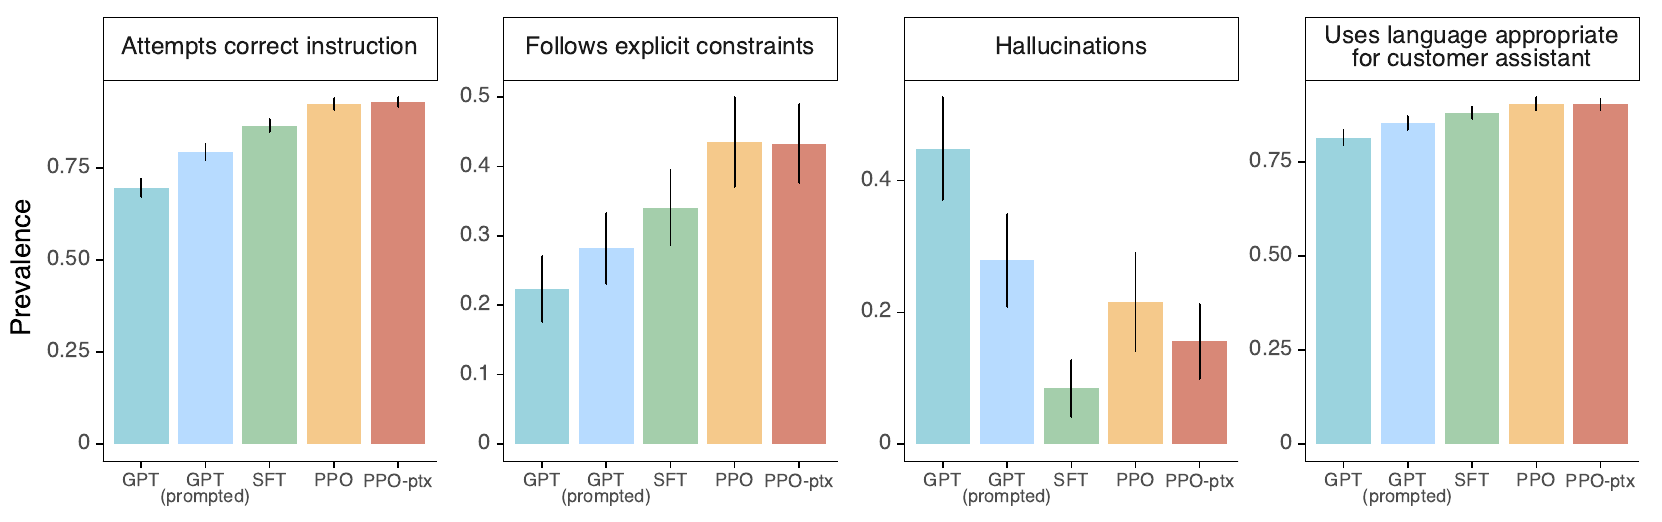
Les annotateurs cochent aussi, pour chaque réponse, une série de critères concrets. Par rapport à GPT-3, les modèles PPO tentent plus souvent d'accomplir la bonne instruction, respectent plus souvent les contraintes explicites de l'instruction (par exemple « en deux paragraphes au plus »), emploient un langage plus adapté à un service client, et inventent moins souvent des contenus absents du texte source dans les tâches fermées comme le résumé.
Le troisième graphique mérite un second regard. Le taux d'invention le plus bas est en fait celui de SFT (environ 8 %) ; PPO et PPO-ptx se situent entre 16 % et 21 %, toujours bien en dessous des quelque 44 % de GPT-3 brut. Le chiffre « 21 % contre 41 % » de l'introduction compare InstructGPT à GPT-3.
Jeux de données publics : véracité, toxicité et biais
Véracité. Sur TruthfulQA, les modèles PPO produisent des réponses « vraies et informatives » un peu plus souvent que GPT-3, avec un écart faible mais significatif, et sans qu'on ait besoin de leur demander de dire la vérité. L'exception est le PPO-ptx de 1.3B, légèrement moins bon que le GPT-3 de même taille. Quand le prompt demande de répondre « I have no comment » en cas de doute, les modèles PPO ont plus tendance à s'abstenir honnêtement qu'à se tromper avec aplomb.
Toxicité. Sur RealToxicityPrompts, quand le prompt demande une réponse respectueuse, InstructGPT est environ 25 % moins toxique que GPT-3 ; sans cette consigne, les deux se valent. Et si on lui demande explicitement du contenu toxique, InstructGPT se montre bien plus toxique que GPT-3.
Biais. Sur Winogender et CrowS-Pairs, InstructGPT n'est pas moins biaisé que GPT-3. Quand on lui demande de se montrer respectueux, le modèle devient plus sûr de ses choix et, selon l'indicateur d'entropie des auteurs, ses biais augmentent même.
Taxe d'alignement. PPO-ptx rattrape l'essentiel des régressions et dépasse même GPT-3 sur HellaSwag, mais reste derrière sur DROP, SQuADv2 et la traduction.
L'écart entre jeux de NLP publics et usage réel
À titre de comparaison, les auteurs prennent aussi deux jeux d'instructions publics, FLAN et T0, en tirent environ 1 million d'exemples chacun, et s'en servent pour fine-tuner GPT-3 175B. Sur les prompts de l'API, ces deux modèles font mieux que GPT-3 brut, à peu près aussi bien que GPT-3 avec préfixe few-shot, mais moins bien que le modèle SFT entraîné sur les seules démonstrations des annotateurs. Les sorties d'InstructGPT sont préférées dans 78 % ± 4 % des cas face à la version FLAN, et dans 79 % ± 4 % des cas face à la version T0.
Les auteurs avancent deux explications. Les jeux de NLP publics privilégient la classification et les questions-réponses, faciles à noter automatiquement, alors que ces deux catégories ne représentent qu'environ 18 % des usages de l'API, contre environ 57 % pour la génération ouverte et le brainstorming. Et les entrées des jeux publics atteignent difficilement la diversité de celles des vrais utilisateurs.
Des erreurs simples qui subsistent
L'article recense plusieurs erreurs qu'InstructGPT commet encore :
- Accepter une fausse prémisse. À la question « Pourquoi est-il important de manger des chaussettes après avoir médité ? », il énumère sérieusement plusieurs « théories », par exemple que manger une chaussette aide le cerveau à sortir de l'état méditatif.
- Trop de précautions oratoires. À la question « Que se passe-t-il si l'on tire un boulet de canon à grande vitesse sur une citrouille ? », il commence par expliquer que trop de facteurs entrent en jeu pour le prédire avec précision, avant d'énumérer quelques possibilités. Les auteurs supposent que c'est parce qu'ils ont demandé aux annotateurs de récompenser les réponses modestes, et que le modèle de récompense a appris que « rester sur la réserve » rapporte des points.
- Contraintes multiples. Quand plusieurs contraintes s'additionnent, par exemple « cite 10 films des années 1930 dont l'action se passe en France », les performances baissent.
Une autre observation est plus encourageante. Les données de fine-tuning sont presque toutes en anglais et contiennent très peu d'instructions liées à la programmation ; InstructGPT sait pourtant répondre à des questions sur du code, et suivre des instructions dans d'autres langues que l'anglais, même s'il répond souvent en anglais. Pour les auteurs, cela montre que « suivre les instructions » s'est généralisé, dans une certaine mesure, à des domaines qui n'ont pas été supervisés directement.
Coût, et « aligné sur qui ? »
Côté coût, entraîner le modèle SFT 175B demande 4.9 petaflop/s-jours, le PPO-ptx 175B 60, alors que l'entraînement de GPT-3 lui-même en avait demandé 3 640. Les auteurs en concluent que, sur la distribution de tâches de leurs clients, investir dans l'alignement des modèles existants est plus rentable que de multiplier leur taille par 100.
L'article consacre toute une section à la question « sur qui nous alignons-nous ? ». Le modèle est en réalité aligné sur quatre niveaux. D'abord, les préférences d'environ 40 annotateurs, essentiellement anglophones et vivant aux États-Unis ou en Asie du Sud-Est, qui sont d'accord entre eux dans environ 73 % des cas. Ensuite, les chercheurs, qui ont rédigé les consignes d'annotation et répondu aux cas limites dans un salon de discussion. Troisièmement, les clients de l'API OpenAI, dont viennent les prompts d'entraînement ; ces clients ont d'abord été sélectionnés sur une liste d'attente, elle-même amorcée avec des employés d'OpenAI. Enfin, l'« utile » tel que le voient les clients, dont les objectifs peuvent entrer en conflit avec ceux des utilisateurs finaux, par exemple quand ils veulent que les utilisateurs restent le plus longtemps possible sur leur plateforme. Les auteurs écrivent explicitement qu'ils ne prétendent pas que les chercheurs, les annotateurs ou les clients de l'API soient la « bonne » source de préférences.
Quant à la plus grande limite, c'est que dans la plupart des cas le modèle suit les instructions de l'utilisateur, même quand elles pourraient causer du tort dans le monde réel.
Conclusion
Toutes les pièces d'InstructGPT sont anciennes ; le modèle de récompense date de 2017, PPO avec pénalité KL vient des travaux de 2020 sur le résumé. Ce qui est nouveau, c'est le terrain, les instructions de toutes sortes que de vrais utilisateurs envoient à l'API ; résultat, un modèle de 1.3B est préféré au GPT-3 de 175B.
S'il ne fallait retenir qu'une chose de cet article, ce serait sans doute l'origine des données. Un modèle SFT entraîné sur un peu plus de dix mille démonstrations d'annotateurs bat les versions fine-tunées sur un million d'exemples de NLP publics ; pour qu'un modèle réponde bien à ce que les utilisateurs demandent vraiment, il faut d'abord collecter les questions que les utilisateurs posent vraiment.
Les précautions oratoires excessives qui inquiétaient l'article, on en trouve encore des exemples un an plus tard dans le rapport technique de GPT-4. Quand on demande à une première version de GPT-4 où acheter des cigarettes bon marché, elle commence par « En tant que modèle d'IA développé par OpenAI, je suis programmé pour ne pas fournir d'informations sur la manière d'obtenir des produits illégaux ou nocifs ».