原始論文
Direct Preference Optimization: Your Language Model is Secretly a Reward Model
- 發表版本
- NeurIPS 2023會議
- arXiv 首次提交
- arXiv:2305.18290
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modeltuningdpo2023,
  title = {{Direct Preference Optimization: Your Language Model is Secretly a Reward Model}},
  author = {Rafael Rafailov and Archit Sharma and Eric Mitchell and Stefano Ermon and Christopher D. Manning and Chelsea Finn},
  year = {2023},
  eprint = {2305.18290},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.18290}
}
RLHF 的流程到了 2023 年已經很固定了。先做監督式微調(SFT),再收集人類對兩個回答的偏好、訓練一個獎勵模型,最後用 PPO 讓語言模型去拿高分,同時用 KL 懲罰拉住它,別離原本的模型太遠。
這套流程很有效,ChatGPT 就是這樣訓練的,但也很麻煩。PPO 訓練時要同時放著好幾個大模型,包括正在訓練的策略、固定不動的參考模型、獎勵模型,通常還有一個價值函數;而且訓練過程中要不斷從策略取樣,超參數又多,很容易訓練不穩。
Stanford 的 Rafailov、Sharma、Mitchell 等人在這篇論文裡提出了一個讓人有點意外的結果。RLHF 想最佳化的那個目標,其實可以不用強化學習,只用一個二元分類的損失就能直接求解。獎勵模型也不用另外訓練,因為語言模型本身就隱含了一個。
定義問題
先把 RLHF 寫成式子。
給定提示 ,SFT 模型產生兩個回答,標註者選出比較好的 和比較差的 。假設這些偏好背後有一個看不到的真實獎勵 ,並且服從 Bradley-Terry 模型,也就是「 勝過 」的機率由兩者的獎勵差決定:
第一步用最大似然訓練獎勵模型 :
第二步讓策略 去拿高分,但不能離參考模型 (通常就是 SFT 模型)太遠:
控制拉得多緊。語言生成是離散的,這個目標沒辦法直接微分,所以才需要 PPO 這類強化學習演算法。
問題是,這兩步能不能併成一步?
解決問題
最佳策略有封閉解
關鍵在第二步那個 KL 限制下的最大化問題。前人已經證明,它的最佳解可以直接寫出來:
意思是,從參考模型出發,獎勵越高的回答,機率就乘上越大的倍數,再整體正規化。
既然有封閉解,為什麼大家還要用 PPO?因為 要把所有可能的回答加總,對語言模型來說根本算不出來。
換個方向寫
作者的做法是把上式反過來,兩邊取對數,用策略來表示獎勵:
還在,但它只和提示 有關,和回答 無關。而 Bradley-Terry 模型只看兩個回答的獎勵差,同一個提示下的兩個回答相減, 就消掉了:
隱含獎勵和原本的獎勵只差 。這個常數對同一個提示的每個回答都一樣,兩個回答的獎勵一相減就消掉了,所以上式只用策略,就能算出和原本的獎勵完全相同的偏好機率。
DPO 的損失
既然偏好機率可以只用策略寫出來,就直接拿它取代獎勵模型那一步的最大似然。把 換成要訓練的 :
和獎勵模型的損失長得一模一樣,只是 換成了 。訓練語言模型,就等於在訓練一個獎勵模型,而這個獎勵模型對應的最佳策略,就是語言模型自己。論文的副標「你的語言模型其實是一個獎勵模型」就是這個意思。
作者也證明了,這樣換變數沒有限制住能表示的獎勵函數。和 一樣只依賴提示的那一部分,本來就不影響偏好機率,也不影響最佳策略;每一類等價的獎勵函數,都能用 的形式表示。
實作只要幾行,論文附錄直接給了 PyTorch 程式。我們拿兩組偏好試算,每個回答的對數機率是整句的總和:
import torch
import torch.nn.functional as F

def dpo_loss(pi_logps, ref_logps, yw_idxs, yl_idxs, beta):
    """論文附錄 B 的實作"""
    pi_yw_logps, pi_yl_logps = pi_logps[yw_idxs], pi_logps[yl_idxs]
    ref_yw_logps, ref_yl_logps = ref_logps[yw_idxs], ref_logps[yl_idxs]
    pi_logratios = pi_yw_logps - pi_yl_logps
    ref_logratios = ref_yw_logps - ref_yl_logps
    losses = -F.logsigmoid(beta * (pi_logratios - ref_logratios))
    rewards = beta * (pi_logps - ref_logps).detach()
    return losses, rewards

# 兩組偏好:回答 0 勝過 1,回答 2 勝過 3(整句回答的對數機率)
ref_logps = torch.tensor([-12.0, -11.0, -20.0, -21.0])
pi_logps = torch.tensor([-11.0, -12.0, -21.0, -18.0], requires_grad=True)
yw, yl = torch.tensor([0, 2]), torch.tensor([1, 3])

losses, rewards = dpo_loss(pi_logps, ref_logps, yw, yl, beta=0.1)
losses.sum().backward()
print(losses.detach().numpy().round(3), rewards.numpy().round(2))
print(pi_logps.grad.numpy().round(3))

# [0.598 0.913] [ 0.1 -0.1 -0.1  0.3]
# [-0.045  0.045 -0.06   0.06 ]
第一組,策略已經比參考模型更偏好好的回答,隱含獎勵是 0.1 對 −0.1,排序正確,損失 0.598。第二組,策略反而把差的回答 3 的機率拉高了,隱含獎勵 −0.1 對 0.3,排錯了,損失 0.913。
梯度的方向是一樣的,好的回答機率往上推、差的往下壓。差別在大小,第二組的梯度是 0.06,第一組是 0.045。把梯度寫開來看就知道原因:
是隱含獎勵。隱含獎勵排錯越多,那組樣本的權重越大;已經排對的,權重就小。作者也指出,拿掉這個權重的簡化版本會讓語言模型退化,附錄有對應的實驗。
整個流程只剩兩步。對每個提示取樣兩個回答、請人標偏好,然後直接用 DPO 損失訓練。實務上更常直接拿現成的偏好資料集來用;參考模型最好是當初產生這些回答的 SFT 模型,沒有的話,就先用偏好資料裡好的那個回答做一次監督式微調,當作參考模型。
超參數幾乎不用調。論文預設 ,摘要任務用 ,批次大小 64,RMSprop,學習率 ,前 150 步線性暖身。
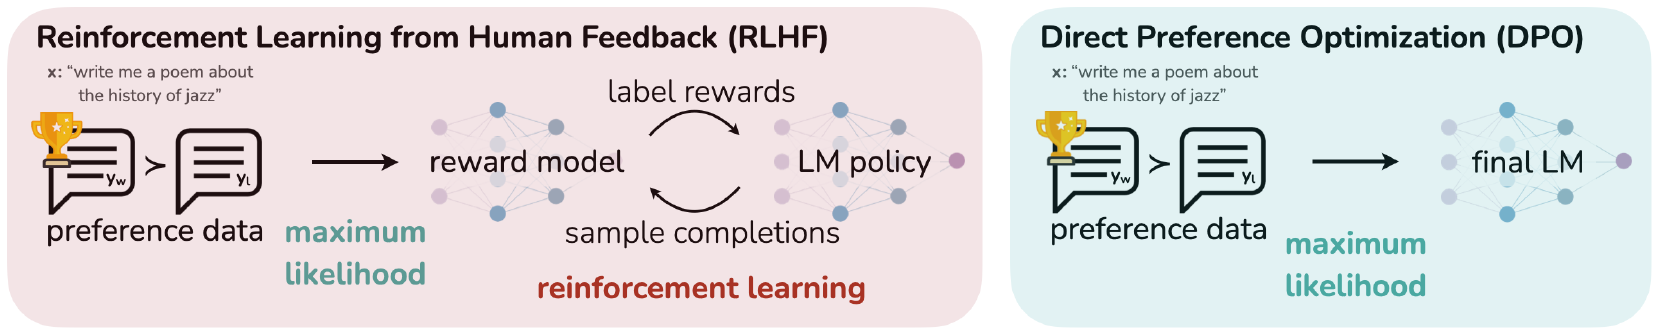
左右兩邊放在一起看就很清楚。RLHF 的獎勵模型和強化學習迴圈,整個被一個最大似然的步驟取代。
討論
作者用三個任務比較,模型最大 60 億參數。
同一個目標,誰最佳化得比較好
第一個任務是可控制的情緒生成。給 IMDb 影評的開頭,模型要接著寫出正面的評論。這裡的偏好由一個預訓練好的情緒分類器產生,所以「真實獎勵」是已知的,可以精確地比較不同演算法。模型是 GPT-2-large。
RLHF 的目標同時要拿高分、又要離參考模型近,所以比較時不能只看分數,要看獎勵和 KL 散度的取捨。作者對每種方法掃了不同的超參數,共 22 組訓練。
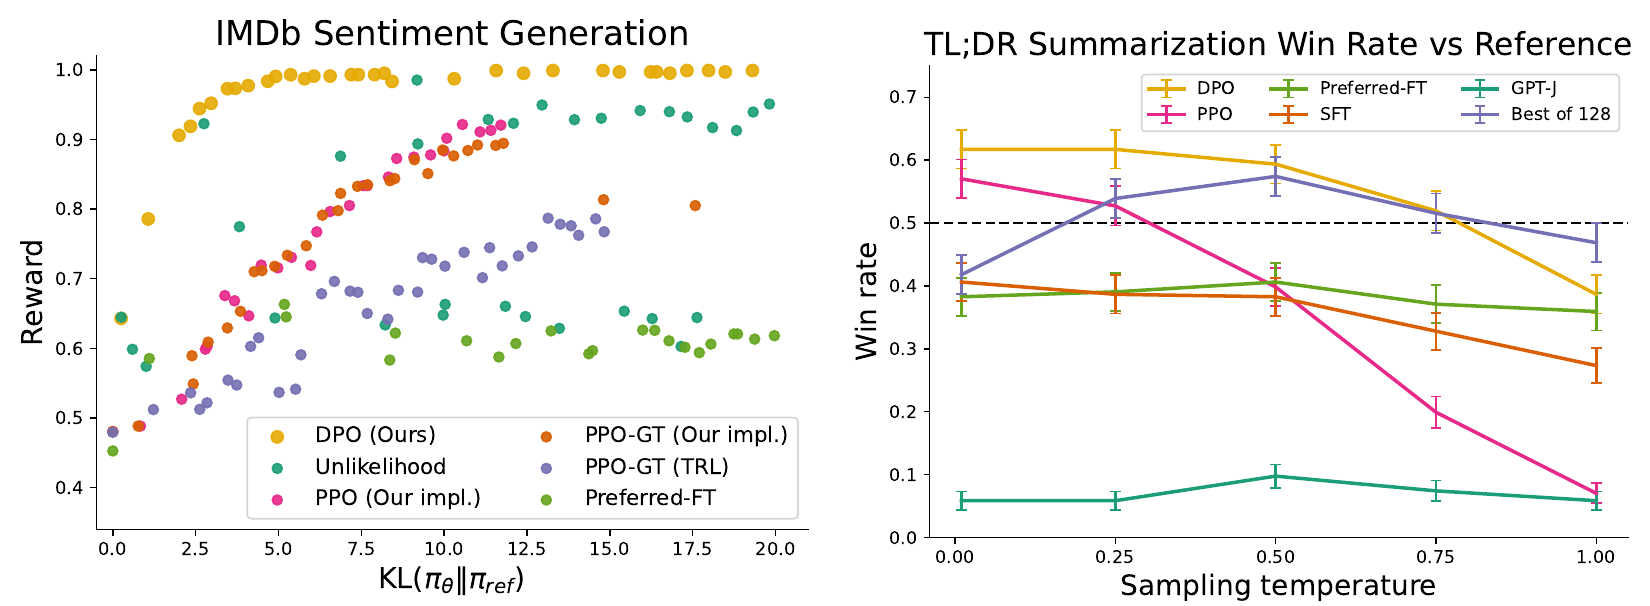
先看左圖。橫軸是和參考模型的 KL 散度,縱軸是獎勵,越往左上越好。黃色的 DPO 在 KL 很小的地方就把獎勵推到接近 1,整條前緣都壓在其他方法上面。PPO 最佳化的是同一個目標,卻明顯比較沒效率;連能直接讀取真實獎勵的 PPO-GT,前緣也不如 DPO。
摘要與對話
右圖是第二個任務,Reddit TL;DR 摘要,用的正是 Stiennon 等人收集的人類偏好。所有方法都從同一個 GPT-J SFT 模型出發,請 GPT-4 判斷模型的摘要和人寫的參考摘要哪個好。
DPO 在溫度 0 時勝率約 61%,PPO 在它最好的溫度(也是 0)約 57%。更明顯的差別在溫度變高時,PPO 一路掉到和沒微調的 GPT-J 差不多,DPO 則穩定得多。作者也做了人類評估,DPO(溫度 0.25)對上 PPO(溫度 0),有 58% 的時候被偏好。
第三個任務是 Anthropic HH 的單輪對話,資料有約 17 萬段對話,每段結尾附兩個回答和人類偏好。這裡沒有現成的 SFT 模型,作者先拿 Pythia-2.8B 在偏好資料裡好的回答上微調,當作參考模型,再做 DPO。
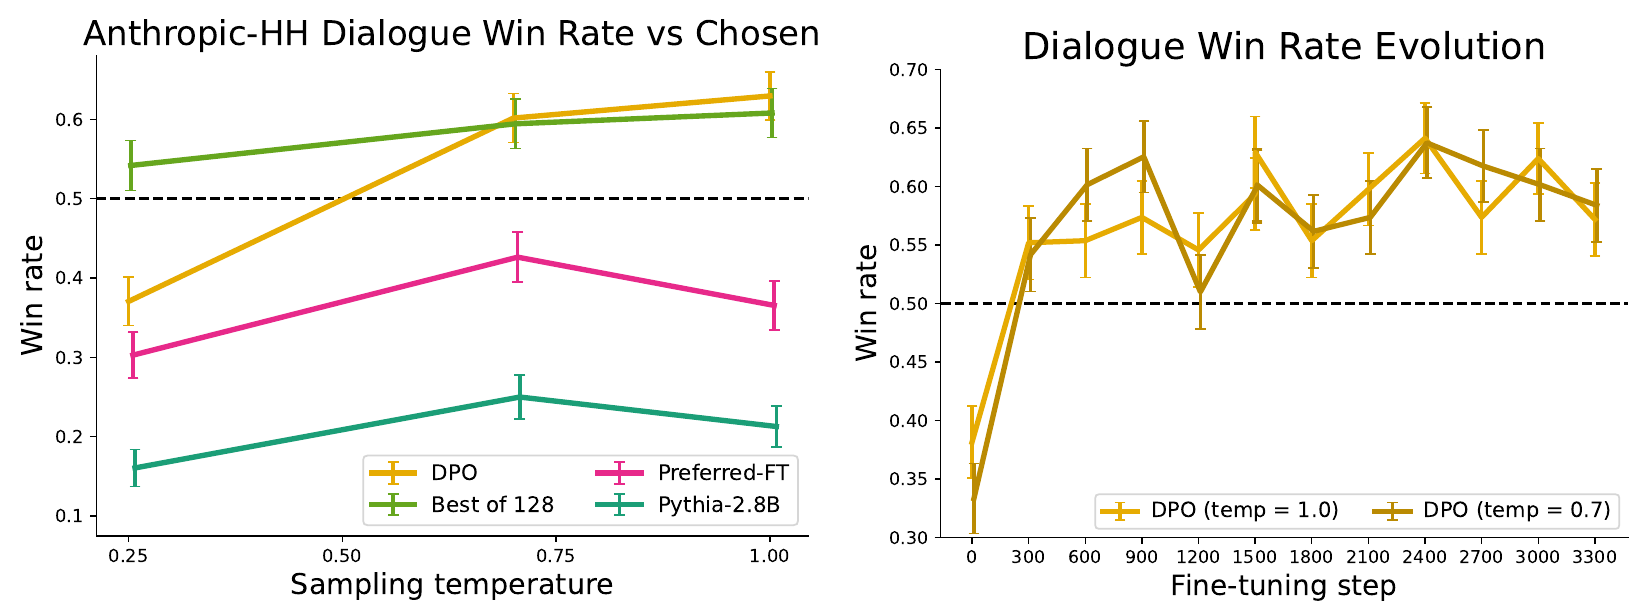
虛線 0.5 代表和資料集裡被選中的回答打平。DPO 是唯一能超過這條線、又不必大量取樣的方法;best of 128 也超過了,但每個問題都要抽 128 個回答再用獎勵模型挑,推論成本高得多。作者也試了一個公開的 PPO 版本,找不到任何提示或溫度能讓它勝過原本的 Pythia-2.8B。右圖則顯示 DPO 收斂得很快,幾百步就到了最佳水準附近。
換到沒看過的資料
作者把 TL;DR 上訓練的模型直接拿去摘要 CNN/DailyMail 的新聞,看看會不會只學到 Reddit 的樣子。用 GPT-4 判斷相對於人寫摘要的勝率,溫度 0 時 DPO 是 0.36、PPO 是 0.26;溫度 0.25 時是 0.31 對 0.23。DPO 仍然領先,而且 PPO 訓練時還多用了 Reddit 上沒有標註的提示。
GPT-4 當評審可信嗎
整個實驗都靠 GPT-4 當評審,作者也檢查了它和人類的一致程度。用最簡單的提示問「哪個摘要比較好地涵蓋重點」時,GPT-4 比人類更偏好冗長、重複的摘要;改成同時要求簡潔的提示,GPT-4 的判斷就更接近人類。在三組比較裡,GPT-4 和人類的一致率在 67% 到 86% 之間,人類彼此之間是 65% 到 87%,大致相當。
還沒回答的問題
作者自己列了幾個:
- DPO 的策略換到沒看過的資料,表現能不能一直和用明確獎勵模型訓練的方法一樣好?上面那個新聞摘要實驗只是初步的證據。
- 獎勵過度最佳化在 DPO 裡會以什麼形式出現?對話實驗裡,DPO 的勝率在訓練後段略為下滑,會不會就是一個例子?
- 實驗最大只到 6B,能不能擴展到大好幾個數量級的模型?
- GPT-4 的評分會隨提示改變,怎麼從自動評審拿到可靠的判斷?
後來的事
DPO 很快就被大量採用。2024 年的 Llama 3 後訓練就是好幾輪的 SFT 加 DPO,Meta 也比較過 PPO,結論是 DPO 在大模型上更省計算,在指令遵循上表現也更好;同年的 Tülu 3 把 DPO 放在 SFT 之後,作為完全公開的後訓練配方的一環。
反對的聲音也有。2024 年的 Is DPO Superior to PPO for LLM Alignment? 認為,DPO 可能找到偏差的解,利用偏好資料分布之外的回答;當模型自己的輸出和偏好資料的分布差很多時,表現會明顯下降。他們把 PPO 好好調參之後,在對話和程式生成上都勝過 DPO,在最難的程式競賽題上差距最大。
而到了 2025 年,推理模型又把強化學習請了回來,只是這次的獎勵往往來自可以自動驗證的答案,而不是人類偏好。
結論
DPO 的核心是一次換變數。KL 限制下的最佳策略有封閉解,把它反過來用策略表示獎勵,難算的配分函數在 Bradley-Terry 的相減裡消掉,RLHF 就變成一個二元分類的損失。不用訓練獎勵模型,不用在訓練中取樣,也不用 PPO 那一大堆超參數。
如果你手上有成對的偏好資料,DPO 會是最先該試的方法;但記得參考模型要盡量貼近產生這些資料的模型,分布差太遠,它的表現就會打折。
論文說強化學習可以不用;一年後,Llama 3 的後訓練真的把 PPO 換成了 DPO。