原始论文
Shampoo: Preconditioned Stochastic Tensor Optimization
- 发表版本
- ICML 2018会议
- arXiv 首次提交
- arXiv:1802.09568
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersshampoo2018,
  title = {{Shampoo: Preconditioned Stochastic Tensor Optimization}},
  author = {Vineet Gupta and Tomer Koren and Yoram Singer},
  year = {2018},
  eprint = {1802.09568},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1802.09568}
}
这篇论文的名字,藏在第 2 页的一个脚注里,「We call it Shampoo because it has to do with preconditioning.」
conditioner 是护发素,preconditioning 就是「护发之前」,那当然是洗发水。致谢里还特别感谢 Roy Frostig 想出了这个名字。
玩笑归玩笑,论文要处理的是一个很实际的麻烦。优化器如果想看清楚参数之间怎么互相牵动,就得维护一个「参数数量平方」大小的矩阵;Google Brain 的 Vineet Gupta、Tomer Koren 与 Princeton 的 Yoram Singer 想找一个办法,让这个矩阵不用真的存下来。
定义问题
预条件在做什么
最朴素的梯度下降,每个参数都用同一个学习率往梯度的反方向走。预条件方法在走之前,先拿一个矩阵乘一下梯度:
如果是对角矩阵,效果就是每个参数各自缩放步长,Adam、AdaGrad 都属于这一类。 如果是完整的矩阵,它还能把梯度「转个方向」。当损失地形是一条斜着的狭长山谷,两个参数必须一起动才能沿谷底前进,对角矩阵只能分别缩放两个坐标轴,完整矩阵才能把那条斜谷转正。
full-matrix AdaGrad 太大了
AdaGrad 有一个完整矩阵的版本,预条件是累积梯度外积的平方根:
理论性质比对角版好,但没人用得起。拿一个 的全连接层来算,展平后有 万个参数, 就是 ,约 个元素,单精度要 4 TB 以上;每次还要对它开根号再求逆,计算量是 。
当时的出路有几条。对角近似便宜,但参数之间的相关性全部丢掉;sketch 或其他估计方法,作者评为「seldom practical at large scale」。K-FAC 也用 Kronecker 分解,但它近似的是 Fisher 矩阵,要从模型的预测分布采样,还依赖前馈网络的反向传播结构,换一个架构就得重新推导。
神经网络的参数本来就是矩阵与张量。全连接层是 ,卷积核是四维。这篇的问题是,能不能保留这个形状,用几个小矩阵去近似那个巨大的预条件?
解决问题
左右各一个
在矩阵情形下,Shampoo 为一个 的权重矩阵维护两个预条件,左边 、右边 (Algorithm 1):
初始值是 、。 累积的是各「行」之间的相关性,对全连接层来说是输出单元之间; 累积的是各「列」之间,也就是输入特征之间。更新时,梯度从左边乘一次、右边乘一次。
同样那个 的层, 与 加起来是 万个元素,单精度 8 MB。内存从 降到 ,算矩阵次方的成本从 降到 。
这两个小矩阵其实就是一个大矩阵的伪装。论文的 Lemma 4 给出 Kronecker 积的恒等式,把 展平后,等于 乘上展平的梯度。所以 Shampoo 等于在用一个 的预条件 ,只是这个矩阵从头到尾都没有被组装出来。
写成代码,一个矩阵参数的更新就这几行:
import torch

def matrix_power(A, p):
    """对称正定矩阵的 p 次方:特征分解后只对特征值取次方"""
    lam, Q = torch.linalg.eigh(A)
    return Q @ torch.diag(lam ** p) @ Q.T

class ShampooMatrix:
    """Algorithm 1:为一个 m×n 的权重矩阵做 Shampoo"""
    def __init__(self, m, n, lr, eps=1e-4):
        self.L = eps * torch.eye(m)   # L_0 = εI_m
        self.R = eps * torch.eye(n)   # R_0 = εI_n
        self.lr = lr

    @torch.no_grad()
    def step(self, W, G):
        self.L += G @ G.T             # 累积 m×m 的左统计量
        self.R += G.T @ G             # 累积 n×n 的右统计量
        W -= self.lr * matrix_power(self.L, -0.25) @ G @ matrix_power(self.R, -0.25)
论文自己的实现用的是 TensorFlow,矩阵次方用 SVD 算,做法相同。
为什么是 1/4
AdaGrad 开根号,所以指数应该是 才对?Shampoo 用的却是 ,而且左右各一次。
答案在 Lemma 8。假设每一步的梯度矩阵秩不超过 ,作者证明:
左边是 full AdaGrad 的统计量。证明分两步。先分别证出 和 ,也就是左右各有一个上界;再用矩阵几何平均的单调性,把两个上界各取 次方相乘。第一个 就是从这里来的。
AdaGrad 的预条件还要对统计量开一次根号。开根号在半正定矩阵上保持顺序,两边同取 次方,就得到
所以 ,一半来自几何平均,一半来自 AdaGrad 的平方根。Shampoo 的 是一个盖在 full AdaGrad 预条件上方的 Kronecker 结构矩阵。作者特别指出,full-matrix 预条件中最影响预条件效果的那些小特征值,不会因为这个近似而消失。
论文另外给了一个直觉,这个指数让整体步长以 衰减,正是随机优化中常见的速率。梯度大小稳定时, 和 大致随步数 线性增长, 和 各贡献 ,合起来刚好是 。
这个 是证明里上界的产物。后来的实现把指数开放成可调,常改用 ,讨论部分再回来看。
张量版本
卷积核是四维的。Shampoo 的一般形式(Algorithm 2)为张量的每一维 维护一个 的预条件 ,统计量是把梯度沿其他所有维收缩后得到的矩阵;更新时逐维乘上 , 是张量的阶数。矩阵 ,回到 。
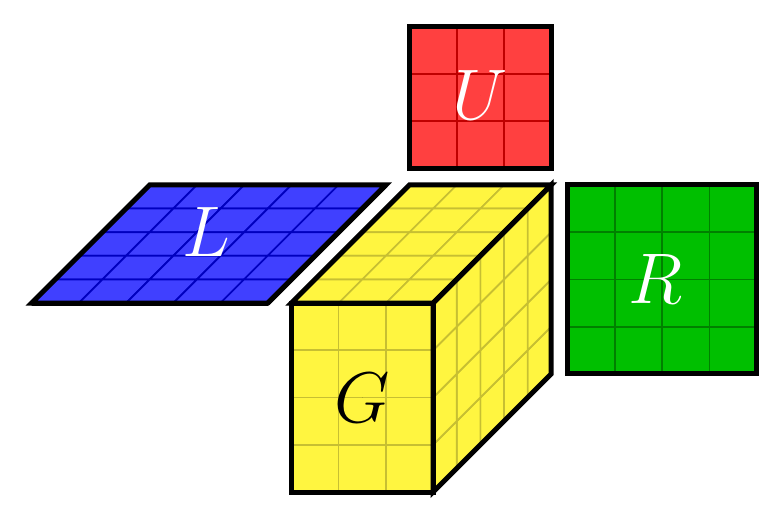
拿论文 CIFAR-100 实验里最大的卷积核 来算,它有 589,824 个参数,full AdaGrad 的预条件约 个元素;Shampoo 只需要四个矩阵, 个元素,指数是 。
收敛保证与它的条件
理论在在线凸优化框架下证明(Theorem 7)。梯度秩不超过 时,regret 上界是
是迭代过程中 与最优解距离的最大值。若梯度的谱范数不超过 1,两个 trace 各以 增长,总 regret 是 ,在在线凸优化里已经是最好的速率。张量版本(Theorem 10)同理, 换成各维秩的几何平均。
条件要读清楚。损失必须是凸的; 可能随 变大,要让它有界,得在每一步把 投影回一个球里,而这个投影要用 诱导的范数,计算很贵,作者便在算法里省略了它,接受一个「slightly looser」的界。深度网络不是凸的,这组证明是算法的出处和动机,实验才是它在神经网络上的证据。
落地时的妥协
实现上有两个取舍。每个参数张量各自处理,整体是 block-diagonal 的预条件,不同层之间的相关性直接忽略。某一维太大时(实验中的阈值约 1200),那一维自动改用对角版本(附录 A 的 Algorithm 3),只存对角元素。另外,实验时再加两个启发式调整,矩阵根每 20 到 100 步才重算一次,以及系数 0.9 的梯度动量;作者说前者对准确率「almost no impact」。
讨论
实验规模很小
所有实验的批量大小都是 128,预条件用整个 batch 的平均梯度更新。图像分类用 CIFAR-10 上 2.4M 参数的 32 层 ResNet 和 1.65M 参数的小型 Inception,CIFAR-100 上 13.5M 参数、不含 BatchNorm 的 55 层 ResNet;每个优化器在 0.01 到 10 之间扫 10 个学习率。这部分论文只画了训练损失曲线,没有测试准确率的对照表。
语言模型是 LM1B 上 9.8M 参数的 Attention 模型,最大的张量是 。
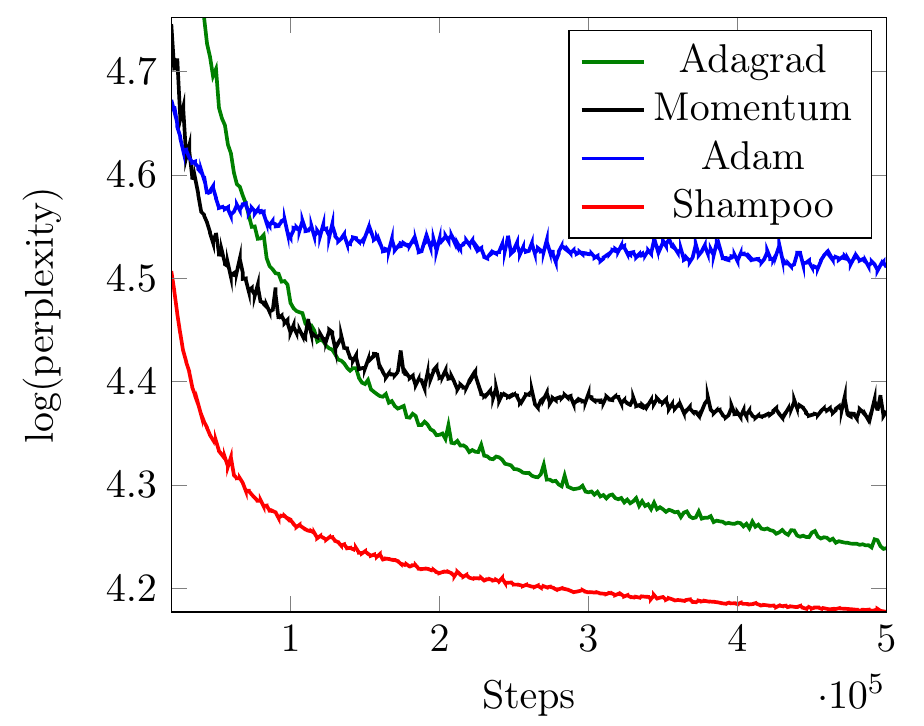
红线从第一个点开始就在最下面,到 50 万步时约 4.18,绿色的 AdaGrad 约 4.24,黑色的 Momentum 约 4.37,蓝色的 Adam 很早就停在 4.5 附近。
这张图的比较条件不对称。Shampoo 直接用默认学习率 ,其他方法「explored various different settings」,但论文没有列出 Adam 扫过哪些值。Adam 在 Attention 模型上落后 AdaGrad 一大截,本文的推论是,这和后来 Transformer 普遍用 Adam 训练的经验不太一致,差距很可能来自调参的不对称,读这张图时要把这一点考虑进去。
每一步多花多少
论文用一张每秒步数的表回应「矩阵运算会不会太慢」(Tesla K40,批量 128):
| 实验 | SGD | Shampoo | 比值 |
|---|---|---|---|
| ResNet-32(C10) | 2.184 | 2.151 | 98% |
| Inception(C10) | 3.638 | 3.506 | 96% |
| ResNet-55(C100) | 1.210 | 1.249 | 103% |
| Attention(LM1B) | 4.919 | 3.509 | 71% |
整理自原论文 Table 1,比值为本文计算;Adam、AdaGrad 的数字与 SGD 相近,表中省略。
卷积网络上几乎没差,ResNet-55 甚至比 SGD 快一点。LM1B 的每秒步数只剩 SGD 的 71%,论文没有分析原因;这个模型最大的张量是 ,按实验用的约 1200 阈值,2000 那一维会改走对角版本。这组数字是在模型只有几百万参数、根每 20 到 100 步算一次的条件下测的。
后来的 Shampoo
2018 年的原版离大规模训练还很远。后面两个版本做的主要是工程。
Anil 等人(2020)的 Distributed Shampoo。 作者群包含原论文的三位作者,论文题名是〈Scalable Second Order Optimization for Deep Learning〉。他们发现真实模型的 条件数极大,矩阵根必须用双精度算,这在 TPU 上很贵。改动包括:
- 加速器每一步只累积统计量,逆 次方根每 步送到主机的 CPU 上异步计算,分摊到所有核心,不阻塞训练循环;
- 用 coupled Newton 迭代取代 SVD 算逆根,搭配 warm start;
- embedding、softmax 这类维度上百万的层只做单边预条件,大型全连接层切成区块各自预条件;
- 预条件每几百步才更新一次;
- grafting,方向取 Shampoo,步长大小取一个调好的一阶方法(例如对角 AdaGrad),每层各自嫁接;
- 指数改成可调的超参数,统计量改用指数移动平均。
结果是 WMT'14 英译法的 Transformer 步数减半,墙钟时间少 45%(约 12 小时降到 6.7 小时)。
Shi 等人(2023)的 PyTorch 版。 Meta 团队针对 GPU 的数据并行训练重写了一版。每个 worker 只负责一部分参数区块的预条件,算完再用 AllGather 收齐方向,每一步的墙钟时间比对角方法最多多 10%。矩阵根改用 torch.linalg.eigh,他们发现单精度通常够用;小维度合并、大维度切块,ImageNet 实验的区块上限设为 2048;grafting、偏差修正、decoupled weight decay、Nesterov 一应俱全。在 ImageNet 的 ResNet-50 上,Shampoo 用 60 个 epoch 达到 SGD-Nesterov 90 个 epoch 的验证准确率,总墙钟时间快 1.35 倍。
AlgoPerf 2024。 MLCommons 在 2024 年 8 月公布第一届 AlgoPerf 训练算法竞赛的结果,外部调参组冠军就是这份 PyTorch Distributed Shampoo,得分 0.78,平均比 NAdamW 基线快约 28%。赛后分析论文的细节更值得看。八个工作负载里,它只在 Criteo 1TB 和 ViT 两项最快;WMT 花的时间是最快提交的两倍以上;ResNet 则没能在时间预算内稳定达标。它赢在几乎每一项都稳定地不差。
同一年的 Gemini 1.5 技术报告也写到,1.5 Flash「is trained with higher-order preconditioned methods」,引用了 AdaGrad 等文献,没有点名是哪一个方法。
1/4 还是 1/2
指数的问题后来有了答案。Anil 等人在附录写到,把指数当成超参数有时效果更好,他们的自编码器实验用的就是 ;Shi 等人的实现则建议,以全连接层为主的网络可以把指数覆盖成 ,同样是 ,或把原本的指数乘上 1.82 倍。Morwani 等人(2024)给出了解释, 恰好等于「求 full AdaGrad 统计量的最佳 Kronecker 近似」做一步幂迭代的结果,而且很接近最佳近似。既然 本身就在近似 ,要模仿 AdaGrad 的 次方,左右各取 才对。以 Morwani 等人(2024)的结果回头看,本文把原论文的 概括为一个不够紧的上界带出来的指数。
也没有白费。把累积拿掉,只看当下这一步的梯度 :
所有奇异值都被压成 1,这就是 Muon 的正交化更新。Shampoo 的第一步,统计量里只有一个梯度,ε 很小时走的方向就是 ;用上面的代码对一个 的随机梯度走一步,结果和 只差 ε 造成的偏移,大多在 量级。Keller Jordan 在 2024 年 12 月介绍 Muon 的文章里也写到,去掉累积的 Shampoo 再加上动量就是 Muon,差别在 Shampoo 要算逆四次根,Muon 用 Newton–Schulz 迭代便宜地近似。
结论
Shampoo 用两个小矩阵的 Kronecker 积,近似 full-matrix AdaGrad 那个存不下的预条件,内存从 降到 ,并在凸设定下证明了 的 regret。论文的实验只到千万参数,主要证明了「每一步没有慢太多」。
如果今天要试,直接用 Meta 的 Distributed Shampoo,从 grafting 用 Adam、指数 、预条件每几十步更新一次开始调,并先测好你的模型里最大那一维让每一步慢了多少。原版的代码留着理解算法就好。
论文第 12 页写着「We plan to implement Shampoo in PyTorch in the near future」。后来拿下 AlgoPerf 冠军的,正是 Meta 团队在五年后写成的 PyTorch 版。