原始论文
GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection
- 发表版本
- ICML 2024会议
- arXiv 首次提交
- arXiv:2403.03507
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersgalore2024,
  title = {{GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection}},
  author = {Jiawei Zhao and Zhenyu Zhang and Beidi Chen and Zhangyang Wang and Anima Anandkumar and Yuandong Tian},
  year = {2024},
  eprint = {2403.03507},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.03507}
}
从零训练一个 70 亿参数的 LLaMA,batch size 只放一条长度 2,048 的序列,需要多少显存?
论文开头先算给我们看。BF16 的权重 14 GB;权重梯度 14 GB,加上 Adam 的一阶、二阶矩各 14 GB,一共 42 GB;activation 再 2 GB。合计 58 GB。一张 RTX 4090 只有 24 GB。
这篇的主张是,用它提出的方法再搭配 8-bit Adam 与逐层更新,7B 的预训练实测只要 22 GB。不切模型、不做 activation checkpointing,也不把东西搬到 CPU,一张 4090 就放得下。
定义问题
省显存的老办法不少。activation checkpointing 用重算换显存,ZeRO 把优化器状态分散到多张卡或搬到 CPU,8-bit Adam 把一阶、二阶矩量化,Adafactor 把二阶矩分解成行和与列和。这些方法各省一部分,代价是时间、通信或稳定性。
另一条路是 LoRA。它把权重写成 ,冻结 ,只训练两个小矩阵 、,梯度和优化器状态都只剩 的大小。
LoRA 在微调上很成功,拿去预训练就吃力了。从零开始时 只是随机初始化,整个模型能学到的变化被锁在 维里;ReLoRA 这类改良,还得先用全秩训练预热一段。作者认为原因有两个,一是最好的权重未必是低秩的,二是重参数化本身也改变了训练动态。举个极端的例子,线性回归 的最优解如果是高秩的,把 限制成低秩,用什么优化器都到不了。
所以作者换了一个问题。权重不必是低秩的,那梯度呢?
解决问题
梯度会变成低秩
作者的理论出发点是一类「可逆网络」,包括线性层(不含偏置)、ReLU、leaky ReLU 这些层,以及它们的串联与相加,残差网络也在内。对这类网络,一个 batch 的权重梯度可以写成
、 是半正定矩阵。Lemma 3.3 证明,如果 、、 在某个时间点之后固定不变,用普通的 SGD 更新, 的 stable rank(,可以理解成「有效的秩」)会以指数速度往下掉,最后只剩下由最小特征子空间决定的那一部分。Corollary 3.4 给了一个更具体的上界。当梯度是 条数据各自的外积相加、输入向量的秩 时,最后的 stable rank 不超过 ;而 个外积相加本身的秩也不超过 ,论文据此说长期来看 stable rank 不超过 。
直觉上,一个线性层的梯度就是「每条数据的反传误差 × 每条数据的输入」的外积加总,本来就只有有限的方向;训练一段时间后,大部分的量还会集中在其中少数几个方向上。
这段理论只覆盖可逆网络、系数矩阵固定与 SGD 更新。Transformer 的部分,作者在附录用另一套框架只证明了前馈层第一个投影的梯度会变成低秩;自注意力和 Adam 都不在证明范围内。
投影到小空间里做 Adam
既然梯度集中在少数方向,就只在那几个方向上记录优化器状态。GaLore(Gradient Low-Rank Projection)的定义是
是任意需要状态的优化器,例如 Adam。实现上只用单边投影。权重是 、 时,每 步对当下的梯度做一次 SVD,取前 个左奇异向量当投影矩阵,
然后每一步:
(论文把 定义成负梯度,所以权重是加上去的。) 是缩放系数,作用类似 LoRA 的 ,但不随 改变。
我们拿 LLaMA 7B 前馈层的一个权重走一遍,形状是 ,论文 7B 实验用 。梯度 是 ;投影矩阵 是 ;投影后的 只有 ,Adam 的 、 也是这个大小。原本 Adam 要存 万个数,现在是 、 共 2,254 万,加上 的 419 万,约 2,674 万,剩三成左右。更新本身还是一个完整的 矩阵,权重保持全秩。
整体来看,GaLore 对一个 权重要存 个数,LoRA 则是 (原权重加两个 adapter,再加上 adapter 的一阶、二阶矩)。
和 LoRA 的差别还有一个。 取满秩时,,搭配单纯的 SGD,GaLore 的轨迹和原本的训练一模一样;LoRA 即使 是满秩,同时优化 和 也是另一条轨迹。
作者也证明了固定投影下的收敛(Theorem 3.8)。条件是 ,也就是不带状态的 SGD,并要求投影后子问题的最小特征值大于某个由连续性常数决定的阈值。定理建议把投影对准最大的特征子空间,这正是取梯度 SVD 前 个方向的理由。作者也写明,收敛只代表在这个子空间内进展良好,不保证整体表现。
换一个子空间
只在一个固定的子空间里走,权重的变化永远只有 维,又回到 LoRA 的老问题。GaLore 每 步换一次子空间:
每一段 都是低秩的,累加起来就可以是全秩。
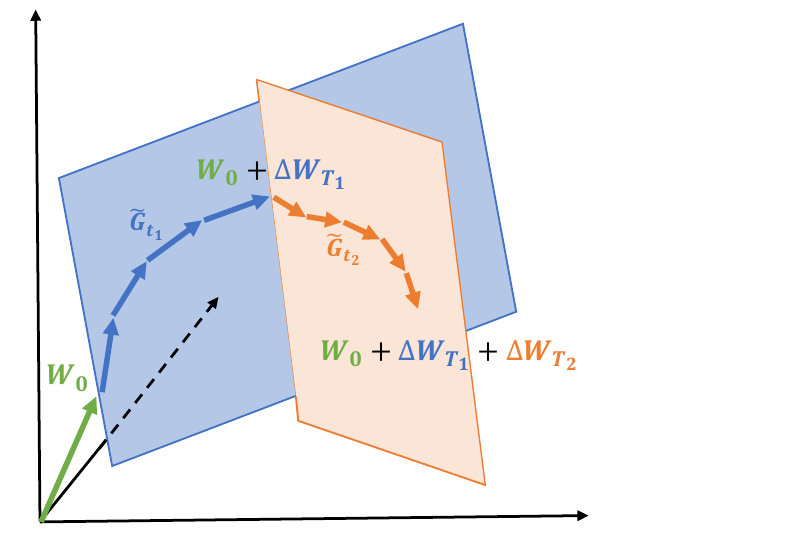
蓝色平面是前 步的子空间,权重在里面走了一段;到了 ,用当下的梯度重算 SVD,换成橙色平面,从刚才的位置继续走。
怎么选?换得太勤,SVD 的开销变大,也破坏定理要求的固定投影,Adam 累积的一阶、二阶矩还会因为基底一直变而失真;换得太少,可能卡在一个已经不重要的子空间里。作者发现 在 50 到 1,000 之间差别不大,预训练一律用 200,并估计 SVD 的总开销在 10% 以内。另外,Algorithm 2 换子空间时, 和 直接沿用,没有重置,也没有转到新的基底上。
再叠两招
GaLore 只压缩优化器状态,作者另外叠了两个现成的技巧。一是把 Adam 换成 8-bit Adam,下文的「8-bit GaLore」指的就是这个组合。二是逐层更新,反向传播算完一层的梯度就立刻更新那一层,不必把整个模型的梯度存到最后,这是 LOMO 系列的做法。
讨论
预训练 60M 到 1B
实验沿用 ReLoRA 的设置,LLaMA 架构(RMSNorm、SwiGLU),在 C4 上训练不重复的数据,序列长度 256,每步 131K 个 token,全程 BF16。每个方法、每个尺寸都从五个学习率里挑最好的;GaLore 则所有尺寸都用学习率 0.01、、,等效学习率 0.0025,比全秩基线通常用的 0.001 以下要大。
| 方法 | 60M | 130M | 350M | 1B |
|---|---|---|---|---|
| 全秩 | 34.06 | 25.08 | 18.80 | 15.56 |
| GaLore | 34.88 | 25.36 | 18.95 | 15.64 |
| LoRA | 34.99 | 33.92 | 25.58 | 19.21 |
| ReLoRA | 37.04 | 29.37 | 29.08 | 18.33 |
| 78.18 | 45.51 | 37.41 | 142.53 |
整理自原论文 Table 2,C4 验证集 perplexity,越低越好;rank 依次为 128、256、256、512(模型维度 512、768、1024、2048)。
GaLore 在四个尺寸都紧贴全秩,1B 只差 0.08;LoRA 和 ReLoRA 随模型变大越拉越远。直接把权重分解成 从头训练最差,1B 时 perplexity 142.53。显存方面,1B 的参数加优化器状态估计是全秩 7.80 GB、GaLore 4.38 GB、LoRA 6.17 GB。
读这张表时要记得两件事。这里的显存是按参数数量估算的 BF16 大小,不含 activation 和梯度。ReLoRA 是拿掉全秩预热后比的,作者说这是为了公平,但它原本的设计就需要那段预热;LoRA 本来也是为微调设计的。
7B 与那张 4090
7B 的实验在 8 个节点、共 64 张 A100 上跑了 15 万步、197 亿个 token。因为算力有限,8-bit GaLore()和 8-bit Adam 各只跑一次,没有调参。
| 方法 | 4 万步 | 8 万步 | 12 万步 | 15 万步 |
|---|---|---|---|---|
| 8-bit GaLore | 17.94 | 15.39 | 14.95 | 14.65 |
| 8-bit Adam | 18.09 | 15.47 | 14.83 | 14.61 |
整理自原论文 Table 3,C4 验证集 perplexity。
前期 GaLore 略好,后期 8-bit Adam 反超,最后差 0.04。
那张 4090 出现在另一组实验里。作者在单一设备上测量实际显存,不开 activation checkpointing、不做 offloading,token batch size 是 256。
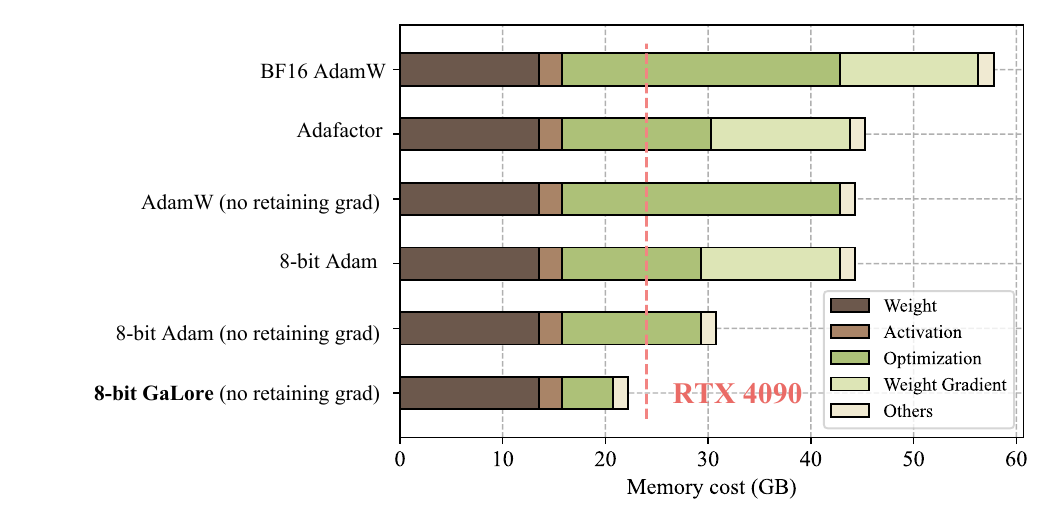
看最下面两条。8-bit Adam 不保留梯度时约 31 GB,换成 8-bit GaLore 后优化器状态那段(深绿色)缩短很多,总共约 22 GB,落在 24 GB 的红色虚线左边。和 8-bit Adam 相比,低秩投影省下 9.6 GB 的优化器状态,逐层更新省下 13.5 GB 的权重梯度;和 BF16 的 AdamW 相比,总共省了 63.3%。
所以「在 4090 上预训练 7B」测的是显存能不能放得下,测量用的 batch 只有 256 个 token(不开 checkpointing 最多约 500),开了 activation checkpointing 也只到 4,096 个;论文里真正跑完的 7B 实验用的是 64 张 A100。作者的设想是用许多张消费级显卡做数据并行,论文没有实际跑过。
速度和超参数
省显存要付出时间。在 LLaMA 1B、token batch 256 的测量里,开逐层更新的 8-bit GaLore 每秒 1,019.63 个 token,8-bit Adam 是 1,205.31,作者称约 17% 的额外开销;关掉逐层更新,GaLore 回到 1,109.38。
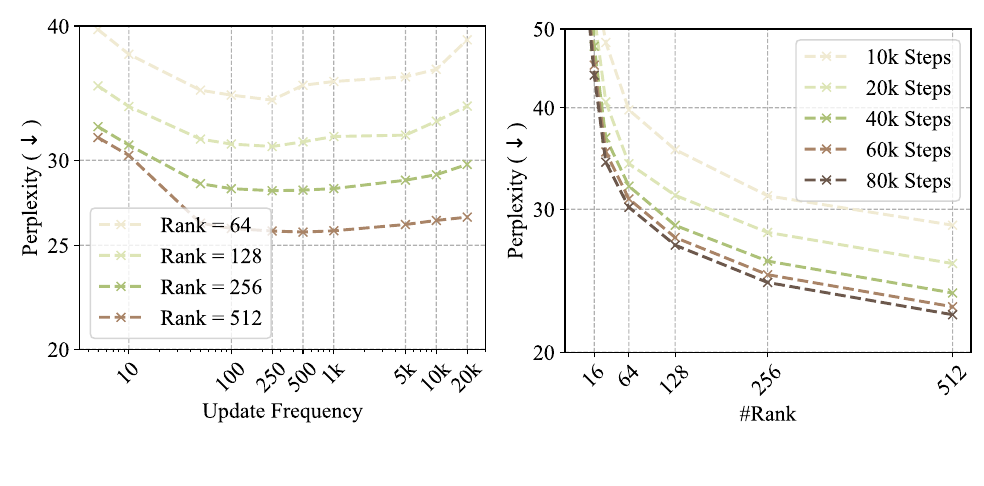
左图是更新频率 。四个 rank 都是 U 形,换得太勤或太少都变差,谷底在每 250 到 500 步换一次附近;rank 越小,越需要常换。右图是 rank,在一定范围内降低 rank 只让收敛慢一些;rank 128 跑 8 万步,比 rank 512 跑 2 万步还好。换句话说,显存不够时可以用时间换。
微调
微调的对照比预训练温和得多。RoBERTa-Base 在 GLUE 上,rank 4 时 GaLore 平均 85.89、LoRA 85.61、全参数 86.28;rank 8 时 85.94 对 85.93,几乎打平。表上的显存 253M 对 257M,算的也是参数加优化器状态。附录里 LLaMA-7B 在 OpenAssistant 对话数据上微调,测试 perplexity GaLore 2.95、LoRA 2.94;拉开比较明显差距的是 BERT-Base 的 SQuAD(F1 88.29 对 86.11)和 Phi-2 的 OpenAssistant 微调(perplexity 3.83 对 4.24)。
另外,GaLore 每一步都更新完整的权重,训练完得到的是一整个新模型;LoRA 则可以只存一个小 adapter,随时挂上或卸下。哪个方便,要看部署的需求。
后来的检验
SVD 的代价。 论文估计 SVD 的开销在 10% 以内,实测的人看法不同。LLaMA-Factory 的作者在 GaLore 发布第二天就做了第三方测试。在 A100 上微调 LLaMA-2 7B、开着 activation checkpointing,16-bit GaLore 不保留梯度只要 18 GB,8-bit AdamW 要 40 GB,一般步骤的吞吐量也不输;但表格底下注明,7B 每做一次 SVD 大约要 10 分钟,没算进去。之后提出 APOLLO 的团队(成员包括 GaLore 的两位共同作者)也报告 LLaMA-7B 一次子空间更新约 10 分钟,吞吐量每 200 步就掉一次。在 Hugging Face 的集成里,逐层更新的模式只能用单张 GPU,不支持 DDP,梯度裁剪和 DeepSpeed 也可能不正常。
收敛性。 He 等人在 2024 年 10 月的论文给了一个明确的反例,证明 GaLore 在标准的随机优化假设下,不一定收敛到 stationary point。原因是 SVD 只挑最大的方向;训练后期真正的梯度变小、噪声还在,前 个奇异向量抓到的可能全是噪声。GaLore 在没有噪声、batch 随步数变大(例如 ),或噪声在各方向上均匀时才有保证。他们提出的 GoLore 改用随机投影,并建议前期用 GaLore、最后一段换成 GoLore。
规模。 2025 年 4 月,GaLore 的两位作者 Jiawei Zhao、Yuandong Tian 与 Meta 的 PyTorch 团队发表了 GaLore 2。他们写明 LLaMA 7B 的每次 SVD 最多要 20 分钟,改用随机化 SVD 后快了 15 倍;也提到 SVD 的正负号不唯一,两次分解出来的投影可能对不上。这次在 32 个节点、256 张 H100 上用 5,000 亿个 token 从零训练 LLaMA 7B,对照组是 8-bit Adam。GaLore 在前 1,500 亿 token 稍微落后,约 2,000 亿时超前,最后两者相当。
结论
权重保持全秩,只把优化器状态放进梯度的低秩子空间,再定期换子空间,这是 GaLore 和 LoRA 最根本的差别。在 1B 以下的预训练,它和全秩 Adam 只差零点几的 perplexity,远好于 LoRA;7B 只跑了一次,最后也和 8-bit Adam 差不多。代价是每隔几百步一次的 SVD,以及一段只在特定条件下成立的理论。
想在单张消费级显卡上做全参数微调,GaLore 值得一试。动手前先测一次 SVD 要花多久,也确认开了逐层更新之后,你原本的多卡设置还能不能用。单纯想省显存做微调,LoRA 或 QLoRA 通常更省事。
那张 4090 后来呢?GaLore 2 的规模验证,用的是 256 张 H100。