原始論文
SOAP: Improving and Stabilizing Shampoo using Adam
- 發表版本
- ICLR 2025會議
- arXiv 首次提交
- arXiv:2409.11321
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizerssoap2024,
  title = {{SOAP: Improving and Stabilizing Shampoo using Adam}},
  author = {Nikhil Vyas and Depen Morwani and Rosie Zhao and Mujin Kwun and Itai Shapira and David Brandfonbrener and Lucas Janson and Sham Kakade},
  year = {2024},
  eprint = {2409.11321},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2409.11321}
}
用 Shampoo 的人都得決定一件事,最貴的那一步要多久做一次?
Shampoo 每一步都會更新兩個統計矩陣 、,但真正拿來乘梯度的是它們的矩陣次方,得做特徵分解或迭代求根。這一步太貴,實作上都是每隔 步才算一次,中間沿用舊的。
Harvard 的 Nikhil Vyas、Depen Morwani 等人把這個 拉開來量。在一個 3.6 億參數的語言模型上, 時 Shampoo 的最終測試損失約 2.824, 變成約 2.868, 約 2.932;同一設定的 AdamW 約 2.943。為了省計算拉長間隔,Shampoo 對 AdamW 的優勢幾乎全部吐回去。
2024 年 8 月,Shampoo 才剛拿下 AlgoPerf 外部調參組的冠軍。這篇論文想讓它便宜一點,也好調一點。
定義問題
Shampoo 替一個 的權重矩陣維護左右兩個預條件:
原版的指數是 ,後來的實作多半改成 。實際能用的 Shampoo(例如 Meta 的 DistributedShampoo)除了學習率、動量之外,還要設定統計量的移動平均係數、矩陣求根用的 、一維與二維參數各自的指數、grafting 用哪個優化器決定步長,以及預條件多久更新一次。
問題有兩個。第一,頻率一拉長就掉效果,因為在兩次特徵分解之間,整個預條件是凍結的,梯度的尺度怎麼變它都不知道。第二,超參數太多。
作者的切入點是先搞懂 Shampoo 在特徵基底裡到底做了什麼。如果能把它拆成「貴的部分」和「便宜的部分」,也許就能讓貴的慢慢算,便宜的每一步都更新。
解決問題
Shampoo 是轉過去的 Adafactor
先把 Shampoo 理想化。用 次方;、 取整個資料集上的期望 、;再乘上一個以 修正的純量。更新就是
把 和 做特徵分解,,,特徵值分別是 與 。代進去:
這行式子可以照三步讀。先把梯度轉到特徵基底,;在這個座標系裡,第 個元素乘上 ;最後轉回原本的座標。
中間那一步是逐元素的縮放,而且縮放係數是「第 列的量」乘「第 行的量」,秩為 1。這正是 Adafactor 的作法。Adafactor 為了省記憶體,不存每個元素的二階動差,只存每一列的總和 和每一行的總和 ,再用 還原。
如果在轉過去的座標裡跑 Adafactor,列總和是多少?令 、 是 、 的第 、 個行向量,
第二個等號用到 是一組正交基底。同理 ,。Adafactor 對 的縮放是 ,和上面的 Shampoo 一模一樣。
這就是論文的 Claim 1, 次方的 Shampoo,等於在 Shampoo 預條件的特徵基底裡跑 Adafactor。 貴的部分是找基底(特徵分解),便宜的部分是在基底裡逐座標縮放。
從 Adafactor 換成 Adam
有了這個視角,Shampoo 的頻率問題就看得出病灶。實務上每 步才重算一次,等於把「基底」和「縮放」一起凍結;可是縮放只是幾個逐元素的移動平均,每一步更新都很便宜。基底可以慢慢換,縮放沒有理由跟著等。
既然要每一步更新縮放,作者乾脆把 Adafactor 換成 Adam,用完整的逐元素二階動差,不做秩 1 分解。演算法(Algorithm 3)如下, 是逐元素乘法:
每 步才更新一次基底,用的是一步冪迭代加 QR 分解:, 是 或 , 是上一次的基底。只有第一次用完整的特徵分解。
有幾個細節值得停下來看。
動量 存在原本的座標裡,每一步再投影過去。因為基底每 步會換,動量如果存在舊座標,換基底那一刻就對不上了。二階動差 則直接活在轉過去的座標裡,換基底時不旋轉;摘要把這個基底形容為「slowly changing」。官方程式在換基底時會依特徵值大小重新排列 的順序,讓同一個方向對到同一格。
一維參數(偏差、LayerNorm 的權重)直接跑 AdamW。第一層 embedding 和最後的輸出層有一維是詞表大小,存一個那麼大的特徵向量矩陣太貴,那一邊的 就固定成單位矩陣。兩邊都是單位矩陣時,SOAP 就退回 Adam,所以論文說 SOAP 是「在旋轉過的空間裡跑 Adam」。
少掉的超參數
SOAP 的名字是 ShampoO with Adam in the Preconditioner's eigenbasis。和 AdamW 相比,它只多一個超參數,就是更新基底的頻率 。和 Shampoo 相比,下面這些都不用了:
- 矩陣次方的指數,因為縮放交給 Adam 的 ;
- 求根時加在特徵值上的 ,改用 Adam 本身的 ;
- grafting,Adam 在旋轉空間裡逐座標決定步長,不必再向另一個優化器借;
- 、 的移動平均係數,直接共用 Adam 的 。
代價
記憶體和 DistributedShampoo 一樣。一個 的層要存 、、、 四個方陣,加上梯度、、,共 ;AdamW 只要 。
Shampoo 每一步是左右各乘一次預條件;SOAP 要先投影過去、再投影回來,多了一輪左右矩陣乘法,所以單步計算量比 Shampoo 略高。換來的是可以把頻率拉長。
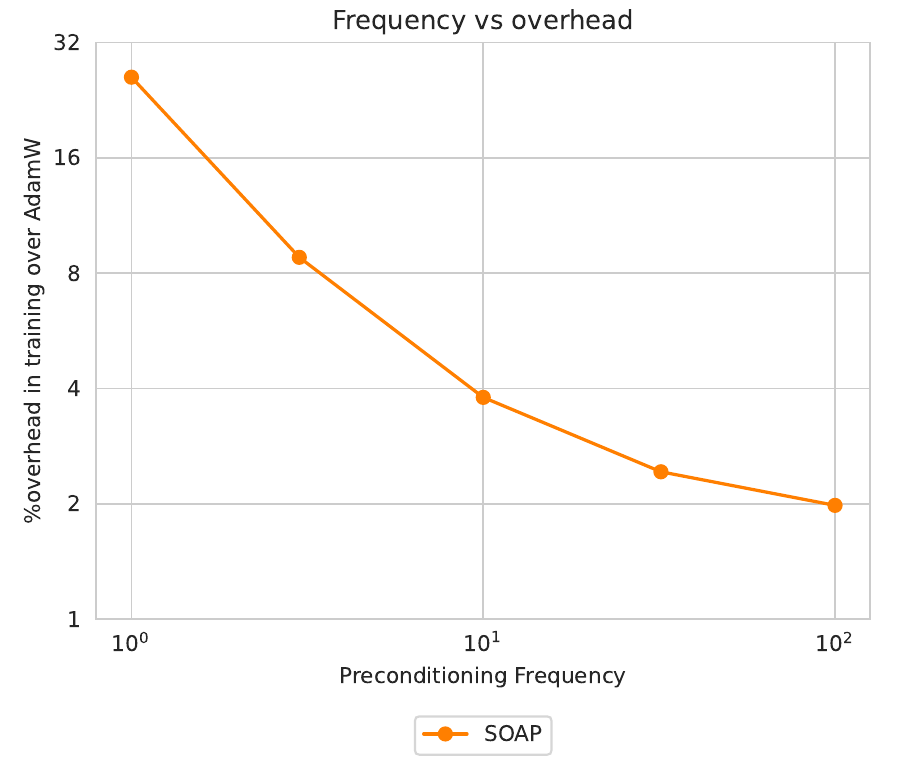
每一步都換基底時,訓練時間多出約 27%; 時約 3.7%, 約 2%。曲線不會降到 0,因為不管換不換基底,每一步都要在 fp32 下更新 、 並做兩次投影。這組數字是在單張 H100 上、用梯度累積湊出大批次量的。
討論
實驗設定
實驗都是語言模型預訓練。資料是 C4,用 T5 的 tokenizer;模型以 OLMo 的程式碼為底,decoder-only,有 2.1 億、3.6 億、6.6 億三個尺寸(不含 embedding),寬度 1024、1024、1408,深度 12、24、24,用了 RoPE 與 QK LayerNorm,bf16 混合精度。序列長 1024,每個批次約 200 萬個 token;訓練量取約 20 倍參數量的 token 數,360m 跑 3,200 步,660m 跑 6,400 步。
三個優化器都先掃學習率。AdamW 在 360m 上另外掃了 、;Shampoo 用 DistributedShampoo,另外掃了 、統計量的移動平均係數與四組指數,這些掃描讓損失的改善都小於 0.004。SOAP 只掃學習率。共用設定是 、decoupled weight decay 、z-loss 、暖身後 cosine 衰減到峰值的 0.1 倍。
「快多少」的算法也要交代。cosine 排程依總步數而定,拿同一次訓練的中途檢查點來比並不公平。作者把 SOAP 另外跑 0.5、0.625、0.75、0.875 倍長度的完整訓練,用 擬合最終損失與步數的關係,再找它在哪個長度追上 AdamW 和 Shampoo 的最終損失。
主結果
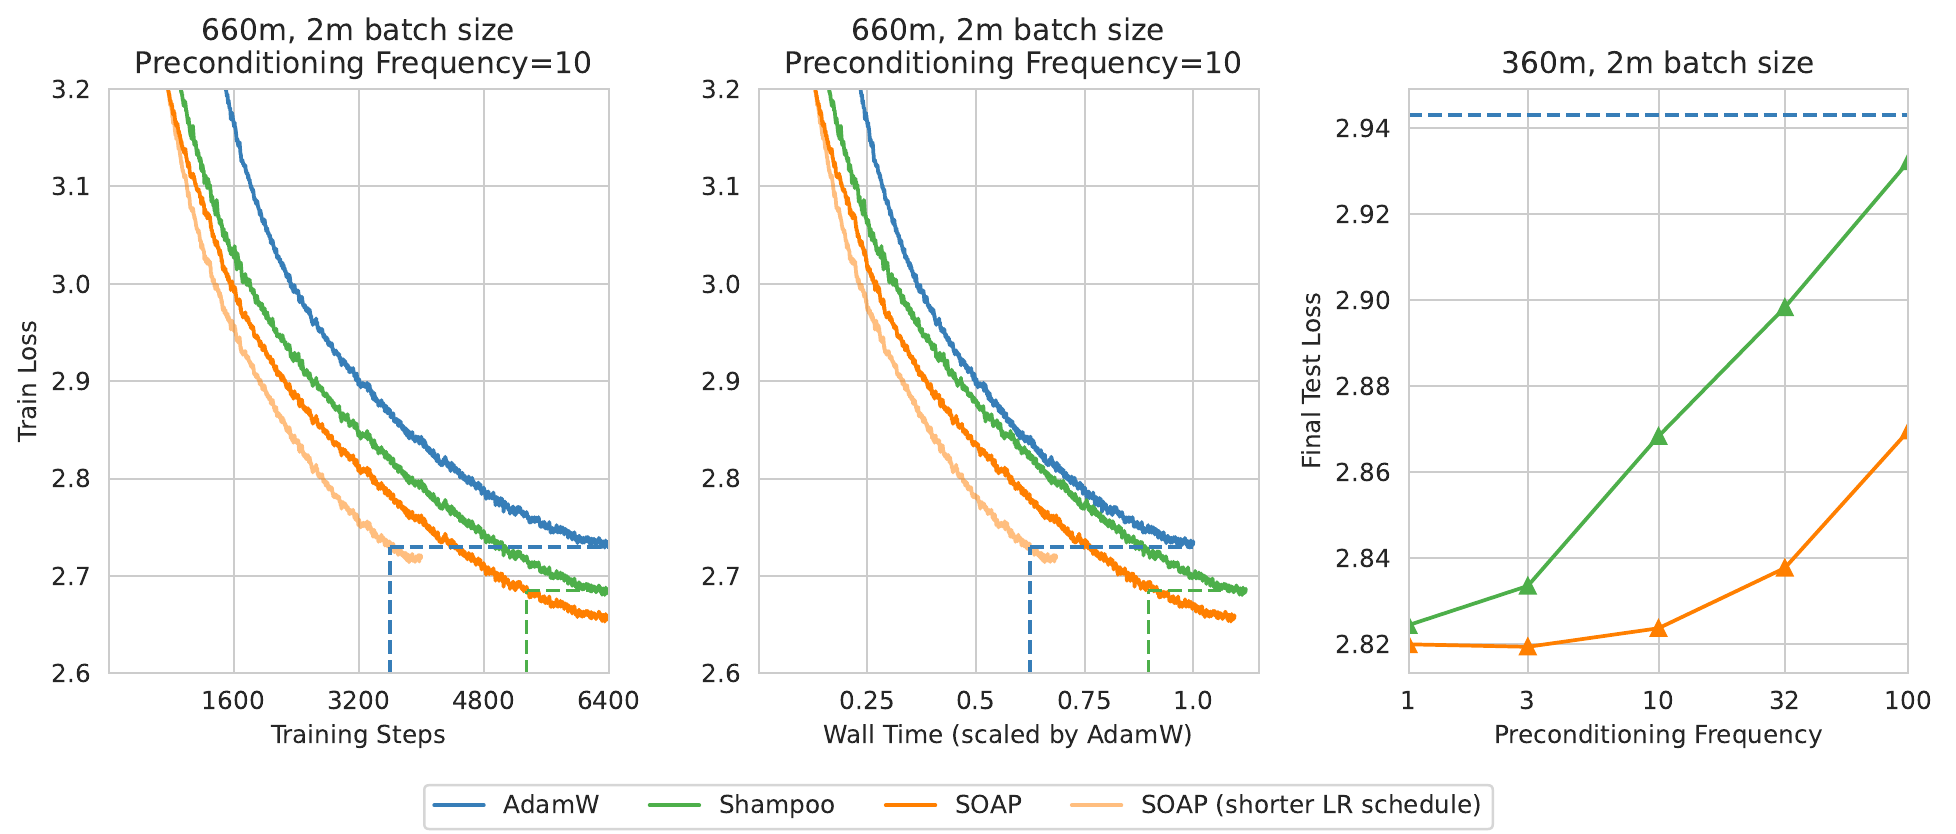
先看左圖。藍、綠、橘三條是同樣跑 6,400 步的 AdamW、Shampoo、SOAP,到終點時 SOAP 最低。淺橘色那條是縮短排程的 SOAP,虛線標出它在約 3,600 步就追上 AdamW 的終點。中圖把橫軸換成牆鐘時間,三條線的間距縮小了一點,這是 SOAP 和 Shampoo 每一步都比 AdamW 貴的結果。
照論文的效率估計,三組設定的數字如下:
| 設定 | 追上 AdamW | 追上 Shampoo |
|---|---|---|
| 360m,200 萬 | 0.50/0.52 | 0.75/0.74 |
| 660m,200 萬 | 0.565/0.62 | 0.80/0.78 |
| 360m,25.6 萬 | 0.72/0.83 | 0.875/0.90 |
整理自原論文 Figure 2 的標示刻度;每格是「步數比/時間比」,第一欄的批次單位是 token。對 Shampoo 的時間比為本文換算(Shampoo 全程分別是 AdamW 的 1.06、1.12、1.11 倍)。
大批次時,SOAP 只要 AdamW 50% 到 57% 的步數、約 52% 到 62% 的時間;對 Shampoo 則省兩成多。這就是摘要裡「比 AdamW 少 40% 以上迭代、35% 以上牆鐘時間,比 Shampoo 少約 20%」的出處。另外把 360m 跑到 100 倍參數量的 token(335 億),SOAP 對 AdamW 的優勢仍在。
頻率的消融
開頭的那組數字來自 Figure 1 的右半,這裡重新放一次。
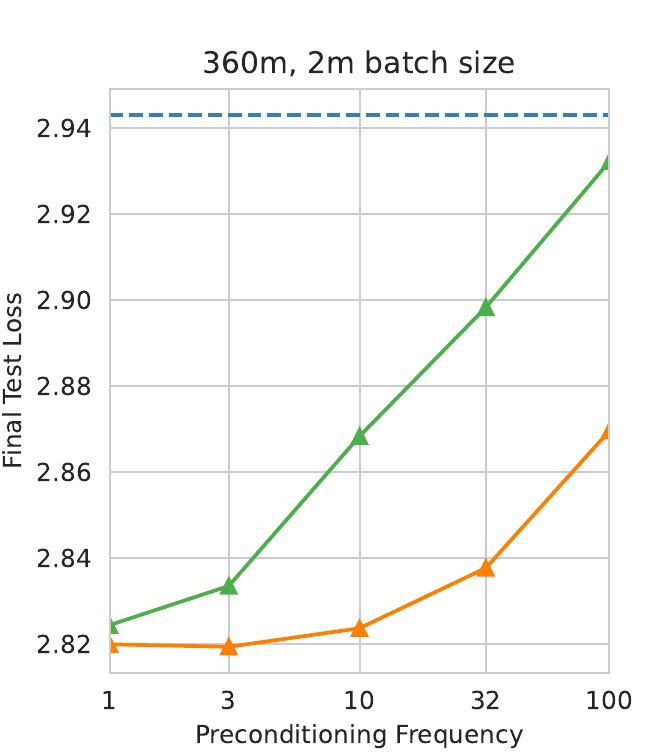
兩條線都在 AdamW 的虛線下方,也就是 從 1 到 100,兩者都贏 AdamW。 時兩者幾乎一樣(2.820 對 2.824),符合「每步都重算時,兩者只差 Adafactor 和 Adam」的預期。之後 Shampoo 一路上升到 2.932,SOAP 在 還是 2.823,到 才升到 2.870。
這組結果支持了作者的解釋。SOAP 在 時是 2.823, 比 高約 0.018,仍遠低於 Shampoo 同頻率的 2.868 與 2.898;真正讓 Shampoo 變差的,是縮放也跟著凍結。
批次大小
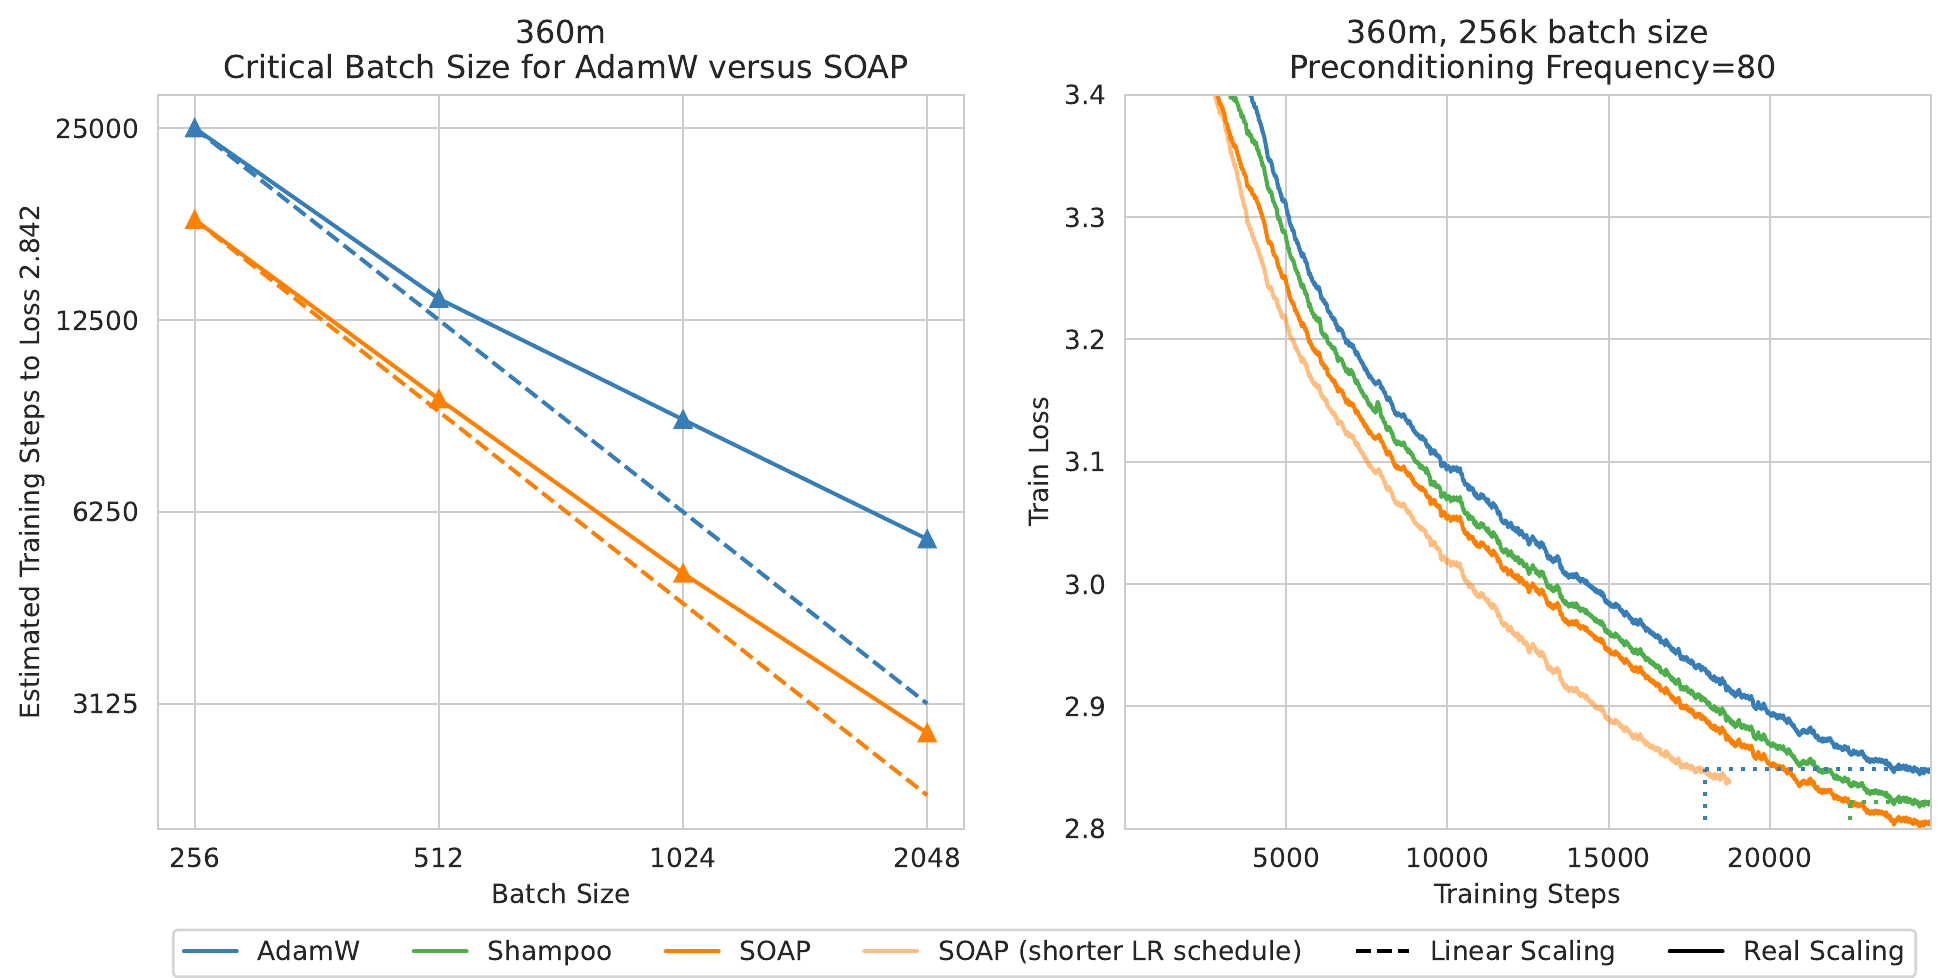
理想情況下,批次大小加倍,達到同一損失的步數就減半,也就是左圖的虛線。實線離虛線越遠,代表多出來的批次越浪費。AdamW 的藍色實線從 512 開始就越偏越遠,到 2048 時需要的步數接近理想值的兩倍;SOAP 的橘色實線比較貼近自己的虛線,所以作者說 SOAP 的臨界批次大小較大。為了公平,批次每縮小 倍,頻率就放大 倍,讓特徵分解的開銷比例不變。
右圖是最小的 25.6 萬批次。SOAP 比 AdamW 少 25% 步數,比 Shampoo 少約 10%。對照上面的表,小批次時的優勢明顯縮水。作者也說這是初步結果,固定「批次乘頻率」未必是最好的取捨;二階方法在小批次時效益變小,和先前的研究一致。官方 README 也建議盡量用大的批次。
省記憶體的變體與 GaLore
SOAP 比 AdamW 多出 的記憶體。論文試了兩種省法。在旋轉後的空間改跑 Adafactor,省下一份 ,損失幾乎沒變;只旋轉較短的那一邊,另一邊用單位矩陣,損失增加得多一些,但仍和 Shampoo 打平或略好。兩招合併後記憶體是 ,在標準 Transformer 上已經比 AdamW 的 小,仍然贏 AdamW。
GaLore 的全秩版本和 SOAP 很像,主要差在三處。GaLore 的投影來自當前梯度的 SVD,SOAP 用 的移動平均;GaLore 把動量存在投影空間、換基底時不轉回,SOAP 存在原空間;GaLore 只投影一邊。在 2.1 億參數的模型上,GaLore 最好的結果是 3.12,贏 AdamW,但輸給 Shampoo 的 3.10,所以作者認為 SOAP 的這幾個改動都有必要。
這個點子其實早有人寫過。Anil 等人在 2020 年 Distributed Shampoo 論文的附錄 B,描述了一個在二維層上與 SOAP 本質等價的演算法,沒有附實驗,只說未發表的實驗沒看到改善。SOAP 的作者在相關研究裡老實交代了這件事,並推測差異來自實作細節。
限制
論文自己列的限制很清楚。模型最大 6.6 億參數,比當時的大模型小兩個數量級;作者假設結論能推廣到更大規模,但「remains to be validated」。只測了語言模型。吞吐量在單張 GPU 上量,分散式實作的比較留給未來。、 的運算都在 fp32,而 PyTorch 的 QR 不支援更低的精度,開銷的下限暫時壓不下去。
一年後的獨立檢驗
2025 年,Stanford 的 Wen、Hall、Ma、Liang 發表〈Fantastic Pretraining Optimizers and Where to Find Them〉,把 AdamW 和十個新優化器放在 1.3 億到 12 億參數、1 到 8 倍 Chinchilla 資料量下,每個都仔細調參後比較。
他們在 3 億與 5.2 億參數的模型上,量到 SOAP 比調好的 AdamW 快 1.2 到 1.3 倍;到 12 億參數時,SOAP 和 Muon 都只剩約 1.1 倍。另一個發現是資料量對模型的比例拉到 8 倍以上時,SOAP 和 Kron 會超過在少資料時最強的 Muon。他們的 SOAP 實作另外做了權重分塊,12 億參數時動量用 bf16,和原版略有不同。
結論
SOAP 從一個等價關係出發, 次方的 Shampoo 就是在它的特徵基底裡跑 Adafactor。把貴的基底和便宜的縮放拆開以後,基底可以每 10 步甚至更久才更新,縮放每一步照 Adam 的方式更新;超參數也縮到只比 AdamW 多一個頻率。在 3.6 億與 6.6 億參數的語言模型、大批次下,它比 AdamW 少約一半步數、少 38% 到 48% 的牆鐘時間。
想試的話,官方的 soap.py 可以直接複製進專案,從 README 的設定開始,、頻率 10,先量清楚每一步比 AdamW 慢多少,再決定頻率要不要拉長。記憶體吃緊時,單邊旋轉和 Adafactor 版本都是論文驗證過的退路。
Fantastic 在正文特別點名,SOAP 是少數替基準獨立掃超參數的論文,報告的提速也最接近他們實測的數字。在優化器論文裡,這樣的評語不常見。