原始论文
Sharpness-Aware Minimization for Efficiently Improving Generalization
- 发表版本
- ICLR 2021会议
- arXiv 首次提交
- arXiv:2010.01412
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizerssam2020,
  title = {{Sharpness-Aware Minimization for Efficiently Improving Generalization}},
  author = {Pierre Foret and Ariel Kleiner and Hossein Mobahi and Behnam Neyshabur},
  year = {2020},
  eprint = {2010.01412},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2010.01412}
}
同一个 ResNet,用 SGD 训练,最后停在一个又尖又窄的洞里;换一种训练方法,停在一个宽宽的碗底。两个点的训练损失都很低,模型的参数也一样多。
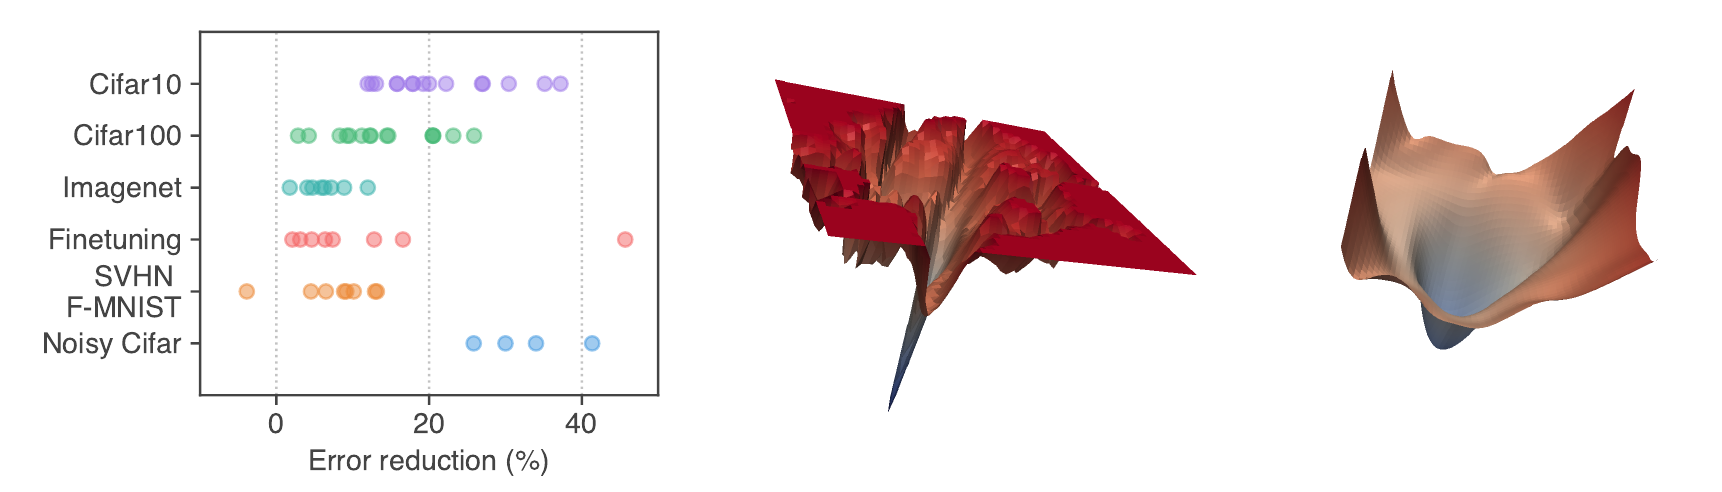
中间和右边这两张地形图,是 Google Research 的 Pierre Foret、Ariel Kleiner、Hossein Mobahi 与 Alphabet 旗下 Blueshift 的 Behnam Neyshabur 放在论文第一页的画面(用的是去掉残差连接的 ResNet-56)。左图是他们的战绩。几十组设置里,换成 SAM 后错误率几乎都下降了,降幅从几个百分点到四成以上都有。
「平坦的最小值泛化更好」这个说法很老,至少能追溯到 1990 年代。这篇的做法是,既然想要平坦,就把平坦直接写进目标函数里,而且要便宜到能拿去训练 ImageNet。
定义问题
现代神经网络的参数多到可以把训练数据整个背下来。训练损失有很多个几乎一样低的最小值,它们在测试集上的表现却差很多,选中哪一个,很大程度上取决于优化器和它的设置。
尖锐度(sharpness)和泛化的关系已经有很多研究。Keskar 等人观察到大批量训练容易停在尖的最小值、泛化较差;Jiang 等人在 2019 年比较了 40 种复杂度度量,以尖锐度为基础的度量和泛化差距的相关性最高。
问题在于,过去提出的尖锐度度量大多很难算,更难微分。Entropy-SGD 改为正则化局部熵,SWA 把训练末段的权重平均起来,可以落到较平坦的位置,但它没有直接最小化尖锐度。作者要的是一个可以直接优化尖锐度、又能扩展到大模型的流程。
解决问题
从泛化界到 min-max
起点是一个 PAC-Bayes 泛化界(Theorem 1 的非正式版本)。对任意 ,以高概率有
是总体损失, 是训练损失, 是一个递增函数。把右边拆开:
中括号衡量的是「从 出发,在半径 的球里,损失最多能升高多少」,就是尖锐度。作者把 换成一般的 L2 正则 ,得到 SAM 的目标:
不再找「本身损失低」的点,改找「整个邻域的损失都低」的点。
一阶近似:
内层的最大化没办法精确求解。作者对 在 处做一阶泰勒展开:
在范数球里让内积最大,答案是经典的对偶范数问题。取 时,解就是把梯度缩放到长度 :
也就是沿着梯度方向往「上坡」走 那么远。附录里也试了 (),效果不如 ;随机方向、同样长度的扰动也不如沿梯度的扰动。
接着要算 的梯度。 本身是 的函数,链式法则会带出一项 ,里面藏着 Hessian:
第二项可以用 Hessian-vector product 算,作者为了省计算直接丢掉,最后的梯度是
到扰动后的点 去取梯度,再拿这个梯度更新原本的 。
丢掉二阶项是一种近似,作者在附录做了对照。训练前半段,有没有二阶项的两种更新方向几乎一样,余弦相似度接近 1;接近收敛时才分开,而且不含二阶项的版本测试错误反而较低,作者坦言「quite unclear」。他们也试过内层多走几步投影梯度上升,把最坏点找得更准,CIFAR-10 的测试错误在 1、2、3、5 步时分别是 2.77%、2.76%、2.73%、2.77%,差不多;CIFAR-100 多步稍好一些(16.72% 对 16.6% 左右)。
两次梯度
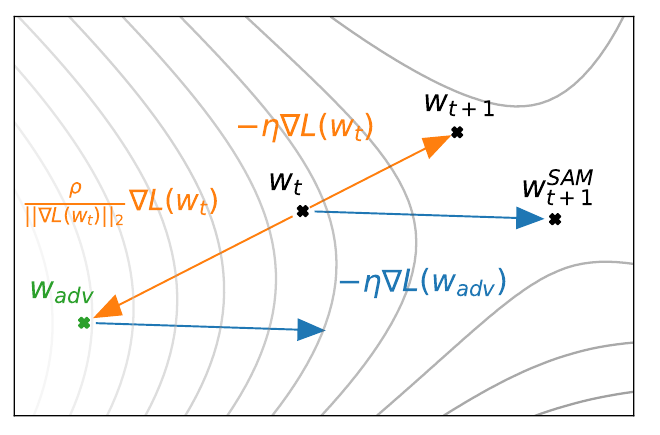
沿着这张图走一遍。从 开始,一般的 SGD 会沿 走到右上的 。SAM 先反过来,沿梯度往上坡走一小段,到达 ,这是半径 内损失最高的点的一阶估计。在 算梯度,得到蓝色箭头 ;把这支箭头搬回 出发,终点才是 SAM 的 。两个终点方向不同,SAM 走的是「最坏情况下也能下降」的方向。
所以每一步要两次前向与反向传播,计算量是原来的两倍。写成 PyTorch,基础优化器是一般的 SGD:
import torch

def sam_step(model, loss_fn, x, y, base_opt, rho=0.05):
    """一次 SAM 更新(p = 2):先走到邻域里最坏的点,再用那里的梯度更新原本的权重"""
    params = [p for p in model.parameters() if p.requires_grad]

    loss_fn(model(x), y).backward()                    # 第 1 次反传:∇L(w)
    with torch.no_grad():
        norm = torch.norm(torch.stack([p.grad.norm() for p in params]))
        eps = [rho * p.grad / (norm + 1e-12) for p in params]   # ε̂ = ρ ∇L / ‖∇L‖₂
        for p, e in zip(params, eps):
            p.add_(e)                                  # w → w + ε̂
    base_opt.zero_grad()

    loss_fn(model(x), y).backward()                    # 第 2 次反传:∇L(w + ε̂)
    with torch.no_grad():
        for p, e in zip(params, eps):
            p.sub_(e)                                  # 回到 w
    base_opt.step()                                    # w ← w − η ∇L(w + ε̂)
    base_opt.zero_grad()
这里的范数是把所有参数的梯度拼成一条向量来算的,整个模型共用一个 。
怎么选
是 SAM 唯一新增的超参数。作者在 里用 10% 的训练数据当验证集来挑选,CIFAR 上挑出来的值在 0.02 到 0.2 之间;他们也说 是「solid default」,附录把全部 CIFAR 与微调实验改用 0.05 重跑,结果和调过 的版本大多相同或只差一点,全部仍胜过不用 SAM 的基线。ImageNet 的实验全部用 0.05。
注意 是参数空间里的绝对距离。同一个 0.05,对数值大的权重是小扰动,对数值小的权重是大扰动。这件事后面还会出现。
讨论
比较条件
每个实验都是把原本的训练流程直接换成 SAM。因为 SAM 每步算两次梯度,作者让不用 SAM 的基线跑两倍的 epoch,取标准长度与加倍长度中较好的那个;他们说多数情况下加长没有明显帮助。每组设置跑 5 次,报告平均值与 95% 置信区间。实现用的是 JAX;多卡时,每张卡用分到的子批量各自算 与 SAM 梯度,最后再平均。这个细节后面会变得很重要。
CIFAR
CIFAR 的模型是已经被调得很好的 WideResNet、Shake-Shake 与 PyramidNet,本身就带有各种正则化。挑几行来看:
| 模型与增强 | CIFAR-10 | CIFAR-100 |
|---|---|---|
| WRN-28-10,200 ep,基础 | 2.7/3.5 | 16.5/18.8 |
| WRN-28-10,1800 ep,AA | 1.6/2.2 | 12.8/16.1 |
| PyramidNet,基础 | 2.7/4.0 | 14.6/19.7 |
| PyramidNet+ShakeDrop,AA | 1.4/1.6 | 10.3/10.6 |
整理自原论文 Table 1;每格为「SAM/SGD」的测试错误率(%),AA 是 AutoAugment。
一个单纯的 WideResNet 加上 SAM,CIFAR-10 错误率从 2.2% 降到 1.6%,原本得靠 PyramidNet 加 ShakeDrop 这类复杂组合才做得到。在已经重度正则化的 PyramidNet+ShakeDrop 上,改善就小得多,CIFAR-100 从 10.6% 到 10.3%,但这也是当时不用额外数据的最好成绩。
ImageNet
ResNet-50、101、152,批量 4096,SGD 加动量、cosine 调度、label smoothing,,最多训练 400 个 epoch。
| 模型 | 100 ep | 200 ep | 400 ep |
|---|---|---|---|
| ResNet-50 | 22.5/22.9 | 21.4/22.3 | 20.9/22.3 |
| ResNet-101 | 20.2/21.2 | 19.4/20.9 | 19.0/22.3 |
| ResNet-152 | 19.2/20.4 | 18.5/20.3 | 18.4/20.9 |
整理自原论文 Table 2;每格为「SAM/标准训练」的 top-1 错误率(%)。
横着读这张表。标准训练从 200 到 400 epoch 不进反退,ResNet-101 从 20.9% 退到 22.3%,是典型的过拟合;SAM 一路变好。再按计算量对齐,SAM 跑 200 epoch 的成本约等于标准训练 400 epoch,ResNet-50 是 21.4% 对 22.3%,ResNet-152 是 18.5% 对 20.9%,SAM 仍然赢。换成 100 对 200 epoch,ResNet-50 的 SAM 是 22.5%,略输给标准训练的 22.3%。
微调
从公开的 EfficientNet 检查点微调,EfficientNet-L2 本身已经用 NoisyStudent 在 ImageNet 加 JFT 上训练到 88.2%。加上 SAM 微调后,ImageNet 的 top-1 错误率从 11.8% 降到 11.39%,CIFAR-100 从 4.07% 到 3.92%,Stanford Cars 从 4.93% 到 4.04%;其中 ImageNet 与 CIFAR-100 都刷新了当时的纪录。微调时冻结了 BN 的统计量,ImageNet 只训练 10 个 epoch。
标签噪声
既然 SAM 找的是「附近都不怕扰动」的参数,作者猜它对训练数据的噪声也比较有抵抗力。实验把 CIFAR-10 训练集的一部分标签随机打乱,测试集保持干净,训练 ResNet-32 共 200 个 epoch:
| 方法 | 20% | 40% | 60% | 80% |
|---|---|---|---|---|
| SGD | 84.8 | 68.8 | 48.2 | 26.2 |
| Mixup | 93.0 | 90.0 | 83.8 | 70.2 |
| SAM | 95.1 | 93.4 | 90.5 | 77.9 |
| Bootstrap+SAM | 95.4 | 94.2 | 91.8 | 79.9 |
| MentorMix | 95.6 | 94.2 | 91.3 | 81.0 |
整理自原论文 Table 4;各列是噪声比例,数值为干净测试集上的准确率(%);MentorMix 为文献数字。
80% 的标签是错的时候,SGD 只剩 26.2%,SAM 还有 77.9%。单纯用 SAM,就胜过所有专门处理噪声标签的方法,只输给 MentorMix;先训练一次、再用模型自己的预测当标签重训(Bootstrap),就和 MentorMix 差不多。 在这组实验取 0.1,80% 噪声时改成 0.05 才收敛得稳。
m-sharpness:每张卡各自扰动
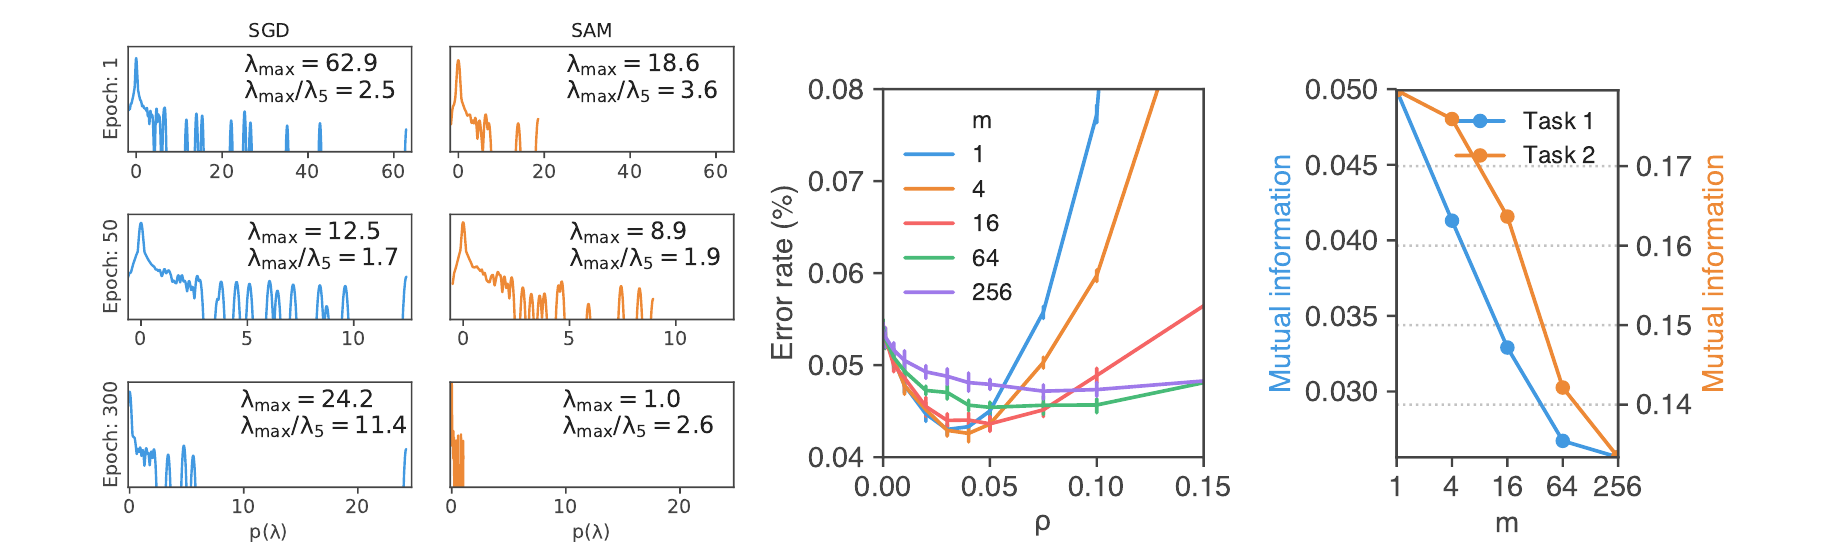
前面提过多卡时每张卡各自算扰动。这等于把目标改成「每 个样本各自做一次最大化,再加总」, 是每张卡分到的样本数;作者把这种尖锐度叫做 m-sharpness。
先看中图。纵轴虽然标着 %,数值其实是比例,0.05 就是 5%。 时错误率约 5.3%。 与 的最低点约 4.3%,但 超过 0.05 之后很快变差; 的紫线最平,最低也只到约 4.7%。小 的效果较好,刚好也和多卡并行的需求相容。右图则显示, 越小,m-sharpness 对实际泛化差距的预测力越强。作者据此认为,m-sharpness 可能比全训练集的尖锐度更能刻画泛化。
左边六张小图确认 SAM 真的停在了曲率较低的地方。这是不含 BN 的 WideResNet-40-10,用 Lanczos 方法估计 Hessian 的特征值分布;训练结束时,SGD 的最大特征值约 24,SAM 约 1.0;描述整体分布的 从 11.4 降到 2.6。
这一节有个实现上的推论。在 PyTorch 的 DistributedDataParallel 里,backward() 会自动把各卡的梯度平均,第一次反传若照常同步, 就变成用整个批量算的, 一下子变大。davda54/sam 的建议是把第一次反传放在 model.no_sync() 里,保持每张卡各自扰动。
后来对 SAM 的理解
尖锐度本身有问题
SAM 发表前三年,Dinh 等人就指出「平坦」这个概念在深度网络上站不太稳。ReLU 满足 ,所以把某一层权重乘以 、下一层除以 ,网络算出来的函数完全一样,但损失地形在参数空间里的形状被拉伸了。他们先在单隐藏层网络上证明、再推广到多层,对任何 Hessian 不为零的最小值,都能找到函数相同、Hessian 谱范数任意大的参数。函数一样,泛化当然一样,尖锐度却可以随便调,所以在原始参数坐标下测的尖锐度,本身没办法解释泛化。
SAM 的 也有同样的问题,它是参数空间里的绝对距离。ASAM(Kwon 等人,2021)把扰动范围改成按权重大小缩放,约束改成 ,其中 ,这样的「adaptive sharpness」在上述缩放下不变。 时扰动变成 ,权重越大的坐标扰动越大; 因此要大约 10 倍(CIFAR-10 用 0.5、CIFAR-100 用 1.0)。ResNet-50 在 ImageNet 上的 top-1 准确率,SGD、SAM、ASAM 分别是 75.79%、76.39%、76.63%。
泛化界解释不了 SAM
Andriushchenko 与 Flammarion(2022)回头检查了 SAM 的理论依据。泛化界推导出来的是对全训练集做最大化的版本,他们称为 n-SAM;论文实际在用的是每个批量各自扰动的 m-SAM。在 CIFAR 上实测,随机扰动几乎没用,n-SAM 也几乎没用,只有低 的版本(例如 128-SAM)明显改善泛化。如果泛化界是原因,n-SAM 应该最好,结果刚好相反。他们的结论是,现有的泛化界解释不了 SAM,而且以 m-sharpness 衡量的「更平坦」也不一定带来更好的泛化。
他们也提出了一些可用的观察。在对角线性网络上,1-SAM 的隐式偏差偏好较稀疏的解,比 n-SAM 和一般训练都强;在 CIFAR 上,只在最后约 10% 的 epoch 从一般训练切换到 SAM,就能明显改善泛化,所以可以拿 SAM 来微调现成的模型。
2023 年 Andriushchenko 等人把范围扩展到 ImageNet 上的 Transformer、CLIP 微调和 BERT。结果是尖锐度(包括 adaptive sharpness)和泛化的相关性并不好,反而和学习率之类的训练设置相关;在好几种情况下,越尖的最小值在分布外数据上表现越好。
被用得很多
理论吵归吵,SAM 在实践中被广泛使用。Chen 等人(2022)发现,不用大规模预训练、只用简单数据增强在 ImageNet 上从头训练时,ViT 收敛到的最小值极尖;加上 SAM 后,ViT-B/16 的 top-1 从 74.6% 升到 79.9%,MLP-Mixer-B/16 从 66.4% 升到 77.4%。NFNet 最大的 F6 模型,也是加上 SAM 才拿到 86.5% 的准确率。
结论
SAM 把「整个邻域的损失都要低」写成一个 min-max 目标,用一阶近似把内层最大化变成「沿梯度往上走 」,再在那个点取梯度更新原本的权重。代价是每步两次反向传播。在 CIFAR、ImageNet、微调与噪声标签上,它都普遍胜出;CIFAR 的比较还让基线多跑了一倍的 epoch。
实际要用的话, 是好的起点,预算要按两倍来算;带 BN 的模型记得第二次前向不要更新统计量,多卡时第一次反传别同步,让每张卡各自扰动。预算不够的话,可以只在训练的最后一段、或微调时开 SAM。
至于「平坦才会泛化」这句话,到 2023 年还有论文在反驳;SAM 倒是一直被拿来用。