原始论文
LLaMA: Open and Efficient Foundation Language Models
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2302.13971
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformersllama2023,
  title = {{LLaMA: Open and Efficient Foundation Language Models}},
  author = {Hugo Touvron and Thibaut Lavril and Gautier Izacard and Xavier Martinet and Marie-Anne Lachaux and Timothée Lacroix and Baptiste Rozière and Naman Goyal and Eric Hambro and Faisal Azhar and Aurelien Rodriguez and Armand Joulin and Edouard Grave and Guillaume Lample},
  year = {2023},
  eprint = {2302.13971},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.13971}
}
2023 年 2 月底,ChatGPT 上线还不到三个月,最强的语言模型几乎都关在 API 后面。
GPT-3、Gopher、Chinchilla、PaLM 的权重都没有公开,训练数据也常常只有一行描述,例如「书籍 2TB」或「社交媒体对话」。公开权重的模型不是没有,OPT、GPT-NeoX、BLOOM、GLM 都放出来了,但作者的评价是,没有一个比得上 PaLM-62B 或 Chinchilla。
Meta AI 的 Touvron、Lavril、Izacard、Grave、Lample 等人在这篇论文里发布了 LLaMA,一组 70 亿到 650 亿参数的基础模型。两个主张让它一出来就备受关注。第一,130 亿参数的 LLaMA-13B 在多数评测上胜过 1,750 亿参数的 GPT-3,推理时一张 V100 就跑得动。第二,训练数据全部来自公开数据集,权重也开放给研究社区(说是开放,其实要填申请表;结果一周后,网上就到处都是了)。
定义问题
Chinchilla 在前一年证明了,给定训练算力,最好的结果不是来自最大的模型,而是较小的模型配上更多数据。它的目标是让训练的计算量用得最有效率。
作者指出,这个目标没有考虑推理成本,而模型一旦部署,推理的总成本往往远大于训练。如果要达到某个表现水平,更划算的是推理最快的模型,而不是训练最快的模型。把一个大模型训练到某个水平也许更便宜,但小模型多训练一阵子,最后在推理时会省得多。
作者举了一个对照。按 Chinchilla 的建议,100 亿参数的模型大约该用 2,000 亿个 token 训练;但他们发现,70 亿参数的模型在看过 1 万亿个 token 之后,表现仍在进步。
所以这篇的目标是,在不同的推理预算下,各自训练出表现最好的模型,方法是让它们看比一般多得多的 token。
我们把几个模型的「每个参数看了几个 token」算一下。训练 FLOPs 约为 ,推理每个 token 约 , 是参数量, 是训练 token 数:
models = {               # 参数量, 训练 token 数
    "GPT-3 175B":     (175e9, 300e9),
    "Chinchilla 70B": (70e9, 1.4e12),
    "LLaMA-7B":       (6.7e9, 1.0e12),
    "LLaMA-13B":      (13.0e9, 1.0e12),
    "LLaMA-65B":      (65.2e9, 1.4e12),
}
for name, (n, d) in models.items():
    train = 6 * n * d          # 训练 FLOPs 约 6ND
    infer = 2 * n              # 推理每个 token 约 2N FLOPs
    print(f"{name:15s} token/参数 {d / n:6.1f}  训练 {train:.1e}  推理/token {infer:.1e}")

# GPT-3 175B      token/参数    1.7  训练 3.2e+23  推理/token 3.5e+11
# Chinchilla 70B  token/参数   20.0  训练 5.9e+23  推理/token 1.4e+11
# LLaMA-7B        token/参数  149.3  训练 4.0e+22  推理/token 1.3e+10
# LLaMA-13B       token/参数   76.9  训练 7.8e+22  推理/token 2.6e+10
# LLaMA-65B       token/参数   21.5  训练 5.5e+23  推理/token 1.3e+11
LLaMA-65B 的比例和 Chinchilla 差不多,都是每个参数约 20 个 token。小模型才是这篇的重点,LLaMA-7B 每个参数看了将近 150 个 token,远超 Chinchilla 的「最佳」比例。如果 LLaMA-13B 真的追得上 GPT-3,它的训练算力只有 GPT-3 的四分之一,每个 token 的推理成本更是只有约十三分之一。
解决问题
只用公开数据
| 数据来源 | 采样比例 | 训练 1.4T token 时的 epoch 数 | 磁盘大小 |
|---|---|---|---|
| CommonCrawl | 67.0% | 1.10 | 3.3 TB |
| C4 | 15.0% | 1.06 | 783 GB |
| GitHub | 4.5% | 0.64 | 328 GB |
| Wikipedia | 4.5% | 2.45 | 83 GB |
| Books | 4.5% | 2.23 | 85 GB |
| ArXiv | 2.5% | 1.06 | 92 GB |
| StackExchange | 2.0% | 1.03 | 78 GB |
整理自原论文 Table 1。
每个来源都有自己的处理方式:
- CommonCrawl:2017 到 2020 年的五个快照,用 CCNet 流程按行去重、用 fastText 过滤非英文页面、用 n-gram 语言模型过滤低质量内容。另外训练一个线性分类器,区分「会被维基百科引用的网页」和随机网页,只保留前者。
- C4:作者发现加入以不同方式处理过的 CommonCrawl 有帮助,所以也加入了 T5 的 C4。它的质量过滤主要靠标点、词数、句数这类规则,和 CCNet 不同。
- GitHub:只保留 Apache、BSD、MIT 许可证的项目,按行长与字母数字字符的比例过滤,再做文件级别的完全去重。
- Wikipedia:2022 年 6 到 8 月的版本,涵盖 20 种使用拉丁或西里尔字母的语言。
- 书籍:古登堡计划的公共领域书籍,以及 The Pile 中的 Books3;内容重叠超过 90% 的书只留一本。
- ArXiv:LaTeX 源文件,删掉第一节之前的内容、参考文献与注释,并把作者自定义的宏展开。
- StackExchange:28 个最大站点的问答,答案按分数从高到低排列。
分词用 SentencePiece 的 BPE,数字一律按位拆开,未知的 UTF-8 字符回退到字节表示。总计约 1.4 万亿个 token,多数数据只看一次,维基百科与书籍约看两次。
架构:三个借来的改动
LLaMA 是标准的 Transformer 解码器,加上三个前人提出、已经被大模型用过的改动,论文也在括号里标出了来源:
- Pre-normalization(GPT-3):对每个子层的输入做归一化,而不是对输出,以提升训练稳定性;归一化函数用 RMSNorm。
- SwiGLU(PaLM):前馈层的 ReLU 换成 SwiGLU。
- 旋转位置编码 RoPE(GPT-Neo):去掉绝对位置编码,在每一层加上 RoPE。
SwiGLU 那一项有个细节。论文说前馈层的宽度用 ,不是 PaLM 的 。原因是 SwiGLU 有三个矩阵,标准的前馈层只有两个;宽度乘上三分之二,参数量才和原来差不多。官方代码再把它向上取整到 256 的倍数。以 LLaMA-7B 的 算一次:
d, multiple_of = 4096, 256          # LLaMA-7B 的 d_model

hidden = int(2 * (4 * d) / 3)       # 4d 的三分之二
hidden = multiple_of * ((hidden + multiple_of - 1) // multiple_of)  # 向上取整到 256 的倍数
print(hidden)                       # 11008

relu_ffn = 2 * d * (4 * d)          # 两个矩阵:d→4d、4d→d
swiglu_ffn = 3 * d * hidden         # 三个矩阵:W、V 与输出矩阵
print(f"{relu_ffn / 1e6:.1f}M {swiglu_ffn / 1e6:.1f}M")  # 134.2M 135.3M
每一层的前馈参数几乎一样,换来的是 SwiGLU 的质量提升。
四个尺寸的设置如下,所有模型的批量都是 400 万个 token:
| 参数 | 注意力头数 | 层数 | 学习率 | 训练 token | |
|---|---|---|---|---|---|
| 6.7B | 4,096 | 32 | 32 | 1.0T | |
| 13.0B | 5,120 | 40 | 40 | 1.0T | |
| 32.5B | 6,656 | 52 | 60 | 1.4T | |
| 65.2B | 8,192 | 64 | 80 | 1.4T |
整理自原论文 Table 2。
优化器是 AdamW(、),余弦学习率调度降到最大值的 10%,权重衰减 0.1,梯度裁剪 1.0,预热 2,000 步。
让训练跑得更快
作者用了几项工程优化:
- 因果注意力的高效实现:来自 xformers 库,不存储注意力权重,也不计算被因果掩码挡掉的 key/query 分数。
- 减少反向传播时的重计算:保留计算代价高的激活值,例如线性层的输出;为此手写了 Transformer 层的反向传播,不靠 PyTorch 的自动微分。
- 模型并行与序列并行,并尽量让激活值的计算与 GPU 之间的通信重叠。
训练 65B 时,每张 GPU 每秒约处理 380 个 token。用 2,048 张 80GB 的 A100,看完 1.4 万亿个 token 大约要 21 天。
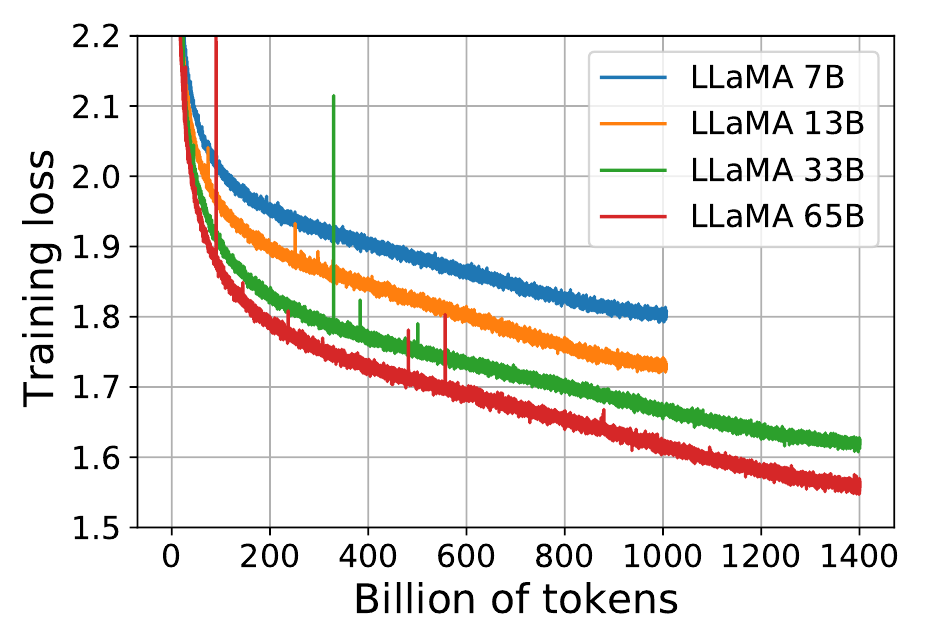
这张图支撑了前面的主张。四条训练损失曲线到最后都还在往下走,7B 在 1 万亿个 token 时也没有变平。
讨论
主要结果
作者比较了 20 个评测,对象包括没公开的 GPT-3、Gopher、Chinchilla、PaLM,以及公开的 OPT、GPT-J、GPT-Neo。数字都取自各自的论文。
常识推理(零样本,8 个评测)。LLaMA-65B 除了 BoolQ 以外都胜过 Chinchilla-70B,除了 BoolQ 和 WinoGrande 以外都胜过 PaLM-540B。LLaMA-13B 在多数评测上胜过 GPT-3。
闭卷问答。Natural Questions 上,65B 的零样本是 23.8,64-shot 是 39.9,PaLM-540B 分别是 21.2 与 39.6。LLaMA-13B 在两个闭卷问答评测上也能和 GPT-3、Chinchilla 相比,作者特别提到它推理时只需要一张 V100。
数学。GSM8K 上,LLaMA-65B 单次作答是 50.9,略低于用 385 亿个 token 的 arXiv 与数学网页微调过的 Minerva-62B(52.4)。改用多数投票,也就是对同一题采样多个答案再投票,LLaMA-65B 是 69.7,胜过 Minerva-62B 的 68.5。LLaMA 没有用任何数学数据微调。
代码。HumanEval 的 pass@1,LLaMA-65B 是 23.7,PaLM-62B 是 15.9,PaLM-540B 是 26.2。13B 以上的 LLaMA 在 HumanEval 和 MBPP 上都胜过 LaMDA-137B。这几个都是通用模型,没有专门针对代码训练或微调。
MMLU 是 LLaMA 明显落后的地方。65B 的 5-shot 平均是 63.4,Chinchilla-70B 是 67.5,PaLM-540B 是 69.3。作者认为原因是书籍与学术论文太少。ArXiv、古登堡与 Books3 加起来只有 177GB,Gopher、Chinchilla、PaLM 用了多达 2TB 的书籍。他们也用这一点解释 Gopher 为什么在 MMLU 上胜过 GPT-3,在其他评测上却差不多。
训练过程中的表现
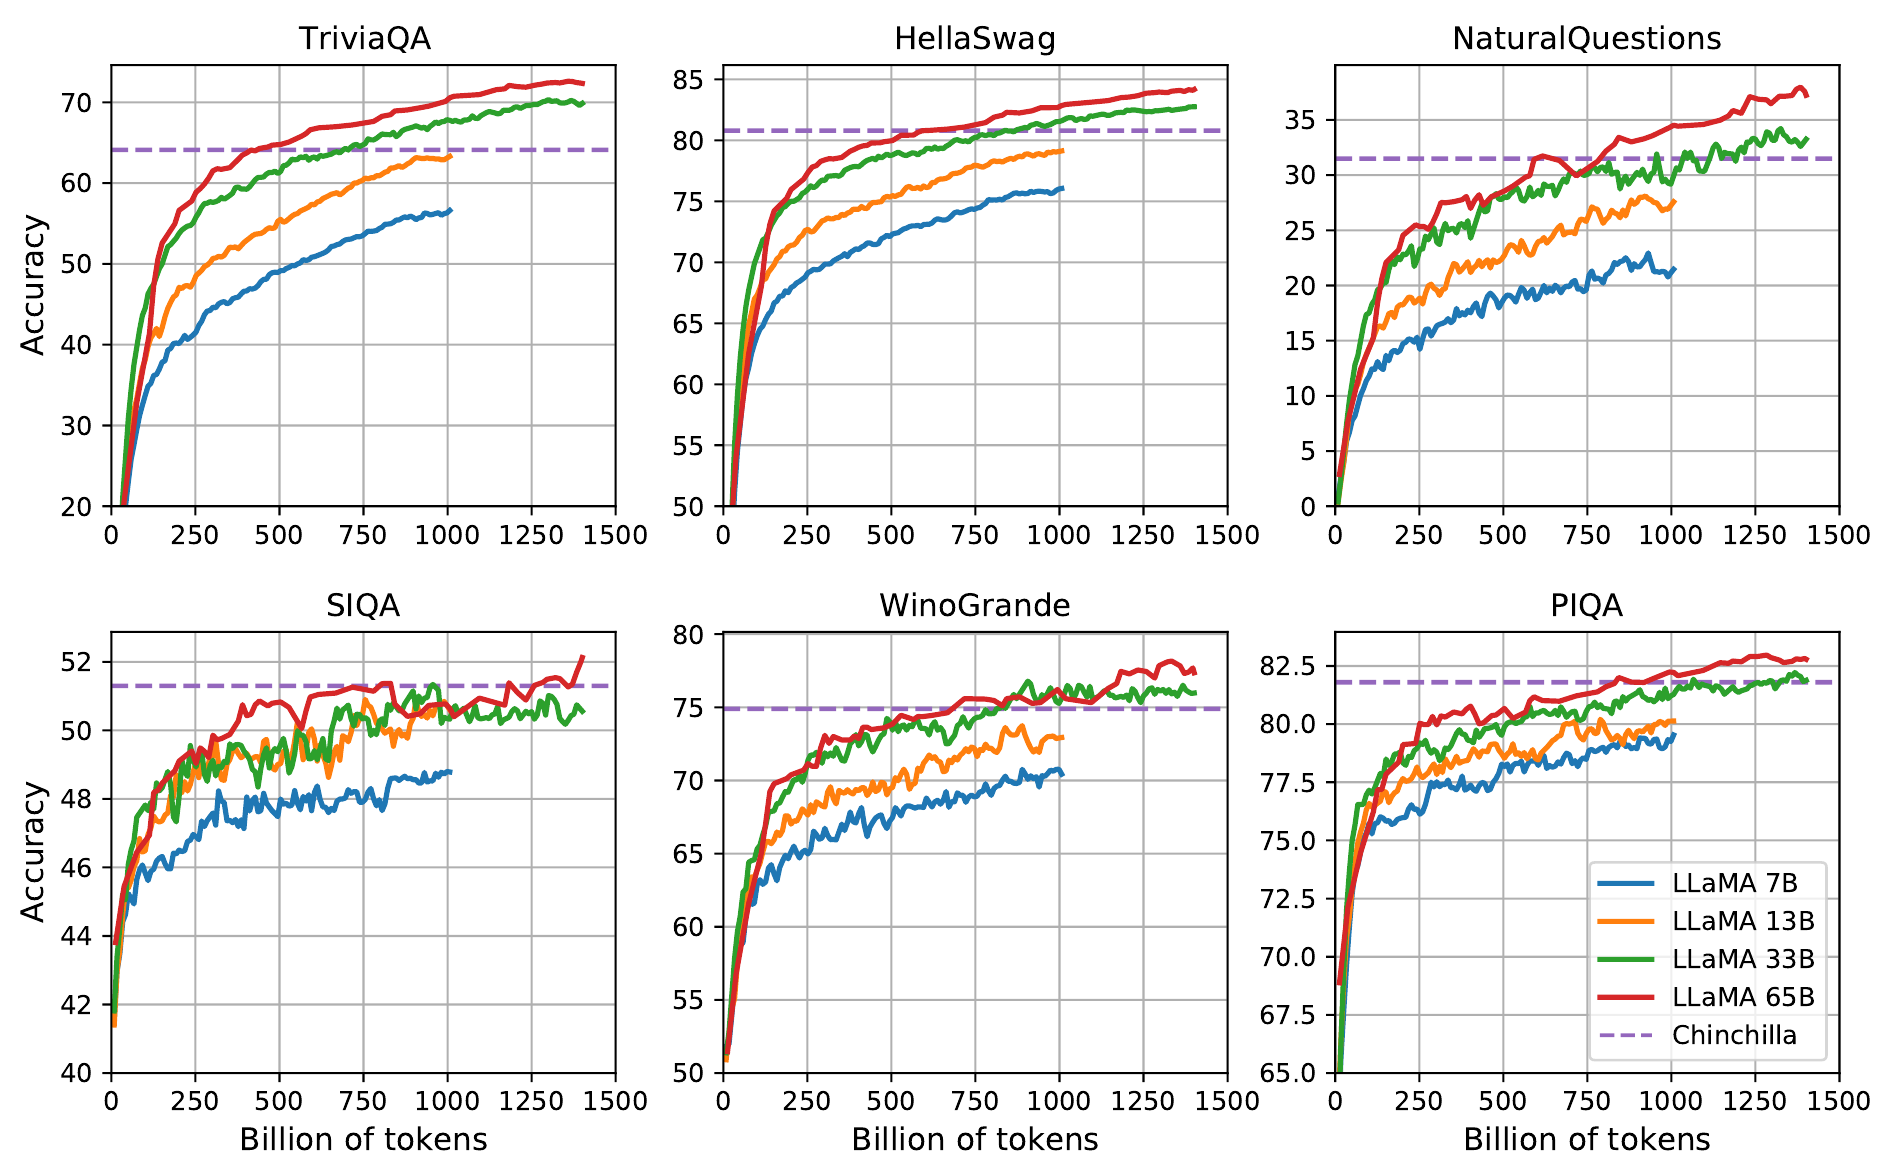
作者在训练过程中持续追踪几个评测。多数评测稳定上升,和训练损失一起改善。两个例外值得注意。SIQA 的分数波动很大,作者认为这个评测可能不可靠;WinoGrande 的分数和困惑度的关联较弱,33B 与 65B 在整个训练过程中几乎一样。
简单的指令微调
作者也做了一个小实验,按 Chung 等人(Flan-PaLM)的流程,对 65B 做少量指令微调,称为 LLaMA-I。MMLU 从 63.4 升到 68.9,胜过 OPT-IML-Max 30B(43.2)与 Flan-PaLM 62B(59.6)等中等规模的指令微调模型,但离当时的最佳,code-davinci-002 的 77.4,还有一段距离。作者强调这不是本文的重点,只做了一次实验。
偏见、毒性与真实性
毒性。在 RealToxicityPrompts 上,毒性随模型变大而上升,在要求「礼貌、尊重、无偏见地补全句子」的提示词下更明显,65B 是 0.141,7B 是 0.081。
刻板印象。在 CrowS-Pairs 上,LLaMA-65B 的平均偏见分数是 66.6,略好于 GPT-3(67.2)与 OPT-175B(69.5),但宗教类别比 OPT 高了约 10 个百分点,其次是年龄与性别。作者推测这些偏见来自 CommonCrawl。
性别与职业。WinoGender 上,模型对「they/them/someone」的代词判断明显比「he」「she」准。在代词和职业的多数性别不一致的「陷阱」题上,错误更多,说明模型会用职业的刻板性别来判断,而不是看句子里的证据。
真实性。TruthfulQA 上,65B 有 57% 的回答是真实的,同时真实且有信息量的是 53%,高于 GPT-3 175B 的 28% 与 25%;作者也说正确率仍然偏低,模型很可能会编出错误的答案。
算力与碳排放
训练 LLaMA-65B 用了约 102 万个 A100 GPU 小时。作者估计整个开发过程约 5 个月、用 2,048 张 A100,总耗电约 2,638 MWh,以美国平均电网碳强度换算约 1,015 吨二氧化碳当量。他们期待的是,开放模型可以让其他人不必再重新训练一次。
发布之后
LLaMA 的权重以非商业许可、申请制的方式提供给研究者。一周后,权重就在 4chan 上以种子文件的形式泄露,Meta 随后对 Hugging Face 等平台上的副本发出下架要求,但文件已经广为流传。
接下来几周的发展,说明了这组权重的影响。2023 年 3 月 13 日,Stanford 的研究者发布了 Alpaca。他们用 OpenAI 的 text-davinci-003 生成 52,000 条指令示范,微调 LLaMA-7B,宣称整个复现成本低于 600 美元;在他们自己的盲测中,Alpaca 对 text-davinci-003 是 90 胜 89 负。这组评测规模不大,但它让「开放权重加上少量指令数据」成了很多人跟着走的路线。
论文透明列出的数据来源也带来了另一面。Books3 收录了大量受版权保护的书籍。2023 年 7 月,包括 Sarah Silverman 在内的几位作家对 Meta 提起版权诉讼,指控 LLaMA 用他们的书训练,Books3 是诉讼的焦点之一。
五个月后,Meta 发布了可商用的 Llama 2;再过一年,Llama 3 把同一个方向推得更远,预训练数据增加到约 15 万亿个 token。
结论
LLaMA 没有发明新组件,它换了一个问题。Chinchilla 问训练算力怎么花最划算,LLaMA 问部署之后怎么最省,答案是让小模型读很多书,13B 读了一万亿个 token,就在多数评测上追过了 GPT-3。
挑模型的时候可以记住这个取舍。训练时多读的 token 只花一次,推理却是每个请求都要把整个模型跑一遍;要长期上线的服务,小一点、读得多一点的模型通常更划算。
顺带一提,到了第二代,名字就从 LLaMA 改成了 Llama,大家总算不用再数大写字母了。