原始论文
Finetuned Language Models Are Zero-Shot Learners
- 发表版本
- ICLR 2022会议
- arXiv 首次提交
- arXiv:2109.01652
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningflan2021,
  title = {{Finetuned Language Models Are Zero-Shot Learners}},
  author = {Jason Wei and Maarten Bosma and Vincent Y. Zhao and Kelvin Guu and Adams Wei Yu and Brian Lester and Nan Du and Andrew M. Dai and Quoc V. Le},
  year = {2021},
  eprint = {2109.01652},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2109.01652}
}
GPT-3 让大家见识到了少样本学习(few-shot learning):在提示里放几个示例,模型就能照着做。
拿掉示例之后就差很多。GPT-3 在阅读理解、问答、自然语言推理(NLI)这类任务上,零样本的成绩明显落后于少样本。作者的推测是,没有示例时,模型面对的提示和预训练数据的格式差得太远。例如 NLI 要判断一句话能否从另一句推出来,这种题目几乎不会以自然的形式出现在网页文本里。
Google 的 Wei、Bosma、Zhao、Guu 等人在 2021 年 9 月提出一个很直接的做法。既然很多 NLP 任务都能用一句话描述,例如「这条影评是正面还是负面?」,那就把现有的几十个数据集都改写成自然语言指令,拿去微调语言模型,再看它能不能做没见过的任务。他们把这个做法叫做指令微调(instruction tuning),微调后的模型叫 FLAN(Finetuned Language Net)。这个名字后来比模型本身还火,Flan-T5、Flan-PaLM 都沿用了它。
定义问题
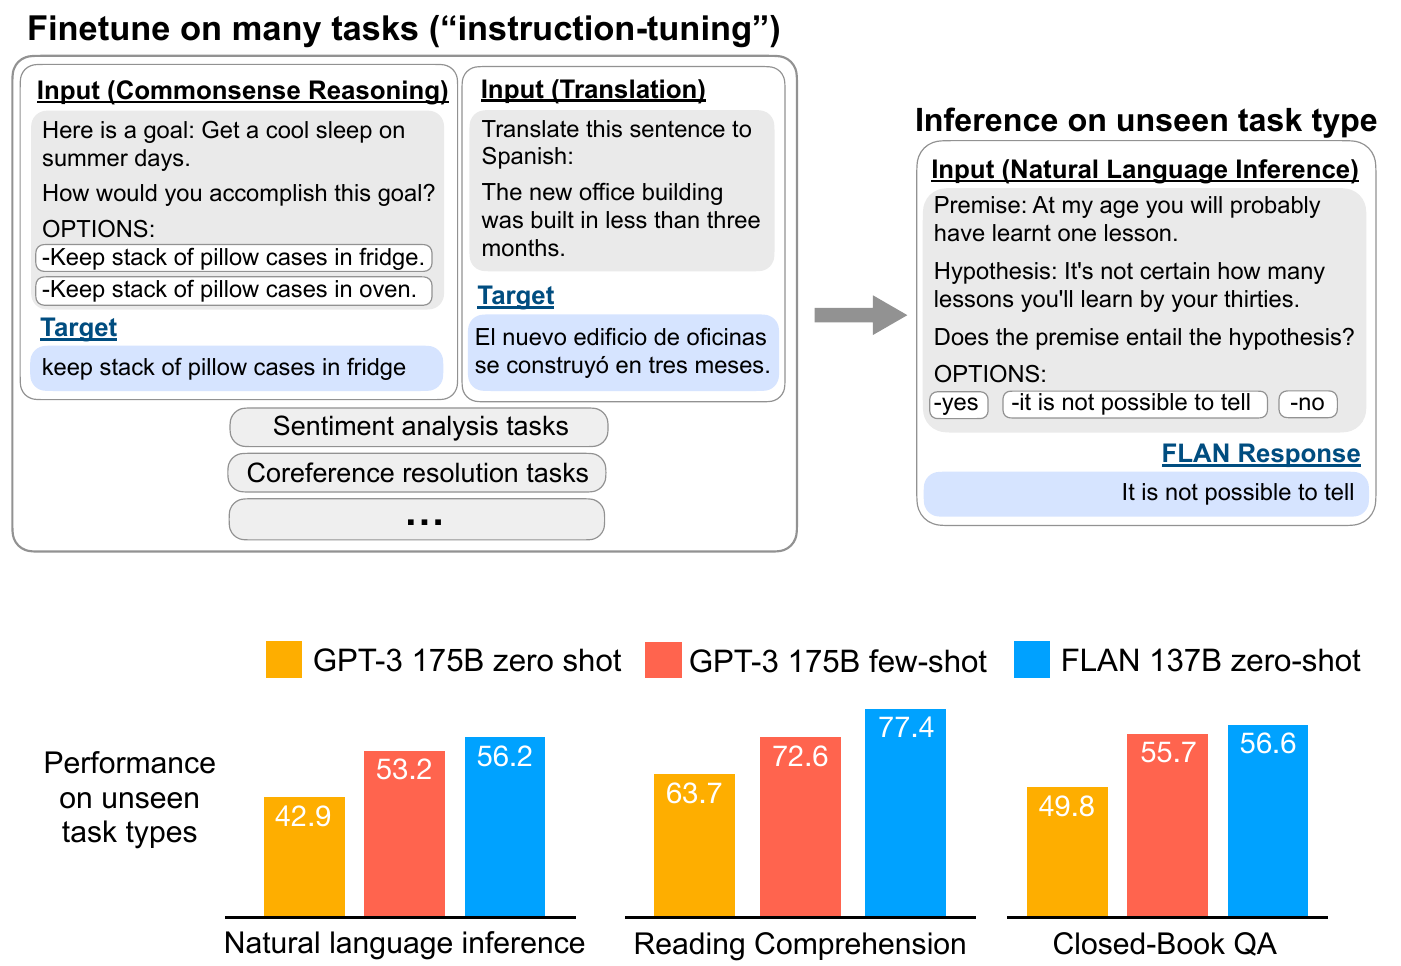
图的上半部分是整个实验的设计。训练时,模型看到常识推理、翻译、情感分析等许多任务,每一题都写成指令;测试时,给它一道自然语言推理题,而它在训练中从没见过任何自然语言推理任务。
下半部分是结果的预告。在三种没见过的题型上,FLAN 137B 的零样本表现超过 GPT-3 175B 的零样本,甚至超过 GPT-3 的少样本。
作者把指令微调放在两种已有做法之间。一种是 BERT、T5 的「预训练后微调」,每个任务都需要大量标注数据,最后得到一个专用模型。另一种是 GPT-3 的「提示」,不微调,靠少样本示例或精心设计的提示词。指令微调用许多任务的监督信号去微调,目标却是让模型在推理阶段,能听懂一个没见过的任务的自然语言描述。
这里最需要说清楚的是「没见过」怎么定义。只要求测试用的数据集没出现在训练里是不够的:如果模型练过 MNLI,再去考 RTE,两者都是 NLI,很难说它在做新任务。
解决问题
把数据集改写成指令
作者从 TensorFlow Datasets 收集了 62 个公开的文本数据集,同时包含理解与生成任务,按任务类型分成 12 个簇(cluster),例如自然语言推理 7 个数据集、阅读理解 5 个、闭卷问答 3 个、翻译 8 个、摘要 11 个。
每个数据集由人工写 10 个不同的指令模板。大部分模板描述原本的任务,但为了增加多样性,每个数据集最多有 3 个模板会「把任务反过来」,例如情感分类数据集也拿来要求模型写一条影评。同一条 NLI 数据,可以套成好几种问法:
模板 1:
<premise>
Based on the paragraph above, can we conclude that <hypothesis>?
<options>

模板 3:
Read the following and determine if the hypothesis can be inferred from the premise:
Premise: <premise>
Hypothesis: <hypothesis>
<options>
训练时,每一条数据随机选一个该数据集的模板套上去。
分类题附上选项
FLAN 是只有解码器的语言模型,生成任务本来就能直接回答。分类题比较麻烦。GPT-3 的做法是「排序分类」,例如只比较「yes」和「no」两个词的概率,取高的那个。作者指出,「yes」可能有很多种说法,概率会被分散掉。
所以 FLAN 在分类题的结尾加上 OPTIONS: 和所有类别,让模型知道该从哪几个答案里选,例如图中 NLI 那道题的「yes / it is not possible to tell / no」。
留出整个题型来测
评估时,作者采用比较保守的定义。数据集 只有在它所属的整个簇都没出现在微调中时,才算未见任务。要测 NLI,就把 NLI 簇的 7 个数据集全部拿掉,用其余的簇微调;性质相近的簇也一并排除,例如测 NLI 时连「复述识别」簇也不用。
这意味着要评估 个簇,就得训练 个不同的 FLAN,每个留出一个簇。成本变高了,但测到的才是「没见过的题型」。
训练设置
基底模型是 LaMDA-PT,一个 1,370 亿参数、只有解码器的语言模型。它在网页(含代码)、对话数据和维基百科上预训练,总共 2.49 万亿个 BPE token,约 10% 不是英文。LaMDA-PT 只做过语言模型预训练,还没经过后来 LaMDA 那种对话微调。
为了平衡各数据集的大小,每个数据集最多取 3 万条,再用 T5 的「按数据量比例混合」(就是 T5 那篇逐一比较过的混合方式),比例上限设为 3,000。举例来说,三个数据集各有 10 万、2 万、1,000 条,截断到 3 万后是 3 万、2 万、1,000;比例上限让前两个都只算 3,000,采样比例就是 3:3:1。大数据集不会把小数据集淹没。
微调 3 万步,每批 8,192 个 token,Adafactor 学习率 ,输入与输出长度分别为 1,024 与 256。在 128 核的 TPUv3 上约需 60 小时,梯度更新步数不到预训练的 2%。
讨论
主要结果
比较对象有三组。最直接的是同一个 LaMDA-PT 不微调,用 GPT-3 论文的提示做零样本和少样本,这组比较直接测出指令微调本身带来了多少提升。另外两组是 GPT-3 175B 与 GLaM 64B/64E,数字取自它们各自的论文。
FLAN 的成绩有两种算法。一种是所有模板的平均,表示随便写一个自然的指令时大概能拿到多少;另一种是用开发集挑出最好的模板,再报告测试集上的成绩,对应 GPT-3 论文里「有开发集可以调提示」的情况。挑出最佳模板时,FLAN 的零样本在 25 个数据集中的 20 个上胜过 GPT-3 的零样本,有 10 个甚至胜过 GPT-3 的少样本。
挑几个数据集来看:
| 数据集 | LaMDA-PT 零样本 | GPT-3 零样本 | GPT-3 少样本 | FLAN 零样本(模板平均) | FLAN 零样本(最佳模板) |
|---|---|---|---|---|---|
| ANLI R1 | 39.6 | 34.6 | 36.8 | 47.7 ± 1.4 | 46.4 |
| RTE | 73.3 | 63.5 | 72.9 | 78.3 ± 7.9 | 84.1 |
| CB | 42.9 | 46.4 | 82.1 | 64.1 ± 14.7 | 83.9 |
| BoolQ | 81.0 | 60.5 | 77.5 | 80.2 ± 3.1 | 82.9 |
| OBQA | 41.8 | 57.6 | 65.4 | 77.4 ± 1.3 | 78.4 |
| ARC-c | 42.0 | 51.4 | 51.5 | 61.7 ± 1.4 | 63.1 |
| HellaSwag | 57.0 | 78.9 | 79.3 | 56.4 ± 0.5 | 56.7 |
| Winogrande | 68.3 | 70.2 | 77.7 | 67.3 ± 2.5 | 71.2 |
整理自原论文附录 Table 2,数值为准确率。
NLI 的进步最明显。作者引用 GPT-3 论文的观察:NLI 的题目很少自然出现在网页文本里,要写成句子接龙会很别扭;FLAN 则能直接问「<前提> 是否意味着 <假设>?」。闭卷问答(ARC)与阅读理解(MultiRC、OBQA)也有大幅提升。
表格也看得出指令的敏感度。CB 的模板平均是 64.1,标准差高达 14.7,换一种问法,分数可能差十几分;最佳模板则达到 83.9。
最后两行是反例。HellaSwag 和 Winogrande 本身就是「把句子补完」的任务,和语言模型的预训练目标几乎一样,指令是多余的。FLAN 在这类常识推理与共指消解任务上,7 个里只有 3 个胜过未微调的 LaMDA-PT。HellaSwag 上 GPT-3 的 78.9 远高于 LaMDA-PT,这个差距来自基底模型,指令微调没有帮上忙。
翻译的情况介于两者之间。FLAN 在全部 6 个翻译方向上都胜过 GPT-3 的零样本,但多数输给 GPT-3 的少样本。翻成英文表现不错,从英文翻出去则较弱,作者认为这和以英文为主的 SentencePiece 词表与预训练数据有关。
消融:簇数、模型大小、指令本身
更多簇,表现更好。 作者固定留出 NLI、闭卷问答与常识推理三个簇,逐个加入其他簇来微调,从 1 个加到 7 个(11 到 39 个数据集)。三个留出簇的平均表现从 49.9 一路升到 63.5,唯一的例外是加入情感分析簇那一步几乎没有帮助。加到 7 个簇时曲线还没有饱和。
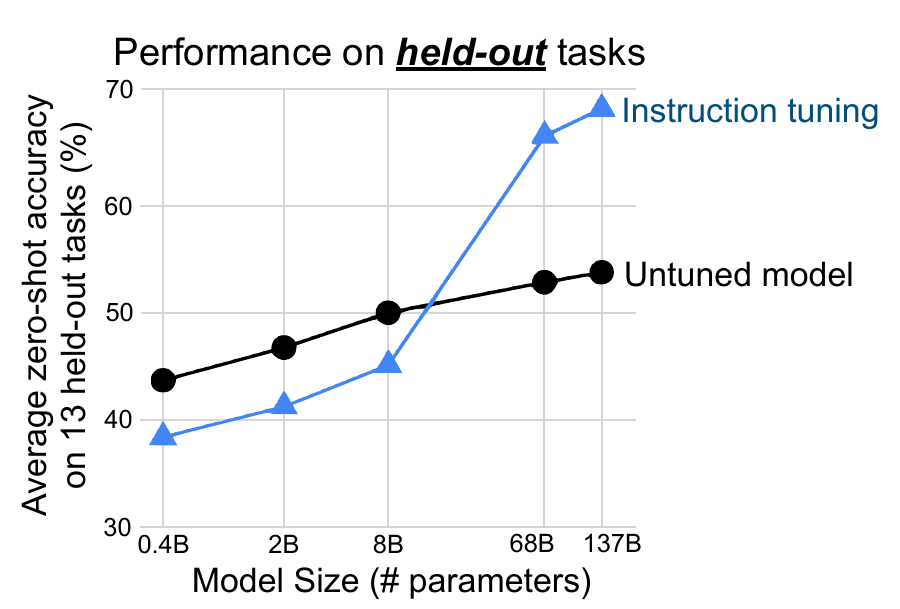
小模型反而变差。 同样的簇划分,作者对 4.22 亿到 1,370 亿参数的五个模型做指令微调。黑线是未微调的模型,蓝线是微调后。68B 和 137B 的提升很大,137B 从约 54 升到约 68;但 8B 以下,指令微调后的成绩反而低于未微调。
作者提出了一个假说。对小模型来说,学会约 40 个微调任务就用光了模型容量,没有余力泛化到新任务;大模型学完这些任务后还有剩余容量,顺便学会了「照指令做事」。论文没有进一步验证这个解释。
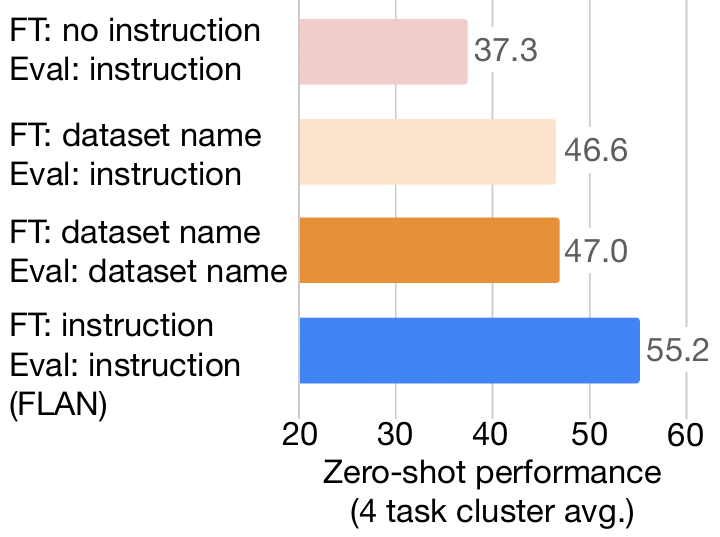
指令本身是关键。 进步会不会只是多任务微调的效果,跟指令无关?作者做了两种没有指令的微调。一种只给输入和输出,例如翻译就是输入「The dog runs.」、输出「Le chien court.」;另一种在输入前加上任务与数据集名称,例如「[Translation: WMT'14 to French] The dog runs.」。
只给输入输出的版本,评估时改用指令,平均只有 37.3。加上数据集名称的版本,用指令或名称评估分别是 46.6 和 47.0。用指令微调、用指令评估的 FLAN 是 55.2。多任务数据确实有帮助,但要泛化到没见过的任务,训练时就得用自然语言描述任务。
和其他方法叠加
指令微调也能和少样本示例一起用。作者在推理阶段把最多 16 个示例套上同样的指令格式,接在题目前面。每个簇的成绩都进一步提升,翻译、结构化数据转文本、闭卷问答这类输出格式比较复杂的任务提升最多;各模板之间的标准差也变小了,对提示词的写法不那么敏感。
另一个实验是 prompt tuning,也就是冻结模型,只训练接在输入前面的一小段连续向量。在 SuperGLUE 上,从 FLAN 出发做 prompt tuning 都比从 LaMDA-PT 出发好;作者提到,尤其是只有 32 条训练数据时,改进常超过 10%。
局限
作者自己列了几项。任务分到哪个簇有一定的主观性。指令都很短,通常只有一句,和众包时给标注者的详细说明差很多。测试题可能出现在预训练的网页数据中,附录的事后分析没发现数据重叠明显影响结果。另外,1,370 亿参数的模型部署成本很高。
后续怎么回应这篇
同一时期,Hugging Face 主导的 BigScience 发表了 T0,用类似的方法在 110 亿参数的 T5 上做提示式多任务训练,也观察到零样本能力的提升。这和 FLAN「8B 以下会变差」的结果并不完全一致;两者的基底模型、任务与模板的数量都不同。
一年后,Google 的 Chung 等人在 Scaling Instruction-Finetuned Language Models 把微调任务扩大到 1,836 个,并加入了思维链数据。在 MMLU、BBH 等评测上,连 8,000 万参数的 Flan-T5-Small 都比原始的 T5-Small 有进步。这组评测和本文「留出整个题型」的设置不同,两者的结论没办法直接对照;它说明的是,小模型能不能从指令微调中受益,和任务的数量与多样性关系很大。
OpenAI 在 InstructGPT 论文里则从另一个角度检验。他们用 FLAN 和 T0 的数据微调 175B 的 GPT-3,再拿到真实的 API 用户提示上比较。这两个模型比原始 GPT-3 好,但输给只用标注者示范做监督微调的模型;InstructGPT 的输出被偏好的比例,对 FLAN 版是 78%,对 T0 版是 79%。他们的解释是,公开 NLP 数据集大多是容易自动评分的分类与问答,在实际使用中只占约 18%,开放式生成与头脑风暴则占约 57%。
结论
把 62 个现成的数据集改写成指令,拿去微调 137B 的模型,它就能在从没练过的题型上胜过 GPT-3 的零样本。功夫都下在实验设计上,整个题型留出来当考题,还特地证明了进步来自指令本身。
自己准备指令数据时,有两件事可以直接照做。任务的种类越多越好;同一个任务也最好准备好几种问法,换个说法,分数就可能差上十几分。
现在说到指令微调,大家想到的是聊天机器人。它最早的样子,是一沓改写过的 NLP 考卷。