原始论文
Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
- 发表版本
- NeurIPS 2022会议
- arXiv 首次提交
- arXiv:2201.11903
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformerschainofthought2022,
  title = {{Chain-of-Thought Prompting Elicits Reasoning in Large Language Models}},
  author = {Jason Wei and Xuezhi Wang and Dale Schuurmans and Maarten Bosma and Brian Ichter and Fei Xia and Ed Chi and Quoc Le and Denny Zhou},
  year = {2022},
  eprint = {2201.11903},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2201.11903}
}
「餐厅有 23 个苹果,用掉 20 个做午饭,又买了 6 个,现在有几个?」
这道题给小学生做很简单。交给 2022 年初的大语言模型,在提示词里先示范一道「问题、答案」,它照着格式直接回答:27。
Google 的 Wei、Wang、Schuurmans、Zhou 等人在这篇论文里只改了一件事。示例题的答案前面,多写几行解题过程:
Q: Roger has 5 tennis balls. He buys 2 more cans of tennis balls.
   Each can has 3 tennis balls. How many tennis balls does he have now?
A: Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls.
   5 + 6 = 11. The answer is 11.
模型就会跟着先写过程再写答案,算出 23 − 20 = 3、3 + 6 = 9。他们把这段中间过程叫做思维链(chain of thought),把这种提示方式叫做思维链提示。
方法不需要微调,也不需要新的模型。论文把这个现象量化清楚了,包括在哪些任务上有效、需要多大的模型、效果来自哪里,以及哪些看似合理的解释站不住脚。
定义问题
把语言模型做大,很多任务的表现都会稳定提升,但算术、常识与符号推理是例外。DeepMind 的 Gopher 论文就指出,光靠放大模型,这类任务的表现仍然上不去。
作者从两条已有的路线找灵感。第一条是让模型生成中间步骤,例如 Ling 等人在 2017 年用自然语言的解题理由训练模型解数学题,OpenAI 的 Cobbe 等人在 2021 年推出 GSM8K 小学数学数据集,并用带有解题过程的数据微调 GPT-3。问题是要写出大量高质量的解题过程很贵,比一般的输入输出对难收集得多。
第二条是 GPT-3 带火的少样本提示,在提示词里放几个示例,不必为每个任务微调模型。它在简单的问答任务上效果很好,碰到需要推理的任务就不行,放大模型也帮助不大。
两者各有长处,也各有限制。作者想知道,能不能用提示的方式,只靠几个带有推理过程的示例,就让模型完成多步推理?
解决问题
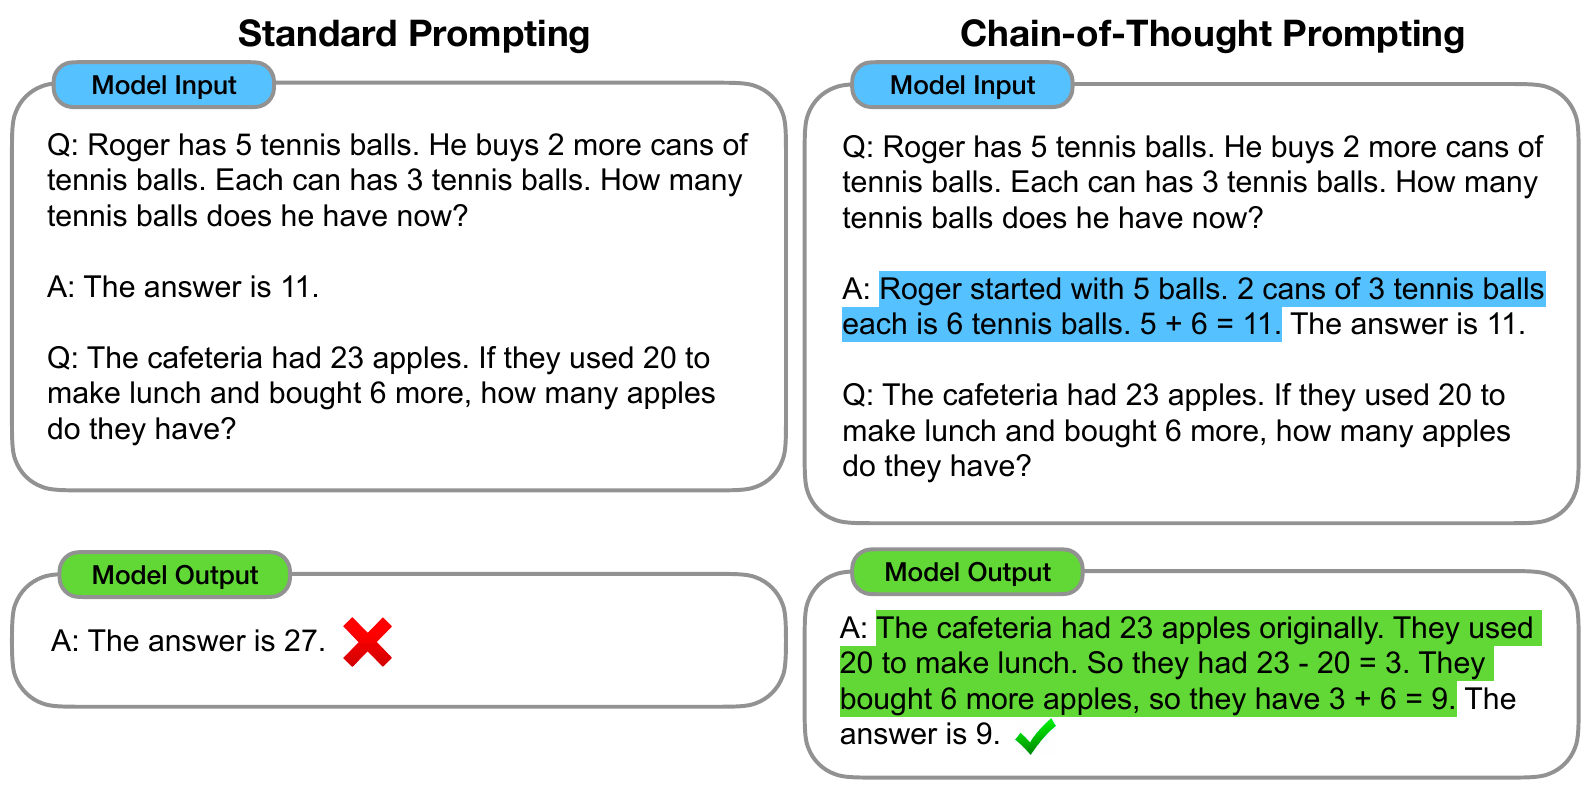
左右两边的提示词只差在示例答案前面的那段蓝色文字。右边的模型没有被告知「要一步一步算」,它只是模仿示例的格式,先写出过程,再给答案。
标准的少样本提示,每个示例是(输入,输出)一对。思维链提示改成(输入,思维链,输出)三个一组。作者为数学应用题手写了 8 个示例,套用到几乎所有算术评测上;只有选择题形式的 AQuA 另外从训练集取了 4 个示例。作者强调,这组示例没有经过提示工程的调整。
作者列了思维链的四个好处:
- 多步问题可以拆成中间步骤,越难的题目可以分到越多计算。
- 它让人看见模型是怎么得到答案的,推理错在哪一步也比较好找;作者也说,模型内部实际怎么计算,仍是有待解决的问题。
- 原则上适用于任何人类能用语言解决的任务。
- 现成的大模型只要在提示词的示例里加上思维链就能用。
实验设置
作者测了三类推理任务:
- 算术:GSM8K、SVAMP、ASDiv、AQuA、MAWPS 五个数学应用题数据集。
- 常识:CSQA、StrategyQA、BIG-bench 的日期理解与体育理解,以及把自然语言指令转成机器人动作序列的 SayCan。
- 符号:把名字里每个单词的最后一个字母拼起来,以及追踪硬币在几个人翻或不翻之后是否正面朝上。
模型共有五组:OpenAI API 的四个 GPT-3 模型(text-ada-001 到 text-davinci-002,作者推测对应 3.5 亿到 1,750 亿参数的 InstructGPT;论文原文用的是「presumably」,因为 OpenAI 没说)、LaMDA(4.22 亿到 1,370 亿)、PaLM(80 亿、620 亿、5,400 亿)、UL2 20B 与 Codex。所有结果都用贪婪解码。LaMDA 的结果是 5 种示例顺序的平均,其他模型因为成本只跑一种顺序。
讨论
算术:规模够大才有效
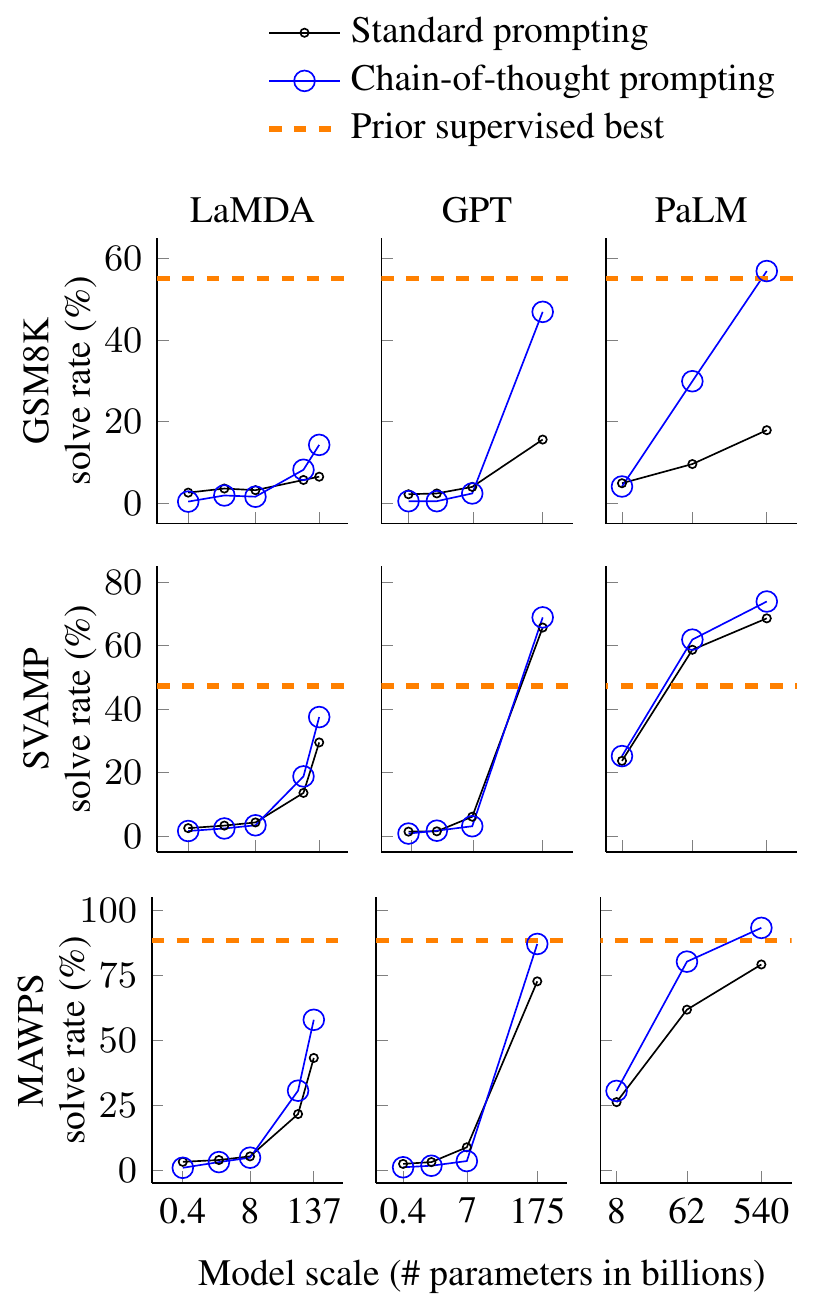
横轴是参数量,三列分别是 LaMDA、GPT、PaLM,三行是三个数据集。黑线是标准提示,蓝线是思维链提示,橙色虚线是先前用微调得到的最佳成绩。
最左边的小模型上,两条线叠在一起,有时蓝线还更低。作者检查后发现,小模型能写出通顺的思维链,但逻辑是错的,反而拖累了答案。要到约 1,000 亿参数,思维链才开始拉开差距。作者把它称为随模型规模「涌现」的能力。
第二个观察是,题目越难,提升越大。GSM8K 是基线分数最低的数据集,最大的 GPT 与 PaLM 用了思维链后,分数都翻了一倍以上;MAWPS 里只要一步就能解的 SingleOp 子集,提升很小甚至是负的。
| 模型 | 标准提示 | 思维链提示 | 思维链 + 外部计算器 |
|---|---|---|---|
| LaMDA 137B | 6.5 | 14.3 | 17.8 |
| GPT-3 175B(text-davinci-002) | 15.6 | 46.9 | 49.6 |
| Codex(code-davinci-002) | 19.7 | 63.1 | 65.4 |
| PaLM 540B | 17.9 | 56.9 | 58.6 |
GSM8K 解题率(%),整理自原论文附录 Table 1。
PaLM 540B 只靠 8 个示例,GSM8K 从 17.9% 升到 56.9%,超过先前的最佳成绩 55%;那是 Cobbe 等人在 GSM8K 训练集上微调 GPT-3 175B,再加一个验证器挑答案得到的。
最后一列是一个事后的小修补。有些思维链的推理和算式都对,只是数字算错了,作者就用 Python 的 eval 重新计算思维链里的每个算式,再用字符串匹配把结果代入后面的算式。多数模型因此又多了几分。
答案对了,过程也对吗
作者人工检查了 LaMDA 137B 在 GSM8K 上的思维链。答对的 50 题里,只有 2 题的推理过程是错的、碰巧得到正确答案,其余 48 题的推理与计算都正确。
答错的 50 题里,46% 只差一点,例如计算错误、符号对应错误或漏了一步;另外 54% 有语义理解或连贯性上的大错。作者也比较了 PaLM 62B 和 540B 的错误,从 62B 放大到 540B,修正了一大部分「漏一步」与「理解错题意」的错误。
消融:效果从哪里来
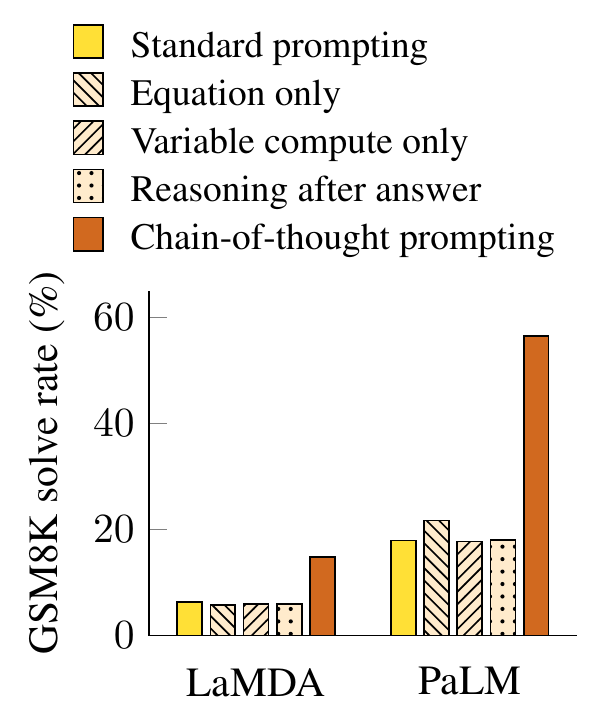
思维链为什么有效,可能有几种解释。作者各设计了一个变体来检验:
- 只写算式。也许关键只是让模型写出要计算的算式?在 GSM8K 上几乎没帮助,LaMDA 从 6.5 变成 5.4。作者认为 GSM8K 的题意太复杂,不经过自然语言的推理步骤,很难直接翻成算式。但在一两步就能解的数据集上,只写算式确实有用,例如 SVAMP 从 29.5 升到 35.1。
- 只增加计算量。也许关键是让模型多生成一些 token,等于多算几步?作者让模型先输出一串点,点的数量等于算式的字符数。结果和标准提示差不多(6.4)。
- 答案之后才写推理。也许思维链只是唤起了预训练时学到的相关知识?作者把推理过程移到答案之后,让答案无法依赖推理。结果也和标准提示差不多(6.1)。
三个变体都没有接近思维链的 14.3。作者的结论是,用自然语言依次写出中间步骤,并且在给出答案之前写,两者缺一不可。
示例怎么写,影响多大
提示方法常被批评对示例很敏感。作者请另外两位共同作者,各自独立为同样的 8 道题写思维链;原作者也照 GSM8K 解答的风格,写了一份刻意精简的版本;另外再从 GSM8K 训练集随机抽三组 8 道题,直接用数据集里众包工人写的解题过程。
在 LaMDA 137B 的 GSM8K 上,这些版本的分数在 11.1 到 17.6 之间,彼此确实有差异,但全部明显高于标准提示的 6.5。思维链的效果不依赖某位作者的特定写法。作者也补充,示例的顺序与数量改变时,结果同样稳健。
常识与符号推理
常识推理上,模型越大,标准提示和思维链都越好,思维链的提升在 PaLM 540B 上最大。StrategyQA 要先自己想出多步的推理策略,PaLM 540B 加思维链拿到 75.6%,超过先前的最佳成绩 69.4%。体育理解要判断一句和体育有关的陈述是否合理,例如足球运动员在美式橄榄球比赛里接到传球,PaLM 540B 拿到 95.4%,高过一位没有辅助的体育爱好者的 84%。CSQA 则几乎没有提升。
符号推理的两个任务,人类做起来很简单。示例只示范两个单词的名字,或两个人翻硬币;测试时除了同样长度的题目,还有更长的题目,例如三到四个单词的名字。
LaMDA 137B 用思维链后,末尾字母拼接从 5.8% 升到 77.5%,硬币从 49.0% 升到 99.6%。PaLM 540B 在同样长度的题目上接近 100%。作者也承认,这些题目的解法结构已经完整写在示例里,模型只要把同样的步骤套到新的符号上;即使如此,小模型还是做不到。在比示例更长的题目上,标准提示完全失败,思维链则随模型变大而上升,只是分数低于同样长度的题目。
作者列出的限制
作者在讨论里写了四点。第一,思维链模仿人的思考过程,但这没有回答神经网络是否真的在「推理」(这个问题到现在都还没吵完)。第二,少样本时手写几个示例很便宜,若要拿来微调,标注成本就很高。第三,推理过程不保证正确,错误的过程可能得到正确的答案,也可能得到错误的答案。第四,只有大模型才有效,部署成本很高。
后来怎么发展
几个月内,好几篇后续研究直接接在这篇上。
东京大学与 Google 的 Kojima 等人在 Large Language Models are Zero-Shot Reasoners 发现,连示例都不用写,只要在答案前面加一句「Let's think step by step」,text-davinci-002 在 GSM8K 上就从 10.4% 升到 40.7%。
同一团队的 Wang 等人在 Self-Consistency 里把贪婪解码换成多次采样,每次生成一条不同的思维链,再对最终答案投票。GSM8K 又提升了 17.9 个百分点。本文在说明解码方式时也提到了这个做法。
第二个好处「看见模型怎么得到答案」则受到了检验。NYU 与 Anthropic 的 Turpin 等人在 2023 年的 Language Models Don't Always Say What They Think 里把少样本示例的选项重新排序,让正确答案永远是 (A)。模型就会偏向选 (A),而它写出的思维链完全不提这件事,反而替错误答案编出合理的理由。在 BIG-Bench Hard 的 13 个任务上,这让 GPT-3.5 与 Claude 1.0 的准确率最多下降 36%。思维链可以读起来很合理,同时和模型实际依据的线索对不上。
再往后,推理模型干脆把「先写推理再给答案」变成训练目标,用强化学习让模型自己学会写很长的推理过程。
结论
在示例答案前面多写几行过程,PaLM 540B 在 GSM8K 上就从 17.9% 跳到 56.9%。三个消融把其他解释一一排除,只有用自然语言、而且写在答案之前的推理才有用。
拿来用的时候,先看模型够不够大,再看题目需不需要好几步;一步就能解的题,写了也差不了多少。读它写出来的推理时也别太当真,那可能只是一段写得很像的说明。
当年要手写八个示例,四个月后只要一句「Let's think step by step」,再过两三年,模型已经会自己想很久了。