原論文
Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters
- 発表先
- ICLR 2025国際会議
- arXiv への初回投稿
- arXiv:2408.03314
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerstesttimecompute2024,
  title = {{Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters}},
  author = {Charlie Snell and Jaehoon Lee and Kelvin Xu and Aviral Kumar},
  year = {2024},
  eprint = {2408.03314},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.03314}
}
人は難しい問題にぶつかると、少し長めに考える。言語モデルも同じように、答える前に少し多めに計算を使って、答えをより良くできないだろうか?
2024 年半ばの時点で、この件をめぐる証拠はばらばらだった。多数決や best-of-N のようなやり方は確かに効く。一方で、数学的推論のような複雑なタスクでは、モデルに自分で反省させて答えを直させても効果はごく限られ、むしろ悪くなることさえある、という研究もあった。推論時に余分に使う計算に見合う価値があるのか、どう使えばよいのかを、体系的に比べた人はいなかった。
UC Berkeley の Snell は Google DeepMind でのインターン中に、Lee、Xu、Kumar と一緒にこの問題に取り組んだ。答えたい問いは二つあった。テスト時計算の予算が決まっているとき、どう使えば最も割に合うのか? そして、モデルを大きくするより、同じ計算を推論に使ったほうが良いのではないか?
問題の定義
提案者と検証者
著者らは、推論時のさまざまなやり方を、調整できる二つの方向にまとめた。
- 提案の分布を変える:モデルにより良い答えを生成させる。一つは STaR や ReSTEM のような手法でモデルを訓練すること、もう一つは推論時にモデルに自分の前の答えを見せ、何度も直させることだ。
- 検証器で選ぶ:たくさんの答えを生成し、検証器で選ぶ。最も基本的なのは best-of-N で、完全な答えを N 個サンプリングし、スコアが最も高いものを選ぶ。さらに進めると、プロセス報酬モデル(PRM)で各ステップを採点し、推論の途中で木探索を行う。
「最も割に合う」とは
著者らは「テスト時計算の最適な配分戦略」を次のように定義した。一つの問題 と計算予算 に対して、正解する確率が最も高くなる設定 を選ぶ。
ここで は、探索を使うかどうか、どの探索を使うか、何回修正するか、いくつ並列にサンプリングするか、といったものだ。
問題ごとに別々に最適化するのは現実的ではないので、著者らは問題の難易度で近似した。難易度はモデル自身を基準に定義する。各問を 2,048 回サンプリングして一回あたりの正解率を求め、すべての問題を簡単なものから難しいものへ五等分する。検証セットで難易度ごとに最も良い戦略を見つけ、それをテスト問題に当てはめる。
難易度をこう定義するには正解を知っている必要があり、著者らはこれを oracle 難易度と呼んでいる。実際にデプロイするときには答えがないので、別に「モデルが予測した難易度」も用意し、同じ 2,048 個の答えに対する検証器の平均スコアで等級を分ける。著者らは、難易度を推定すること自体にかなりの計算がかかり、実験ではその分を含めていないことも認めている。
実験設定
- データ:MATH。Lightman らが切り分けた訓練用 12,000 問とテスト用 500 問を使う。
- モデル:PaLM 2-S*(Codey)。MATH である程度の成績を出しつつ、まだ飽和していないので、研究に向いている。
- 微調整:既製のモデルにプロンプトで答えの修正やステップの検証をさせてもうまくいかないので、どちらの能力も別に微調整した。著者らは、将来のモデルは事前学習の時点でこうした能力を備えているだろうと見込んでいる。
問題を解く
その1:PRM で探索する
PRM の訓練:著者らは当初、Lightman らが公開した PRM800K を使ったが、それで訓練した PRM は抜け穴を突かれやすく、最も単純な best-of-N でさえ、それをだます答えを見つけてしまうことがわかった。PRM800K の解答はすべて GPT-4 が書いたもので、PaLM 2 の出力とかけ離れているからだろうと著者らは推測している。
そこで、人手のアノテーションが要らない Math-Shepherd のやり方に切り替えた。解答の各ステップから先をモデルに何度か最後まで書かせ、正しい答えにたどり着く割合をそのステップのスコアにする。こうして訓練した PRM は、各ステップでの予測が実は「ここから先で正解できる確率」になっている。最終的な答えだけを見る ORM と比べて、PRM はつねに良かった。
スコアの集約:一つの解答の総合スコアとして、Lightman らは各ステップのスコアの積を使ったが、ここでは最後のステップでの PRM の予測を使う。著者らは、これが最も効果的だと見出した。複数の解答の間では「best-of-N 重みづけ」を使う。最終的な答えが同じ解答のスコアを合計し、合計が最も高い答えを選ぶ。
最高スコアの一つだけを見ると、スコアが高めに出た間違った答えにだまされることがある。重みづけは票数とスコアの両方を考慮に入れる。
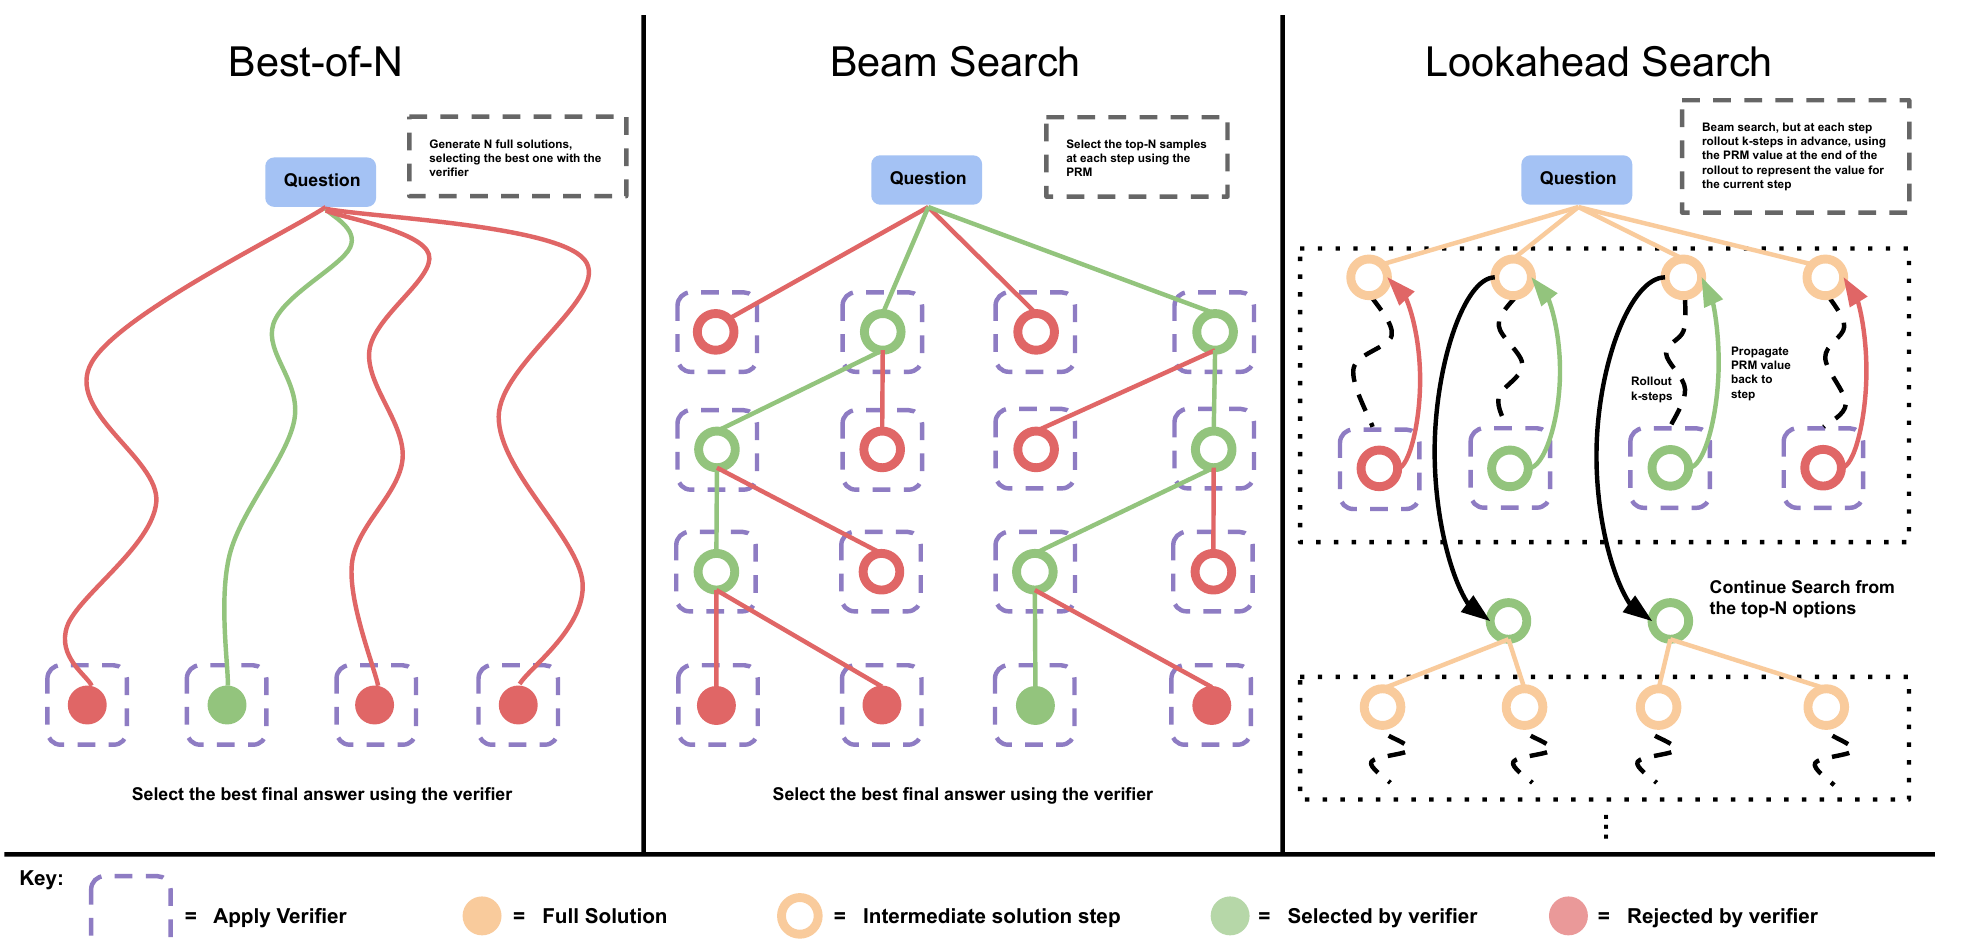
三つの探索方法:
- best-of-N 重みづけ:N 個の解答を独立にサンプリングし、上の重みづけのやり方で選ぶ。
- ビームサーチ:N 個の候補とビーム幅 M を保つ。各ステップでまず N 個の候補ステップを生成して PRM で採点し、最も良い N/M 個を残して、それぞれからさらに M 個を展開する。これを解答が終わるまで繰り返し、最大 40 ラウンドまで行う。
- 先読み探索:ビームサーチと同じだが、各ステップを評価するときに、まず温度 0 で最大 k ステップ先まで展開し、その終点での PRM スコアでこのステップを表す。これで価値の推定はより正確になるが、代わりに計算が増え、コストは 回のサンプリングとして数える。著者らは、これはランダムな探索の要素を取り除いた MCTS とみなせると指摘している。PRM はすでに訓練済みなので、推論時に要るのは探索ではなく活用だからだ。
その2:モデルに自分の答えを直させる
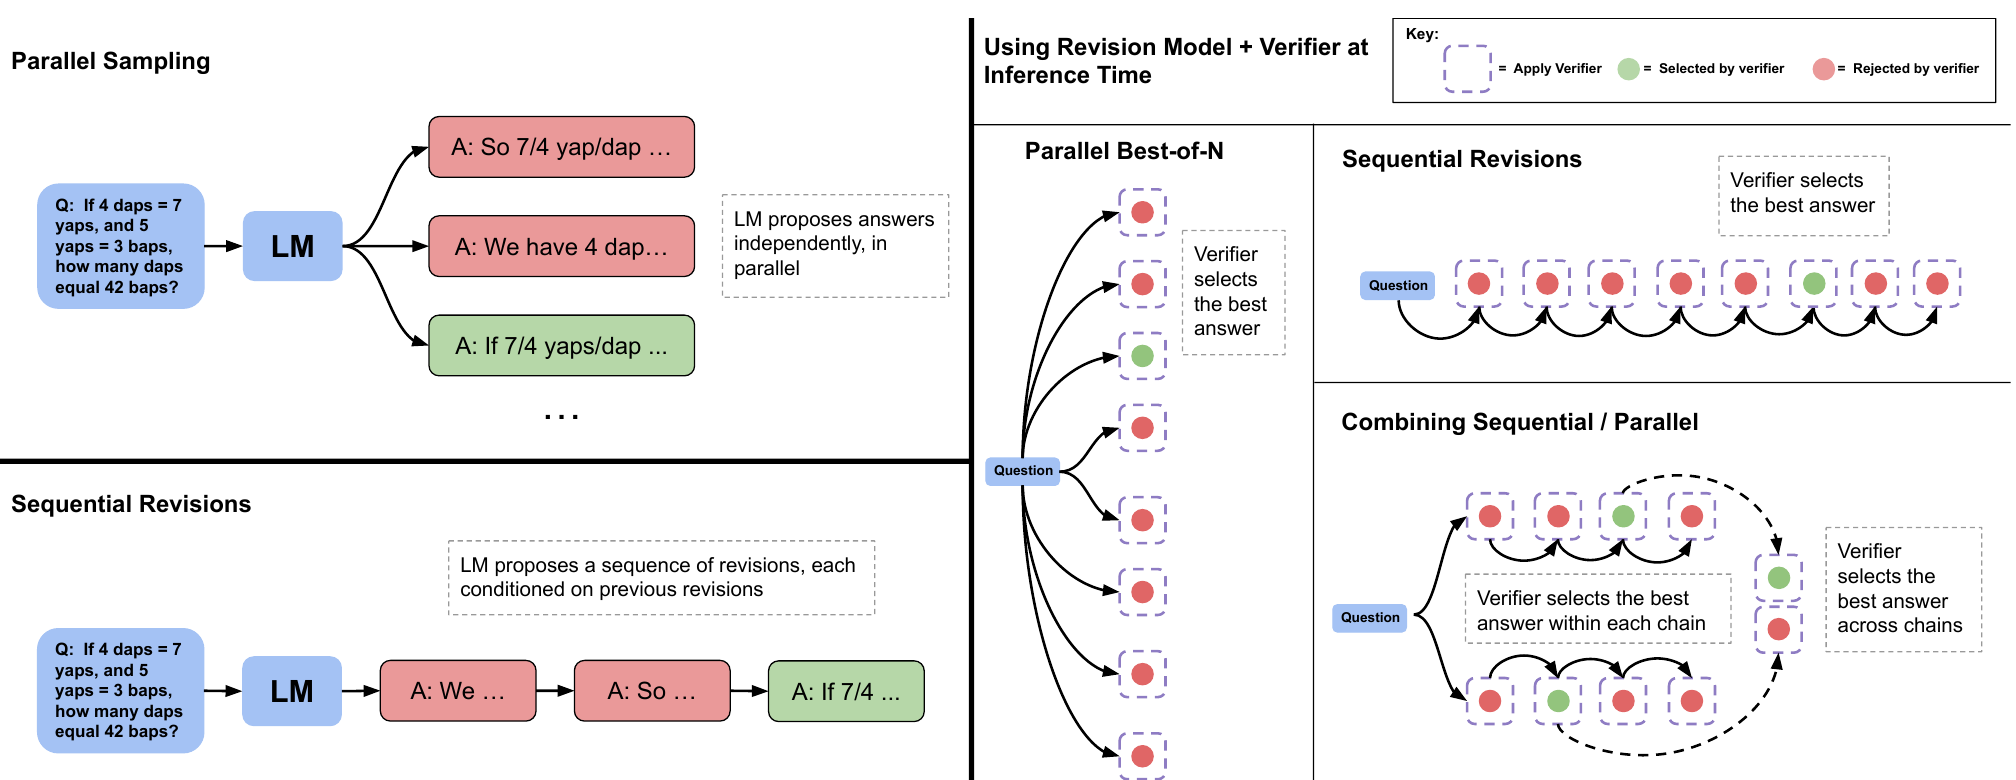
既製のモデルに自分の間違いを直すよう直接頼んでも、推論の問題ではたいてい役に立たない。そこで著者らは、答えの修正に特化したモデルを微調整した。
訓練データ:理想的な訓練データは、間違った答えが何本か続き、その後に正しい答えが来るもので、しかも正しい答えはゼロから書き直したものではなく、それらの間違いを直して得たものであるのが望ましい。多ターンの対話をラウンドごとに生成するのは高すぎるので、著者らは答えを 64 個まとめて並列にサンプリングし、後から多ターンのデータに組み立てた。各正しい答えの前に、0 個から 4 個(ランダムに決める)の間違った答えを置く。間違った答えを選ぶときは文字単位の編集距離を使い、正しい答えに近いものを優先して選ぶ。モデルが学ぶのが書き直しではなく修正になるようにするためだ。
推論:モデルは前に最大 4 個の答えがある場合しか訓練されていないが、推論時には修正をいつまでも続けられ、直近の 4 個だけをコンテキストとして残す。修正の回数が増えるほど一回あたりの正解率は少しずつ上がり、4 回を超えてもまだ伸び続ける。
ただし副作用が一つある。訓練時には、前の答えはすべて間違っている。推論時には、前にすでに正しい答えがあるかもしれないのに、モデルはお構いなしに「修正」してしまう。正しい答えの約 38% が、次の修正で間違いに変わる。だから最後の答えをそのまま採用するわけにはいかず、多数決か検証器で修正の連鎖全体から一つを選ぶ必要がある。
議論
探索:予算が少ないときは効くが、簡単すぎる問題ではかえって害になる
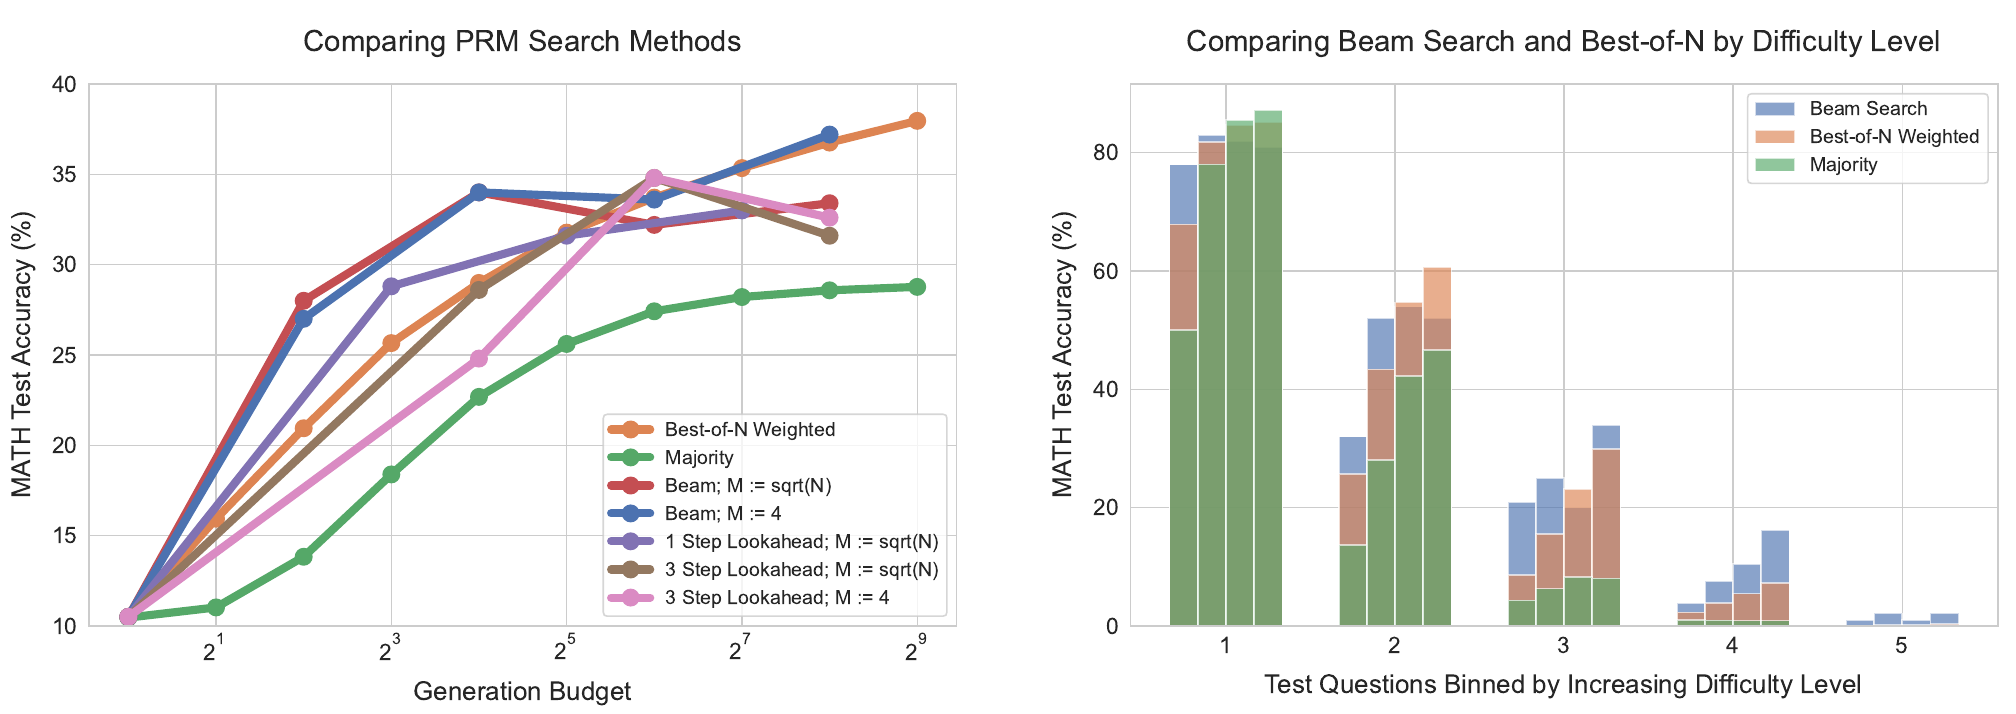
予算が小さいときは、ビームサーチがはっきり best-of-N に勝つ。予算が大きくなると優位は消え、ビームサーチはしばしば best-of-N に負けさえする。先読み探索は、同じ予算ではたいていもっと悪い。
著者らは、原因は PRM の抜け穴を突かれたことにあると考えている。探索が強いほど、PRM が高いスコアをつけるのに実際には役に立たない解答、たとえば最後に情報のないステップを繰り返したり、一、二ステップしかないほど短かったりする解答を見つけやすくなる。最も強い探索方法が、かえって最も成績が悪い。
難易度別に分けて見ると、傾向はまったく違う。
- 簡単な問題:モデルはもともと正しい答えを書きやすく、検証器もたいてい正しく判断する。そこにビームサーチで強力に最適化をかけると、検証器が学んだ誤った特徴を増幅するだけで、予算が多いほど悪くなる。
- 中程度の問題:モデルは一回では正しく書きにくく、探索で正しい答えへ導ける。ビームサーチがずっと best-of-N を上回る。
- 最も難しい問題:どの手法でも目立った改善はない。
難易度に応じて最も良い探索方法を選ぶと、予算が少ないときには、16 回のサンプリングで best-of-N の 64 回の成績に迫れる。つまり計算を 4 倍近く節約できる。
修正:簡単な問題はひたすら直し、難しい問題は道を何本も開く
同じサンプリング数では、逐次修正が並列サンプリングをやや上回る。ただし二つの得意分野は違う。並列サンプリングは大域的な探索に近く、まったく違う解き方を試せる。逐次修正は局所的な手直しに近く、すでにおおむね正しい方向に進んでいる答えに向いている。
そこで著者らは予算の一部を並列に、一部を逐次に回し、さまざまな比率を試した。どの予算にも最も良い比率があり、しかもその比率は難易度によって変わる。簡単な問題は予算をすべて逐次修正に回すのが最も良く、難しい問題は並列と逐次のバランスを取る必要がある。
難易度に応じて比率を選ぶと、64 回のサンプリングで best-of-N の 256 回の成績を超えられる。こちらも 4 倍の節約だ。
テスト時計算で、モデルを大きくすることの代わりになるか
最後の問いだ。同じ FLOPs を、モデルを大きくするのに使うか、それとも小さいモデルが推論時に何回も計算するのに使うか?
著者らはよく使われる近似を用いた。事前学習の計算量は 、推論は で、 はパラメータ数だ。モデルのパラメータを 倍にすると、事前学習と推論の計算はどちらも 倍になる。その計算を代わりに小さいモデルの推論に回すなら、推論量に次の倍率を掛けられる。
何倍多く計算できるかは、推論の token 数と事前学習の token 数の比 で決まる。約 14 倍大きいモデル()と比べるために、著者らは が 0.16、0.79、22 の三つの場合を試した。推論の量がごく少ないとき(たとえば自己改善の訓練の流れ)は、節約できる事前学習の計算が多く、同じ FLOPs で小さいモデルの推論量を約 258 倍に増やせる。推論と事前学習の量が同程度なら約 63 倍、推論の量が事前学習よりはるかに多いとき(たとえば大規模なサービス運用)は約 16 倍しか残らない。
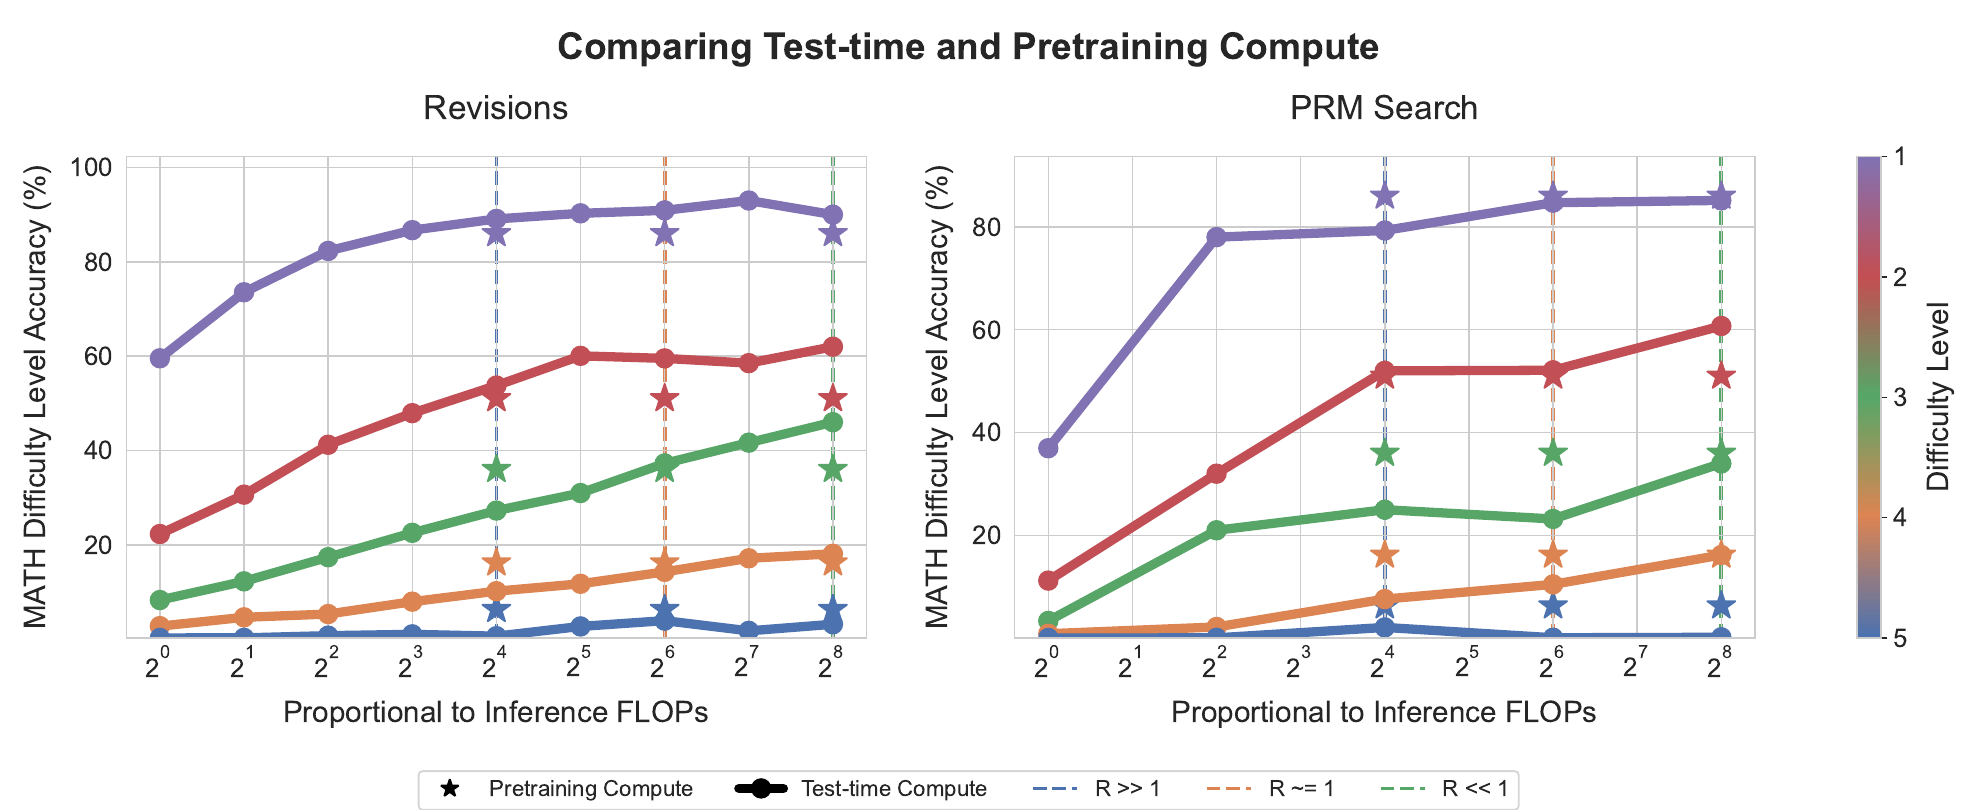
結論として、二つは一対一では交換できない。簡単な問題や中程度の問題、あるいは推論の需要が大きくない場面では、計算を推論に使うほうが、モデルを 14 倍大きくするよりしばしば良い。とても難しい問題や、推論の需要がとても大きい場面では、やはりモデルを大きくするほうが効果的だ。
限界
- 難易度の推定が高くつく:等級を分けるのに各問 2,048 回のサンプリングが要り、この分の計算は実験に含めていない。著者らは今後、モデルに問題の難易度を直接予測させるか、難易度の推定と解答を動的に切り替えることを提案している。
- 最も難しい問題は改善しない:探索でも修正でも、最も難しいレベルでは役に立たない。
- 手法を組み合わせていない:修正は検証器と組み合わせたが、PRM の木探索とは一緒に使っていない。
- 一つの設定でしか試していない:MATH と PaLM 2-S* だけで、しかも修正と検証の能力はそれぞれ別に微調整する必要がある。
著者らは、推論時に計算を多く使って得た答えをモデル自身に蒸留し戻し、継続的に自己改善するループを作れるだろうとも述べている。
その後
この論文が arXiv に出てから一か月後の 2024 年 9 月 12 日、OpenAI は o1 を発表した。o1 は強化学習で訓練され、答える前に長い内部の思考の連鎖を書く。OpenAI の記事は、o1 の性能が、訓練時の計算(強化学習)とテスト時計算(考える時間)を増やすにつれて着実に向上すると書いている。この論文が比べた「逐次修正」は、o1 では同じ思考の連鎖の中での自己点検と修正に姿を変え、修正用のモデルを別に微調整する必要はなくなった。
DeepSeek-R1 も似た道をたどり、しかも PRM と MCTS が彼らの手ではうまくいかなかったことをはっきり記録している。
難易度に応じてテスト時計算を配分するという考え方は、さらに極端なところまで推し進められた。2025 年 2 月の Can 1B LLM Surpass 405B LLM? は、最適な推論時の戦略を使えば、1B のモデルが MATH-500 で 405B のモデルを上回り、0.5B のモデルが MATH-500 と AIME24 で GPT-4o を上回れると報告した。彼らもまた、最も良い戦略は使うモデル、PRM、問題の難易度によって変わることを見出している。
最小限の訓練で、モデル自身に一本の思考の連鎖の中で考える時間を延ばさせるにはどうすればよいか。それについては s1 を見るとよい。
結論
テスト時計算の使い方に、万能のやり方はない。簡単な問題ではモデルに自分の答えを直させるべきで、強力な探索はかえって検証器の誤りを増幅する。中程度の問題では探索が最も効く。最も難しい問題では、今の手法はどれも役に立たない。難易度に応じて配分すれば、最大で 4 倍の計算を節約できる。
モデルを 14 倍大きくするのと比べると、簡単な問題と中程度の問題では、同じ計算を推論に使うほうがしばしば良く、難しい問題ではやはりより大きなモデルに頼る必要がある。テスト時計算と事前学習の計算は、一対一では交換できない。
著者らは序論で、これは事前学習に使う計算を少し減らし、推論に使う計算を少し増やす未来を示唆していると書いている。一か月後に o1 が発表され、テスト時計算は各社が競う焦点になった。ただ、その道はこの論文が考えていたよりもっと直接的で、外付けの探索や検証器に頼るのではなく、モデル自身にもう少し長く考えることを身につけさせるものだった。