原論文
s1: Simple test-time scaling
- 発表先
- EMNLP 2025国際会議
- arXiv への初回投稿
- arXiv:2501.19393
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltunings12025,
  title = {{s1: Simple test-time scaling}},
  author = {Niklas Muennighoff and Zitong Yang and Weijia Shi and Xiang Lisa Li and Li Fei-Fei and Hannaneh Hajishirzi and Luke Zettlemoyer and Percy Liang and Emmanuel Candès and Tatsunori Hashimoto},
  year = {2025},
  eprint = {2501.19393},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.19393}
}
2024 年 9 月、OpenAI は o1 を発表し、とてもきれいな曲線を見せた。モデルに長く考えさせるほど、答えが正確になる。しかし OpenAI はやり方を公開せず、大規模な強化学習を使ったとだけ述べた。
その後の数か月、多くのチームが再現を試みた。モンテカルロ木探索を使うところもあれば、複数のエージェントに議論させるところもあった。2025 年 1 月の DeepSeek-R1 は、数百万件のサンプルと何段階もの強化学習を使って、o1 の成績に追いついた。ところが、これだけ多くの再現の中で、あの「長く考えるほど答えが良くなる」曲線を公開の形で再現した例はなかった。
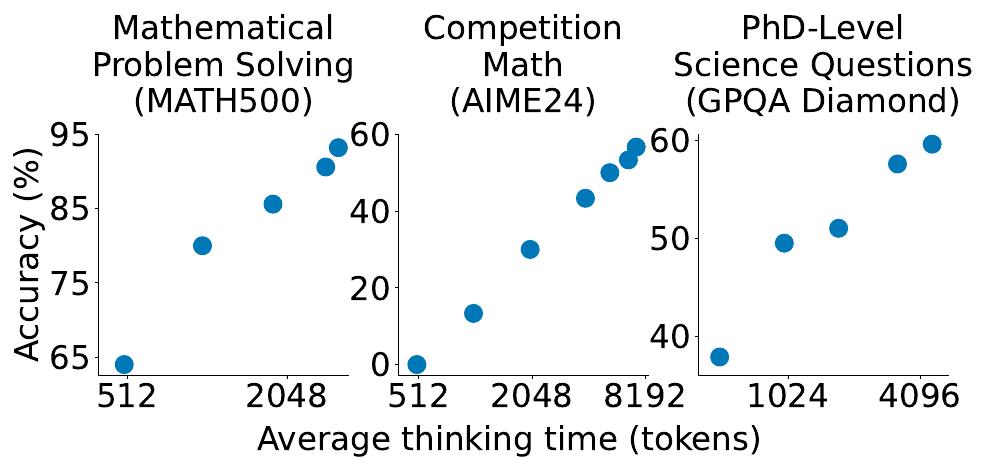
Stanford、ワシントン大学、AI2 などの Muennighoff、Yang らは、ごく率直な問いを立てた。あの曲線と強い推論能力を同時に実現する、最も単純なやり方は何か? 彼らの答えは意外なほど単純だった。1,000 件のデータ、16 枚の H100 で 26 分の微調整、それに「Wait」を一つ。
問題の定義
推論時に計算を多く使う手法を、著者らは二つに分けた。
- 逐次:後の計算が前の結果の上に積み上がる。たとえば長い推論を書く。
- 並列:それぞれ独立に計算し、最後にまとめる。たとえば多数決。
著者らが重点を置いたのは逐次のほうだ。直感的には、後の計算は前の途中結果を利用でき、より深く推し進めることも、繰り返し修正することもできる。
さまざまな手法を比べるには、正解率を見るだけでは足りず、計算量を制御できるか、計算量が増えたときに正解率もついてくるかも見なければならない。著者らは三つの指標を定義した。ある手法について、同じ評価で異なる計算量 で何回か走らせ、正解率 を得る。
制御度は、実際に使った思考 token 数が指定した範囲に収まった割合だ。スケーリングは曲線の平均の傾きで、正でなければ役に立たない。性能は達成できる最高の正解率だ。
問題を解く
s1K:1,000 問を選び出す
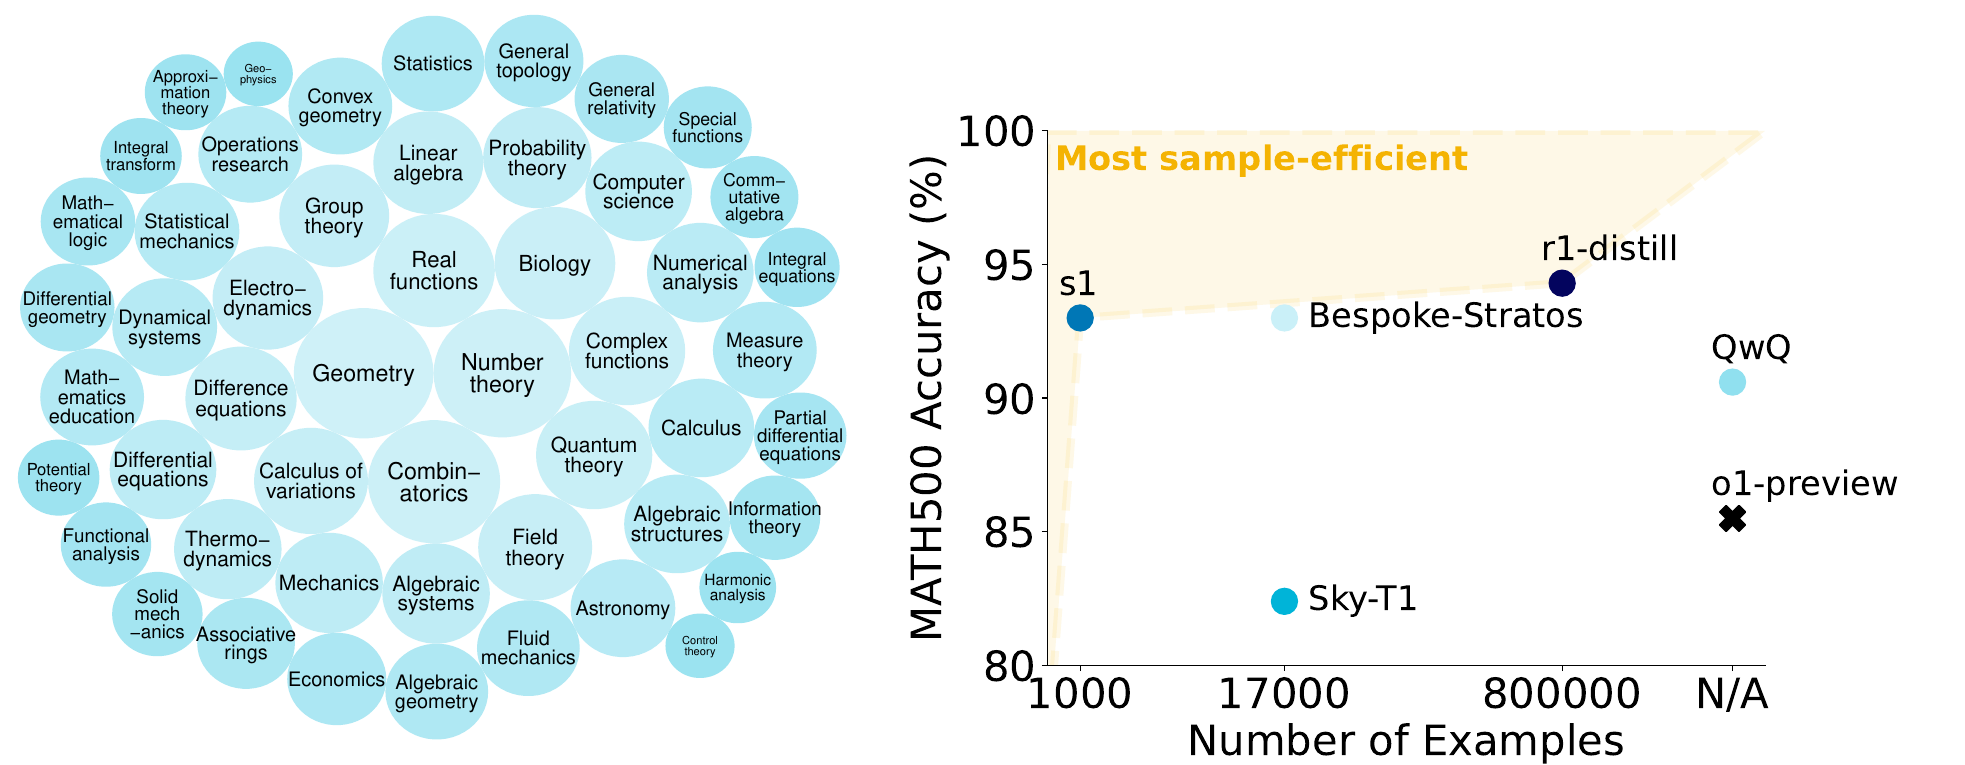
まず 5.9 万問を集める。出どころは 16 あり、最も大きいのは NuminaMATH の数学問題 30,660 問だ。ほかに歴代の AIME(1983 年から 2021 年)、分野横断のオリンピック問題 OlympicArena(4,250 問)、競技数学の OmniMath(4,238 問)、SAT や LSAT などの標準テストからなる AGIEval(2,385 問)がある。著者らは自分たちでも二つ作った。Stanford 統計学科の博士資格試験の確率の問題 182 問と、クオンツトレーディングの面接によく出る難問 23 問だ。
各問について Google の Gemini 2.0 Flash Thinking で推論過程と解答を生成し、「問題、推論、解答」の組を 59,029 組得た。評価の問題(MATH500、GPQA Diamond、AIME24)と 8 語連続で一致するデータはすべて削除し、重複した問題も取り除いた。
続いて三つの原則で絞り込んだ。
- 品質:API エラーが出たものを削除して 54,116 問が残った。さらに ASCII アートの図、存在しない画像への参照、問題番号の乱れといった形式に問題のあるものを削除して、51,581 問が残った。そのうち、高品質なデータセットから来ていて、それ以上絞り込む必要のない 384 問は、そのまま最終リストに入れた。
- 難易度:Qwen2.5-7B-Instruct と Qwen2.5-32B-Instruct にそれぞれ一回ずつ解かせ、Claude 3.5 Sonnet が正解と照らし合わせて採点する。どちらか一方のモデルでも正解したら簡単すぎるとして削除し、24,496 問が残った。推論過程の長さも難易度の指標として使った。難しい問題ほど長く考える必要があると仮定している。
- 多様性:Claude 3.5 Sonnet に、アメリカ数学会の数学主題分類に従って、各問を一つの分野に振り分けさせる。毎回まず分野を一つ無作為に選び、その分野の中から一問を選ぶ。推論が長いものほど選ばれやすい。これを 1,000 問に達するまで繰り返し、最終的に 50 分野をカバーした。
採点モデルは、s1K の推論過程のうち正しいのは 53.6% だけだと判定した。著者らはこうした誤りをわざと残している。欲しいのは推論の過程であって、完全に正しい解答ではないからだ。
予算強制
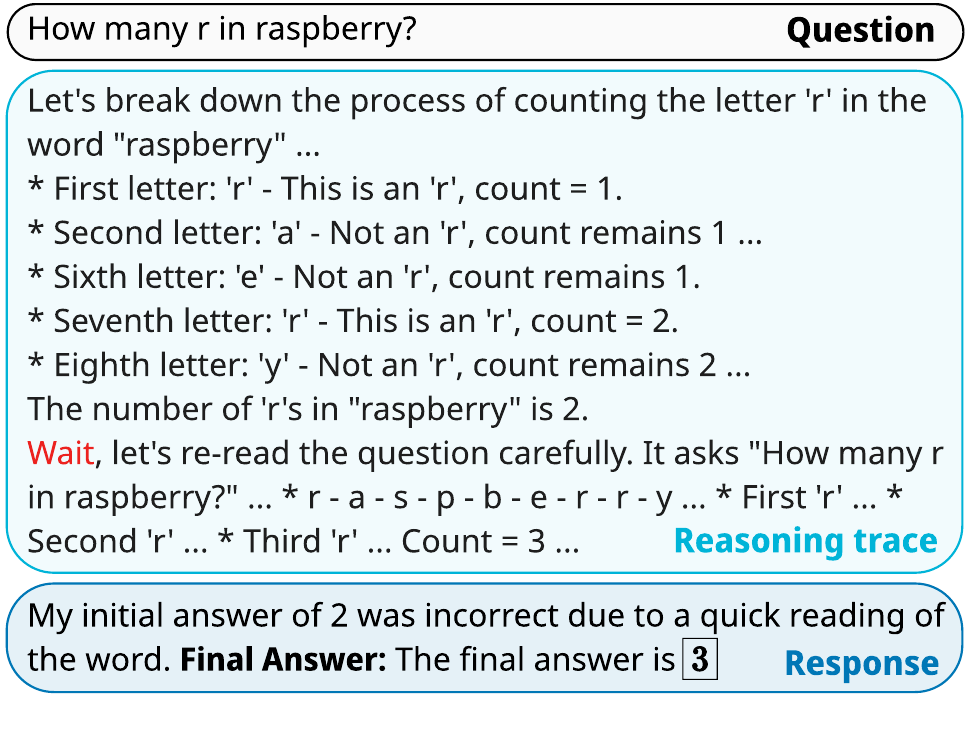
考える長さを制御する手法は予算強制(budget forcing)と呼ばれ、デコード時に直接介入する。
- 上限を設ける:思考の token 数が上限を超えたら、そのまま思考終了の記号をつなぎ、必要なら「Final Answer:」も加えて、モデルにその時点で最も良い答えを出させる。
- 下限を設ける:モデルが考えるのを終えようとしたら、終了記号を飲み込み、代わりに「Wait」をつないで考え続けさせる。
上の図がその一例だ。モデルは一度数えて、raspberry には r が二つしかないと思い込み、終えようとする。「Wait」をつながれると、問題を読み直して三つ目の r を見つけた。
「Wait」の後にモデルが何を書くかは、訓練データから何を学んだかで決まる。s1K の推論過程には「ちょっと待って」「もう一度確認しよう」といった文があふれていて、モデルは「Wait」を見ると、続けて前の推論を確認し始める。
著者らはほかの制御方法もいくつか比べた。
- プロンプトで token 数を指定する:最大何 token まで考えるかをモデルに伝える。
- プロンプトでステップ数を指定する:最大何ステップまで考えるかをモデルに伝える。1 ステップは約 100 token。
- プロンプトで長短を指定する:二種類のプロンプトで、短めに考えるか、長めに考えるかをそれぞれ指示する。
- 棄却サンプリング:ある回の長さがちょうど予算内に収まるまで、サンプリングを続ける。
訓練
ベースモデルは Qwen2.5-32B-Instruct だ。思考の部分は <|im_start|>think で始め、回答の部分は <|im_start|>answer で始める。s1K で 5 エポック、バッチ 16、合計 315 ステップ、学習率 で訓練し、最初の 5% でウォームアップした後、コサイン減衰で 0 まで下げる。損失は推論過程と解答だけで計算し、問題文は含めない。
16 枚の H100 で 26 分、約 7 GPU 時間の訓練だった。
議論
長く考えるほど、答えが良くなる
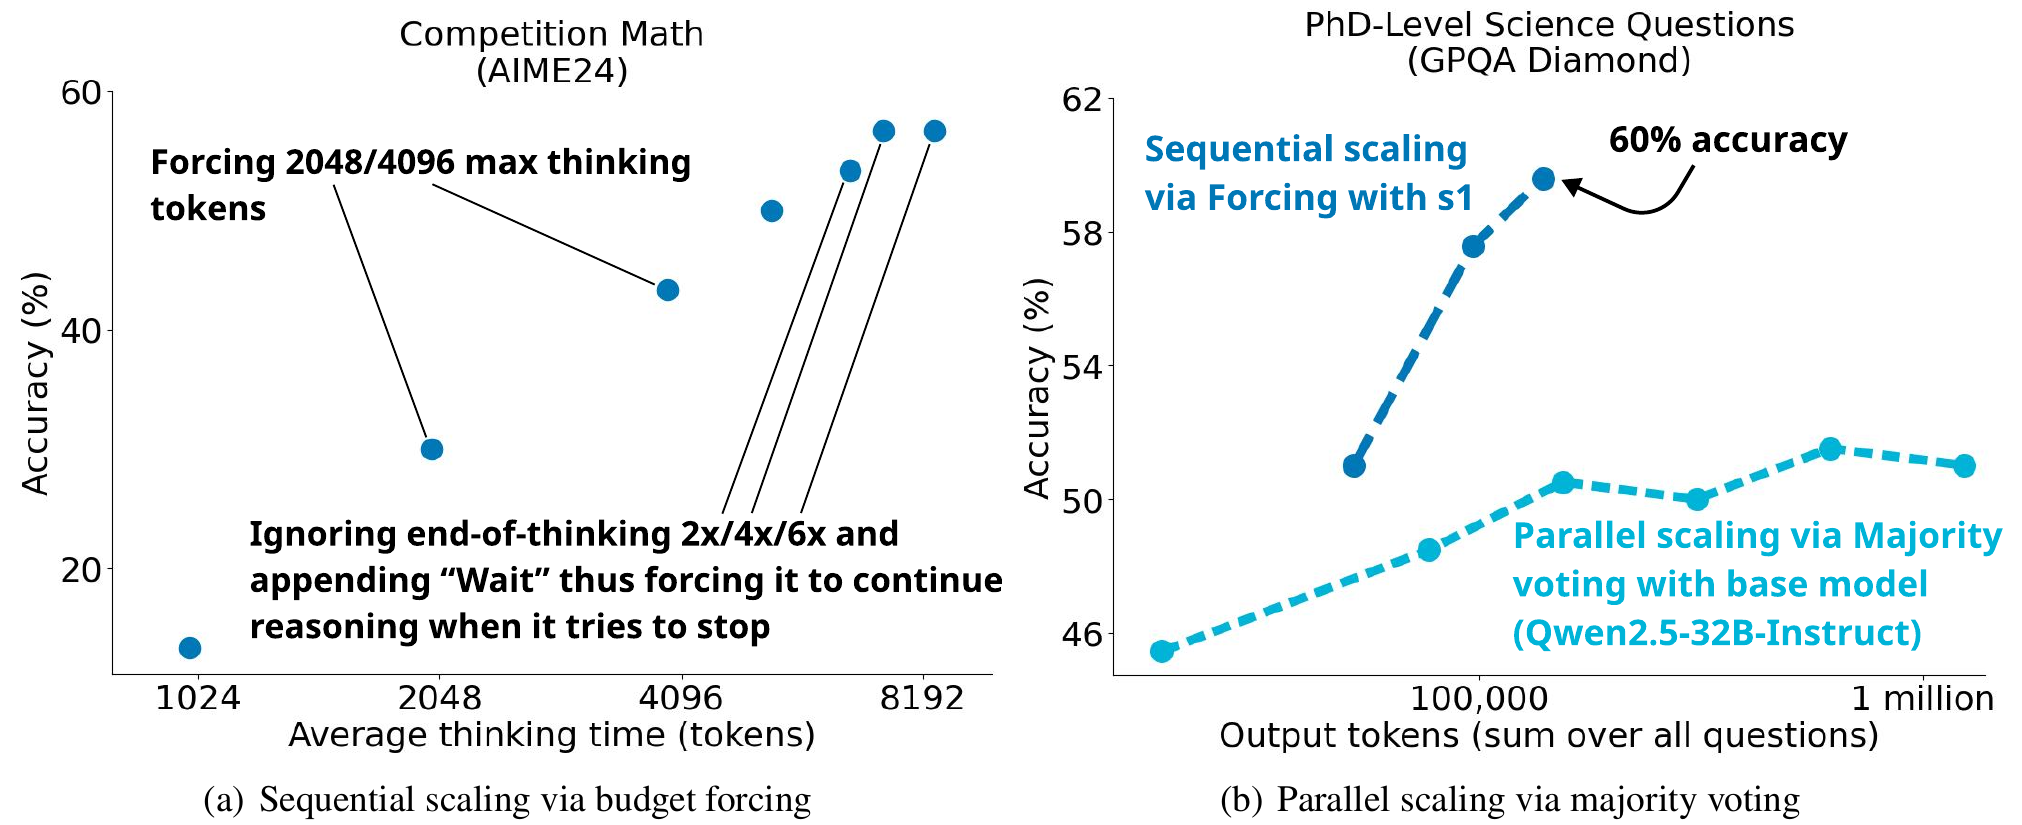
予算強制で思考を延ばすと、AIME24 は介入なしの 50% から 56.7% に上がる。ただし「Wait」を 6 回目までつなぐと、曲線は平らになる。終了記号を飲み込みすぎると、モデルは推論を続けるのではなく、同じことを繰り返すループに陥る。
右図は二つのスケーリングのしかたを比べている。ベースモデルの Qwen2.5-32B-Instruct は各問 64 回、温度 1 でサンプリングし、2 個から 64 個の答えで多数決を取っても、正解率は s1 の逐次スケーリングの成績にどうしても追いつけない。著者らは、これが最初の直感、つまり逐次スケーリングのほうが並列スケーリングより効果的だということを裏づけていると考えている。
成績
| モデル | 推論微調整のサンプル数 | AIME24 | MATH500 | GPQA |
|---|---|---|---|---|
| o1-preview | 非公開 | 44.6 | 85.5 | 73.3 |
| o1 | 非公開 | 74.4 | 94.8 | 77.3 |
| Gemini 2.0 Flash Thinking | 非公開 | 60.0 | - | - |
| Qwen2.5-32B-Instruct | - | 26.7 | 84.0 | 49.0 |
| DeepSeek-R1 | 80 万よりはるかに多い | 79.8 | 97.3 | 71.5 |
| R1 蒸留版(32B) | 80 万 | 72.6 | 94.3 | 62.1 |
| Bespoke-32B | 1.7 万 | 63.3 | 93.0 | 58.1 |
| s1(予算強制なし) | 1,000 | 50.0 | 92.6 | 56.6 |
| s1-32B | 1,000 | 56.7 | 93.0 | 59.6 |
原論文 Table 1 をもとに整理。一部の行を抜粋。単位は %。
わずか 1,000 件のデータを追加で訓練しただけで、s1-32B の AIME24 はベースモデルより 30 ポイント高くなった。AIME24 と MATH500 ではどちらも o1-preview を上回っている。要旨の「最大 27% 上回る」というのは、AIME24 での 56.7 対 44.6 の相対的な差だ。ただし GPQA では、まだ o1-preview より十数ポイント低い。
同時期に発表された R1 蒸留版は s1 より強いが、800 倍のデータを使っている。s1 は AIME24 で、その教師である Gemini 2.0 Flash Thinking にも迫っており、蒸留がおおむねうまくいったことを示している。
データの選び方で大きく変わる
| データ | AIME24 | MATH500 | GPQA |
|---|---|---|---|
| 無作為の 1,000 問(品質だけを見る) | 36.7 | 90.6 | 52.0 |
| 最も多様な 1,000 問(多様性だけを見る) | 26.7 | 91.2 | 54.6 |
| 推論が最も長い 1,000 問(難易度だけを見る) | 33.3 | 90.4 | 59.6 |
| 全 5.9 万問 | 53.3 | 92.8 | 58.1 |
| s1K | 50.0 | 93.0 | 57.6 |
原論文 Table 2 をもとに整理。この表の成績はどれも思考の上限を約 3 万 token に設定しており、モデルがループにはまって抜け出せなくなるのを防いでいる。単位は %。
一つの原則だけで問題を選ぶと、AIME24 はどれも 13 から 23 ポイント下がった。三つの原則を組み合わせた s1K は、全 5.9 万問で訓練したモデルとほぼ同じだが、後者には 394 GPU 時間かかり、s1K は 7 GPU 時間で済む。
考える長さをどう制御するか
| 手法 | 制御度 | スケーリング | 性能 |
|---|---|---|---|
| 予算強制 | 100% | 15 | 56.7 |
| プロンプトで token 数を指定 | 40% | −24 | 40.0 |
| プロンプトで token 数を指定 + 予算強制 | 100% | 13 | 40.0 |
| プロンプトでステップ数を指定 | 60% | 3 | 36.7 |
| プロンプトでステップ数を指定 + 予算強制 | 100% | 6 | 36.7 |
| プロンプトで長短を指定 | 50% | 25 | 36.7 |
| 棄却サンプリング | 100% | −35 | 40.0 |
原論文 Table 3 をもとに整理。AIME24。
予算強制は三つの指標のどれでも良い結果を出している。制御度は 100%、スケーリングは正で、正解率も最も高い。ほかの手法にはそれぞれ問題がある。
- token 数を指定する:モデルは自分が何 token 書いたかを正確に数えられない。特別に訓練しても同じで、予算強制を加えなければ制御しきれない。
- ステップ数を指定する:モデルは抜け道を突くのがうまい。ステップを少なくしろと言えば各ステップを長めに書き、多くしろと言えば各ステップを短めに書くので、総 token 数はほとんど変わらない。
- 長短を指定する:長めに考えろと言えば、確かにモデルは長く考える。スケーリングはむしろ最も高いが、正解率は高くない。
- 棄却サンプリング:最も意外な結果だ。長さの制限を緩めるほど、正解率はかえって下がり、スケーリングは −35 になった。著者らが調べたところ、短い生成の多くは、モデルが最初から正しい方向に進んでいたものだった。長い生成は、モデルが道を間違えて、引き返したり自分を疑ったりを繰り返していることが多い。ある長さの答えだけを選ぶことは、異なる難しさの状態を選び出すことに等しい。
後ろにつなぐ言葉についても、著者らはいくつか比べている。
| 思考を終えるときの扱い | AIME24 | MATH500 | GPQA |
|---|---|---|---|
| 延長しない | 50.0 | 93.0 | 57.6 |
| 2 回飲み込み、何もつながない | 50.0 | 90.2 | 55.1 |
| 2 回飲み込み、「Alternatively」をつなぐ | 50.0 | 92.2 | 59.6 |
| 2 回飲み込み、「Hmm」をつなぐ | 50.0 | 93.0 | 59.6 |
| 2 回飲み込み、「Wait」をつなぐ | 53.3 | 93.0 | 59.6 |
原論文 Table 4 をもとに整理。単位は %。
終了記号を取り除くだけで何もつながないと、かえって悪くなる。「Wait」が全体として最も良く、AIME24 を向上させたのはこれだけだ。
なぜ 1,000 件で足りるのか
著者らの仮説は、推論の能力はもともとモデルの中にある、というものだ。事前学習には数兆 token が使われ、その中にはもともと大量の推論データが含まれている。1,000 件の微調整はこの能力を呼び出すだけで、それを予算強制で推論時に増幅する。これは LIMA が提唱した「表面的アラインメント仮説」に似ている。LIMA は、1,000 件のデータで、モデルが利用者の好みに沿って答えることを十分に学べると見出した。
限界
- 頭打ちになる:予算強制である程度まで延ばすと、それ以上は良くならず、やりすぎるとモデルが繰り返しのループに陥る。著者らが挙げた改善の方向には、異なる言葉を順番に使うこと、繰り返しペナルティと組み合わせること、温度を上げることがある。
- コンテキスト長:どれだけ長く考えても、モデルのコンテキストウィンドウを超えることはできない。AIME24 でモデルに 512 ステップまで考えさせると、30 問中 12 問で出力がコンテキスト長を超え、成績が大きく落ちた。
- 並列スケーリングで補える:著者らは、プロセス報酬モデルで導く木探索 REBASE に多数決を組み合わせて試した。単純な多数決よりうまくスケールし、この比較では逐次スケーリングにも勝ったが、ステップごとに報酬モデルの計算が一回余分に要る。
もう一つ、s1K の推論過程はすべて Gemini が書いたもので、モデルはおおむね教師のレベルまでしか学べない。この点は、次の s1.1 でいっそうはっきりする。
その後
s1 の発表から 7 日後、著者らは s1.1 を発表した。同じ 1,000 問で、推論過程を DeepSeek-R1 で生成し直し、訓練方法はそのままにした。
| モデル | MATH500 | GPQA | AIME24 | AIME25 |
|---|---|---|---|---|
| s1(予算強制なし) | 92.6 | 56.6 | 50.0 | 26.7 |
| s1(「Wait」を 4 回つなぐ) | 92.2 | 58.6 | 56.7 | 36.7 |
| s1.1(予算強制なし) | 94.4 | 60.6 | 56.7 | 50.0 |
| s1.1(「Wait」を 2 回つなぐ) | 95.4 | 63.6 | 56.7 | 50.0 |
原論文の付録 Table 5 をもとに整理。一部の行を抜粋。単位は %。
教師を替えただけで、s1.1 は予算強制をまったく使わずに、s1 が予算強制で出した最高の成績に追いついた。2025 年の新しい問題 AIME25 では、26.7% から 50.0% に跳ね上がった。著者らは Claude 3.7 を教師にすることも試したが、結果は R1 より悪かった。面白いことに、s1.1 は「Wait」を加えても、AIME の成績はもう上がらなかった。
同じ表には、新しい競争相手もいくつか載っている。817 件のデータで微調整した LIMO は、AIME24 で 56.3% を取り、s1 と似た結論に達している。OpenAI の o3-mini は、考える強さをそのまま三段階にしていて、low、medium、high の AIME24 はそれぞれ 56.3%、75.8%、83.8% だ。モデルにどれだけ考えさせるかを制御することが、製品の選択肢の一つになった。
結論
s1 は精選した 1,000 問のデータで Qwen2.5-32B-Instruct を 26 分微調整し、さらに予算強制で考える長さを制御して、o1 のあの「長く考えるほど答えが良くなる」曲線を公開の形で再現した。AIME24 は 50% から 56.7% に上がり、競技数学で o1-preview を上回った。
最も示唆に富むのは、あのデータのアブレーション表だ。無作為、最も多様、最も長い、どれか一つの基準だけで 1,000 問を選ぶと、三つを組み合わせたものよりずっと悪い。5.9 万問をすべて訓練に使っても、ほんの少し良くなるだけだ。データが少ないことは問題ではなく、的確に選ぶことが肝心なのだ。
あの「Wait」について言えば、確かに効くが、延ばせる幅には限りがあり、より良い教師に替えるほうがずっと大きな差を生む。s1 に考え続けさせていたのは、あの一語というより、Gemini と後の R1 があの 1,000 問に書き込んだ推論の癖だったと言うべきだろう。