原論文
Let's Verify Step by Step
- 発表先
- ICLR 2024国際会議
- arXiv への初回投稿
- arXiv:2305.20050
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningletsverify2023,
  title = {{Let's Verify Step by Step}},
  author = {Hunter Lightman and Vineet Kosaraju and Yura Burda and Harri Edwards and Bowen Baker and Teddy Lee and Jan Leike and John Schulman and Ilya Sutskever and Karl Cobbe},
  year = {2023},
  eprint = {2305.20050},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.20050}
}
数学の問題の解答は、十数ステップの導出が一本の長い列につながっていることが多い。そのうち一ステップでも計算を間違えれば、後をどれだけきれいに書いても答えは間違いになる。もっと厄介なことに、途中で間違えているのに答えがたまたま合っている場合もある。
モデルをより信頼できるものにする一般的な方法は、解答の良し悪しを見分ける報酬モデルを訓練することだ。報酬モデルは強化学習に使うこともできるし、推論時に多数の候補から最も良いものを一つ選ぶのに使うこともできる。どちらの使い方でも、システム全体の信頼性は、せいぜい報酬モデルと同じところまでだ。
報酬モデルはどう教えればよいのか? DeepMind の Uesato らは 2022 年に二つのやり方を比べている。最終的な答えが正しいかだけを見る結果監督と、一ステップずつ確認するプロセス監督だ。小学校レベルの算数 GSM8K では、両者の最終的な性能はほぼ同じだった。
OpenAI の Lightman らは、この比較をやり直した。今回は、より強いモデル(GPT-4)、はるかに多くの人手のアノテーション、そしてずっと難しい問題(MATH、高校の競技数学レベル)を使った。結論は変わった。
問題の定義
二種類の報酬モデルの違いは、訓練の信号にある。
- 結果監督の報酬モデル(ORM):解答全体が正しいか間違っているかを予測するように学習する。ラベルは自動で作れる。MATH の各問には、自動で照合できる最終的な答えがあるからだ。推論時には、最後の token でのモデルの予測を解答のスコアとする。
- プロセス監督の報酬モデル(PRM):各ステップが正しいか間違っているかを予測するように学習する。これは自動では判断できないので、人に一ステップずつラベルをつけてもらう必要がある。
ORM のラベルには生まれつきの穴がある。推論が間違っていて答えがたまたま正しい解答も、正しいとラベルづけされてしまう。
この論文は報酬モデルそのものだけを研究しており、それを使って解答を生成するモデルを強化学習で鍛えることはしない。評価方法は best-of-N だ。解答を生成するモデル(generator)を一つ固定し、各問について N 個の解答をサンプリングし、報酬モデルにスコアが最も高いものを選ばせて、正解の割合を見る。報酬モデルが信頼できるほど、正しい解答を選べる回数が増える。
問題を解く
二つの規模のモデル
大規模のモデルは、すべて GPT-4 のベースモデルから微調整したものだ。このベースモデルは次の token を予測する事前学習しかしておらず、RLHF は経ていない。目的は最良の ORM と PRM を作ることにある。
小規模のモデルは GPT-4 に似た構造だが、事前学習の計算量はおよそ 200 分の 1 で、大規模では負担しきれない比較実験に使う。
すべてのモデルは、まず MathMix でもう一段階訓練する。これは約 15 億 token の数学関連データで、数学的推論の能力を高める。
解答を生成するモデルも微調整している。著者らは少数ショットプロンプトでモデルに MATH の訓練問題を解かせ、正解したものを残して、それらの解答で 1 エポック訓練した。目的は、一行一ステップの形式を覚えさせてステップに区切りやすくすることだけで、新しい能力を教えることではない。
一ステップずつラベルをつける
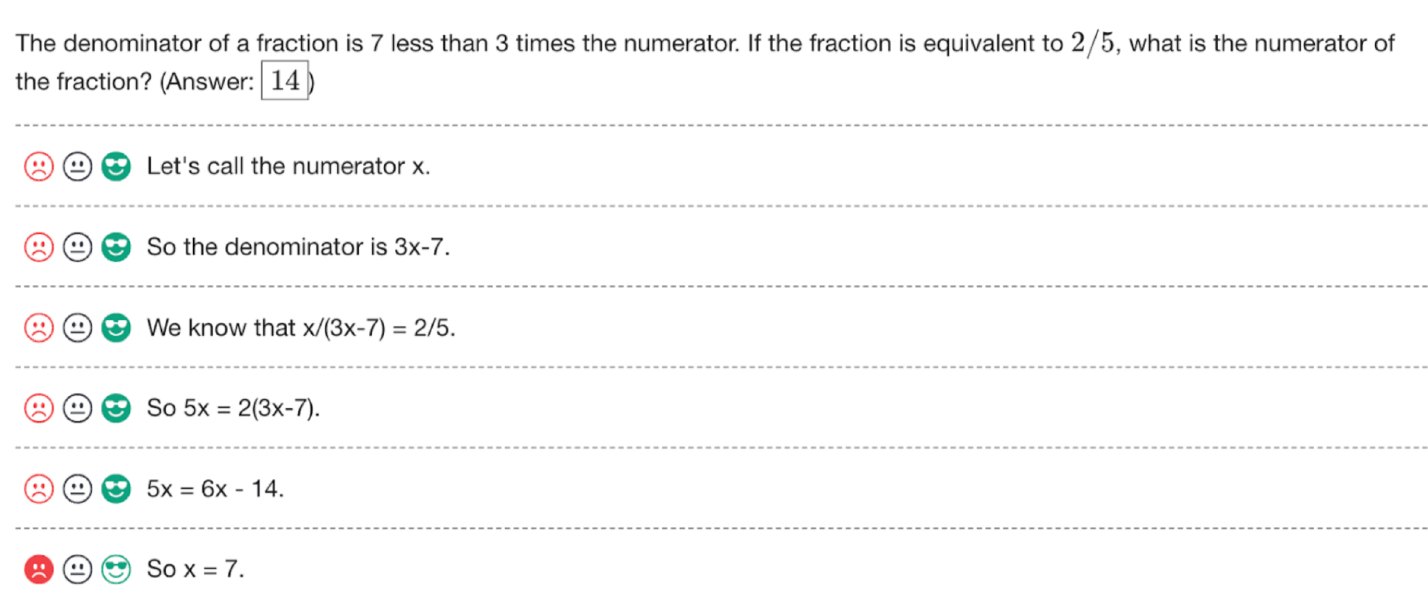
アノテーターは大規模な generator が書いた解答を見て、各ステップに三種類のラベルのどれかをつける。
- 肯定的:このステップは正しく、筋が通っていて、しかも答えに向かって前進している。
- 否定的:このステップは間違っているか、筋が通らない。
- 中立:どちらとも言えない。たとえば少し誤解を招く、あるいは技術的には正しいが良い方向ではない。
中立という選択肢を残したのは、曖昧なケースをどう扱うかの決定を先送りするためで、推論時に中立を肯定的とみなすことも、否定的とみなすこともできる。アノテーターには正しい最終的な答えは渡されるが、参照解法は渡されない。特定の解き方だけを認めることにならないようにするためだ。
最終的にまとめたのが PRM800K で、1.2 万問に対する 7.5 万個の解答から、80 万個のステップのラベルを集めたものだ。問題が足りなかったので、著者らは MATH のテストセットの 4,500 問も訓練用の問題に回し、評価には残りから無作為に抜き出した 500 問だけを使った。付録では、この 500 問の難易度と分野の分布が、テストセット全体とほぼ同じであることを確認している。
どの解答を人に見せるか
ラベルづけは高くつくので、情報量の多い解答を選ぶ必要がある。明らかに間違った解答は、ラベルをつけても学べることは多くない。
著者らの戦略は、「説得力のある間違った答え」を選ぶことだ。現時点で最良の PRM が高いスコアをつけたのに、最終的な答えが間違っている解答である。答えが間違っている以上、PRM は少なくともどこか一ステップを見誤っている。それがどのステップかを人に示してもらうことは、PRM の盲点を埋めることになる。データ収集の過程では、PRM を最新のラベルで何度か訓練し直してから、次の一群を選ぶ。
PRM の訓練とスコアのつけ方
PRM は各ステップの最後の token の後で、正誤を表す token を一つ予測する。通常の言語モデルの訓練方法でこの token の対数尤度を最大化すればよく、特別なアーキテクチャは要らない。推論時には、解答全体に対して一回フォワード計算をすれば、各ステップのスコアが得られる。
一つの解答の総合スコアは、「すべてのステップが正しい」確率、つまり各ステップが正しい確率の積として定義する。アノテーション画面のあの問題を例にとると、最初の五ステップはすべて正しく、5x = 6x − 14 からは x = 14 が得られるはずなのに、最後のステップは x = 7 と書かれている。一ステップでも確率が非常に低ければ、掛け合わせた総合スコアは非常に低くなり、しかも PRM はどのステップで間違えたかを示せる。
積には副作用もあって、ステップが多いほど掛け合わせた値は小さくなる。十二ステップで各ステップ 0.95 の解答は総合スコアが約 0.54 で、二ステップで各ステップ 0.8 の解答(0.64)よりむしろ低い。著者らは付録で四通りのスコアのつけ方(中立を肯定的とみなすか否定的とみなすか、積を取るか最小値を取るか)を比べたが、差はどれもわずかだった。
| 中立のステップ | 積 | 最小値 |
|---|---|---|
| 肯定的とみなす | 78.2 | 77.6 |
| 否定的とみなす | 77.4 | 77.8 |
原論文の付録 Table 4 をもとに整理。best-of-1860 の正解率(%)。
論文全体で使っているのは、最も成績の良い組み合わせ、つまり中立を肯定的とみなし、積を取るやり方だ。著者らも、積はステップの多い解答にやや不利であることを認めている。
最初の誤りまでしかラベルをつけない
プロセス監督では、最初に誤ったステップまでしかラベルをつけず、その後にはつけない。こうすると二つの監督の比較がより公平になる。
正解した解答では、二つの監督が与える情報は同じで、どのステップも正しい。間違った解答では、どちらもその中に誤りがあることはわかるが、プロセス監督はさらに、どのステップで間違えたかがわかる。最初の誤りの後もラベルをつけ続ければ、プロセス監督の情報量がいっそう有利になってしまう。
これで人手のコストもほぼ同じになる。照合できる最終的な答えがなければ、解答が正しいかどうかを判断することは、もともとその最初の誤りを見つけることと同じだ。MATH の問題にはどれも照合しやすい答えがあるが、著者らは、より複雑な分野ではこの条件がいつも成り立つとは限らないと見ている。
議論
大規模:PRM がはっきり勝つ
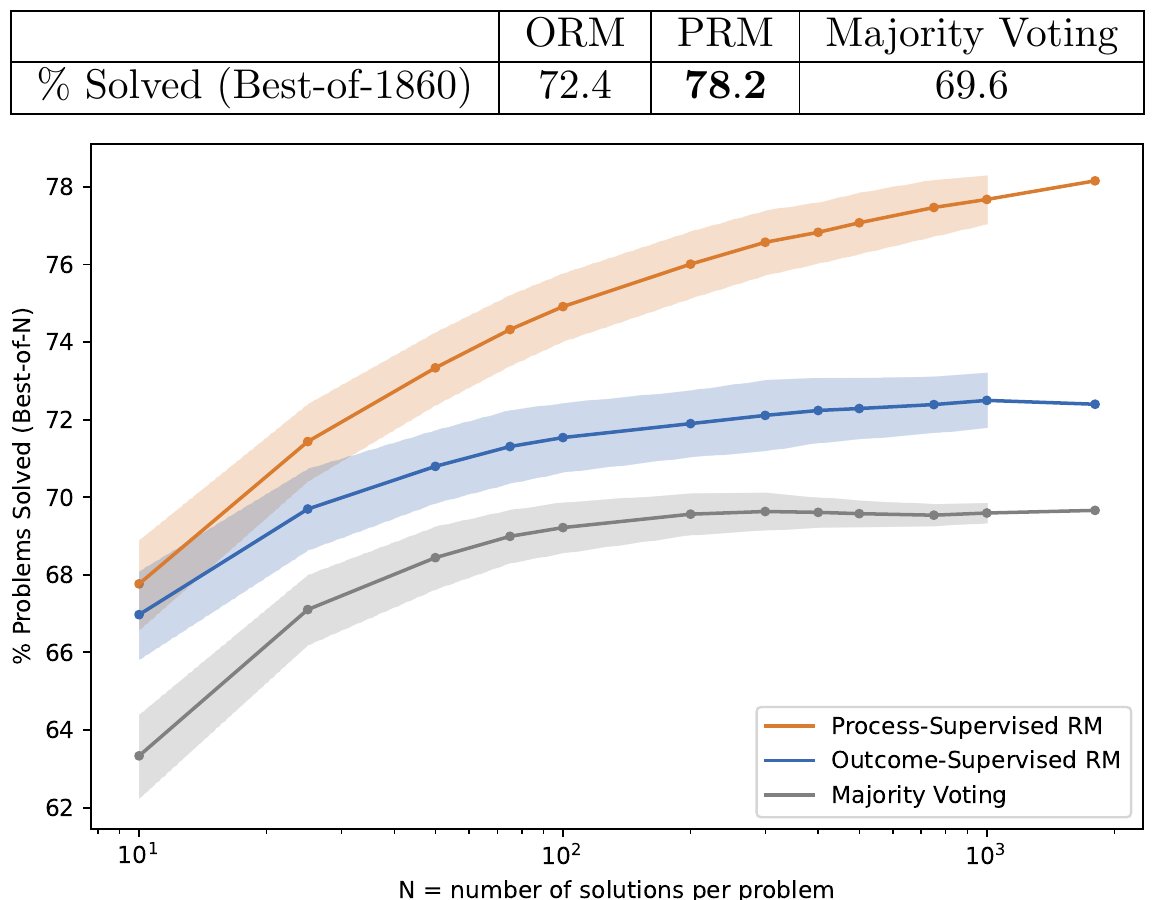
ORM をできるだけ強くするため、著者らは各問につき 100 個の解答を一様にサンプリングして訓練した。データ量は PRM800K より一桁多く、二つのデータはまったく重ならない。
各問 1,860 個の解答から一つを選ぶと、PRM の正解率は 78.2%、ORM は 72.4%、多数決は 69.6% だった。ORM は多数決より少し良いだけだが、PRM は両者をはっきり上回り、しかも N が大きいほど差が広がる。大量の候補から正しいものを選び出すなら、PRM が最も信頼できる。
著者らは、報酬モデルのスコアで多数決に重みをつけ、両方の長所を取ることも試したが、目立った効果はなかった。
小規模:交絡要因を切り分ける
大規模の結果には二つの交絡要因がある。第一に、両者の訓練データが違う。PRM のデータは能動的に選んだもので、間違った答えに偏っており、しかも一桁小さい。第二に、最終的な答えで正誤を判定すると、「推論が間違っていて答えが正しい」解答を正しいとラベルづけしてしまい、ORM の足を引っ張る。これを結果監督のせいにすべきかどうかは、意見が分かれるところだ。
人手のアノテーションは高すぎて、こうした比較実験には使えない。そこで著者らは、大規模な PRM(以下 PRMlarge と呼ぶ)をアノテーター役にして小規模モデル用のラベルを生成し、大量のデータ収集を安上がりに模擬した。
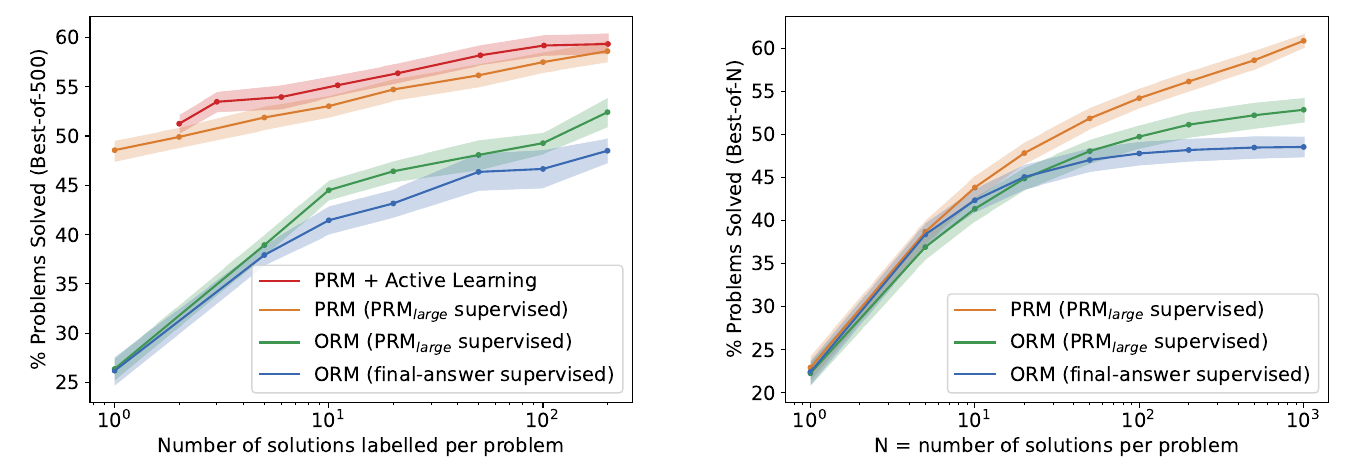
各問につき 1 から 200 個の解答をサンプリングし、同じデータに三種類の監督を与える。PRMlarge が一ステップずつラベルをつけるプロセス監督、PRMlarge が解答全体の正誤だけを判定する結果監督、最終的な答えとの照合による結果監督だ。三組のモデルの違いは、監督のやり方だけである。
データ量にかかわらず、プロセス監督は二つの結果監督をはっきり上回る。二つの結果監督の間では、PRMlarge が判定したほうが最終的な答えとの照合より良い。「推論が間違っていて答えが正しい」解答を間違いと判定できるからだ。
著者らは、PRMlarge が判定した組のほうが比較対象として適切だと考えている。この種の偽陽性が起きにくい分野では、結果監督はこちらに近くなる。MATH での偽陽性の問題は、実際より大きく見えているかもしれない。
能動学習:まず各問 1 個の解答で小さな PRM を訓練し、それに各問 1,000 個の解答を採点させる。次に各問 N 個を選ぶ。そのうち 80% はその PRM が最高スコアをつけた間違った答え、20% は残りの中で最高スコアの解答(正誤は問わない)で、これらを PRMlarge に渡してラベルをつけさせる。二本の当てはめ直線の傾きを比べると、この能動学習のデータ効率は、一様に選ぶ場合のおよそ 2.6 倍だった。
各問 200 個を選んだときは、性能が傾向線をやや下回った。著者らの説明では、200 個は候補 1,000 個の五分の一を占めており、選べるものの多様性が足りなかった。収集の途中で選別用の PRM を繰り返し訓練し直すことも試したが、原因を突き止められない不安定さが生じ、結果は良くならなかった。
見たことのない新しい問題
MATH の問題はネット上で広く出回っていて、事前学習データに含まれている可能性がある。著者らは別に、最新の AP 物理、AP 微積分、AP 化学、AMC10、AMC12 の試験問題を集めた。どれも事前学習データの収集が終わった後に公開されたものだ。各問につき 100 個の解答をサンプリングした。
| 試験 | ORM | PRM | 多数決 | 問題数 |
|---|---|---|---|---|
| AP 微積分 | 68.9% | 86.7% | 80.0% | 45 |
| AP 化学 | 68.9% | 80.0% | 71.7% | 60 |
| AP 物理 | 77.8% | 86.7% | 82.2% | 45 |
| AMC10/12 | 49.1% | 53.2% | 32.8% | 84 |
| 合計 | 63.8% | 72.9% | 61.3% | 234 |
原論文 Table 1 をもとに整理。
結果は MATH と一致しており、PRM は ORM と多数決を上回る。AMC のような難問では、多数決は 32.8% しかなく、PRM は 53.2% だった。
なぜプロセス監督のほうが良いのか
著者らの説明は信用割り当て(credit assignment)だ。結果監督はモデルに「この解答は間違い」と伝えるだけで、どこが間違いかはモデルが自分で推測しなければならない。問題が難しいほど、モデルが書く解答はほとんどどこかに誤りを含むので、「間違い」というラベルがもたらす情報は少なくなる。プロセス監督は、前のいくつかのステップは正しく、どのステップで間違えたかを直接伝えるので、信号ははるかに豊かだ。
著者らはアラインメントの観点からも論じている。プロセス監督は、結果だけを見るのではなく、人が認めた推論過程に報酬を与えるので、解釈しやすく、モデルが報酬の抜け穴を突くことも学びにくい。安全なやり方はしばしば性能を少し犠牲にし、これはアラインメント税(alignment tax)と呼ばれる。ここでは、より安全なプロセス監督のほうがむしろ効果が高く、著者らはこれを負のアラインメント税と呼んでいる。ただし、この結論が数学以外にも一般化できるかはまだわからない、とも注意している。
限界
- テストセットの汚染:著者らは文字列照合で MATH の問題を MathMix から削除したが、ネット上には見抜きにくい言い換え版があるかもしれず、完全にきれいだとは保証できない。モデルの解答を確認したところ、答えを丸暗記している明らかな形跡は見られなかった。たとえ少量の汚染があっても、すべての手法に同じような影響を与えるはずで、相対的な比較はおおむね影響を受けない。generator 自身が正しく書ける確率が一桁パーセントしかない正しい解答を、PRM がしばしば選び出せることも、このことを裏づけている。
- 報酬モデルしか研究していない:PRM を使って強化学習で generator を訓練することはしておらず、著者らはこれを今後の研究に残している。
- 人手のコスト:PRM800K には 80 万個のステップのラベルがあり、大量の人手のアノテーションに頼っている。しかも数学でしか試していない。
その後
あの 500 問のテスト問題は、のちに MATH-500 としてまとめられ、推論モデルの評価で最もよく使われるものの一つになった。DeepSeek-R1 の MATH-500 での pass@1 は 97.3% だ。
人手のアノテーションが高すぎるという問題には、すぐに代わりの方法が見つかった。2023 年 12 月の Math-Shepherd は人にラベルをつけてもらう代わりに、各ステップから先をモデルに何本も最後まで書かせ、そのうち何本が正しい答えにたどり着くかを見て、その割合をそのステップの質とした。その著者陣は DeepSeekMath と重なっている。
PRM は推論時の探索の主要な道具にもなり、各ステップで候補を採点し、どこを展開するかを決めるのに使われた。ただし DeepSeek-R1 は「失敗した試み」の中で、PRM の三つの問題も記録している。一般的な推論タスクでは各ステップを明確に定義しにくいこと。途中のステップの正誤は、自動アノテーションでは正確さが足りず、人手のアノテーションは規模を広げにくいこと。モデルを報酬として使うと、大規模な強化学習では抜け穴を突かれやすいこと。最終的に彼らが使ったのは、答えの正誤だけを見るルールベースの報酬だった。
結論
MATH のような難問では、一ステップずつラベルをつけるプロセス監督で訓練した報酬モデルが、答えだけを見る結果監督よりはっきり信頼できる。1,860 個の解答から一つを選ぶと、PRM の正解率は 78.2%、ORM は 72.4%、多数決は 69.6% だった。小規模の比較実験でも、同じデータの上でプロセス監督がずっと先頭を走ることが確認された。
代償は 80 万個の人手のラベルだ。能動学習で多少は節約でき、「PRM が見誤った間違った解答」を選んでラベルをつければ効率はおよそ 2.6 倍になるが、結局は誰かが一ステップずつ目を通す必要がある。
この論文が最も多くの痕跡を残したのは、おそらく付随的な二つのものだ。PRM800K というデータと、あの 500 問のテスト問題である。前者は数えきれない報酬モデルの訓練に使われ、後者は MATH-500 となって、今でもあらゆる推論モデルの成績表に載っている。