原論文
STaR: Bootstrapping Reasoning With Reasoning
- 発表先
- NeurIPS 2022国際会議
- arXiv への初回投稿
- arXiv:2203.14465
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningstar2022,
  title = {{STaR: Bootstrapping Reasoning With Reasoning}},
  author = {Eric Zelikman and Yuhuai Wu and Jesse Mu and Noah D. Goodman},
  year = {2022},
  eprint = {2203.14465},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.14465}
}
推論を先に書いてから答えると、モデルの答えは良くなる。このことには、2022 年初めの時点ですでにかなりの証拠があった。問題は、どうやってモデルに推論の書き方を身につけさせるかだ。
当時は道が二つあった。一つは、推論過程つきの訓練データを大量に用意して微調整すること。これには人が一問ずつ書く必要がある。たとえば CommonsenseQA の人手による説明のデータセット CoS-E がそうだ。テンプレートで自動生成することもできるが、解き方がわかっていてルールに書ける問題に限られる。
もう一つは思考の連鎖プロンプトで、推論つきの例をいくつかプロンプトに入れ、訓練はしない。安上がりだが、大量のデータで「答えだけを出力する」ように直接訓練したモデルには、たいてい及ばない。この論文で使う GPT-J 6B を例にとると、CommonsenseQA で少数ショットの思考の連鎖は 36.6% しかなく、答えを出力するよう直接微調整すると 60.0% になる。
Stanford の Zelikman らは、その中間の道を行こうとした。推論つきの例は十個ほどだけ用意し、そこに推論のない、答えだけがついた大量の問題を加えて、モデルに自分で推論を書かせ、それを教材にして自分で学ばせる。
問題の定義
手元にあるのは、事前学習済みのモデル 、問題と答えだけのデータセット 、そして推論つきの例の小さな組 (10 個ほど)だ。
目標は、先に推論 を書き、次に答え を書くモデルを訓練することで、しかも答えだけを出力するモデルより正確でなければならない。
手法全体が前提にしているのは、正しい答えを導ける推論は誤った答えを導く推論より質が高い、という仮定だ。この仮定はいつも正しいとは限らない。これについては後でまた触れる。
問題を解く
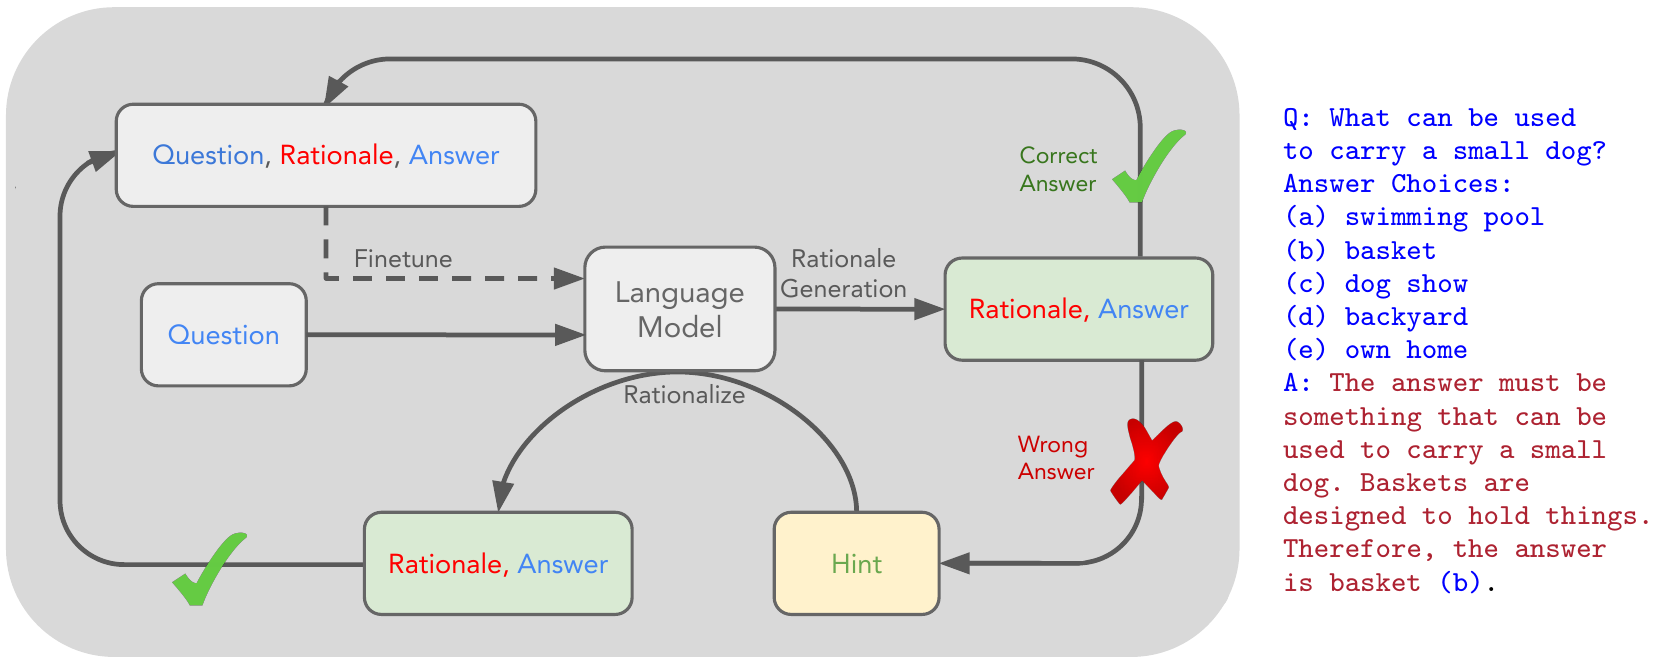
自分で推論を書き、正解したものだけ残す
最初のステップは単純明快だ。その十個ほどの例をプロンプトにして、データセットの各問題についてモデルに推論と答えを書かせる。答えが正解と一致したものは推論ごと残し、間違えたものは捨てる。
次に、残したデータでモデルを微調整し、微調整したモデルでもう一度すべての問題を解き直す。選別と微調整を、成績が伸びなくなるまで繰り返す。
毎回の微調整は、前回のモデルから続けて訓練するのではなく、元の事前学習済みモデル から始める。過学習を避けるためだ。最初の回は 40 ステップだけ訓練し、以降は回ごとに 20% ずつ増やす。著者らは、最初はゆっくり訓練したほうが最終的な成績が良いことに気づいた。
解けない問題には、答えを見せる
正解した問題だけを残すやり方には、はっきりした問題がある。モデルが解けない問題はいつまでも訓練データに入らないので、解ける問題を学び尽くしたら、もう新しいことは何も学べない。
著者らの解決策は rationalization と呼ばれる。間違えた問題については、プロンプトで正しい答えをモデルにそのまま教え、推論を書かせる。
Q: Where do you put your grapes just before checking out?
Answer Choices:
(a) mouth
(b) grocery cart (CORRECT)
(c) super market
(d) fruit basket
(e) fruit market
A: The answer should be the place where grocery items are placed before
checking out. Of the above choices, grocery cart makes the most sense for
holding grocery items. Therefore, the answer is grocery cart (b).
原論文 Figure 2 のプロンプト例。「(CORRECT)」がモデルに与えるヒントだ。
答えがわかっていれば、筋の通った理由を逆算するのはずっと簡単だ。そして、この推論を訓練データに入れるときにはヒントを取り除き、訓練の入力は元の問題だけにして、まるでモデルが自分で考え出したかのように扱う。
これで、もともと解けなかった難しい問題も訓練データに入れられ、データ量もそのぶん増える。
アルゴリズム全体は二重のループだ。
- 現在のモデル で、各問題について推論と答えを書く。
- 間違えた問題は、正しい答えをヒントとして加え、もう一度書く。
- ステップ 1 で正解したものと、ステップ 2 でヒントのもとで正しい答えを導けたものを残す。
- 元の から始めて、このデータで を微調整し、ステップ 1 に戻る。
これは実は強化学習だ
著者らは、STaR が強化学習の近似とみなせると指摘している。推論 を潜在変数とし、正解なら 1 点、不正解なら 0 点とすると、データセット全体の期待報酬とその勾配は次のようになる。
これは標準的な方策勾配だ。不正解のサンプルは報酬が 0 なので勾配がそのまま消え、STaR の「正解したものだけ残す」と同じになる。正解したサンプルの勾配は普通の対数尤度の勾配で、それを使って教師あり微調整をするのと同じだ。
本物の方策勾配と比べると、STaR は二つの簡略化をしている。一つは、ランダムなサンプリングの代わりに貪欲デコーディングを使って分散を下げることで、代償として探索が少なくなる。もう一つは、同じデータの上で勾配更新を何ステップも行うことだ。rationalization は、別の分布 からのサンプリング、つまりオフポリシーの推定とみなせる。
この導出は当時はついでに触れられた程度だったが、後になって、推論モデルの訓練を理解するための便利な視点になった。
実験設定
- モデル:GPT-J 6B。重みと微調整のコードが公開されていて、ある程度の質の推論を書けるだけの大きさがあるからだ。バッチは長さ 1024 の系列 8 本、学習率は で、TPU v3 のノード一つで訓練とサンプリングを行う。
- 足し算:二つの 桁の数を足す。Nye らの scratchpad 形式に従い、一桁ずつ足していく過程を書く。まず 5 万問を生成し、各回 1 万問を抜き出す。1~5 桁のそれぞれに例が 10 個ある。
- CommonsenseQA:五択の常識問答で、訓練セットは 9,741 問。プロンプトには思考の連鎖の論文の 10 問を使った。著者らはそのうち一問の誤った答えを直し、推論が関連する知識をよりはっきり引用するように手を入れた。
- GSM8K:小学校レベルの数学の文章題で、訓練セット 7,473 問、テストセット 1,319 問。
足し算の推論は原論文 Figure 3 の形式に従い、一の位から一桁ずつ足していく。C は繰り上がりだ。624 + 259 を例にとる。
<scratch>
6 2 4 + 2 5 9 , C: 0
2 + 5 , 3 C: 1
6 + 2 , 8 3 C: 0
, 8 8 3 C: 0
0 8 8 3
</scratch>
8 8 3
各行は、次に足す桁の組、ここまでに積み上がった結果、繰り上がりだ。モデルは <scratch> から最後の答えまでを自分で書けるようにならなければならない。rationalization のときは、正しい答えがプロンプトの「Target:」の後ろに置かれる。
この形式の推論は答えと強く結びついていて、推論の途中で一ステップでも間違えれば、答えもほぼ確実に間違う。この点が後で重要になる。
議論
足し算:一桁ずつ登っていく
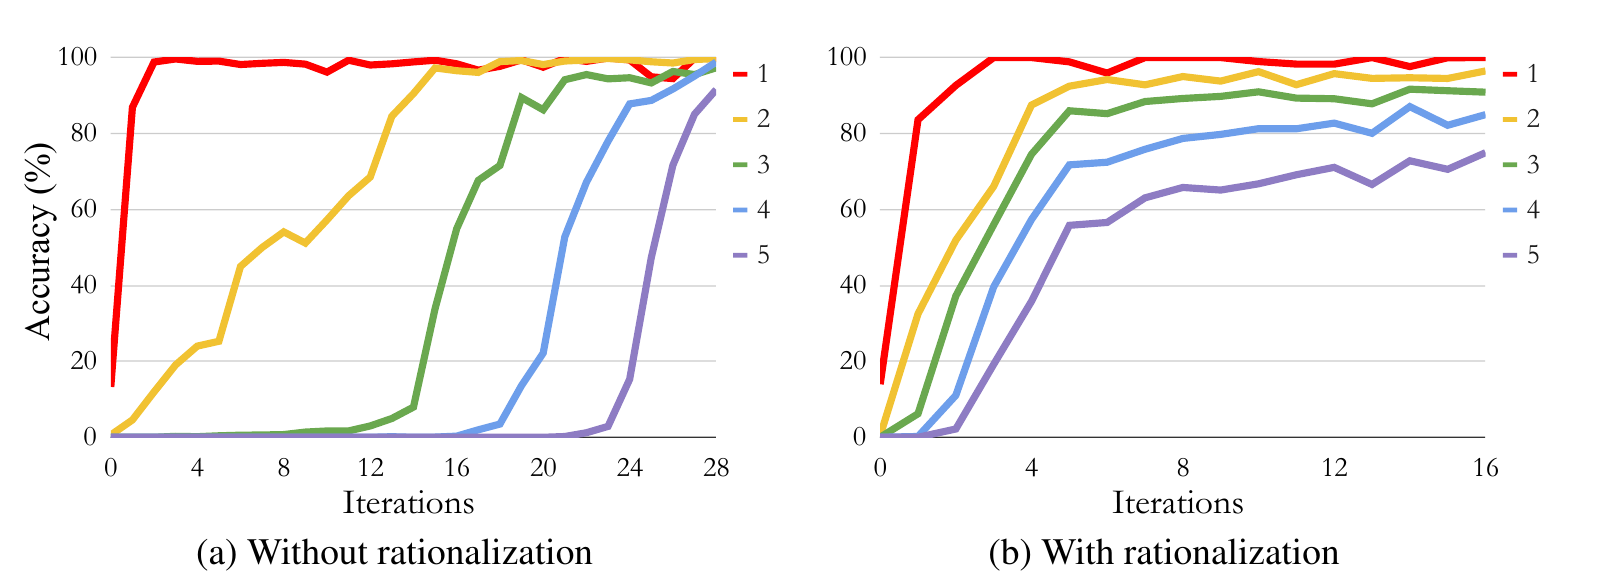
出発点はとても低い。少数ショットのプロンプトでは、GPT-J の 2 桁の足し算の正答率は 1% 未満で、それより桁が多いとほぼ 0 だ。
rationalization なしのとき(左図)、進歩は段階的だ。モデルはまず 桁をものにしてから、ようやく 桁が伸び始め、5 桁は 23 回目あたりまで待たなければならない。これは理にかなっている。正解した問題しか訓練データに入らないので、モデルはまず 桁の問題をたまに何問か正解しないと、学ぶ材料がないのだ。
rationalization を加えると(右図)、どの桁数もほぼいっしょに伸びる。ただし正答率はそれぞれ違う。一回目の微調整の後、2 桁はもう 1% 未満から 32% に跳ね上がった。ヒントがあるので多くの問題が少数ショットの段階で解けてしまうため、この組は 300 ステップから訓練を始め、回ごとに 20 ステップずつ増やした。
論文によると、16 回実行した後の全体の正答率は 89.5% だった。比較のために挙げると、推論を書かずに 1 万問で 5,000 ステップ直接訓練したモデルは 76.3% だ。
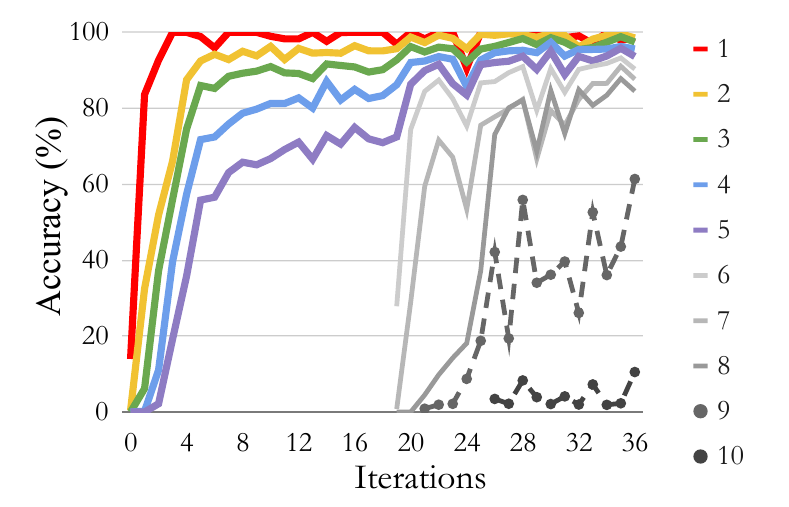
著者らはさらに、20 回目あたりで桁数の多い問題を加えた。訓練の総問題数は変えていない。元の 1~5 桁はむしろ伸びが速くなり、訓練で一度も出てこなかった 9、10 桁も一部は正解できた。代償は訓練が不安定になることで、その原因は著者らにもはっきりわからない。
CommonsenseQA:6B が 175B に追いつく
| 手法 | 正答率 | 使った訓練データ |
|---|---|---|
| GPT-3 175B、答えを出力するよう直接微調整 | 73.0 | 100% |
| GPT-J 少数ショット、直接回答 | 20.9 | 約 0 |
| GPT-J 少数ショットの思考の連鎖 | 36.6 | 約 0 |
| LaMDA 137B 少数ショットの思考の連鎖 | 55.6 | 約 0 |
| GPT-J、答えを出力するよう直接微調整 | 60.0 | 100% |
| STaR(rationalization なし) | 68.8 | 69.7% |
| STaR(rationalization あり) | 72.5 | 86.7% |
原論文 Table 1 をもとに整理。正答率は検証セットでの %。最後の行の 86.7% のうち、78.2% は自分で正解した問題から、8.5% は rationalization から来ている。
この表には、見比べておきたい点がいくつかある。
- GPT-J が自分で書いた推論だけで、全データで直接微調整するより 8.8 ポイント高く、しかも STaR が使ったのは問題の七割だけだ。
- rationalization を加えると 72.5% になり、30 倍近く大きい GPT-3 の微調整の結果 73.0% との差はわずか 0.5 だ。
- 小さいモデルの少数ショットの思考の連鎖は 36.6% しかなかったが、STaR はそれを 35.9 ポイント引き上げ、LaMDA 137B の少数ショットの思考の連鎖も上回った。
五択の問題は当てずっぽうでも 20% は取れる。著者らは、意味の類似度のような単純な経験則だけでも 30% 前後に届くとも述べている。
もう一つわかったのは、微調整のときに少数ショットの例も訓練の系列に入れておくと、成績がはっきり良くなることだ。rationalization なしでは 60.9% から 68.8% に、rationalization ありでは 69.9% から 72.5% になった。
推論の質
推論がうまく書けているかは、足し算なら標準の過程と直接照らし合わせられるが、常識問題は人が読んで判断するしかない。著者らは、少数ショットの思考の連鎖と STaR がどちらも正解した問題から 50 問を無作為に選び、CoS-E にある人間が書いた説明も集めた。20 人のクラウドワーカーがそれぞれ 10 問を見て、三種類の推論を順位づけした。
結果、STaR の推論が少数ショットの推論より上位に置かれる確率は 30% 高く()、人間が書いた説明より上位に置かれる確率は 74% 高かった()。著者らはわざわざ、この結果が示しているのは質の高い説明を人に書いてもらうこと自体の難しさで、モデルが推論を書く力はまだ人間の水準に届いていないと断っている。
ただ、答えが正しくても推論が空っぽなこともある。付録には、答えは正しいのに推論が成り立たない型がいくつも挙げられていて、最もよくあるのは問題文を言い換えて、それを理由にしてしまうものだ。
Q: What might someone get from learning about science?
Answer Choices:
(a) headache
(b) see things differently
(c) increased knowledge
(d) accidents
(e) appreciation of nature
A: The answer must be something that someone would get from learning about
science. Learning about science would increase knowledge. Therefore, the
answer is increased knowledge (c).
原論文の付録 A.1 の例。
「科学を学ぶと知識が増える。だから答えは知識が増えること」。この文は間違ってはいないが、なぜ「appreciation of nature」ではないのかは何も説明していない。ほかの型には、循環論法、理由をまったく書かないもの、それに問題文の人名を実在の人物だと思い込み、「James は高いところにいると興奮する」といった推論を書くものもある。
GSM8K:絶対値は低いが、相対的には倍増
| 手法 | テストセットの正答率 | 使った訓練データ |
|---|---|---|
| GPT-J 少数ショット、直接回答 | 3.0 | 約 0 |
| GPT-J 少数ショットの思考の連鎖 | 3.1 | 約 0 |
| GPT-J、答えを出力するよう直接微調整 | 5.8 | 100% |
| STaR(rationalization なし) | 10.1 | 25.0% |
| STaR(rationalization あり) | 10.7 | 28.7% |
原論文 Table 2 をもとに整理。単位は %。
6B の GPT-J には小学校の算数でもかなり荷が重く、STaR でも 10.7% どまりだが、直接微調整の 5.8% の倍近くになり、しかも使った問題は四分の一ほどだ。ここでは rationalization はほとんど役に立たず、使った 28.7% のデータのうち、rationalization から来たものはわずか 0.5% だった。訓練のステップ数にも上限を設ける必要があった。そうしないと時間がかかりすぎるからだ。最終的には 36 回実行し、さらに rationalization を 10 回加えた。
著者らがモデルと標準解答の計算のステップ数を比べると、一致する割合は 53%~57% だった。一致しないときは、たいていモデルのほうがステップが少ない。ステップを飛ばしていることもあれば、別の解き方を見つけていることもある。付録には、標準解答が 7 ステップを使う問題で、モデルが余計な情報を読み飛ばし、1 ステップで解き終えた例がある。
なぜ何回もサンプリングしないのか
訓練データを増やしたいなら、いちばん直感的なのは温度を上げて何回もサンプリングすることだ。何回かは正解するだろう。著者らも試したが、効果はむしろ悪かった。
温度が高いと、「推論は間違っているのに、答えはたまたま合っている」サンプルが増える。こういうデータで訓練すると、モデルは汎化できることを何も学べない。足し算では特にはっきりしていて、高い温度でサンプリングして学んだ scratchpad はだんだん意味をなさなくなり、モデルは行き詰まる。温度 0.5 や 0.7 の版は、どれも rationalization なしの STaR より悪かった。しかも 10 回サンプリングすると約 10 倍遅く、rationalization よりずっと高くつく。
「たまたま正解」の割合は、問題の型の当たりやすさに大きく左右される。モデルの推論が本当に正しい割合を 、推論が間違っているときにそれでも答えが当たる確率を とすると、「答えが正しい」というフィルタを通ったデータのうち、推論が実は間違っているものの割合は次のとおりだ。
多桁の足し算はまず当てずっぽうでは当たらないので、 は 0 に近く、フィルタはきれいに効く。五択の CommonsenseQA を、ランダムに当てる で見積もると、最初の のときは、残ったデータの約 64% がたまたま当たったものになる。 が 0.6 に上がると約 12% まで下がる。はい・いいえで答える問題なら で、状況はさらに悪い。モデルが強くなるにつれてこの割合は下がるが、データの質は出だしが最も悪く、しかもそこが最も肝心なのだ。
限界
著者らは結論と付録で次の点を挙げている。
- 出発点が弱すぎてはいけない:最初の回を成功させるには、少数ショットの成績が当てずっぽうより高くなければならず、モデルにもともとある程度の推論能力が必要だ。著者らは GPT-2 でも試したが、足し算ですら立ち上がらなかった。
- 当たりやすいタスク:はい・いいえで答える問題のようなタスクでは、ひどい推論がたくさん残る。それをどうふるい落とすかは、まだ答えが出ていない。
- 偏りが増幅される:STaR が増幅するのは「正解できる」推論なので、データセットの偏見が正解に役立つなら、偏見も増幅される。rationalization はさらに、モデルが自分からは出さない偏った答えまで「引き出して」しまう。
- 推論が忠実とは限らない:モデルは先に答えを選んでから理由をでっち上げるかもしれない。そういう推論はモデルが実際に判断した根拠とは無関係で、STaR にはそれを確かめる手段がない。
- ヒントの与え方が自明とは限らない:ここではヒントは正しい答えそのものだが、ほかの状況では、どうヒントを与えるかがそれほど単純とは限らない。
著者らは拡張も一つ提案している。高い温度で推論を複数サンプリングし、答えで投票して、多数決の答えを正解とみなす。こうすれば、答えのない問題まで訓練に使える。
その後
STaR のループは、その後何度も規模を広げられた。2023 年 12 月、Google DeepMind の ReSTEM は同じやり方を PaLM 2 に持ち込み、MATH とプログラミング問題の APPS で試した。サンプリングし、答えの正誤で選別し、微調整する。これを何回か繰り返し、期待値最大化(EM)の観点から導出し直して、人が書いたデータだけで微調整するより良い結果を出した。
著者ら自身も 2024 年 3 月に Quiet-STaR を提案し、「考えてから話す」を事前学習に持ち込んだ。一般的なウェブのテキストで、モデルに各 token の後で短い内部の推論を生成させ、それを使って後に続くテキストを予測させる。OpenWebMath と C4 で事前学習を続けた後、Mistral 7B はタスク向けの微調整なしで、GSM8K が 5.9% から 10.9% に、CommonsenseQA が 36.3% から 47.2% に上がった。
あの方策勾配の導出は、推論モデルで本物の強化学習になった。DeepSeek-R1 の報酬は「答えが正しいか」のようなルールだ。強化学習の後で教師あり微調整のデータを集めるとき、各プロンプトについて複数の回答をサンプリングし、正解したものだけを残して、約 60 万件の推論データを集めた。これは STaR の選別と同じことで、規模が何桁も大きくなっただけだ。
結論
STaR は推論つきの例 10 個と、答えだけがついた問題の束を用意するだけで、GPT-J 6B に数千本の推論を自分で書かせ、それで自分を訓練させた。CommonsenseQA では 72.5% を取り、30 倍近く大きい GPT-3 を直接微調整したものとの差は、わずか 0.5 ポイントだった。
いちばん巧妙なのは rationalization だ。解けない問題では先にモデルに答えを教えて理由を逆算させ、訓練のときにはその答えを隠す。そのおかげで難しい問題も訓練データに入り、足し算ではどの桁数もいっしょに伸びて、一段ずつ待つ必要がなくなった。
弱点もはっきりしていて、選別は答えしか見ていない。答えが当たりやすい型の問題では、残った推論の大半がこじつけかもしれず、論文も最後までこれを解決していない。後の推論モデルは、より大きなモデル、より多くのサンプリング、より厳しい検証で、このループをどんどん大きく回すようになったが、最初の問題はいまもそこに残っている。