原始論文
Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters
- 發表版本
- ICLR 2025會議
- arXiv 首次提交
- arXiv:2408.03314
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformerstesttimecompute2024,
  title = {{Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters}},
  author = {Charlie Snell and Jaehoon Lee and Kelvin Xu and Aviral Kumar},
  year = {2024},
  eprint = {2408.03314},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.03314}
}
人遇到難題,會多想一下。語言模型能不能也這樣,在回答之前多花一點計算,把答案做得更好?
這件事在 2024 年中的證據很混亂。多數決、best-of-N 這類做法確實有效;但也有研究指出,在數學推理這種複雜的任務上,讓模型自己反省、修改答案,效果非常有限,甚至更差。推論時多花的計算到底值不值得、該怎麼花,沒有人系統性地比較過。
UC Berkeley 的 Snell 在 Google DeepMind 實習期間,和 Lee、Xu、Kumar 一起做了這件事。他們想回答兩個問題:給定一筆推論時的計算預算,怎麼花最划算?以及,與其把模型做大,把同樣的計算花在推論上,會不會更好?
定義問題
提議者與驗證者
作者把各種推論時的做法,歸成兩個可以調整的方向:
- 改變提議的分布:讓模型產生更好的答案。一種是用 STaR、ReSTEM 這類方法訓練模型;另一種是在推論時讓模型看著自己之前的答案,一次一次修改。
- 用驗證器挑選:產生很多答案,再用驗證器挑。最基本的是 best-of-N,取樣 N 個完整的答案,挑分數最高的;更進一步是用過程獎勵模型(PRM)替每一步打分,在推理的過程中做樹狀搜尋。
什麼叫「最划算」
作者把「推論時算力的最佳分配策略」定義成:對一道題 、一個計算預算 ,選出讓答對機率最高的那組設定 :
這裡 可以是要不要用搜尋、用哪種搜尋、修改幾次、平行取樣幾個。
每一題都分開最佳化不實際,作者用題目的難度來近似。難度是相對於模型本身定義的:每題取樣 2,048 次,算出單次答對率,再把所有題目切成五個等分,從簡單到困難。在驗證集上找出每個難度等級最好的策略,再套用到測試題上。
這樣定義難度需要知道正確答案,作者稱為 oracle 難度。實際部署時不會有答案,所以另外有一個「模型預測的難度」,改用驗證器對同樣 2,048 個答案的平均分數來分級。作者也承認,估計難度本身就要花不少計算,實驗裡沒有把這部分算進去。
實驗設定
- 資料:MATH,用 Lightman 等人切出的 12,000 題訓練、500 題測試。
- 模型:PaLM 2-S*(Codey)。在 MATH 上有一定的成績、但還沒飽和,適合拿來研究。
- 微調:直接提示現成的模型修改答案或驗證步驟,效果不好,所以兩種能力都另外微調。作者預期未來的模型會在預訓練時就具備這些能力。
解決問題
一、用 PRM 搜尋
訓練 PRM:作者一開始用 Lightman 等人公開的 PRM800K,卻發現用它訓練的 PRM 很容易被鑽漏洞,連最簡單的 best-of-N 都能找到騙過它的答案。他們推測是因為 PRM800K 的解答都是 GPT-4 寫的,和 PaLM 2 的輸出差太多。
改用 Math-Shepherd 的做法,不需要人工標註:從解答的每一步往下用模型寫完幾次,看能走到正確答案的比例,當成這一步的分數。這樣訓練出的 PRM,每一步的預測其實是「從這裡開始,之後能答對的機率」。和只看最終答案的 ORM 比,PRM 一直比較好。
整合分數:一份解答的總分,Lightman 等人用的是各步分數的乘積;這裡改用 PRM 在最後一步的預測,作者發現效果最好。多份解答之間,則用「best-of-N 加權」:把最終答案相同的解答分數加總,選總分最高的答案。
只看最高分的那一份,可能被一個分數偏高的錯誤答案騙走;加權把票數和分數都考慮進去。
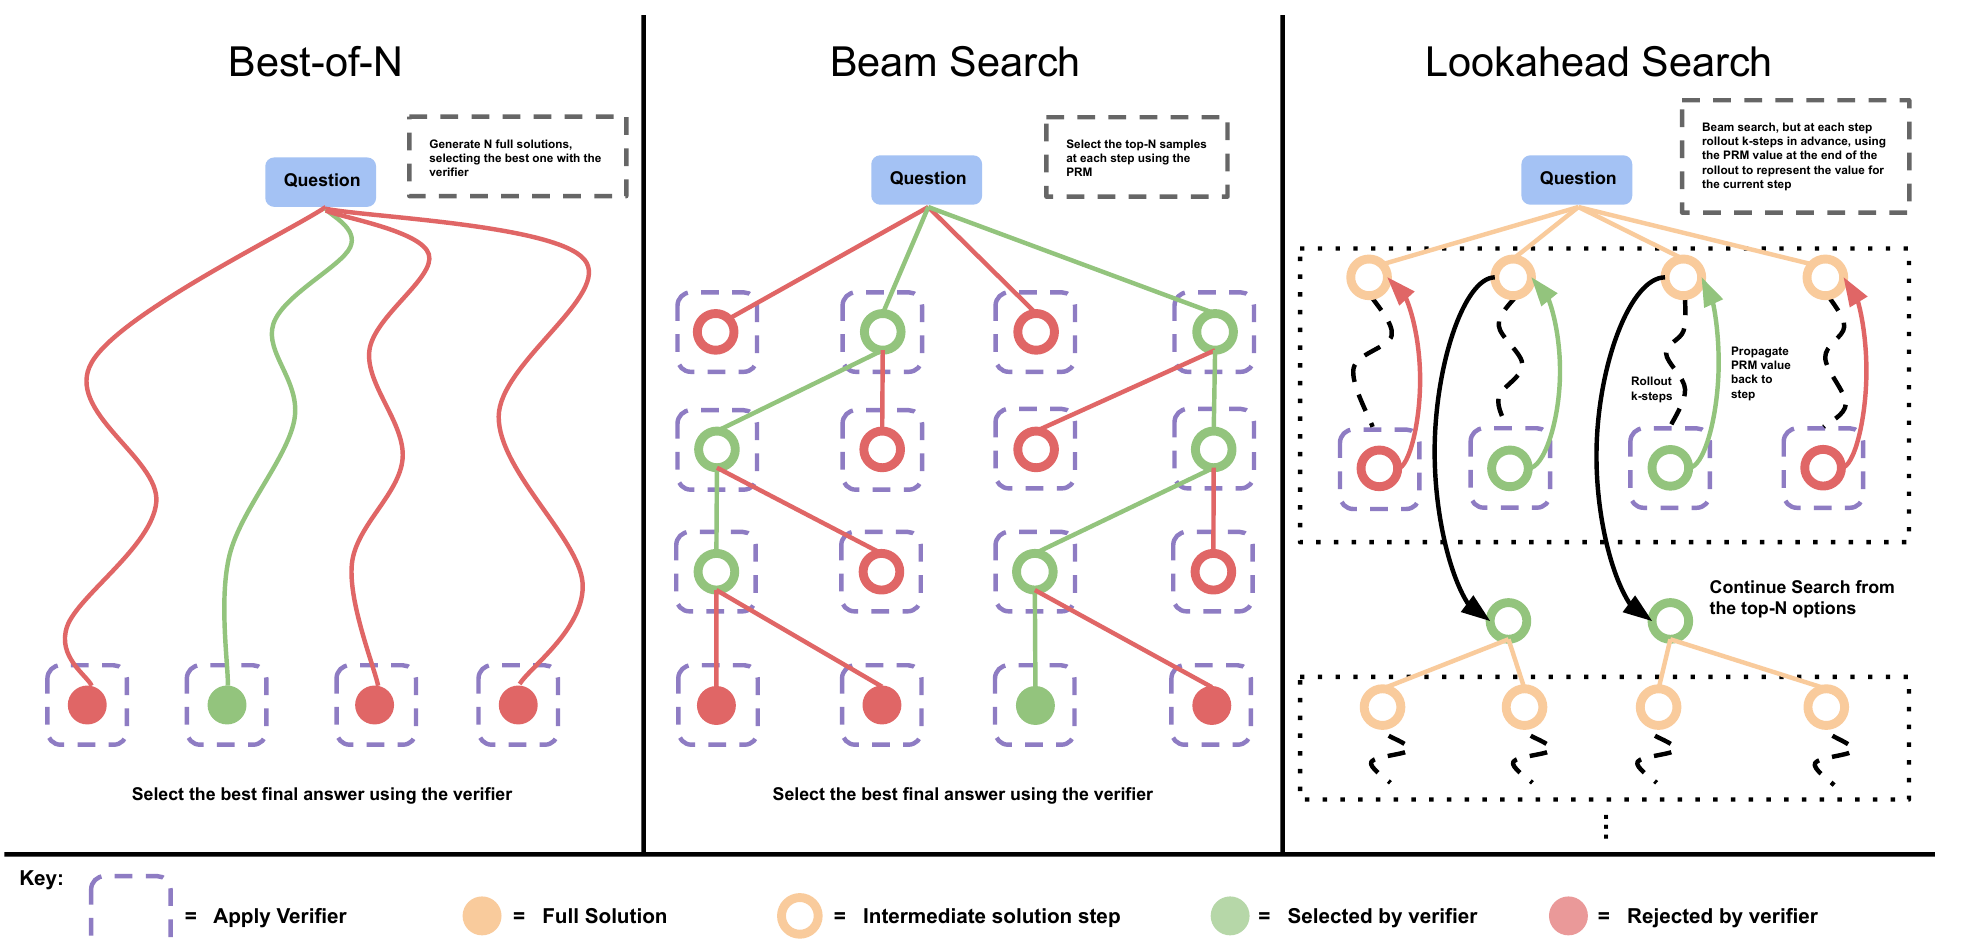
三種搜尋方法:
- best-of-N 加權:獨立取樣 N 個解答,用上面的加權方式挑。
- 束搜尋:維持 N 個候選、束寬 M。每一步先產生 N 個候選步驟,用 PRM 打分,留下最好的 N/M 個,每個再往下展開 M 個,重複到解答結束,最多 40 輪。
- 前瞻搜尋:和束搜尋一樣,但評估每一步時,先用溫度 0 往前推演最多 k 步,用推演終點的 PRM 分數代表這一步。這讓價值估計更準,代價是更多計算,成本算成 個取樣。作者指出,這可以看成拿掉隨機探索的 MCTS,PRM 已經訓練好了,推論時要的是利用而不是探索。
二、讓模型修改自己的答案
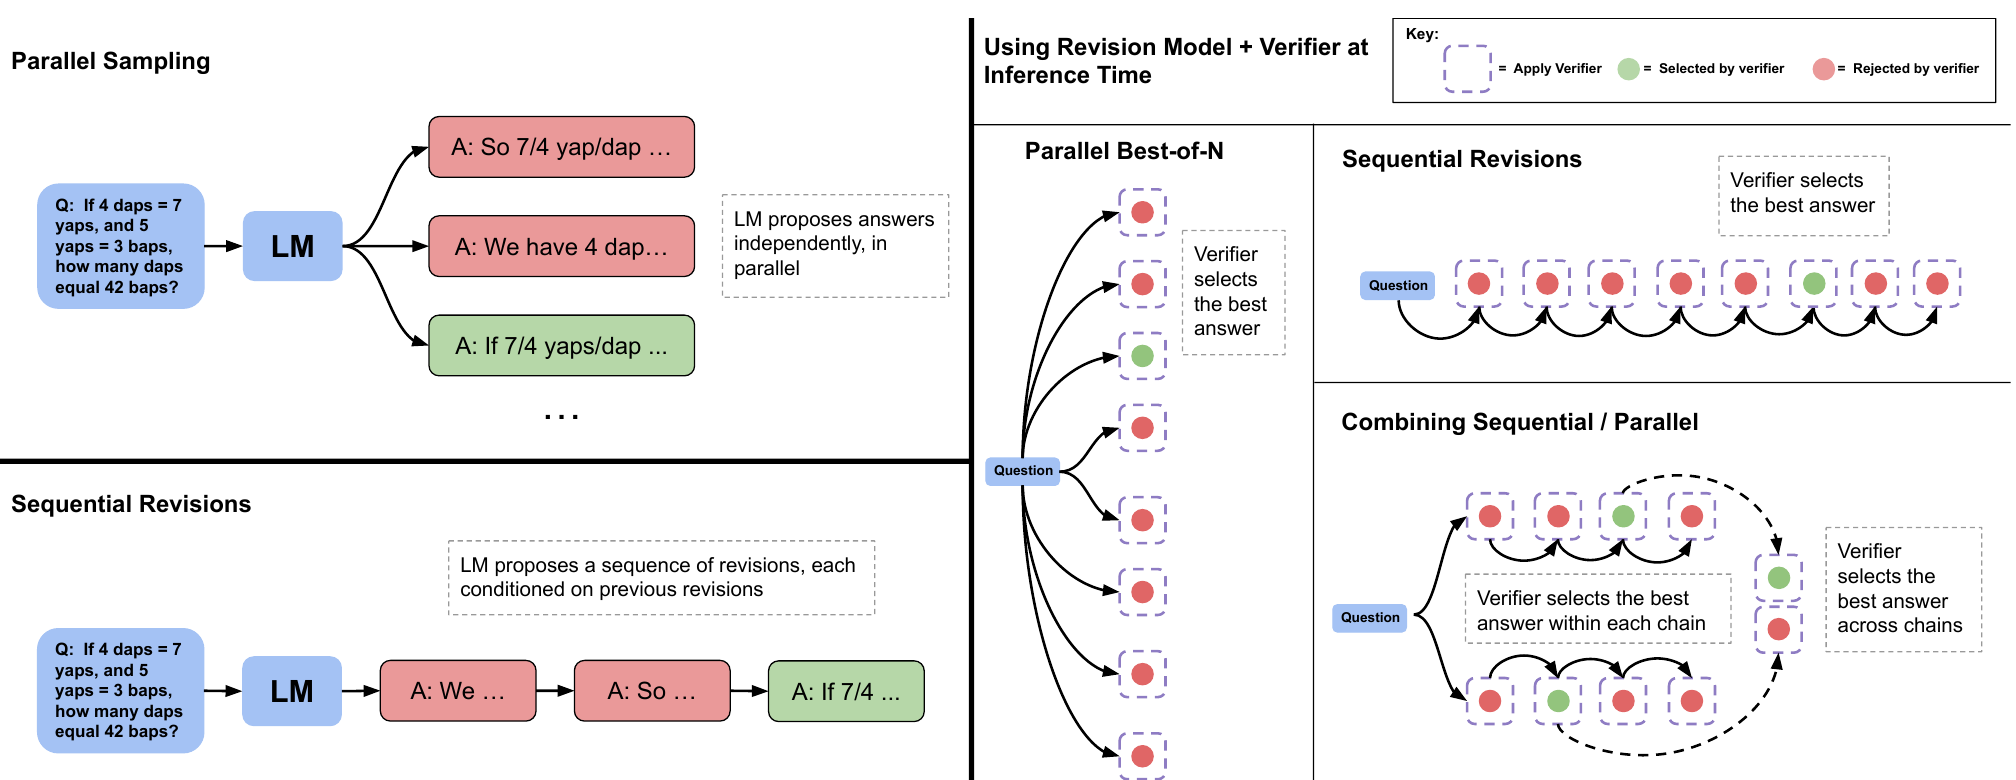
直接請現成的模型改正自己的錯,在推理題上大多沒用,所以作者微調了一個專門修改答案的模型。
訓練資料:理想的訓練資料,是一串錯誤的答案,接著一個正確的答案,而且正確答案最好是從那些錯誤修改而來,而不是從頭重寫。逐輪產生多輪對話太貴,作者改成一次平行取樣 64 個答案,再事後拼成多輪的資料:每個正確答案前面,放 0 到 4 個(隨機決定)錯誤答案。挑錯誤答案時,用字元的編輯距離,優先選和正確答案比較接近的,讓模型學到的是修改而不是重寫。
推論:模型只訓練過前面最多 4 個答案的情況,推論時可以一直修改下去,只保留最近 4 個當上下文。修改的次數越多,單次答對率逐步上升,超過 4 次之後也還在進步。
但有一個副作用。訓練時,前面的答案全都是錯的;推論時,前面可能已經有正確的答案,模型還是照樣「修改」。大約 38% 的正確答案,在下一次修改後變成錯的。所以最後不能直接取最後一個答案,要用多數決或驗證器,從整條修改鏈裡挑一個。
討論
搜尋:預算少時有用,題目太簡單反而有害
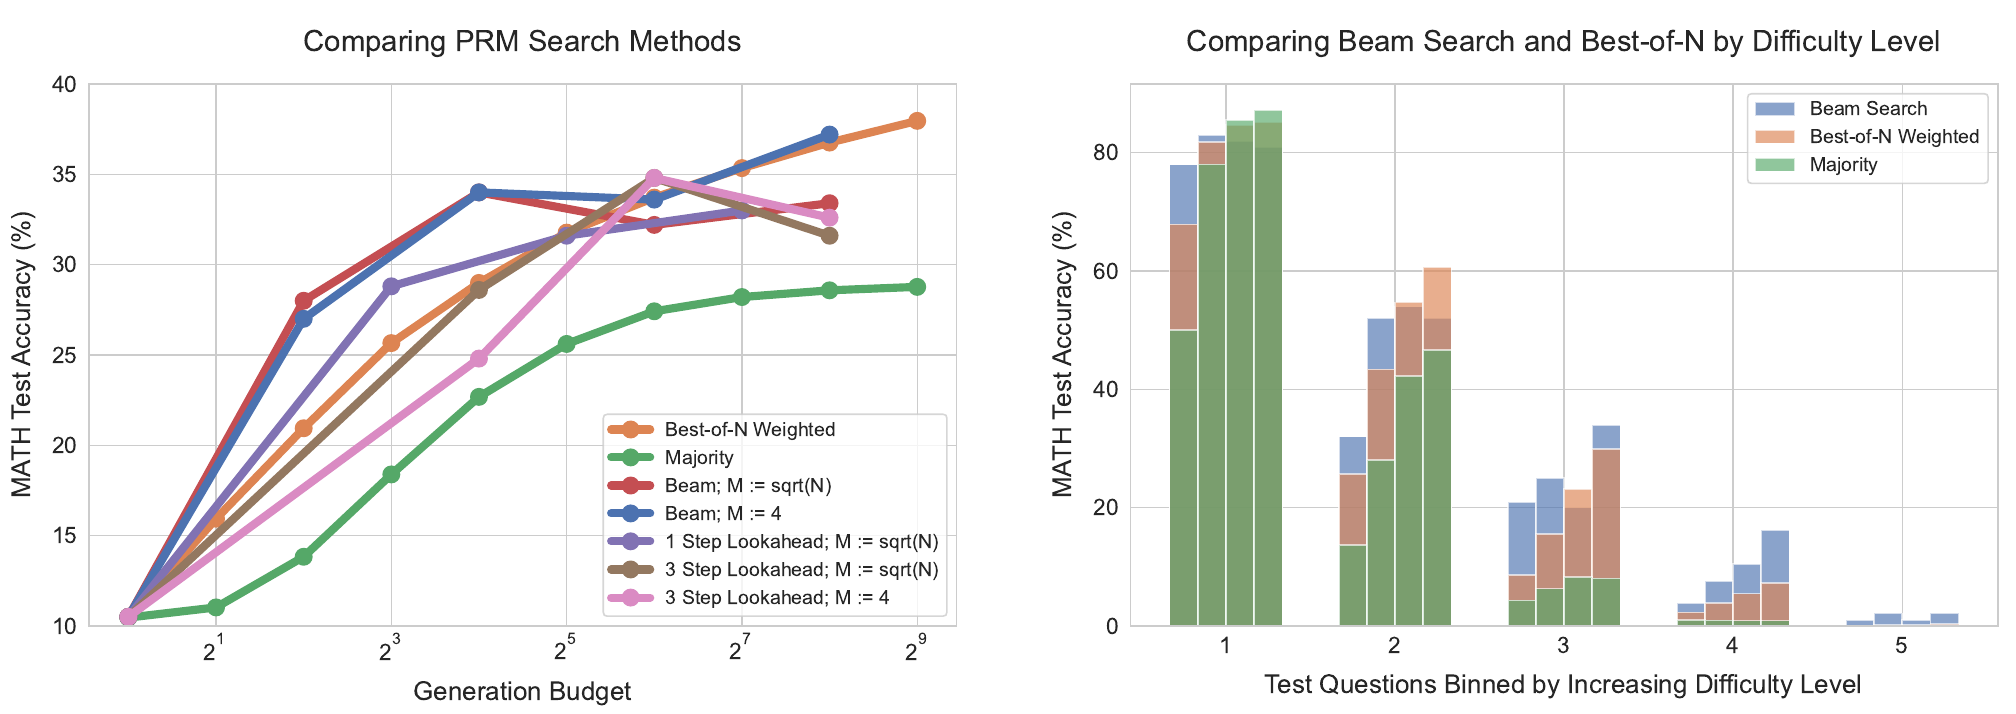
預算小的時候,束搜尋明顯勝過 best-of-N;預算一大,優勢就消失了,束搜尋常常還輸給 best-of-N。前瞻搜尋在相同預算下大多更差。
作者認為原因是 PRM 被鑽了漏洞。搜尋越強,越容易找到 PRM 打分很高、實際上沒用的解答,例如在結尾重複一些沒資訊的步驟,或者短到只有一兩步。最強的搜尋方法,反而表現最差。
按難度拆開看,趨勢完全不同:
- 簡單的題目:模型本來就容易寫出正確答案,驗證器大多也判斷正確。再用束搜尋強力最佳化,只會放大驗證器學到的錯誤特徵,預算越多越差。
- 中等的題目:模型不太容易一次寫對,搜尋可以引導它找到正確答案,束搜尋一直勝過 best-of-N。
- 最難的題目:什麼方法都沒有明顯進步。
依難度選擇最好的搜尋方式,在預算較少時,用 16 次取樣就能接近 best-of-N 用 64 次的成績,也就是省下將近 4 倍的計算。
修改:簡單題一路改下去,難題要多開幾條路
在相同的取樣數下,循序修改略勝於平行取樣。但兩者擅長的不同:平行取樣比較像全域搜尋,可以嘗試完全不同的解法;循序修改比較像局部修正,適合已經大致走對方向的答案。
所以作者讓一部分預算給平行、一部分給循序,掃過不同的比例。在每個預算下都有一個最好的比例,而且這個比例和難度有關:簡單的題目全部拿去循序修改最好;難的題目,平行和循序要取得平衡。
依難度選比例,可以用 64 次取樣,超過 best-of-N 用 256 次的成績,同樣是省下 4 倍。
推論算力能不能取代把模型做大
最後一個問題:同樣的 FLOPs,拿去把模型做大,還是給小模型在推論時多算幾次?
作者用常見的近似:預訓練的計算量是 ,推論是 ,其中 是參數量。模型的參數放大 倍,預訓練和推論的計算都變成 倍。如果改把這些計算給小模型推論,推論量可以乘上:
能多算幾倍,取決於推論的 token 數和預訓練的 token 數之比 。和大約 14 倍大的模型()比較,作者試了 為 0.16、0.79、22 三種情況。推論的量很少時(例如自我改進的訓練流程),省下的預訓練計算很多,同樣的 FLOPs 讓小模型的推論量可以多用約 258 倍;推論和預訓練的量相當時約 63 倍;推論的量遠大於預訓練時(例如大規模上線服務),就只剩約 16 倍。
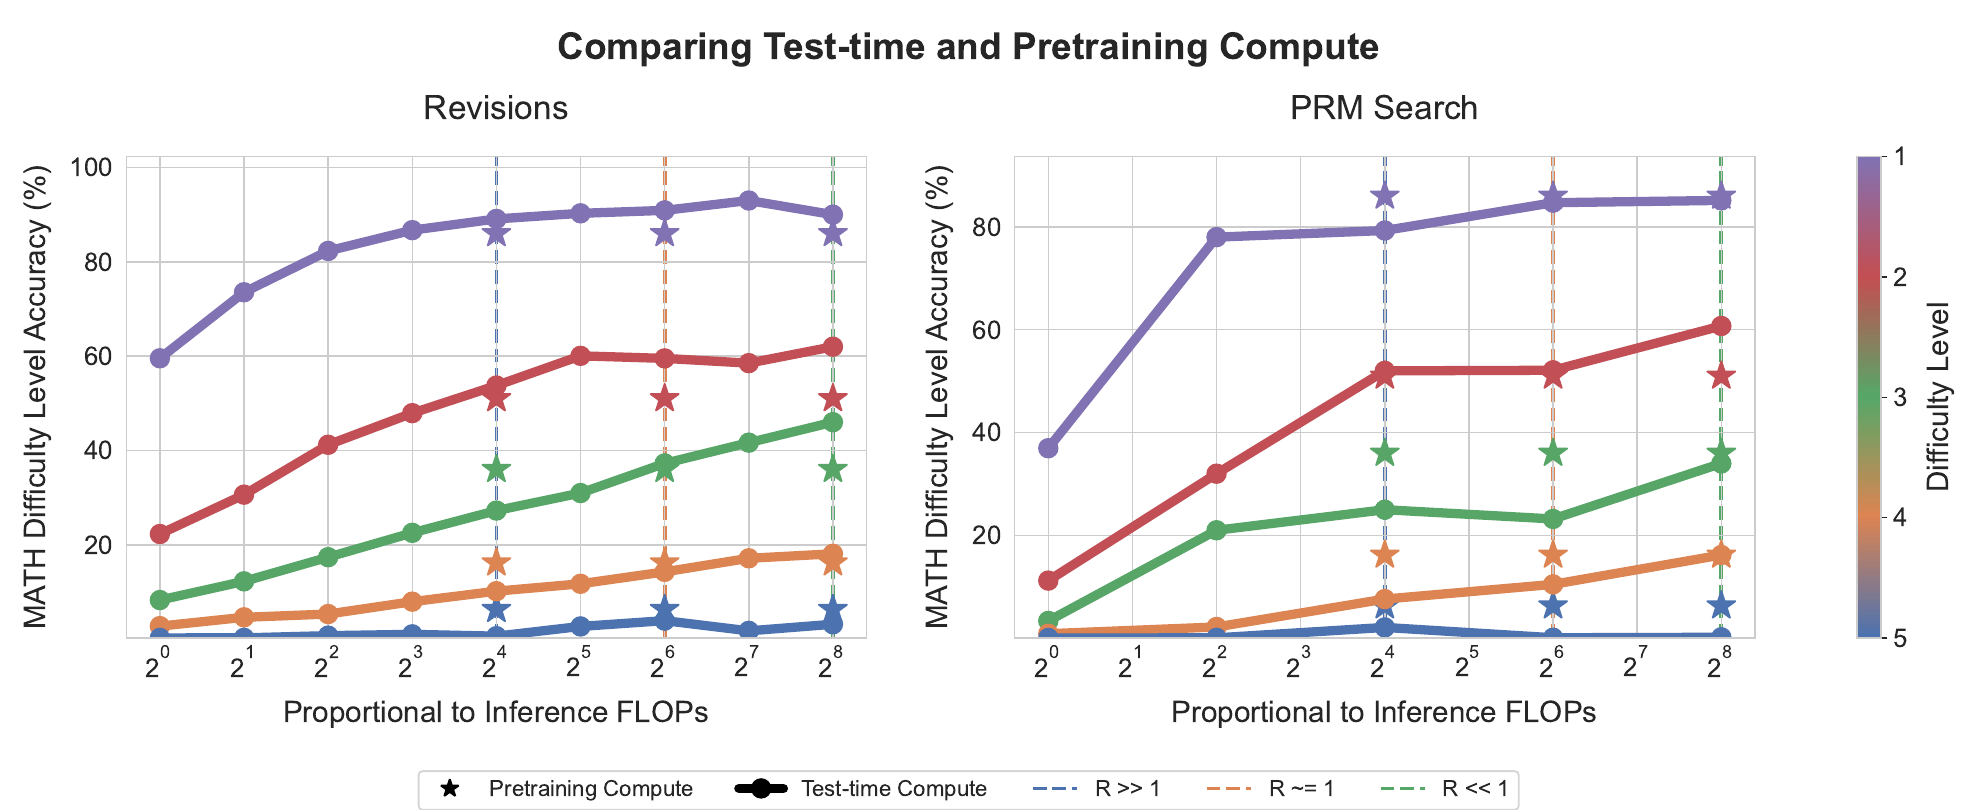
結論是兩者不能一比一互換。簡單和中等的題目,或推論需求不大的情境,把計算花在推論上,常常比把模型做大 14 倍更好;很難的題目,或推論需求很大的情境,還是把模型做大比較有效。
限制
- 估計難度很貴:每題要取樣 2,048 次才能分級,這部分計算沒有算進實驗裡。作者建議未來讓模型直接預測題目的難度,或在估計難度和解題之間動態切換。
- 最難的題目沒有進步:不管是搜尋還是修改,在最難的等級上都幫不上忙。
- 沒有把方法組合起來:修改搭配了驗證器,但沒有和 PRM 的樹狀搜尋一起用。
- 只在一個設定上測:只有 MATH 和 PaLM 2-S*,而且修改和驗證的能力都要另外微調。
作者也提到,未來可以把推論時多花計算得到的答案蒸餾回模型本身,形成一個持續自我改進的迴圈。
後來的事
這篇論文上 arXiv 一個月後,2024 年 9 月 12 日,OpenAI 發表了 o1。o1 用強化學習訓練,在回答前寫出很長的內部思維鏈;OpenAI 的文章寫道,o1 的表現會隨著訓練時的計算(強化學習)和推論時的計算(思考的時間)穩定提升。這篇論文比較的「循序修改」,在 o1 身上變成了同一條思維鏈裡的自我檢查和修正,不需要另外微調一個修改模型。
DeepSeek-R1 也走了類似的路,而且明確記錄了 PRM 和 MCTS 在他們手上沒有成功。
依難度分配推論算力的想法,則被推到了更極端的地方。2025 年 2 月的 Can 1B LLM Surpass 405B LLM? 報告,用最佳的推論時策略,1B 的模型在 MATH-500 上可以超過 405B 的模型,0.5B 的模型在 MATH-500 和 AIME24 上可以超過 GPT-4o;他們也同樣發現,最好的策略取決於使用的模型、PRM 和題目的難度。
至於怎麼用最少的訓練,讓模型自己在一條思維鏈裡延長思考,可以看 s1。
結論
推論時的算力怎麼花,沒有一種萬用的做法。簡單的題目,該讓模型修改自己的答案,強力搜尋反而會放大驗證器的錯;中等的題目,搜尋最有效;最難的題目,目前的方法都幫不上忙。依難度分配,最多可以省下 4 倍的計算。
和把模型做大 14 倍相比,在簡單和中等的題目上,把同樣的計算花在推論上常常更好,難題則還是要靠更大的模型。推論和預訓練的算力,不能一比一地互換。
作者在引言裡寫道,這暗示了一個未來:預訓練少花一點,推論多花一點。一個月後 o1 發表,推論時的計算成了大家比拚的重點,只是走的路比這篇論文想的還要直接,不靠外掛的搜尋和驗證器,而是讓模型自己學會多想一會兒。