原論文
Self-Consistency Improves Chain of Thought Reasoning in Language Models
- 発表先
- ICLR 2023国際会議
- arXiv への初回投稿
- arXiv:2203.11171
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformersselfconsistency2022,
  title = {{Self-Consistency Improves Chain of Thought Reasoning in Language Models}},
  author = {Xuezhi Wang and Jason Wei and Dale Schuurmans and Quoc Le and Ed Chi and Sharan Narang and Aakanksha Chowdhery and Denny Zhou},
  year = {2022},
  eprint = {2203.11171},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.11171}
}
2022 年 1 月、Google の Wei らが思考の連鎖プロンプトを発表した。モデルに推論のステップを先に書かせてから答えさせると、数学の文章題の成績が大きく伸びる、というものだ。
ただ、あの論文のデコーディングはかなり保守的だった。推論問題は答えが一つに決まっているので、貪欲デコーディングを使うのが普通で、毎ステップで確率が最も高い token を選び、最後に得られる推論は一本だけになる。その途中で一ステップでも計算を間違えれば答えも間違いで、挽回の機会はない。
二か月後、同じチームの Wang らは発想を変えた。同じ問題をモデルに何度か解かせ、毎回違う道筋をたどらせて、最後にいちばん多く出てきた答えを採る。
問題の定義
人が問題を解くとき、いくつもの考え方が同じ答えにたどり着くことはよくある。著者らの仮説は、複雑な推論問題でもそうだというものだ。正しい推論は書き方が違っても最後の答えが一致し、誤った推論はそれぞれ別々に間違えるので、答えがばらつきやすい。
この仮説が成り立つなら、どの推論が正しいかを知る必要はない。答えが「かぶっている」かどうかを見ればよい。
それまで、複数の候補の答えから良いものを選ぶには、たいてい別のモデルを訓練する必要があった。Cobbe らは GSM8K で検証器を訓練して解答を順位づけし、LaMDA は追加の人手アノテーションを集めて再順位づけのモデルを訓練した。この論文が目指したのは、訓練なし、アノテーションの追加なし、別のモデルもなしで、既製の言語モデルをそのまま使うことだ。
問題を解く
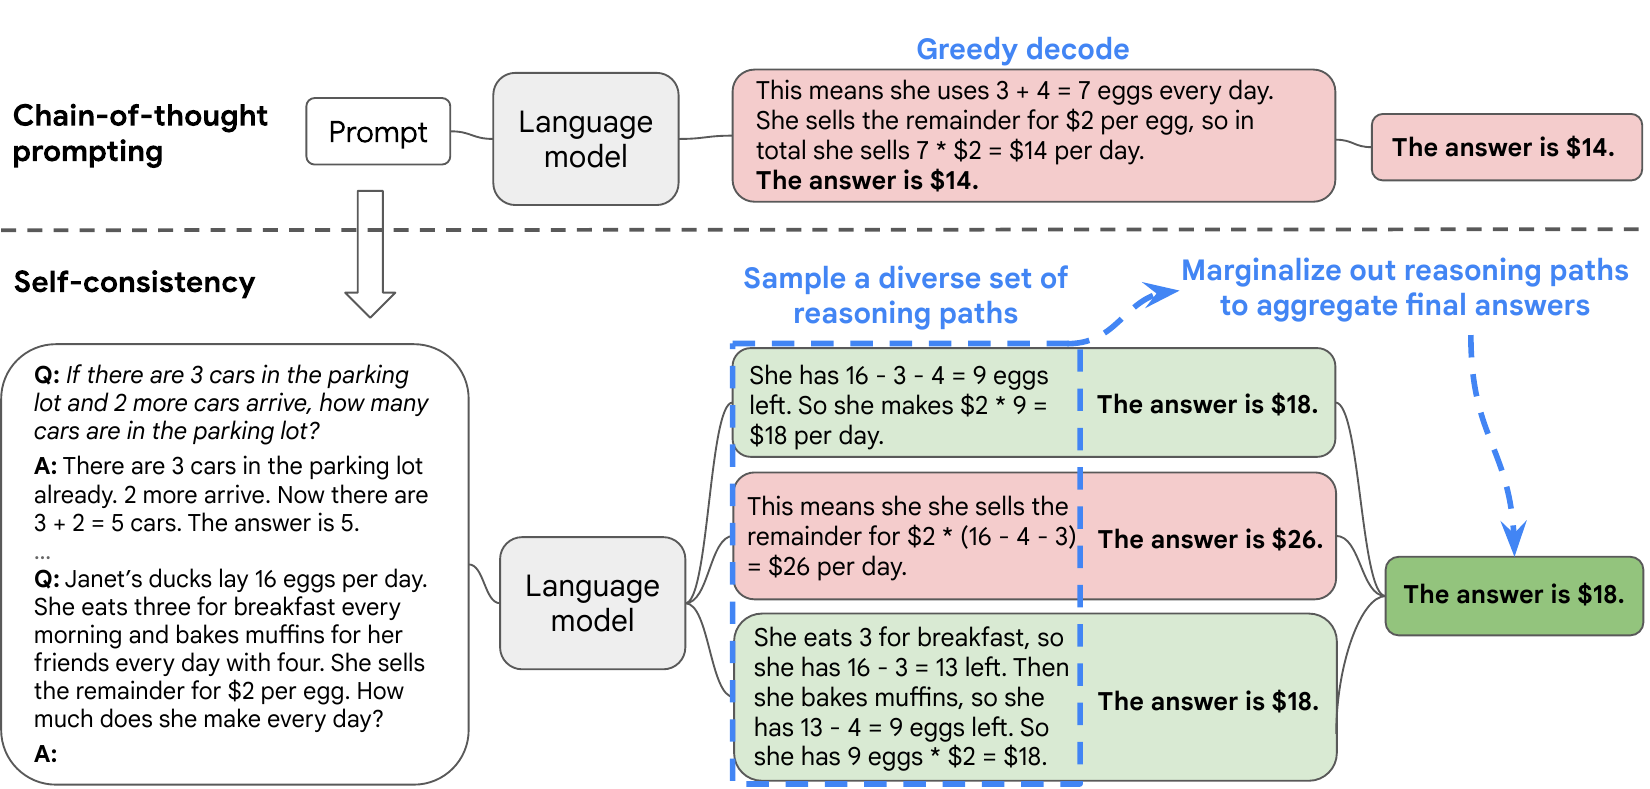
手法は三ステップしかない。
- 従来どおり、手書きの思考の連鎖の例をプロンプトにする。
- 貪欲デコーディングは使わず、モデルのデコーダから 本の出力をサンプリングする。各出力には推論と答えが一つずつ含まれる。
- 各出力の最後にある「The answer is」の後ろの答えを取り出し、最も多く出てきたものを選ぶ。
図の例は GSM8K の一問だ。Janet のアヒルは毎日卵を 16 個産む。朝食に 3 個食べ、マフィンを焼くのに 4 個使い、残りを 1 個 2 ドルで売る。一日にいくら稼ぐか? 貪欲デコーディングは、食べた卵と使った卵を足して 7 個としたのに、16 個から引かずにそのまま 7 に 2 を掛け、14 ドルと答えた。サンプリングした三本の推論のうち、二本は別々の書き方でどちらも 18 ドルを出し、一本は計算を誤って 26 ドルになった。投票の結果は 18 だ。
なぜ「周辺化」と呼ぶのか
著者らは 本目の出力を推論 と答え に分ける。本当に知りたいのは答えだけで、推論は途中の産物にすぎない。だから推論のほうはすべて足し合わせて消してしまい、答えごとに何票集まったかだけを見る。
つまり多数決だ。名前はいかにも学術的だが、やっていることは票を数えるだけである。
確率で重みをつけるべきか
各出力にはモデルがつけた確率があるのだから、確率の高い推論に多めに票を与えることもできる。著者らは重みのつけ方をいくつか試した。そのうち「正規化」とは、出力全体の対数確率を token 数で割ることで、長い推論が確率を多く掛け合わせるせいで不利になるのを防ぐ。
PaLM 540B での結果は次のとおりだ。
| 投票の方式 | GSM8K | MultiArith | AQuA | SVAMP |
|---|---|---|---|---|
| 貪欲デコーディング | 56.5 | 94.7 | 35.8 | 79.0 |
| 重みつき平均(正規化なし) | 56.3 | 90.5 | 35.8 | 73.0 |
| 重みつき平均(正規化あり) | 22.1 | 59.7 | 15.7 | 40.5 |
| 重みつき総和(正規化なし) | 59.9 | 92.2 | 38.2 | 76.2 |
| 重みつき総和(正規化あり) | 74.1 | 99.3 | 48.0 | 86.8 |
| 重みなし(多数決) | 74.4 | 99.3 | 48.3 | 86.6 |
原論文 Table 1 をもとに整理し、算術の四つのデータセットを抜粋。単位は %。
正規化した重みつき総和は、単純に票を数えるのとほとんど同じだった。著者らが調べたところ、正規化した後の各推論の確率はどれもかなり近く、モデルはそれらを「どれも同じくらいありそう」とみなしていた。言い換えると、モデルは自分のどの推論が正しいのかをうまく見分けられない。先行研究が別に順位づけのモデルを訓練しなければならなかったのも、そのためだ。重みをつけても役に立たないなら、素直に票を数えればよい。
一方の「重みつき平均」は、各答えの重みつき総和をさらに票数で割るもので、票の多さを無視するのと同じになり、結果は大きく悪化する。
この手法には前提が一つある。二つの答えが同じかどうかを判定できるように、答えが決まった集合から来なければならない。数学の問題なら数値を、選択問題なら選択肢を取り出せばよいので問題ない。自由形式の生成ではそうはいかず、二つの文章が「一致する」とは何かを別に定義する必要がある。
実験設定
- タスク:算術推論は AddSub、MultiArith、ASDiv、AQuA、GSM8K、SVAMP。常識推論は CommonsenseQA、StrategyQA、ARC。記号推論は文字の連結とコインの裏返しで、例では二単語や二回の裏返しだけを示し、テストでは四つに増やして出す。
- モデル:UL2 20B、GPT-3 175B(Codex 系列の code-davinci-001 と 002 を使用)、LaMDA 137B、PaLM 540B。すべてプロンプトだけで使い、微調整は一切しない。
- プロンプト:思考の連鎖の論文と同じで、算術問題は同じ 8 個の手書きの例を共有する。
- サンプリング:UL2 と LaMDA は温度 0.5、top-k 40。PaLM は温度 0.7、top-k 40。GPT-3 は温度 0.7 で切り捨てなし。毎回 40 本をサンプリングし、10 回繰り返して平均を取る。
議論
どのモデルも伸びる
| モデル | GSM8K | SVAMP | AQuA |
|---|---|---|---|
| UL2 20B | 4.1 → 7.3 | 12.6 → 19.4 | 23.6 → 26.9 |
| LaMDA 137B | 17.1 → 27.7 | 38.9 → 53.3 | 17.7 → 26.8 |
| PaLM 540B | 56.5 → 74.4 | 79.0 → 86.6 | 35.8 → 48.3 |
| code-davinci-001 | 14.6 → 23.4 | 39.8 → 54.5 | 18.9 → 25.6 |
| code-davinci-002 | 60.1 → 78.0 | 75.8 → 86.8 | 39.8 → 52.0 |
原論文 Table 2 をもとに整理。矢印の左は思考の連鎖と貪欲デコーディング、右は self-consistency で、単位は %。
四つのモデル、すべての算術タスクで改善があり、しかもモデルが大きいほど、たいてい改善も大きい。UL2 20B は 3~7 ポイント、LaMDA 137B と code-davinci-001 はおおむね 7~24 ポイントの範囲で伸びた。もともと強い PaLM 540B と code-davinci-002 でも、GSM8K は 17.9 ポイント伸びた。code-davinci-002 の 78.0% は、GPT-3 を微調整して検証器を加えた当時の方法の 55% を上回る。しかも self-consistency は一切訓練していない。
常識推論の改善は小さめで、code-davinci-002 では StrategyQA が 6.4 ポイント、ARC-challenge が 3.9 ポイントの増加だった。記号推論は例より長い問題でテストしていて、モデルが十分に大きければやはり効果がある。ただし UL2 20B の文字の連結はもともと 0.0% で、投票しても 0.0% のままだった。モデルがまったく解けない問題では、何回サンプリングしても誤答を多く集めるだけだ。
サンプリングは多いほど良いが、すぐに頭打ちになる
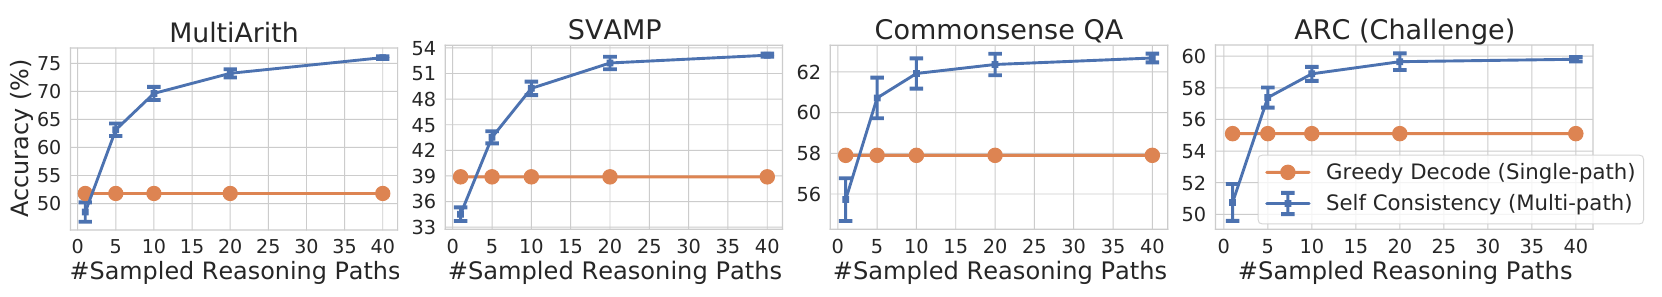
各図のいちばん左の点に注目してほしい。1 本だけサンプリングしたときの正答率は、貪欲デコーディングより悪い。ランダムなサンプリングは、もともと最も確率の高い token を選ぶより間違えやすいからだ。サンプリングした推論は一本だけだと質が劣り、本数と投票の力で逆転している。
曲線は 5~10 本の時点で改善の大部分を得ていて、著者らも結論で、実務では 5 本か 10 本から始めることを勧めている。
投票はなぜ効くのか
著者らの仮説では、正しい推論は書き方がばらばらでも最後は同じ答えに落ち着き、誤った推論はそれぞれ別々に間違えるので、答えが多くの異なる値に散らばる。だから正しい答えが四割の票しか取れなくても、残りの六割がいくつもの誤った値に分散していれば、正しい答えがやはり最大のグループになる。サンプリングが多いほど、多数決は安定する。
裏返せば、この仮説は投票が効く範囲の境界も示している。モデルに系統的な誤り、たとえばいつも一ステップ引き忘れる癖があれば、誤った答えは同じ値に集中する。正答率が 40% で、残りの六割のうち八割が同じ値に間違えるとき、その誤答は 48% の票を取り、正しい答えより多くなる。サンプリングを増やすほど、かえって確実に間違ったほうを選ぶ。self-consistency が勝てるのは、「誤りがそれぞれ別々」だからだ。
他の方法との比較
サンプリングしてから順位づけ:同じく複数本をサンプリングし、各本の対数確率で順位をつけて、一位の答えを採る。code-davinci-001 では、これも本数とともに改善するが、伸びは投票よりずっと小さい。前に見た「モデルはどの推論が良いかを見分けられない」という観察と一致する。
ビームサーチ:UL2 20B の AQuA では、ビームサーチの最上位を採ると、ビームが広いほどかえって悪くなり、23.6% から 40 ビームでは 10.2% に落ちた。ビームサーチで 40 本の推論を作って投票すると 24.2%、サンプリングして投票すると 26.9%。ビームサーチが作る候補は互いに似すぎている。投票に必要なのは多様性だ。
アンサンブル:LaMDA 137B の GSM8K で、二種類のプロンプトのアンサンブルと比べた。
| 手法 | GSM8K |
|---|---|
| 思考の連鎖(貪欲デコーディング) | 17.1 |
| 異なる手書きのプロンプト 3 組で、それぞれ貪欲デコーディングしてから投票 | 18.6 |
| 例の順序を 40 回入れ替え、それぞれ貪欲デコーディングしてから投票 | 19.2 |
| Self-consistency(40 本をサンプリング) | 27.7 |
原論文 Table 7 をもとに整理。単位は %。
プロンプトや順序を変えて得られる変化は、モデル自身にいくつもの道を歩かせることには遠く及ばない。付録では複数のモデルでいっしょに投票することも試していて、PaLM 540B に LaMDA 137B を加えると 36.9% にしかならず、PaLM 単独の self-consistency の 74.4% よりずっと悪い。弱いモデルが強いモデルの足を引っ張るのだ。
思考の連鎖でかえって悪くなるタスク
Ye と Durrett は、一般的な NLP タスクの中に、思考の連鎖を加えるとかえって成績が下がるものがあることを見つけた。著者らは PaLM 540B でいくつか試している。
| 手法 | ANLI R1 | e-SNLI | RTE | BoolQ |
|---|---|---|---|---|
| 標準のプロンプト(推論を書かない) | 69.1 | 85.8 | 84.8 | 71.3 |
| 思考の連鎖プロンプト | 68.8 | 81.0 | 79.1 | 74.2 |
| Self-consistency | 78.5 | 88.4 | 86.3 | 78.4 |
原論文 Table 5 をもとに整理し、一部の列を抜粋。単位は %。
e-SNLI と RTE は、思考の連鎖を加えるとどちらも 5 ポイントほど落ちた。self-consistency はそれを取り戻し、推論を書かない標準のプロンプトさえ上回った。
設定をあまり選ばない
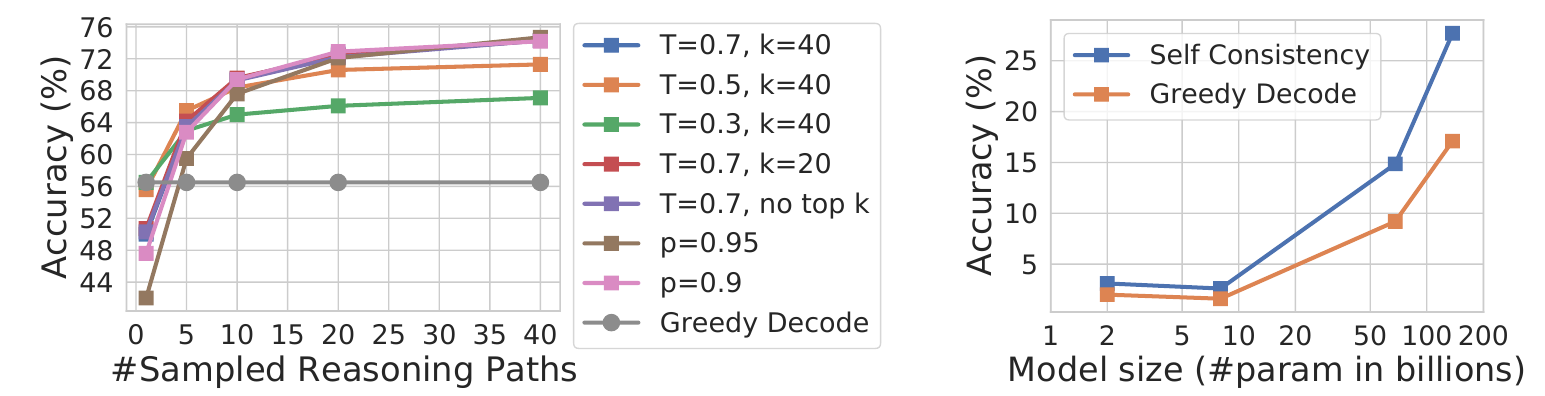
左図では、温度、top-k、nucleus サンプリングのどの設定も、40 本の時点で貪欲デコーディングを大きく上回る。右図からは、小さいモデルでは改善が限られることがわかる。著者らの説明では、算術のような能力はある程度の規模になってはじめて現れるので、モデルがまだ計算できないうちは、投票しても助けにならない。
著者らはストレステストもいくつか行っていて、どれも GSM8K で試している。
- 例が間違っている:プロンプトの例の推論過程に出てくる数字をランダムに置き換えた(最終的な答えだけはそのまま)。LaMDA 137B の貪欲デコーディングは 17.1% から 14.9% に下がり、self-consistency を加えると 23.4% に戻った。
- 式だけを書く:推論に「3 + 2 = 5」のような式だけを書かせると、self-consistency は 5.0% から 6.5% と、伸びはごくわずかだった。式は短すぎて変化の余地が少なく、多様性が足りない。
- ゼロショットの思考の連鎖:例を与えず、「Let's think step by step」の一文だけを加える。PaLM 540B は 43.0% から 69.2% に上がり、26.2 ポイントの増加になった。
- 別のプロンプトに替える:付録では別に二組の例を書いていて、PaLM 540B の改善はそれぞれ 17.5 ポイントと 16.4 ポイント。主実験の 17.9 とほぼ同じだ。
一致の度合いは確信度として使える
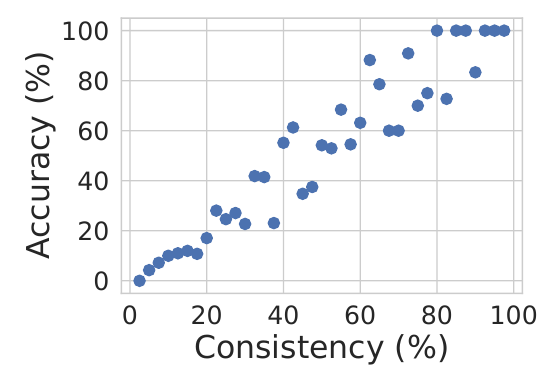
投票は答えだけでなく、票数も教えてくれる。40 本の推論のうち 35 本が同意しているのと、12 本しか同意していないのとでは、信頼できる度合いが明らかに違う。著者らは、一致の割合と正答率が強く相関することを見つけた。だから一致の度合いが低い問題は、モデルが「自分でも自信がない」という合図として使える。
限界
著者ら自身が三つの限界を挙げている。
- コスト:40 本サンプリングすれば、推論の計算は 40 倍になる。だからまず 5~10 本で試すことを勧めている。
- 答えが決まっている場合だけ:答えが同じかどうかを判定できなければならない。
- 推論が正しいとは限らない:投票で答えが当たっても、推論過程はでたらめかもしれない。表に載っている StrategyQA の例では、モデルは二つの Albany の人口を比べて答えているが、どちらの人口の数字もあまり正確ではない。
著者らは将来の方向も一つ示している。self-consistency でより良いデータを作ってモデルを微調整し、一回の推論で正解できるようにすることだ。同じ月、Zelikman らの STaR がまさに似たことをしていた。正解した問題の推論過程を使って、モデルを訓練し直すのだ。
その後
多数決はすぐに推論の評価の標準装備になった。論文の表でよく見る maj@k や cons@64 は、k 本や 64 本をサンプリングしてから投票したことを指す。DeepSeek-R1-Zero は AIME 2024 で、一回ずつ解いたときの平均が 71.0%、64 本の投票では 86.7% だった。
「一致の度合いを確信度にする」という点も実際に使われた。2023 年 12 月の Gemini のテクニカルレポートで、Gemini Ultra は MMLU で 90.04% を取った。使ったのは、彼らが uncertainty-routed chain-of-thought と呼ぶ方法だ。まず 32 本の思考の連鎖をサンプリングし、一致の度合いがしきい値を超えれば多数決の答えを採用し、超えなければ推論を書かない貪欲デコーディングに戻る。貪欲デコーディングだけなら 84.0%、32 本の投票だけなら 85.0% で、両者を組み合わせてはじめて 90.0% に届いた。
答えが決まっていなければならないという制約を外そうとした研究もある。2023 年 11 月、同じチームの Chen らは Universal Self-Consistency を提案した。答えを自分で照合するのをやめ、すべての候補の回答を言語モデルに渡して、ほかの回答と最も一致するものを選んでもらう。そのため、要約やコードのように標準的な答えがない生成にも使える。
さらにその先では、問いが「推論時に余分に使う計算資源を、どう配分するのが最も効率的か」に変わった。投票は最も単純な方法で、ほかにも検証器で答えを選ぶ方法や、推論の各ステップで探索を広げる方法がある。
結論
Self-consistency は訓練も別のモデルも要らない。貪欲デコーディングを 40 本のサンプリングと票の集計に替えるだけで、PaLM 540B と code-davinci-002 は GSM8K で 17.9 ポイント伸び、当時の微調整に検証器を加えた方法を上回った。
これが成り立つ前提は、誤った推論がそれぞれ別々に間違えることだ。モデルに系統的な盲点がある場合や、まったく解けない問題では、投票はますます確信をもって間違ったほうを選ぶだけになる。コストもサンプリングの本数に比例してそのまま増える。幸い、多くの問題は 5~10 本で改善の大部分が得られる。
この論文が本当に残したものは、あの一致の度合いと正答率の散布図かもしれない。票数そのものが一種の確信度のスコアになる。二年もたたないうちに Gemini Ultra が MMLU で 90% に届いたのも、まず票が十分に集中しているかを見て、それから投票の結果を信じるかどうかを決めたからだ。