原始論文
Self-Consistency Improves Chain of Thought Reasoning in Language Models
- 發表版本
- ICLR 2023會議
- arXiv 首次提交
- arXiv:2203.11171
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformersselfconsistency2022,
  title = {{Self-Consistency Improves Chain of Thought Reasoning in Language Models}},
  author = {Xuezhi Wang and Jason Wei and Dale Schuurmans and Quoc Le and Ed Chi and Sharan Narang and Aakanksha Chowdhery and Denny Zhou},
  year = {2022},
  eprint = {2203.11171},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.11171}
}
2022 年 1 月,Google 的 Wei 等人發表思維鏈提示,讓模型先寫出推理步驟再給答案,數學應用題的成績大幅提升。
不過那篇論文的解碼方式很保守。推理題的答案是固定的,大家習慣用貪婪解碼,每一步都挑機率最高的 token,最後只得到一條推理。這條推理中間只要算錯一步,答案就錯了,沒有補救的機會。
兩個月後,同一個團隊的 Wang 等人換了一個想法。同一題讓模型多寫幾遍,每遍走不同的路,最後看哪個答案出現最多次。
定義問題
人解題的時候,常常有好幾種想法都能走到同一個答案。作者的假設是,複雜的推理題也是這樣,正確的推理就算寫法不同,最後的答案會一致;錯誤的推理則各錯各的,答案比較分散。
如果這個假設成立,就不需要知道哪一條推理是對的,只要看答案有沒有「撞在一起」。
在這之前,要從多個候選答案裡挑出好的,通常得另外訓練一個模型。Cobbe 等人在 GSM8K 上訓練了一個驗證器替解答排序,LaMDA 則收集額外的人工標註,訓練一個重新排序的模型。這篇想做到的是不訓練、不加標註、不需要額外的模型,拿現成的語言模型直接用。
解決問題
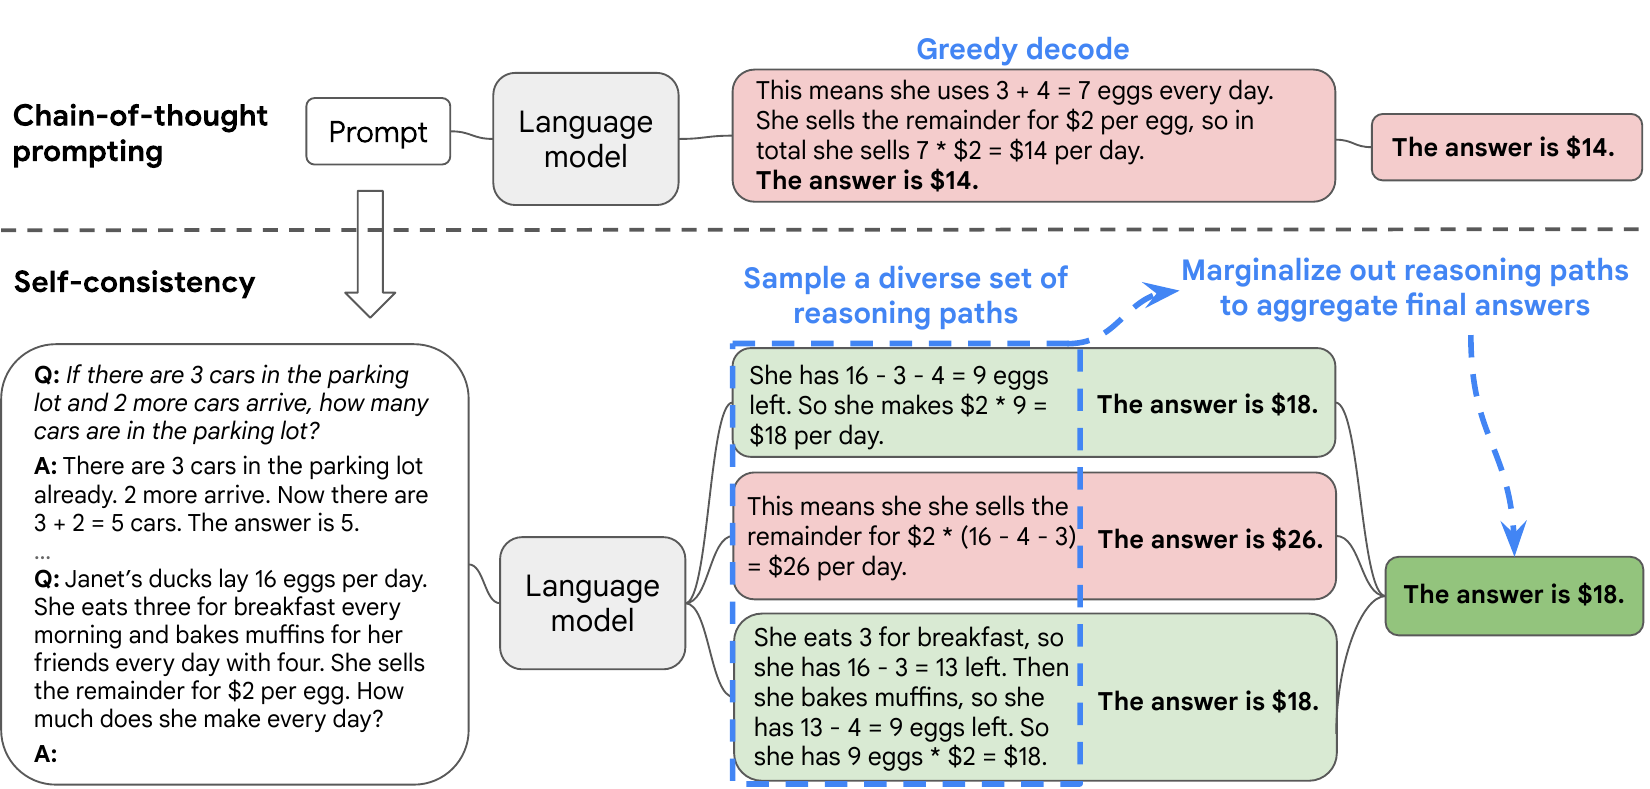
方法只有三步:
- 和原本一樣,用手寫的思維鏈範例當提示。
- 不用貪婪解碼,改從模型的解碼器取樣出 條輸出,每條各有一段推理和一個答案。
- 把每條輸出最後「The answer is」之後的答案取出來,選出現最多次的那個。
圖中的例子是 GSM8K 的一題:Janet 的鴨子每天下 16 顆蛋,早餐吃 3 顆、烤瑪芬用 4 顆,剩下的每顆賣 2 美元,一天賺多少?貪婪解碼把吃掉和用掉的蛋加成 7 顆,卻沒有從 16 顆裡扣掉,直接拿 7 乘 2,得到 14 美元。三條取樣的推理中,兩條用不同的寫法都算出 18 美元,一條算錯成 26 美元。投票的結果是 18。
為什麼叫「邊際化」
作者把第 條輸出拆成推理 和答案 。我們真正關心的只有答案,推理是中間產物,所以把各種推理加總掉,只看每個答案得到多少票:
這就是多數決。名字聽起來很學術,做起來就是數票。
要不要按機率加權
既然每條輸出都有模型給的機率,也可以讓機率高的推理多算幾票。作者試了幾種加權方式,其中「正規化」指的是把整條輸出的對數機率除以 token 數,避免長的推理因為連乘了更多機率而吃虧:
在 PaLM 540B 上的結果:
| 投票方式 | GSM8K | MultiArith | AQuA | SVAMP |
|---|---|---|---|---|
| 貪婪解碼 | 56.5 | 94.7 | 35.8 | 79.0 |
| 加權平均(未正規化) | 56.3 | 90.5 | 35.8 | 73.0 |
| 加權平均(正規化) | 22.1 | 59.7 | 15.7 | 40.5 |
| 加權總和(未正規化) | 59.9 | 92.2 | 38.2 | 76.2 |
| 加權總和(正規化) | 74.1 | 99.3 | 48.0 | 86.8 |
| 不加權(多數決) | 74.4 | 99.3 | 48.3 | 86.6 |
整理自原論文 Table 1,節錄四個算術資料集;單位為 %。
正規化的加權總和和單純數票幾乎一樣。作者檢查後發現,正規化之後各條推理的機率都很接近,模型覺得它們「差不多一樣可能」。換句話說,模型分不太出自己哪條推理是對的,這也是先前的研究要另外訓練排序模型的原因。既然加權沒有幫助,直接數票就好。
「加權平均」則是把每個答案的加權總和再除以票數,等於不看票數多寡,結果差很多。
這個方法有一個前提,答案必須來自固定的集合,才能判斷兩個答案是不是同一個。數學題取數字、選擇題取選項都沒問題;開放式的生成就不行,除非另外定義什麼叫兩段文字「一致」。
實驗設定
- 任務:算術推理有 AddSub、MultiArith、ASDiv、AQuA、GSM8K、SVAMP;常識推理有 CommonsenseQA、StrategyQA、ARC;符號推理有字母串接和翻硬幣,範例只示範兩個字或兩次翻轉,測試時考四個。
- 模型:UL2 20B、GPT-3 175B(透過 Codex 系列的 code-davinci-001 與 002)、LaMDA 137B、PaLM 540B。全部只用提示,不做任何微調。
- 提示:和思維鏈論文相同,算術題共用同一組 8 個手寫範例。
- 取樣:UL2 和 LaMDA 用溫度 0.5、top-k 40;PaLM 用溫度 0.7、top-k 40;GPT-3 用溫度 0.7,不截斷。每次取樣 40 條,重複 10 次取平均。
討論
每個模型都進步
| 模型 | GSM8K | SVAMP | AQuA |
|---|---|---|---|
| UL2 20B | 4.1 → 7.3 | 12.6 → 19.4 | 23.6 → 26.9 |
| LaMDA 137B | 17.1 → 27.7 | 38.9 → 53.3 | 17.7 → 26.8 |
| PaLM 540B | 56.5 → 74.4 | 79.0 → 86.6 | 35.8 → 48.3 |
| code-davinci-001 | 14.6 → 23.4 | 39.8 → 54.5 | 18.9 → 25.6 |
| code-davinci-002 | 60.1 → 78.0 | 75.8 → 86.8 | 39.8 → 52.0 |
整理自原論文 Table 2;箭頭左邊是思維鏈加貪婪解碼,右邊是 self-consistency,單位為 %。
四個模型、所有算術任務都有提升,而且模型越大,提升通常越多。UL2 20B 多 3 到 7 個百分點,LaMDA 137B 和 code-davinci-001 多在 7 到 24 個百分點之間。即使是本來就很強的 PaLM 540B 和 code-davinci-002,GSM8K 也多了 17.9 個百分點。code-davinci-002 的 78.0% 超過了當時微調 GPT-3 再加驗證器的 55%,而 self-consistency 完全沒有訓練。
常識推理的提升比較小,code-davinci-002 在 StrategyQA 多 6.4、ARC-challenge 多 3.9 個百分點。符號推理用比範例更長的題目測試,模型夠大時仍有幫助;但 UL2 20B 的字母串接本來就是 0.0%,投票之後還是 0.0%。模型根本不會的題,取樣再多次也只是收集更多錯誤答案。
取樣越多越好,但很快就飽和
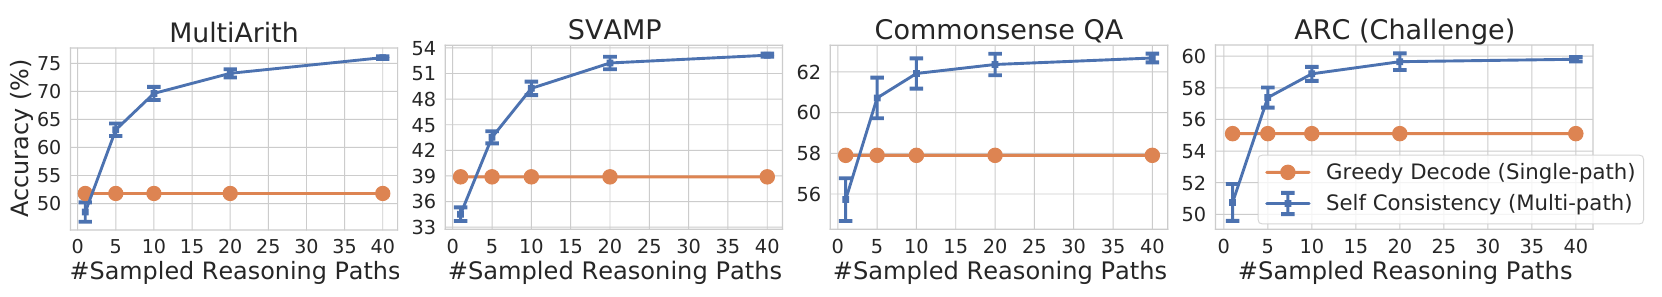
注意每張圖最左邊那個點。只取樣 1 條時,準確率比貪婪解碼還差,因為隨機取樣本來就比挑最可能的 token 更容易出錯。單獨一條取樣的推理品質較差,要靠數量和投票才贏回來。
曲線在 5 到 10 條時已經拿到大部分的提升,作者在結論也建議實務上從 5 或 10 條開始。
投票為什麼有效
作者的假設是,正確的推理即使寫法各不相同,最後也會落在同一個答案;錯誤的推理則各錯各的,答案分散在許多不同的值。所以正確答案只要拿到四成的票,而其餘六成分散在好幾個錯誤值上,它仍然是最大的一群,取樣越多,多數決越穩。
反過來看,這個假設也劃出了投票的邊界。如果模型有系統性的錯誤,例如習慣性地少扣一步,錯誤答案就會集中在同一個值。正確率 40%、其餘六成裡有八成錯成同一個值時,這個錯誤答案拿到 48% 的票,比正確答案還多,取樣越多反而越確定地選錯。self-consistency 能贏,靠的是「錯誤各錯各的」。
和其他做法比
取樣後排序:同樣取樣多條,按每條的對數機率排序,取第一名的答案。在 code-davinci-001 上,這樣做也會隨條數進步,但幅度比投票小得多,和前面「模型分不出哪條推理比較好」的觀察一致。
束搜尋(beam search):在 UL2 20B 的 AQuA 上,束搜尋取最上面那條,束越寬反而越差,從 23.6% 掉到 40 束的 10.2%。用束搜尋產生 40 條推理再投票是 24.2%,用取樣再投票是 26.9%。束搜尋產生的候選太相似,投票需要的是多樣性。
集成:在 LaMDA 137B 的 GSM8K 上和兩種提示集成比較:
| 方法 | GSM8K |
|---|---|
| 思維鏈(貪婪解碼) | 17.1 |
| 三組不同的手寫提示,各自貪婪解碼後投票 | 18.6 |
| 範例順序打亂 40 次,各自貪婪解碼後投票 | 19.2 |
| Self-consistency(取樣 40 條) | 27.7 |
整理自原論文 Table 7;單位為 %。
換提示和換順序帶來的變化,遠不如讓模型自己多走幾條路。附錄還試了多個模型一起投票,PaLM 540B 加上 LaMDA 137B 只有 36.9%,比 PaLM 自己做 self-consistency 的 74.4% 差很多;弱的模型會把強的模型拖下水。
思維鏈反而變差的任務
Ye 和 Durrett 發現,有些一般的 NLP 任務加上思維鏈反而會退步。作者在 PaLM 540B 上測了幾個:
| 方法 | ANLI R1 | e-SNLI | RTE | BoolQ |
|---|---|---|---|---|
| 標準提示(不寫推理) | 69.1 | 85.8 | 84.8 | 71.3 |
| 思維鏈提示 | 68.8 | 81.0 | 79.1 | 74.2 |
| Self-consistency | 78.5 | 88.4 | 86.3 | 78.4 |
整理自原論文 Table 5,節錄部分欄;單位為 %。
e-SNLI 和 RTE 加上思維鏈都掉了 5 個百分點左右,self-consistency 把它們拉回來,還超過不寫推理的標準提示。
不太挑設定
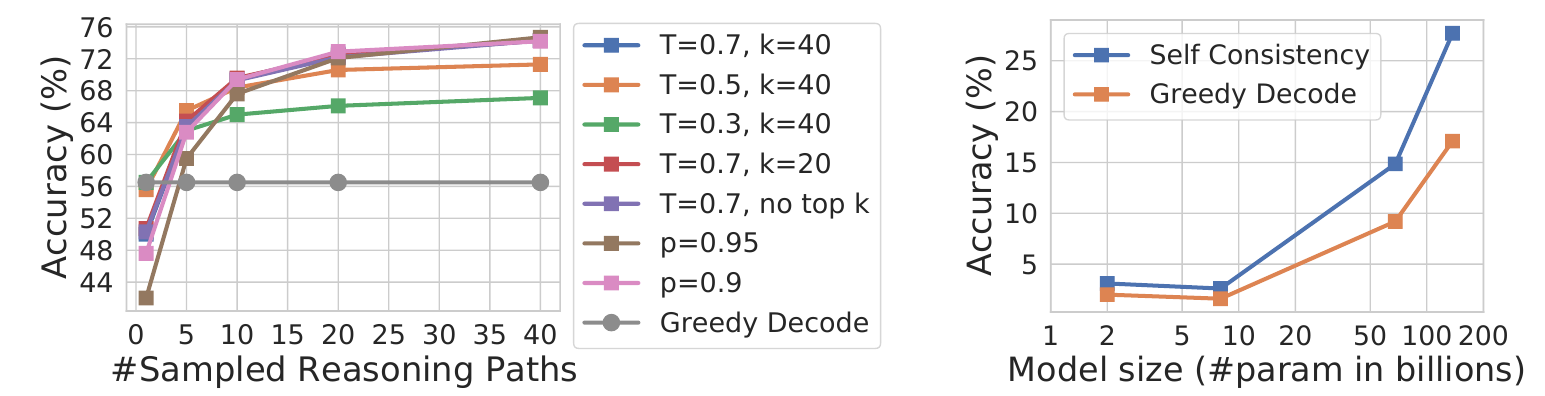
左圖的各種溫度、top-k、nucleus 取樣設定,取到 40 條時都遠高於貪婪解碼。右圖則顯示小模型的提升有限,作者的解釋是算術這類能力要到一定規模才出現,模型還不會算的時候,投票也幫不上忙。
作者還做了幾個壓力測試,都在 GSM8K 上:
- 範例寫錯:把提示範例裡推理過程的數字隨機替換(只保留最終答案),LaMDA 137B 的貪婪解碼從 17.1% 降到 14.9%,加上 self-consistency 回到 23.4%。
- 只寫算式:推理只寫「3 + 2 = 5」這類算式,self-consistency 從 5.0% 到 6.5%,提升很小。算式太短,能變出的花樣不多,多樣性不夠。
- 零樣本思維鏈:不給範例,只加一句「Let's think step by step」,PaLM 540B 從 43.0% 升到 69.2%,多了 26.2 個百分點。
- 換一組提示:附錄另寫了兩組範例,PaLM 540B 的提升分別是 17.5 和 16.4 個百分點,和主實驗的 17.9 差不多。
一致程度可以當成信心
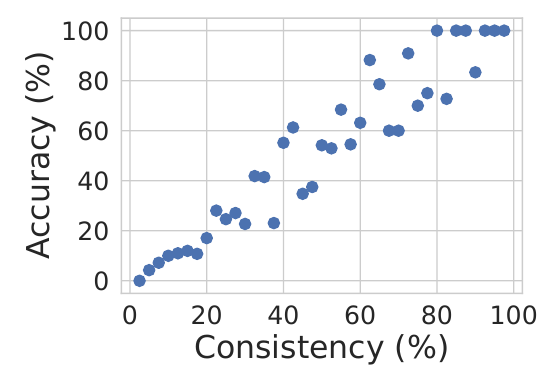
投票不只給出答案,也給出票數。40 條推理裡有 35 條同意,和只有 12 條同意,可信度顯然不同。作者發現一致的比例和準確率高度相關,所以一致程度低的題目,可以當成模型「自己也沒把握」的訊號。
限制
作者自己點出三個限制:
- 成本:取樣 40 條就是 40 倍的推論,所以建議先試 5 到 10 條。
- 只適用固定答案:要能判斷答案是否相同。
- 推理不一定對:答案投對了,推理過程仍可能胡說。表格裡 StrategyQA 的例子,模型比較兩個 Albany 的人口來回答,兩個人口數字都不太準。
作者也提出一個未來方向,用 self-consistency 產生更好的資料來微調模型,讓它一次推論就能答對。同一個月,Zelikman 等人的 STaR 就在做類似的事,拿答對題目的推理過程回頭訓練模型。
後來的事
多數決很快成了推理評測的標準配備,論文表格裡常見的 maj@k、cons@64,指的就是取樣 k 條或 64 條後投票。DeepSeek-R1-Zero 在 AIME 2024 上單次作答的平均是 71.0%,64 條投票則是 86.7%。
「一致程度當信心」這一點也被用上了。2023 年 12 月的 Gemini 技術報告,Gemini Ultra 在 MMLU 拿到 90.04%,用的是他們稱為 uncertainty-routed chain-of-thought 的做法。先取樣 32 條思維鏈,一致的程度超過門檻就採用多數決的答案,否則退回不寫推理的貪婪解碼。只用貪婪解碼是 84.0%,只用 32 條投票是 85.0%,兩者結合才到 90.0%。
固定答案的限制,也有人試著拿掉。2023 年 11 月,同團隊的 Chen 等人提出 Universal Self-Consistency,不再自己比對答案,而是把所有候選回答交給語言模型,請它挑出和其他回答最一致的那個,因此可以用在摘要、程式碼這類沒有標準答案的生成上。
再往後,問題變成「推論時多花的算力,要怎麼分配最划算」。投票是最簡單的一種,還有用驗證器挑答案、在推理的每一步展開搜尋等做法。
結論
Self-consistency 不用訓練、不用額外的模型,把貪婪解碼換成取樣 40 條再數票,PaLM 540B 和 code-davinci-002 在 GSM8K 上就多了 17.9 個百分點,超過當時微調再加驗證器的做法。
它成立的前提是錯誤的推理各錯各的。模型有系統性的盲點,或是根本不會的題目,投票只會更堅定地選錯;成本也是直接乘上取樣的條數。好在多數題目在 5 到 10 條時就拿到大部分的提升。
這篇真正留下來的,可能是那張一致程度和準確率的散布圖。票數本身就是一種信心分數,不到兩年後 Gemini Ultra 衝上 MMLU 90%,靠的就是先看票數夠不夠集中,再決定要不要相信投票的結果。