原論文
Tree of Thoughts: Deliberate Problem Solving with Large Language Models
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2305.10601
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerstreeofthoughts2023,
  title = {{Tree of Thoughts: Deliberate Problem Solving with Large Language Models}},
  author = {Shunyu Yao and Dian Yu and Jeffrey Zhao and Izhak Shafran and Thomas L. Griffiths and Yuan Cao and Karthik Narasimhan},
  year = {2023},
  eprint = {2305.10601},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.10601}
}
言語モデルが文章を生成するやり方は、GPT から GPT-4 まで変わっていない。左から右へ、token を一つずつ書き足していき、書いたら後戻りはできない。
思考の連鎖はモデルに推論のステップを先に書かせるが、それでも一本道を最後まで進むだけだ。Self-Consistency は何本も道を進んで最後に投票するが、どの道も一気に書き上げられ、途中で立ち止まって「この一歩はこう進むのがいいか、それともああ進むのがいいか」を比べることはない。最初の一歩で道を誤れば、その後をどれだけきれいに書いても無駄になる。
Princeton の Yao らは Google DeepMind と組んで、人工知能のごく初期の研究にヒントを求めた。1950 年代、Newell と Simon は、人間の問題解決を木の上の探索として描いた。各ノードは部分的な解で、各枝は次の一手の候補だ。経験則でどちらへ進むかを決め、行き詰まったら引き返す。この論文は、言語モデルにも同じことをさせる。
問題の定義
著者らは当時の手法を、いくつかの形式に統一して書いた。入力を 、出力を 、言語モデルを とする。
- 入出力プロンプト(IO):答えを直接生成する。。
- 思考の連鎖(CoT):入力と出力の間に一連の思考 を挟む。各思考は意味のあるひとまとまりの文章で、たとえば一行の式だ。実際には、この連鎖全体が一気に書かれる。
- 思考の連鎖 + Self-Consistency(CoT-SC): 本の思考の連鎖を独立にサンプリングし、最も多く出た答えを選ぶ。
「木の上の探索」という見方からすると、これらの手法には二つのものが欠けている。局所的には、同じステップで異なる書き方を探らない。大域的には、計画も、先読みも、バックトラックもない。
問題を解く
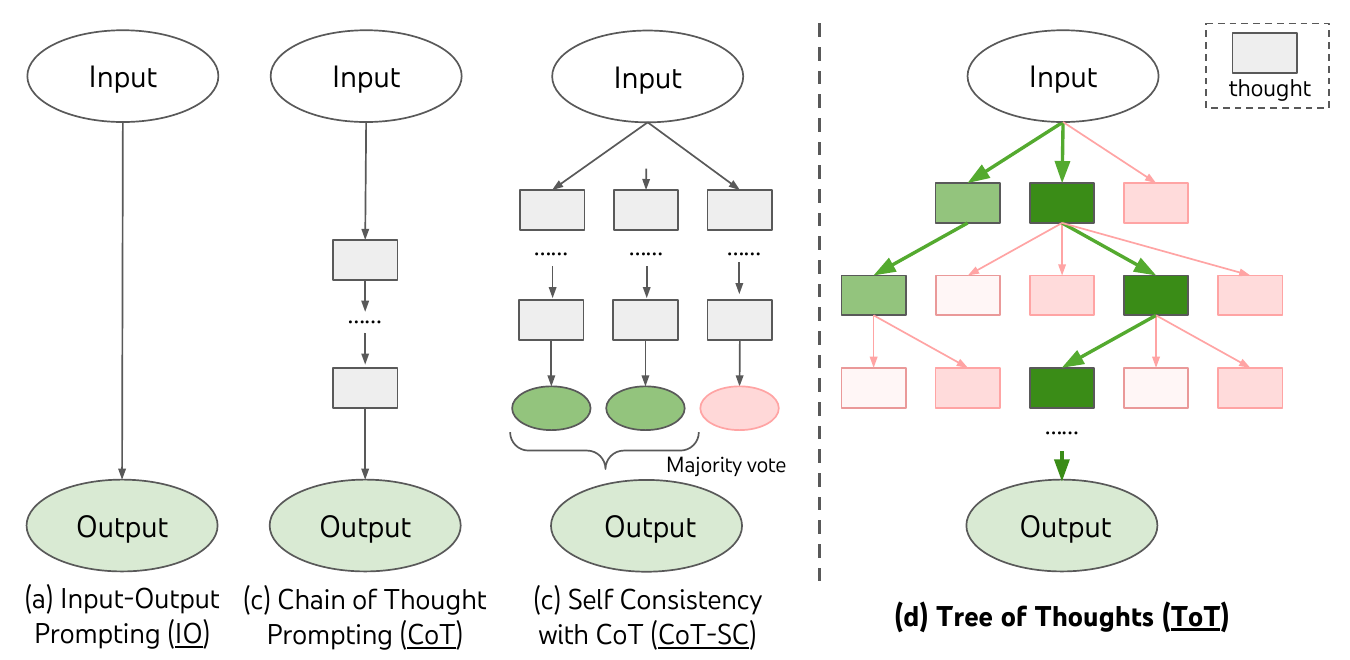
Tree of Thoughts(ToT)は、問題を木の上の探索とみなす。各ノードは状態 、つまり入力にここまでの思考を加えたものだ。これをある問題に使うには、四つの問いに答えなければならない。
その1:思考をどの大きさに切るか
思考は、モデルが多様で見込みのある候補を出せるくらい小さく、それでいてモデルが見込みの有無を判断できるくらい大きくなければならない。token 一つでは小さすぎて評価のしようがなく、本一冊では大きすぎて筋の通ったものが書けない。
問題によって、著者らの切り方も変わる。24 ゲームでは一つの思考は一行の式、創作文では構成案ひとまとまり、クロスワードではあるヒントに入れる単語一つだ。
その2:次の思考をどう生成するか
- 独立サンプリング:思考の連鎖のプロンプトを使い、 回独立にサンプリングする。段落ひとつ分の構成案のように思考の空間が広い場合に向いていて、それぞれ独立にサンプリングすれば自然に多様性が出る。
- まとめて提案:「提案プロンプト」を使い、モデルに一回の出力の中で 個の候補を列挙させる。一行の式や単語一つのように思考の空間がかなり限られている場合に向いていて、同じ出力の中に並べさせれば重複を避けられる。
その3:状態をどう評価するか
ここが ToT と一般的な探索アルゴリズムの最も違うところだ。従来の探索の経験則は、ハードコードされた規則(たとえば Deep Blue)か、訓練されたモデル(たとえば AlphaGo)のどちらかだった。ToT は第三のやり方を取り、言語モデル自身に文章で推論させて、ある状態に見込みがあるかを判断させる。
- 個別に採点:各状態について、モデルに点数をつけさせるか、「必ずできる / できるかもしれない / 不可能」に分類させる。判断の根拠は、数手先まで試してみることでもよい。たとえば 5、5、14 なら、すぐに 5 + 5 + 14 = 24 が作れる。常識でもよい。たとえば 1、2、3 は小さすぎて、どう計算しても 24 に届かない。
- 相互に比較:文章に一貫性があるかどうかのように、成否を直接採点しにくい場合は、いくつかの候補を並べて、モデルに投票で最も見込みのあるものを選ばせる。各ステップで一回ずつ Self-Consistency をするのに少し似ている。
評価は完璧でなくてよく、だいたい意思決定の助けになれば十分だ。何回か問い合わせて平均を取り、コストと引き換えに、より信頼できる判断を得ることもできる。
その4:どの探索を使うか
- 幅優先(BFS):各ステップで、最も見込みのある 個の状態だけを残す。木が浅い(最大 3 ステップ)24 ゲームと創作文で使う。
- 深さ優先(DFS):まず最も見込みのある方向へ行けるところまで進む。この状態からは解けないと評価が判断したら、部分木をまるごと刈り込み、一つ上の層に戻って次の候補に切り替える。10 個の単語を埋めるクロスワードで使う。
この見方からすると、IO、CoT、CoT-SC はどれも ToT の特殊ケースで、木の深さと幅が制限されているだけだ。枠組み全体に訓練は一切要らず、既製の言語モデルでそのまま使える。
議論
三つの実験はどれも GPT-4 のチャットモードを使い、温度 0.7 で、2023 年 5 月 5 日から 16 日の間に実行された。三つのタスクはいずれも、GPT-4 でも IO や CoT ではうまく解けないものを、著者らがわざわざ選んでいる。
24 ゲーム
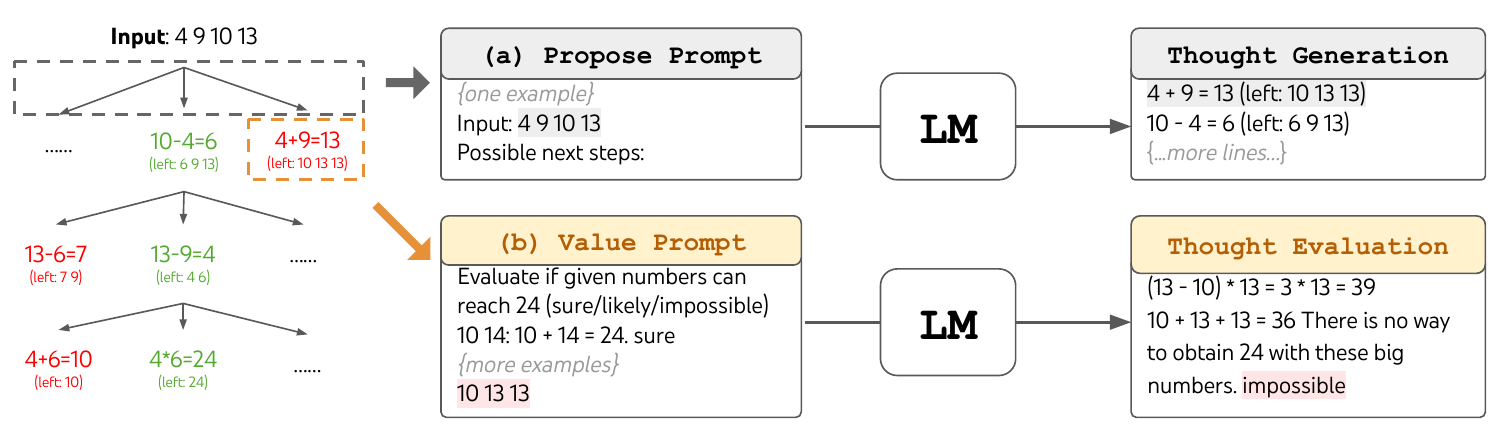
24 ゲームは、四つの数と四則演算で 24 を作るゲームだ。著者らは 4nums.com から 1,362 問を集めた。このサイトは人間が解くのにかかった時間をもとに問題を易しい順に並べており、テストには第 901 問から第 1,000 問までの、比較的難しい 100 問を使った。
ToT で解くと、自然に 3 ステップに分かれ、各ステップが一行の式になる。各ノードは残りの数を提案プロンプトに渡し、次の一手の候補を列挙させる。各候補はさらに評価プロンプトに渡され、sure、maybe、impossible のどれかに判定される。判定は候補ごとに 3 回ずつ行う。幅優先探索で、各ステップで最も良い 5 個を残す。
| 手法 | 成功率 |
|---|---|
| IO プロンプト | 7.3% |
| CoT プロンプト | 4.0% |
| CoT-SC(100 回の多数決) | 9.0% |
| ToT() | 45% |
| ToT() | 74% |
| IO + 反復修正(最大 10 ラウンド) | 27% |
| IO(100 回中のベスト) | 33% |
| CoT(100 回中のベスト) | 49% |
原論文 Table 2 をもとに整理。
CoT は 4.0% しかなく、直接答えさせるより低い。投票しても 9.0% どまりだ。ToT は候補を 1 個残すだけで 45%、5 個残すと 74% に達する。
表の下半分は、条件を緩めた比較対象だ。「反復修正」は、間違えるたびにモデルに反省させてやり直させるが、式が正しいかどうかの正解情報をフィードバックとして使っている。「100 回中のベスト」は 100 回のうち一回でも正しければ成功とみなすもので、実際に使うときにはどの回が正しいかはわからないので、上限と言える。そんな上限でさえ CoT は 49% で、やはり ToT に届かない。
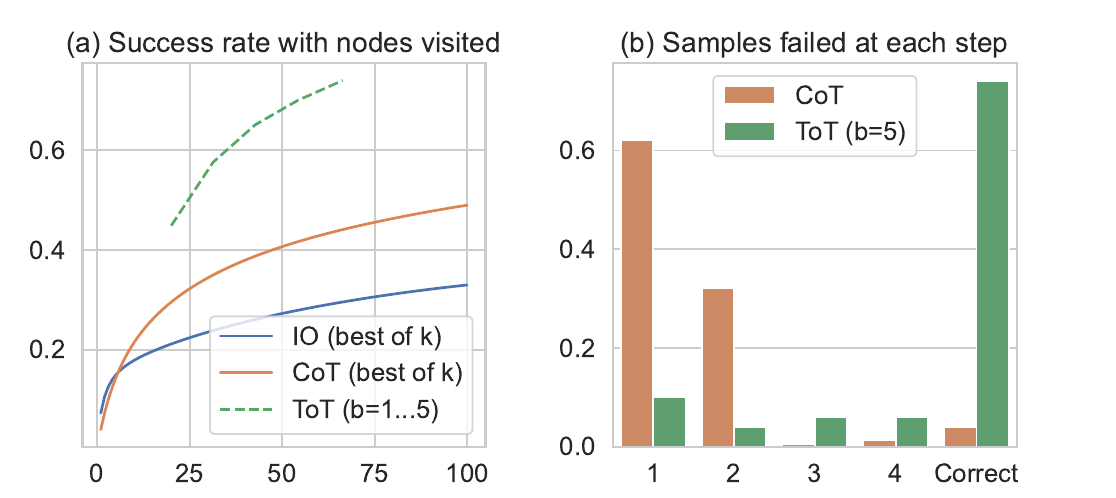
いちばん見ておきたいのは右図だ。CoT のサンプルの約 6 割は、第一ステップ、つまり最初の 3 文字(たとえば「4 + 9」)を書き終えた時点で、もう 24 を作れないことが決まっていた。
なぜ第一ステップがそれほど決定的なのか? 4 9 10 13 を例にとると、二つの数を選んで四則演算を一回するやり方は、第一ステップだけで 36 通りある。そのうちまだ 24 を作れるのは 7 通りだけで、たとえば 10 − 4、9 + 10、13 − 9 だ。適当に一手を選べば、八割がたは行き止まりに入り込む。左から右へ書き進める CoT は引き返せないので、第一ステップを間違えればすべてが台無しになる。
何も判断せず、ただ深さ優先でひたすら試していき、最後まで行って作れなければ一つ上の層に戻る、というやり方でも答えは見つかる。たとえば 4 − 10 = −6、9 − 13 = −4、(−6) × (−4) = 24 だ。ただし千を超える状態をたどる必要がある。プログラムなら力ずくで全探索できるが、言語モデルは一歩進むたびに API 呼び出しを一回使うので、とても持たない。ToT の評価プロンプトが担っているのはまさに枝刈りの役割で、「10 13 13 はどう計算しても大きすぎる」といった状態を先に刈り込み、見込みのある少数の枝だけを展開する。
それでもコストはかなりのものだ。ToT で 24 ゲームを 1 問解くには平均 5,500 token を生成する必要があり、CoT を 100 回サンプリングしたときの 6,700 token に近い。1 問あたりのコストは約 0.74 ドルで、CoT の 100 回サンプリングは約 0.47 ドルだ。ほぼ同じ token を使って、ToT の成功率は 74%、CoT の 100 回中のベストは 49% である。
著者らは GPT-3.5 でも試していて、ToT は 19% にとどまった。組み合わせを入れ替えたテストでは、GPT-4 が思考を生成して GPT-3.5 が評価すると 64%、GPT-3.5 が生成して GPT-4 が評価すると 31% しかない。このゲームのボトルネックは良い候補を生成するほうにあり、評価にはない。
創作文
ランダムな文を 4 つ与え、4 段落の文章を書かせる。各段落は、それぞれこの 4 つの文で終わらなければならない。このタスクには正解がないので、著者らは二通りのやり方で一貫性を評価した。GPT-4 に 1 から 10 点で採点させて 5 回の平均を取るやり方と、著者の一部が、どちらがどの手法で書かれたかを知らされないまま、CoT と ToT の文章を一対ずつ比べるやり方だ。
ToT は二層しかない。まず構成案を 5 つ生成し、5 回投票して最も良いものを一つ選ぶ。次にその構成案に沿って文章を 5 本書き、同じく投票で一本を選ぶ。
| 手法 | GPT-4 の採点 |
|---|---|
| IO | 6.19 |
| CoT(構成案を書いてから文章を書く) | 6.93 |
| ToT | 7.56 |
| IO + 反復修正 | 7.67 |
| ToT + 反復修正 | 7.91 |
原論文 4.2 節をもとに整理。スコアは 100 問の平均。
人手による比較の結果も一致していて、100 組のうち 41 組で ToT のほうが一貫していると判定され、CoT のほうが良いとされたのは 21 組、残りの 38 組は同程度だった。このタスクでは反復修正がよく効く。著者らはこれを、思考を生成する三つ目のやり方、つまり古い思考に手を入れて新しい思考を作るやり方とみなしている。
ミニクロスワード
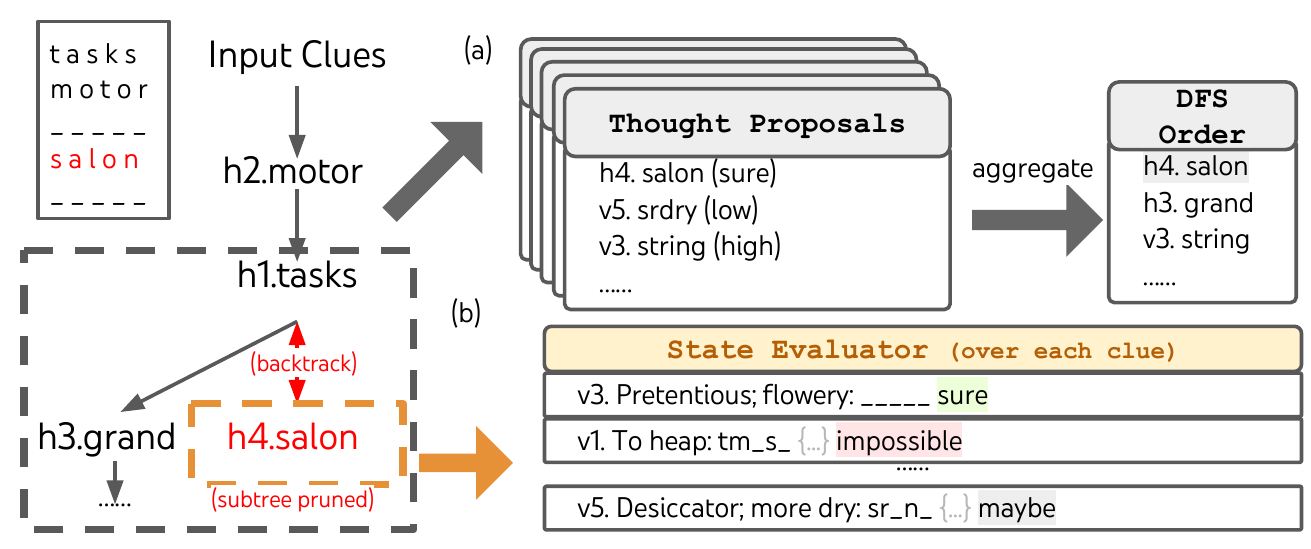
前の二つのタスクの木はどちらも浅く、最大 3 ステップだった。クロスワードは単語を 10 個(横 5 個、縦 5 個)埋める必要があり、しかも互いに制約し合うので、より難しい探索問題になる。著者らは GooBix から 156 問を集め、20 問をテストに使った。
ここでは深さ優先探索を使う。各状態では、すでに埋めた単語を残りのヒントに対する文字の制約に変換し、モデルに候補を 5 回提案させる。各候補には確信度をつけさせ、それをまとめて優先順位にする。評価では残りのヒントを一つずつ確認し、一つでも埋められないと判定されたら、部分木全体を刈り込んで一つ上の層に戻る。最大 100 ステップまで進み、最後に最も深くまで進んだ状態を出力する。
| 手法 | 文字 | 単語 | 問題全体 |
|---|---|---|---|
| IO | 38.7 | 14 | 0 |
| CoT | 40.6 | 15.6 | 1 |
| ToT | 78 | 60 | 20 |
| ToT、最良の状態を出力 | 82.4 | 67.5 | 35 |
| ToT、枝刈りなし | 65.4 | 41.5 | 5 |
| ToT、バックトラックなし | 54.6 | 20 | 5 |
原論文 Table 3 をもとに整理。単位は %。「問題全体」は 20 問のうち完全に解けた割合。
IO と CoT の単語正解率はどちらも 16% 未満で、ToT は 60% に達し、20 問中 4 問を完全に解いた。
後ろの三行はアブレーションだ。各問について、探索の途中で得られた最良の状態をそのまま出力すると(これには正解を知っている必要があるので、上限と言える)、7 問を解ける。「最も深い状態を出力する」というルールには、まだ改善の余地があるということだ。
枝刈りも間違えることがある。5 × 5 のクロスワードはマスを埋めるために、珍しい単語や古い単語を使うことがある。たとえば「agend」は「agendum」の古い形だが、GPT-4 はそれを「agenda」の綴り間違いだと思い込み、正しい盤面を刈り込んでしまった。枝刈りを外すと全体のスコアは下がるが、4 問では探索の途中で正しい盤面に行き着いており、そのうち 3 問は、枝刈りありの ToT が 100 ステップ以内に解けなかった問題だった。評価器の良し悪しが、探索がどこまで進めるかを直接左右する。
バックトラックを外し、毎回最も見込みのある単語を埋め、最大 20 ステップ、上書きも可、というやり方に変えると、単語正解率は 20% まで落ちる。
簡単な問題には出番がない
付録では、ゼロショットの ToT を一般的な問題に使っている。まず解き方の戦略を 5 つ生成して投票で一つ選び、次にその戦略に沿って解答を 5 つ書いて投票で一つ選ぶ。
| 手法 | GSM8K | StrategyQA |
|---|---|---|
| IO | 51 | 73 |
| CoT | 86 | 82 |
| ToT | 90 | 83 |
原論文 Table 4 をもとに整理。GPT-4、各 100 問、単位は %。
ToT はやはり CoT より良いが、差はわずかだ。GPT-4 + CoT は、こうした問題ですでに十分強い。StrategyQA のボトルネックは外部知識で、推論ではない。著者らの提案は、従来の NLP タスクでは小さいモデル + ToT を試してみて、GPT-4 + ToT は GPT-4 + CoT でも解けない難問のために取っておく、というものだ。
限界
著者らは議論の中でいくつかの点を挙げている。
- 多くのタスクでは要らない:GPT-4 がすでに得意なタスクに、これほど手間のかかる探索は必要ない。この論文が探ったのも、比較的単純だが GPT-4 がうまく解けない三つのタスクだけだ。
- コスト:プロンプトや探索方法によって、ToT が生成する token は CoT の 5 倍から 100 倍になる。三つのタスクの主要な実験のうち、24 ゲームと創作文で合計約 106 ドル、クロスワードも 100 ドル以内と見積もられている。
- 既製のモデルしか使っていない:著者らは、今後 ToT に似たやり方でモデルを微調整すれば、次の token を予測するだけでなく、「次のひとまとまりをどう書くか」というレベルで意思決定することを学ばせられるだろうと述べている。
もう一つ触れておきたいのは、ToT ではタスクごとに人が設計しなければならないことだ。思考をどう切るか、提案と評価のプロンプトをどう書くか、どの探索を使うか。問題が変われば、これらをすべて考え直すことになる。
その後
著者らが結びで挙げた方向は、のちに推論モデルによって実現した。ただし、たどった道は ToT とは違っていた。
DeepSeek-R1 の論文には「失敗した試み」という一節がある。チームは推論時にモンテカルロ木探索(MCTS)で探索することを試し、答えを小さな断片に分けて、価値モデルで探索を導いた。しかし二つの問題にぶつかった。token 生成の探索空間はボードゲームよりはるかに大きく、各ノードの展開数を制限しても局所最適にはまりやすいこと。そして、十分に精密な価値モデルを訓練すること自体が難しいことだ。最終的にうまくいったのは、答えの正誤を報酬にする強化学習で、モデルは一本の長い思考の連鎖の中で、確認し、疑い、引き返して考え直すことを自分で身につけた。
推論時の探索は、その後も残った。どんな場合に探索を使うべきか、どんな場合にモデル自身に答えを直させるべきか、計算量をどう配分すれば最も割に合うのか。のちに、これを体系的に比べた研究が出ている。
結論
ToT は古典的な人工知能の木探索を言語モデルにつなぎ、候補の提案と良し悪しの評価の両方をモデルに任せた。GPT-4 の 24 ゲームでは、CoT が 4% しかないのに対して ToT は 74% に達し、クロスワードの単語正解率は 15.6% から 60% に上がった。
この種の手法の代償も、この論文ははっきり示している。問題ごとに、思考の切り方、提案と評価のプロンプト、探索のやり方を人が設計しなければならない。token は CoT の数倍から百倍に達する。評価器が一度見誤れば、綴り間違いとされたあの「agend」のように、正しい答えが刈り込まれてしまう。
一年あまり後、推論モデルはこの木を平らにならしてしまった。モデルは一本の長い思考の連鎖の中で自分から立ち止まり、「ちょっと待って、これは違う」と言って前に戻り、考え直す。分岐も、評価も、バックトラックもまだそこにあるが、もう外側の探索プログラムに管理してもらう必要はない。