原論文
GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection
- 発表先
- ICML 2024国際会議
- arXiv への初回投稿
- arXiv:2403.03507
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersgalore2024,
  title = {{GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection}},
  author = {Jiawei Zhao and Zhenyu Zhang and Beidi Chen and Zhangyang Wang and Anima Anandkumar and Yuandong Tian},
  year = {2024},
  eprint = {2403.03507},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.03507}
}
70 億パラメータの LLaMA をゼロから学習させるとして、バッチサイズを長さ 2,048 の系列 1 本だけにしたら、メモリはどれだけ要るだろうか。
論文は冒頭で計算してみせる。BF16 の重みが 14 GB。重みの勾配が 14 GB、Adam の一次・二次モーメントがそれぞれ 14 GB で、合わせて 42 GB。activation がさらに 2 GB。合計 58 GB だ。RTX 4090 は 1 枚 24 GB しかない。
この論文の主張は、提案手法に 8-bit Adam と層ごとの更新を組み合わせれば、7B の事前学習が実測でわずか 22 GB で済むというものだ。モデルを分割せず、activation checkpointing もせず、CPU へのオフロードもしないで、4090 1 枚に収まる。
問題の定義
メモリを節約する昔ながらの方法はたくさんある。activation checkpointing は再計算と引き換えにメモリを節約し、ZeRO はオプティマイザの状態を複数の GPU に分散したり CPU に移したりする。8-bit Adam はモーメントを量子化し、Adafactor は二次モーメントを行和と列和に分解する。どれも一部を節約できるが、代償として時間、通信、あるいは安定性を払う。
もう一つの道が LoRA だ。重みを と書き、 を凍結して二つの小さな行列 、 だけを学習するので、勾配もオプティマイザの状態も の大きさで済む。
LoRA は微調整では大成功したが、事前学習に持ち込むと苦しい。ゼロから始めるとき はランダムに初期化されただけなので、モデル全体が学べる変化が 次元に閉じ込められてしまう。ReLoRA のような改良版でも、まずフルランクの学習でしばらくウォームアップする必要がある。著者らは原因を二つ挙げる。一つは最良の重みが低ランクとは限らないこと、もう一つは再パラメータ化そのものが学習のダイナミクスを変えてしまうことだ。極端な例を挙げると、線形回帰 の最適解が高ランクなら、 を低ランクに制限した時点で、どんなオプティマイザを使っても届かない。
そこで著者らは、問いを変えた。重みは低ランクでなくてもいい。では、勾配はどうだろうか。
問題の解決
勾配は低ランクになっていく
著者らの理論の出発点は、ある種の「可逆ネットワーク」だ。線形層(バイアスなし)、ReLU、leaky ReLU といった層と、それらの直列接続や加算を含み、残差ネットワークもここに入る。このようなネットワークでは、1 バッチの重み勾配は次のように書ける。
、 は半正定値行列だ。Lemma 3.3 は、、、 がある時点以降変わらないなら、普通の SGD で更新したとき、 の stable rank(、「実効的なランク」と考えればよい)が指数的な速さで下がっていき、最後には最小固有部分空間で決まる部分だけが残ることを証明している。Corollary 3.4 はもっと具体的な上界を与える。勾配が 個のデータそれぞれの外積の和で、入力ベクトルのランクが のとき、最終的な stable rank は を超えない。一方、 個の外積の和そのもののランクも を超えないので、論文はこれをもとに、長期的には stable rank は を超えないとしている。
直感的に言えば、線形層の勾配は「各データの逆伝播誤差 × 各データの入力」の外積の和なので、もともと方向の数は限られている。しばらく学習すると、量の大部分がさらにそのうちの少数の方向に集中していく。
この理論がカバーするのは、可逆ネットワーク、係数行列が固定、SGD による更新の場合だけだ。Transformer については、著者らは付録で別の枠組みを使い、フィードフォワード層の最初の射影の勾配が低ランクになることだけを証明している。自己注意と Adam は証明の範囲に入っていない。
小さな空間に射影して Adam を回す
勾配が少数の方向に集中するなら、それらの方向でだけオプティマイザの状態を記録すればいい。GaLore(Gradient Low-Rank Projection)の定義は次のとおりだ。
は状態を必要とする任意のオプティマイザで、たとえば Adam だ。実装では片側の射影だけを使う。重みが 、 のとき、 ステップごとにその時点の勾配を SVD し、上位 個の左特異ベクトルを射影行列にとる。
そして各ステップで次を行う。
(論文は を負の勾配として定義しているので、重みには足し込む形になる。) はスケーリング係数で、LoRA の に似た働きをするが、 によって変わらない。
LLaMA 7B のフィードフォワード層の重みを一つとって、一通りたどってみよう。形は で、論文の 7B 実験では を使う。勾配 は 、射影行列 は で、射影後の は しかなく、Adam の 、 もこの大きさになる。もともと Adam は 万個の数を保存しなければならなかったが、いまは 、 で合わせて 2,254 万、 の 419 万を足して約 2,674 万と、3 割ほどに減る。更新そのものはやはり完全な の行列で、重みはフルランクのままだ。
全体で見ると、GaLore は の重み一つに対して 個の数を保存し、LoRA は 個になる(元の重みと二つのアダプタ、さらにアダプタの 2 セットのモーメント)。
LoRA との違いはもう一つある。 をフルランクにとると となり、単純な SGD と組み合わせれば、GaLore の軌跡は元の学習とまったく同じになる。LoRA では、 がフルランクであっても、 と を同時に最適化すれば別の軌跡になる。
著者らは固定した射影のもとでの収束も証明している(Theorem 3.8)。条件は 、つまり状態を持たない SGD であること、そして射影後の部分問題の最小固有値が、連続性の定数で決まるあるしきい値より大きいことだ。定理は射影を最大の固有部分空間に合わせるよう示唆していて、これが勾配の SVD の上位 方向をとる理由になっている。著者らは、ここでの収束が示すのはこの部分空間の中でうまく進んでいることだけで、全体の性能は保証されないとも明記している。
部分空間を取り替える
一つの固定した部分空間の中だけを進むと、重みの変化はいつまでも 次元に限られ、LoRA と同じ問題に戻ってしまう。GaLore は ステップごとに部分空間を取り替える。
各区間の はどれも低ランクだが、積み重なればフルランクになりうる。
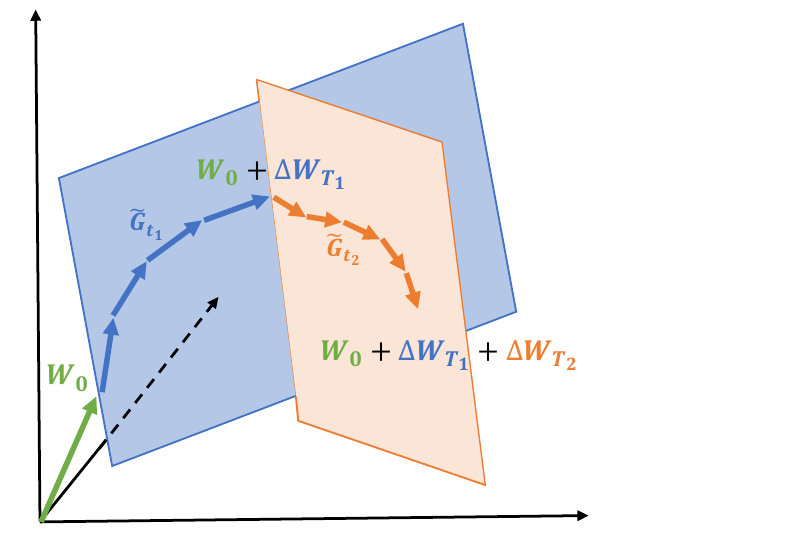
青い平面は最初の ステップの部分空間で、重みはその中をしばらく進む。 に達すると、その時点の勾配で SVD を計算し直して橙の平面に替え、さっきの位置から進み続ける。
はどう選べばいいか。頻繁に替えすぎると SVD のコストが大きくなり、定理が要求する固定射影も崩れ、Adam が蓄積したモーメントも基底が変わり続けるせいで歪んでしまう。替えるのが少なすぎると、もう重要でなくなった部分空間に閉じ込められるおそれがある。著者らは、 が 50 から 1,000 のあいだなら大差ないことを見出し、事前学習では一律に 200 を使った。SVD の総コストは 10% 以内と見積もっている。なお Algorithm 2 では、部分空間を替えるとき と はそのまま引き継がれ、リセットも新しい基底への変換もされない。
さらに二つの技を重ねる
GaLore が圧縮するのはオプティマイザの状態だけなので、著者らは既存のテクニックを二つ重ねた。一つは Adam を 8-bit Adam に替えることで、以下の「8-bit GaLore」はこの組み合わせを指す。もう一つは層ごとの更新で、逆伝播で一つの層の勾配を計算し終えたらすぐその層を更新し、モデル全体の勾配を最後まで保存しておかずに済ませる。これは LOMO 系のやり方だ。
議論
60M から 1B までの事前学習
実験は ReLoRA の設定を踏襲し、LLaMA アーキテクチャ(RMSNorm、SwiGLU)で、C4 の重複のないデータで学習する。系列長は 256、1 ステップあたり 131K トークン、全体を通して BF16 だ。各手法、各サイズとも 5 通りの学習率から最良のものを選んだ。GaLore はすべてのサイズで学習率 0.01、、 を使い、実効学習率は 0.0025 で、フルランクのベースラインがふつう使う 0.001 以下より大きい。
| 手法 | 60M | 130M | 350M | 1B |
|---|---|---|---|---|
| フルランク | 34.06 | 25.08 | 18.80 | 15.56 |
| GaLore | 34.88 | 25.36 | 18.95 | 15.64 |
| LoRA | 34.99 | 33.92 | 25.58 | 19.21 |
| ReLoRA | 37.04 | 29.37 | 29.08 | 18.33 |
| 78.18 | 45.51 | 37.41 | 142.53 |
原論文 Table 2 をもとに整理。C4 検証セットのパープレキシティで、低いほど良い。rank は順に 128、256、256、512(モデル次元 512、768、1024、2048)。
GaLore は四つのサイズすべてでフルランクにぴったりついていき、1B では差は 0.08 しかない。LoRA と ReLoRA はモデルが大きくなるにつれて差が開いていく。重みを直接 に分解してゼロから学習するのが最も悪く、1B ではパープレキシティが 142.53 になる。メモリについては、1B のパラメータとオプティマイザ状態の見積もりは、フルランク 7.80 GB、GaLore 4.38 GB、LoRA 6.17 GB だ。
この表を読むときは、二つのことを覚えておきたい。ここでのメモリはパラメータ数から見積もった BF16 のサイズで、activation と勾配は含まない。ReLoRA はフルランクのウォームアップを外したうえで比べている。著者らは公平のためだとしているが、ReLoRA はもともとそのウォームアップを必要とする設計だ。LoRA ももともとは微調整のために設計されたものである。
7B とあの 4090
7B の実験は 8 ノード、計 64 枚の A100 で 15 万ステップ、197 億トークンを走らせた。計算資源が限られていたので、8-bit GaLore()と 8-bit Adam はそれぞれ 1 回ずつ、ハイパーパラメータ調整なしで走らせただけだ。
| 手法 | 4 万ステップ | 8 万ステップ | 12 万ステップ | 15 万ステップ |
|---|---|---|---|---|
| 8-bit GaLore | 17.94 | 15.39 | 14.95 | 14.65 |
| 8-bit Adam | 18.09 | 15.47 | 14.83 | 14.61 |
原論文 Table 3 をもとに整理。C4 検証セットのパープレキシティ。
前半は GaLore がわずかに良く、後半は 8-bit Adam が逆転し、最後の差は 0.04 だった。
あの 4090 は別の実験に出てくる。著者らは単一デバイスで実際のメモリを測定した。activation checkpointing はオンにせず、オフロードもせず、トークンのバッチサイズは 256 だ。
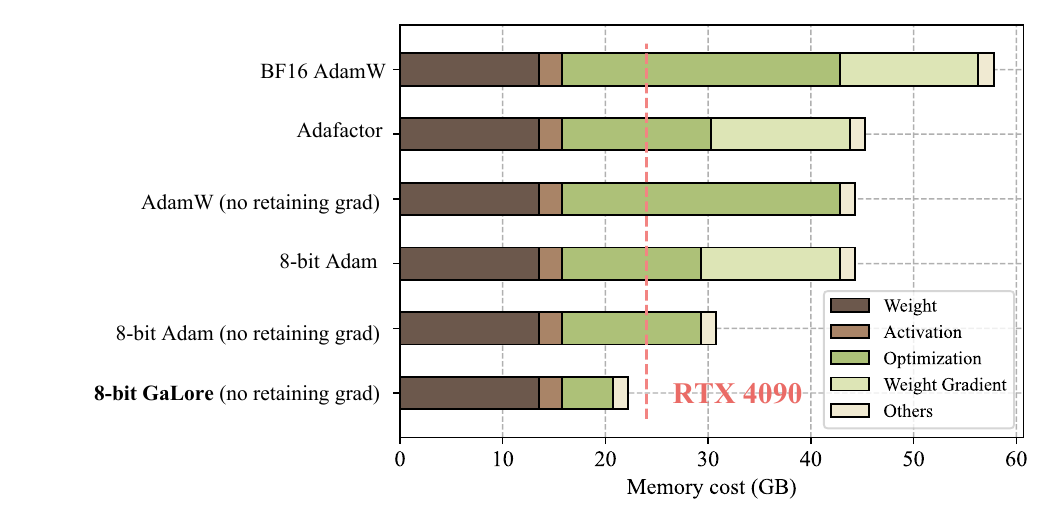
いちばん下の 2 本を見てほしい。勾配を保持しない 8-bit Adam は約 31 GB で、8-bit GaLore に替えるとオプティマイザ状態の部分(濃い緑)がずっと短くなり、合計約 22 GB と、24 GB の赤い破線の左側に収まる。8-bit Adam と比べると、低ランク射影でオプティマイザ状態が 9.6 GB、層ごとの更新で重みの勾配が 13.5 GB 節約される。BF16 の AdamW と比べると、合計で 63.3% の節約だ。
つまり「4090 で 7B を事前学習する」で測っているのはメモリに収まるかどうかで、測定に使ったバッチは 256 トークン(checkpointing なしで最大約 500)しかなく、activation checkpointing をオンにしても 4,096 までだ。論文で実際に最後まで走らせた 7B の実験は、64 枚の A100 を使っている。著者らは多数のコンシューマ向け GPU でデータ並列を組むことを想定しているが、論文では実際には試していない。
速度とハイパーパラメータ
メモリの節約には時間の代償がつく。LLaMA 1B、トークンバッチ 256 の測定では、層ごとの更新をオンにした 8-bit GaLore は毎秒 1,019.63 トークン、8-bit Adam は 1,205.31 で、著者らはこれを約 17% のオーバーヘッドとしている。層ごとの更新をオフにすると、GaLore は 1,109.38 に戻る。
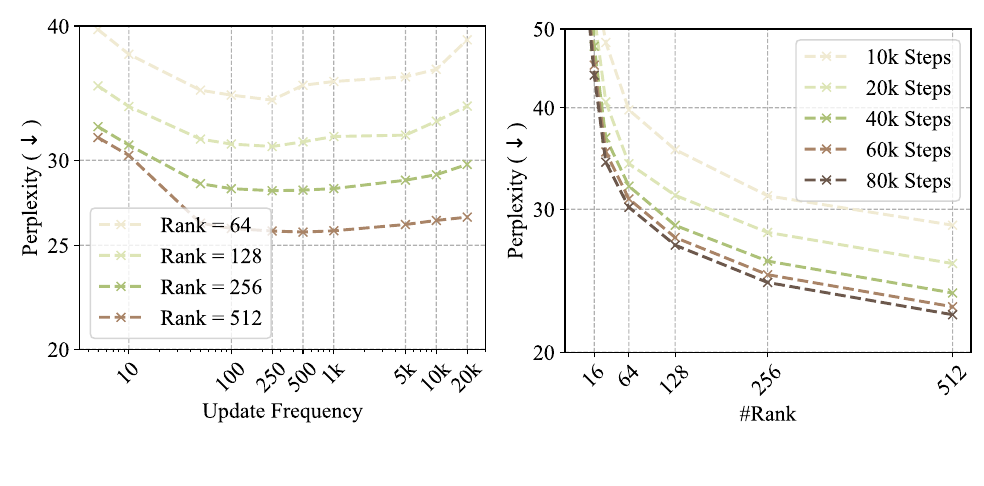
左図は更新頻度 だ。四つの rank はどれも U 字形で、替えるのが頻繁すぎても少なすぎても悪くなり、谷底は 250 から 500 ステップごとに替えるあたりにある。rank が小さいほど、頻繁に替える必要がある。右図は rank で、ある範囲内なら rank を下げても収束が少し遅くなるだけだ。rank 128 で 8 万ステップ走らせると、rank 512 で 2 万ステップ走らせるより良い。言い換えれば、メモリが足りないときは時間と引き換えにできる。
微調整
微調整での比較は、事前学習よりずっと穏やかだ。GLUE 上の RoBERTa-Base では、rank 4 のとき GaLore の平均は 85.89、LoRA は 85.61、全パラメータは 86.28。rank 8 のときは 85.94 対 85.93 で、ほとんど引き分けだ。表のメモリ 253M 対 257M も、パラメータとオプティマイザ状態を数えたものである。付録では LLaMA-7B を OpenAssistant の対話データで微調整していて、テストパープレキシティは GaLore 2.95、LoRA 2.94。比較的はっきり差がついたのは、BERT-Base の SQuAD(F1 88.29 対 86.11)と、Phi-2 の OpenAssistant での微調整(パープレキシティ 3.83 対 4.24)だ。
また、GaLore は毎ステップ重み全体を更新するので、学習が終わると手に入るのは丸ごと新しいモデルだ。LoRA なら小さなアダプタだけを保存し、いつでも付け外しできる。どちらが便利かは、デプロイの要件しだいだ。
その後の検証
SVD のコスト。 論文は SVD のオーバーヘッドを 10% 以内と見積もったが、実際に測った人たちの見方は違う。LLaMA-Factory の作者は GaLore が公開された翌日に第三者による検証を行った。A100 で LLaMA-2 7B を activation checkpointing ありで微調整すると、勾配を保持しない 16-bit GaLore はわずか 18 GB、8-bit AdamW は 40 GB で、通常ステップのスループットも劣らなかった。ただし表の下には、7B では SVD 1 回におよそ 10 分かかり、それは計算に入れていないと注記されている。その後 APOLLO を提案したチーム(GaLore の共著者 2 人を含む)も、LLaMA-7B では 1 回の部分空間更新に約 10 分かかり、200 ステップごとにスループットが落ちると報告している。Hugging Face の統合では、層ごとの更新モードは単一 GPU でしか使えず、DDP に対応しておらず、勾配クリッピングや DeepSpeed も正常に動かないことがある。
収束性。 He らは 2024 年 10 月の論文で明確な反例を示し、標準的な確率的最適化の仮定のもとでは、GaLore が stationary point に収束するとは限らないことを証明した。原因は、SVD が最大の方向だけを選ぶことにある。学習後期には本当の勾配が小さくなってもノイズは残るので、上位 個の特異ベクトルが捉えるのがすべてノイズになりうる。GaLore が保証を持つのは、ノイズがない場合、バッチがステップ数とともに大きくなる場合(たとえば )、ノイズがどの方向にも均一な場合に限られる。彼らが提案した GoLore はランダムな射影を使い、前半は GaLore、最後の区間は GoLore に切り替えることを勧めている。
規模。 2025 年 4 月、GaLore の著者のうち Jiawei Zhao と Yuandong Tian の 2 人が、Meta の PyTorch チームとともに GaLore 2 を発表した。そこでは LLaMA 7B の SVD は 1 回あたり最大 20 分かかり、ランダム化 SVD に替えると 15 倍速くなると明記している。SVD の符号が一意でないため、2 回の分解で得た射影が対応しないことがあるとも書いている。今回は 32 ノード、256 枚の H100 で 5,000 億トークンを使い、LLaMA 7B をゼロから学習した。対照は 8-bit Adam だ。GaLore は最初の 1,500 億トークンではわずかに遅れ、約 2,000 億で前に出て、最後は両者が同程度になった。
結論
重みはフルランクのまま、オプティマイザの状態だけを勾配の低ランク部分空間に入れ、定期的に部分空間を取り替える。これが GaLore と LoRA の最も根本的な違いだ。1B 以下の事前学習では、フルランクの Adam とのパープレキシティの差はコンマ数程度で、LoRA よりはるかに良い。7B は 1 回しか走らせていないが、最後は 8-bit Adam とほぼ同じだった。代償は、数百ステップごとの SVD と、特定の条件でしか成り立たない理論だ。
単一のコンシューマ向け GPU で全パラメータの微調整をしたいなら、GaLore は試す価値がある。手をつける前に SVD 1 回にどれだけかかるかを一度測り、層ごとの更新をオンにしたあとも、もともとのマルチ GPU の設定がまだ使えるかどうかを確かめておこう。単にメモリを節約して微調整したいだけなら、たいていは LoRA や QLoRA のほうが手間がかからない。
あの 4090 はその後どうなったのか。GaLore 2 の規模の検証に使われたのは、256 枚の H100 だった。