原始論文
Shampoo: Preconditioned Stochastic Tensor Optimization
- 發表版本
- ICML 2018會議
- arXiv 首次提交
- arXiv:1802.09568
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersshampoo2018,
  title = {{Shampoo: Preconditioned Stochastic Tensor Optimization}},
  author = {Vineet Gupta and Tomer Koren and Yoram Singer},
  year = {2018},
  eprint = {1802.09568},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1802.09568}
}
這篇論文的名字,藏在第 2 頁的一個腳註裡,「We call it Shampoo because it has to do with preconditioning.」
conditioner 是潤髮乳,preconditioning 就是「潤髮之前」,那當然是洗髮精。致謝裡還特別感謝 Roy Frostig 想出這個名字。
笑話歸笑話,論文要處理的是一個很實際的麻煩。優化器如果想看清楚參數之間怎麼互相牽動,就得維護一個「參數數量平方」大小的矩陣;Google Brain 的 Vineet Gupta、Tomer Koren 與 Princeton 的 Yoram Singer 想找一個辦法,讓這個矩陣不用真的存下來。
定義問題
預條件在做什麼
最樸素的梯度下降,每個參數都用同一個學習率往梯度的反方向走。預條件方法在走之前,先拿一個矩陣乘一下梯度:
如果是對角矩陣,效果就是每個參數各自縮放步長,Adam、AdaGrad 都屬於這一類。 如果是完整的矩陣,它還能把梯度「轉個方向」。當損失地形是一條斜著的狹長山谷,兩個參數必須一起動才能沿谷底前進,對角矩陣只能分別縮放兩個座標軸,完整矩陣才能把那條斜谷轉正。
full-matrix AdaGrad 太大了
AdaGrad 有一個完整矩陣的版本,預條件是累積梯度外積的平方根:
理論性質比對角版好,但沒人用得起。拿一個 的全連接層來算,攤平後有 萬個參數, 就是 ,約 個元素,單精度要 4 TB 以上;每次還要對它開根號再求逆,計算量是 。
當時的出路有幾條。對角近似便宜,但參數之間的相關全部丟掉;sketch 或其他估計法,作者評為「seldom practical at large scale」。K-FAC 也用 Kronecker 分解,但它近似的是 Fisher 矩陣,要從模型的預測分佈取樣,還依賴前饋網路的反向傳播結構,換一個架構就得重新推導。
神經網路的參數本來就是矩陣與張量。全連接層是 ,卷積核是四維。這篇的問題是,能不能保留這個形狀,用幾個小矩陣去近似那個巨大的預條件?
解決問題
左右各一個
在矩陣情形,Shampoo 為一個 的權重矩陣維護兩個預條件,左邊 、右邊 (Algorithm 1):
初始值是 、。 累積的是各「列」之間的相關,對全連接層來說是輸出單元之間; 累積的是各「行」之間,也就是輸入特徵之間。更新時,梯度從左邊乘一次、右邊乘一次。
同樣那個 的層, 與 加起來是 萬個元素,單精度 8 MB。記憶體從 降到 ,算矩陣次方的成本從 降到 。
這兩個小矩陣其實就是一個大矩陣的偽裝。論文的 Lemma 4 給出 Kronecker 積的恆等式,把 攤平後,等於 乘上攤平的梯度。所以 Shampoo 等於在用一個 的預條件 ,只是這個矩陣從頭到尾沒有被組出來。
寫成程式,一個矩陣參數的更新就這幾行:
import torch

def matrix_power(A, p):
    """對稱正定矩陣的 p 次方:特徵分解後只對特徵值取次方"""
    lam, Q = torch.linalg.eigh(A)
    return Q @ torch.diag(lam ** p) @ Q.T

class ShampooMatrix:
    """Algorithm 1:替一個 m×n 的權重矩陣做 Shampoo"""
    def __init__(self, m, n, lr, eps=1e-4):
        self.L = eps * torch.eye(m)   # L_0 = εI_m
        self.R = eps * torch.eye(n)   # R_0 = εI_n
        self.lr = lr

    @torch.no_grad()
    def step(self, W, G):
        self.L += G @ G.T             # 累積 m×m 的左統計量
        self.R += G.T @ G             # 累積 n×n 的右統計量
        W -= self.lr * matrix_power(self.L, -0.25) @ G @ matrix_power(self.R, -0.25)
論文自己的實作是 TensorFlow,矩陣次方用 SVD 算,作法相同。
為什麼是 1/4
AdaGrad 開根號,所以指數該是 才對?Shampoo 用的卻是 ,而且左右各一次。
答案在 Lemma 8。假設每一步的梯度矩陣秩不超過 ,作者證明:
左邊是 full AdaGrad 的統計量。證明分兩步。先分別證出 和 ,也就是左右各有一個上界;再用矩陣幾何平均的單調性,把兩個上界各取 次方相乘。第一個 從這裡來。
AdaGrad 的預條件還要對統計量開一次根號。開根號在半正定矩陣上保持順序,兩邊同取 次方,就得到
所以 ,一半來自幾何平均,一半來自 AdaGrad 的平方根。Shampoo 的 是一個蓋在 full AdaGrad 預條件上方的 Kronecker 結構矩陣。作者特別指出,full-matrix 預條件中最影響預條件效果的那些小特徵值,不會因為這個近似而消失。
論文另外給了一個直覺,這個指數讓整體步長以 衰減,正是隨機最佳化常見的速率。梯度大小穩定時, 和 大致隨步數 線性成長, 和 各貢獻 ,合起來剛好是 。
這個 是證明裡上界的產物。後來的實作把指數開放成可調,常改用 ,討論時再回來看。
張量版本
卷積核是四維的。Shampoo 的一般形式(Algorithm 2)替張量的每一維 維護一個 的預條件 ,統計量是把梯度沿其他所有維收縮後得到的矩陣;更新時逐維乘上 , 是張量的階數。矩陣 ,回到 。
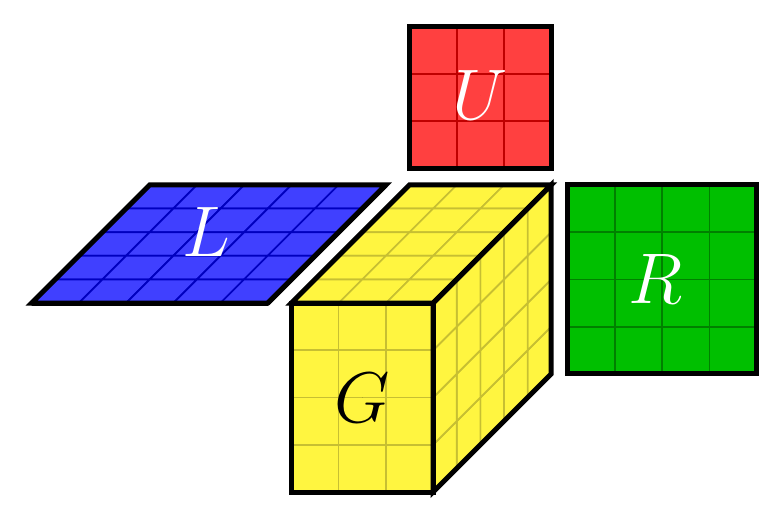
拿論文 CIFAR-100 實驗裡最大的卷積核 來算,它有 589,824 個參數,full AdaGrad 的預條件約 個元素;Shampoo 只需要四個矩陣, 個元素,指數是 。
收斂保證與它的條件
理論在線上凸最佳化框架下證明(Theorem 7)。梯度秩不超過 時,regret 上界是
是迭代過程中 與最優解距離的最大值。若梯度的譜範數不超過 1,兩個 trace 各以 成長,總 regret 是 ,在線上凸最佳化裡已經是最好的速率。張量版本(Theorem 10)同理, 換成各維秩的幾何平均。
條件要讀清楚。損失必須是凸的; 可能隨 變大,要讓它有界,得在每一步把 投影回一個球裡,而這個投影要用 誘導的範數,計算很貴,作者便在演算法裡省略,接受一個「slightly looser」的界。深度網路不是凸的,這組證明是演算法的出處和動機,實驗才是它在神經網路上的證據。
落地時的妥協
實作上有兩個取捨。每個參數張量各自處理,整體是 block-diagonal 的預條件,不同層之間的相關直接忽略。某一維太大時(實驗門檻約 1200),那一維自動改用對角版本(附錄 A 的 Algorithm 3),只存對角元素。另外,實驗時再加兩個啟發式調整,矩陣根每 20 到 100 步才重算一次,以及係數 0.9 的梯度動量;作者說前者對準確率「almost no impact」。
討論
實驗規模很小
所有實驗的批次大小都是 128,預條件用整個 batch 的平均梯度更新。影像分類用 CIFAR-10 上 2.4M 參數的 32 層 ResNet 和 1.65M 參數的小型 Inception,CIFAR-100 上 13.5M 參數、不含 BatchNorm 的 55 層 ResNet;每個優化器在 0.01 到 10 之間掃 10 個學習率。這部分論文只畫訓練損失曲線,沒有測試準確率的對照表。
語言模型是 LM1B 上 9.8M 參數的 Attention 模型,最大的張量是 。
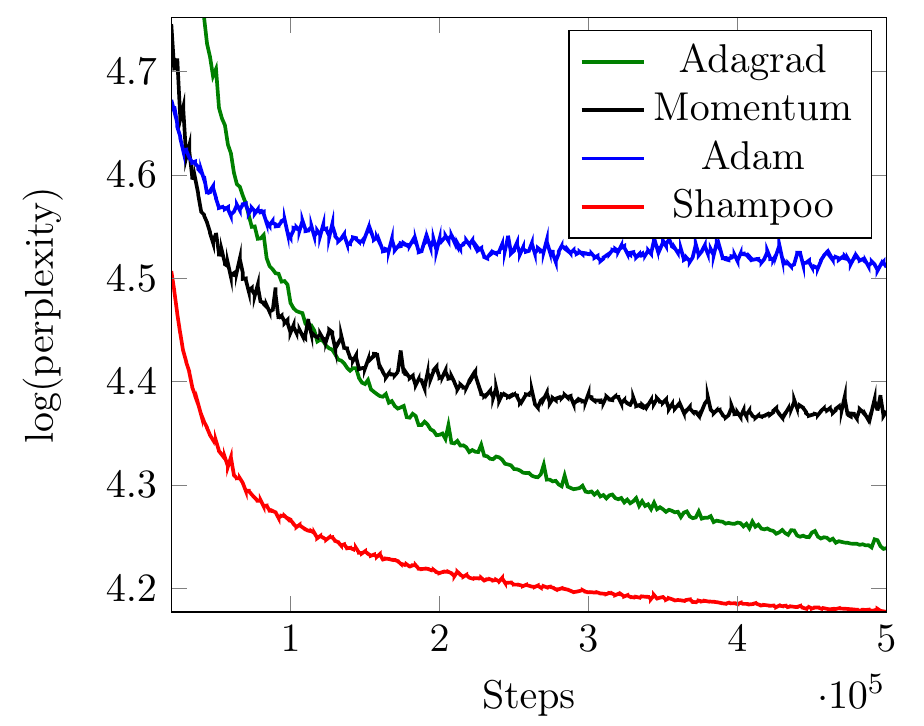
紅線從第一個點開始就在最下面,到 50 萬步時約 4.18,綠色的 AdaGrad 約 4.24,黑色的 Momentum 約 4.37,藍色的 Adam 很早就停在 4.5 附近。
這張圖的比較條件不對稱。Shampoo 直接用預設學習率 ,其他方法「explored various different settings」,但論文沒列出 Adam 掃過哪些值。Adam 在 Attention 模型上落後 AdaGrad 一大截,本文的推論是,這和後來 Transformer 普遍用 Adam 訓練的經驗不太一致,差距很可能來自調參的不對稱,讀這張圖時要把它算進去。
每一步多花多少
論文用一張每秒步數的表回應「矩陣運算會不會太慢」(Tesla K40,批次 128):
| 實驗 | SGD | Shampoo | 比值 |
|---|---|---|---|
| ResNet-32(C10) | 2.184 | 2.151 | 98% |
| Inception(C10) | 3.638 | 3.506 | 96% |
| ResNet-55(C100) | 1.210 | 1.249 | 103% |
| Attention(LM1B) | 4.919 | 3.509 | 71% |
整理自原論文 Table 1,比值為本文計算;Adam、AdaGrad 的數字與 SGD 相近,表中省略。
卷積網路上幾乎沒差,ResNet-55 甚至比 SGD 快一點。LM1B 的每秒步數只剩 SGD 的 71%,論文沒有分析原因;這個模型最大的張量是 ,照實驗用的約 1200 門檻,2000 那一維會改走對角版本。這組數字是在模型只有幾百萬參數、根每 20 到 100 步算一次的條件下量的。
後來的 Shampoo
2018 年的原版離大規模訓練還很遠。後面兩個版本做的主要是工程。
Anil 等人(2020)的 Distributed Shampoo。 作者群包含原論文三位,論文題名是〈Scalable Second Order Optimization for Deep Learning〉。他們發現真實模型的 條件數極大,矩陣根必須用雙精度算,這在 TPU 上很貴。改動包括:
- 加速器每一步只累積統計量,逆 次方根每 步送到主機的 CPU 上非同步計算,分散到所有核心,不擋訓練迴圈;
- 用 coupled Newton 迭代取代 SVD 算逆根,搭配 warm start;
- embedding、softmax 這類維度上百萬的層只做單邊預條件,大型全連接層切成區塊各自預條件;
- 預條件每幾百步才更新一次;
- grafting,方向取 Shampoo,步長大小取一個調好的一階方法(例如對角 AdaGrad),每層各自嫁接;
- 指數改成可調的超參數,統計量改用指數移動平均。
結果是 WMT'14 英翻法的 Transformer 步數減半,牆鐘時間少 45%(約 12 小時降到 6.7 小時)。
Shi 等人(2023)的 PyTorch 版。 Meta 團隊針對 GPU 的資料平行訓練重寫。每個 worker 只負責一部分參數區塊的預條件,算完再用 AllGather 收齊方向,每一步的牆鐘時間比對角方法最多多 10%。矩陣根改用 torch.linalg.eigh,他們發現單精度通常夠用;小維度合併、大維度切塊,ImageNet 實驗的區塊上限設為 2048;grafting、偏差修正、decoupled weight decay、Nesterov 一應俱全。在 ImageNet 的 ResNet-50 上,Shampoo 用 60 個 epoch 達到 SGD-Nesterov 90 個 epoch 的驗證準確率,總牆鐘時間快 1.35 倍。
AlgoPerf 2024。 MLCommons 在 2024 年 8 月公布第一屆 AlgoPerf 訓練演算法競賽的結果,外部調參組冠軍就是這份 PyTorch Distributed Shampoo,分數 0.78,平均比 NAdamW 基準快約 28%。賽後分析論文的細節更值得看。八個工作負載裡,它只在 Criteo 1TB 和 ViT 兩項最快;WMT 花的時間是最快提交的兩倍以上;ResNet 則沒能在時間預算內穩定達標。它贏在幾乎每一項都穩定地不差。
同一年的 Gemini 1.5 技術報告也寫到,1.5 Flash「is trained with higher-order preconditioned methods」,引用了 AdaGrad 等文獻,沒有點名是哪一個方法。
1/4 還是 1/2
指數的問題後來有了答案。Anil 等人在附錄寫到,把指數當成超參數有時效果更好,他們的自編碼器實驗用的就是 ;Shi 等人的實作則建議,以全連接層為主的網路可以把指數覆寫成 ,同樣是 ,或把原本的指數乘上 1.82 倍。Morwani 等人(2024)給了解釋, 恰好等於「求 full AdaGrad 統計量的最佳 Kronecker 近似」做一步冪迭代的結果,而且很接近最佳近似。既然 本身就在近似 ,要模仿 AdaGrad 的 次方,左右各取 才對。以 Morwani 等人(2024)的結果回頭看,本文把原論文的 概括為一個不夠緊的上界帶出的指數。
也沒有白費。把累積拿掉,只看當下這一步的梯度 :
所有奇異值都被壓成 1,這就是 Muon 的正交化更新。Shampoo 的第一步,統計量裡只有一個梯度,ε 很小時走的方向就是 ;用上面的程式碼對一個 的隨機梯度走一步,結果和 只差 ε 造成的偏移,多半在 量級。Keller Jordan 在 2024 年 12 月介紹 Muon 的文章裡也寫到,沒有累積的 Shampoo 再加上動量就是 Muon,差別在 Shampoo 要算逆四次根,Muon 用 Newton–Schulz 迭代便宜地近似。
結論
Shampoo 用兩個小矩陣的 Kronecker 積,近似 full-matrix AdaGrad 那個存不下的預條件,記憶體從 降到 ,並在凸設定下證明了 的 regret。論文的實驗只到千萬參數,主要證明「每一步沒有慢太多」。
如果今天要試,直接拿 Meta 的 Distributed Shampoo,從 grafting 用 Adam、指數 、預條件每幾十步更新一次開始調,並先量好你的模型裡最大那一維讓每一步慢了多少。原版的程式碼留著理解演算法就好。
論文第 12 頁寫著「We plan to implement Shampoo in PyTorch in the near future」。後來拿下 AlgoPerf 冠軍的,正是 Meta 團隊在五年後寫成的 PyTorch 版。