原論文
Sharpness-Aware Minimization for Efficiently Improving Generalization
- 発表先
- ICLR 2021国際会議
- arXiv への初回投稿
- arXiv:2010.01412
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerssam2020,
  title = {{Sharpness-Aware Minimization for Efficiently Improving Generalization}},
  author = {Pierre Foret and Ariel Kleiner and Hossein Mobahi and Behnam Neyshabur},
  year = {2020},
  eprint = {2010.01412},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2010.01412}
}
同じ ResNet でも、SGD で学習させると、最後は尖った狭い穴の中に止まる。別の学習法に替えると、広いお椀の底に止まる。どちらの点も学習損失はとても低く、モデルのパラメータ数も同じだ。
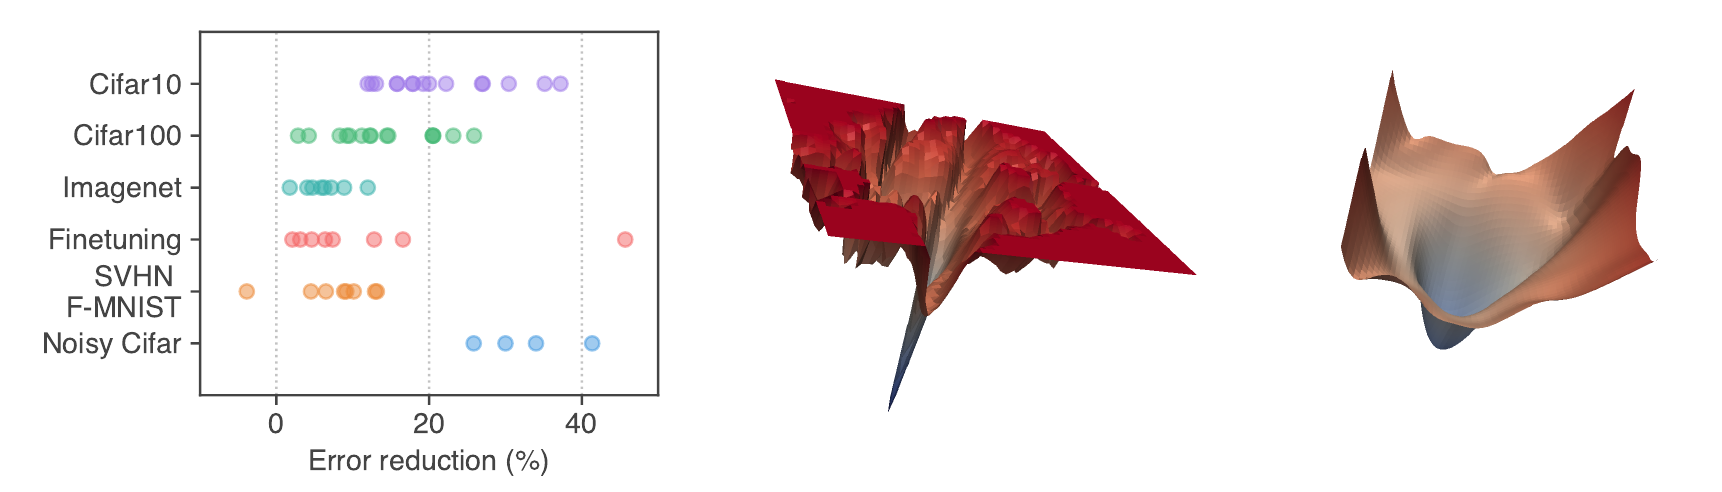
中央と右の二つの地形図は、Google Research の Pierre Foret、Ariel Kleiner、Hossein Mobahi と、Alphabet 傘下の Blueshift の Behnam Neyshabur が論文の 1 ページ目に載せた画像だ(残差接続を取り除いた ResNet-56 を使っている)。左図は彼らの戦績だ。数十の設定のうち、SAM に替えると誤り率はほとんどすべてで下がり、下げ幅は数ポイントから 4 割以上まである。
「平坦な最小値のほうが汎化する」という説はかなり古く、少なくとも 1990 年代までさかのぼれる。この論文のやり方は、平坦さが欲しいなら平坦さを直接目的関数に書き込んでしまい、しかも ImageNet の学習に使えるほど安くする、というものだ。
問題の定義
現代のニューラルネットワークは、学習データを丸ごと覚えられるほどパラメータが多い。学習損失には、ほぼ同じくらい低い最小値がたくさんあるが、テストセットでの性能は大きく違い、どれを選ぶかはオプティマイザとその設定に大きく左右される。
シャープネス(sharpness)と汎化の関係については、すでに多くの研究がある。Keskar らは、大きなバッチで学習すると尖った最小値に止まりやすく、汎化が悪くなることを観察した。Jiang らは 2019 年に 40 種類の複雑さの尺度を比べ、シャープネスに基づく尺度が汎化ギャップと最も高い相関を示した。
問題は、これまで提案されたシャープネスの尺度の多くが計算しにくく、微分するのはなおさら難しいことだ。Entropy-SGD は代わりに局所エントロピーを正則化する。SWA は学習の終盤の重みを平均して、より平坦な位置に落ち着けるが、シャープネスを直接は最小化していない。著者らが求めたのは、シャープネスを直接最適化でき、しかも大規模モデルにまで拡張できる手順だ。
問題の解決
汎化界から min-max へ
出発点は PAC-Bayes の汎化界(Theorem 1 の非形式的な版)だ。任意の について、高い確率で次が成り立つ。
は母集団の損失、 は学習損失、 は増加関数だ。右辺を分解すると次のようになる。
角括弧の中が測っているのは、「 から出発して半径 の球の中で、損失が最大でどれだけ上がりうるか」で、これがシャープネスだ。著者らは を一般的な L2 正則化 に置き換え、SAM の目的関数を得る。
「それ自体の損失が低い」点ではなく、「近傍全体の損失が低い」点を探すことにしたわけだ。
一次近似:
内側の最大化は厳密には解けない。著者らは を のまわりで一次のテイラー展開する。
ノルム球の中で内積を最大にする問題の答えは、古典的な双対ノルムの問題になる。 を取ると、解は勾配を長さ にスケーリングしたものだ。
つまり、勾配の方向に沿って「上り坂」へ だけ進む。付録では ()も試したが、効果は に及ばなかった。ランダムな方向で同じ長さの摂動も、勾配に沿った摂動に及ばない。
次に の勾配を計算する。 自体が の関数なので、連鎖律から という項が出てきて、その中にヘッセ行列が隠れている。
2 番目の項は Hessian-vector product で計算できるが、著者らは計算を節約するためにそのまま捨て、最終的な勾配は次のようになる。
摂動後の点 へ行って勾配を取り、その勾配で元の を更新する。
2 次の項を捨てるのは近似で、著者らは付録で比較している。学習の前半では、2 次の項の有無による二つの更新方向はほとんど同じで、cosine 類似度は 1 に近い。収束に近づいてようやく分かれ、しかも 2 次の項を含まない版のほうがテスト誤差は低かった。著者らはその理由が「quite unclear」だと認めている。内側で射影勾配上昇を何ステップか多く進め、最悪点をより正確に見つけることも試した。CIFAR-10 のテスト誤差は 1、2、3、5 ステップでそれぞれ 2.77%、2.76%、2.73%、2.77% で、ほぼ同じだった。CIFAR-100 では複数ステップのほうが少し良い(16.72% 対 16.6% 前後)。
2 回の勾配
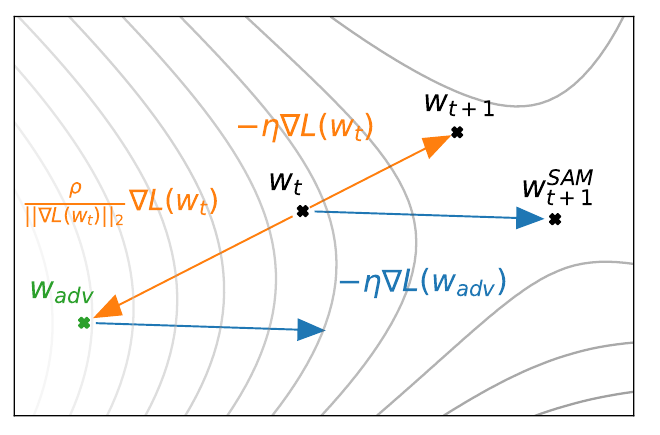
この図に沿って一通りたどってみよう。 から始めると、通常の SGD は に沿って右上の へ進む。SAM はまず逆に、勾配に沿って上り坂を少し進み、 に着く。これは半径 の中で損失が最も高い点の一次の推定だ。 で勾配を計算すると青い矢印 が得られる。この矢印を に移して出発させた終点が、SAM の になる。二つの終点は方向が違い、SAM が進むのは「最悪の場合でも下がる」方向だ。
だから各ステップで順伝播と逆伝播が 2 回ずつ必要で、計算量は元の 2 倍になる。PyTorch で書くと次のようになり、ベースのオプティマイザは通常の SGD だ。
import torch

def sam_step(model, loss_fn, x, y, base_opt, rho=0.05):
    """SAM の 1 回の更新(p = 2):まず近傍で最悪の点へ行き、そこでの勾配で元の重みを更新する"""
    params = [p for p in model.parameters() if p.requires_grad]

    loss_fn(model(x), y).backward()                    # 1 回目の逆伝播:∇L(w)
    with torch.no_grad():
        norm = torch.norm(torch.stack([p.grad.norm() for p in params]))
        eps = [rho * p.grad / (norm + 1e-12) for p in params]   # ε̂ = ρ ∇L / ‖∇L‖₂
        for p, e in zip(params, eps):
            p.add_(e)                                  # w → w + ε̂
    base_opt.zero_grad()

    loss_fn(model(x), y).backward()                    # 2 回目の逆伝播:∇L(w + ε̂)
    with torch.no_grad():
        for p, e in zip(params, eps):
            p.sub_(e)                                  # w に戻る
    base_opt.step()                                    # w ← w − η ∇L(w + ε̂)
    base_opt.zero_grad()
ここでのノルムは、すべてのパラメータの勾配を 1 本のベクトルにつないで計算していて、モデル全体で一つの を共有する。
の選び方
は SAM が新たに加える唯一のハイパーパラメータだ。著者らは の中から、学習データの 10% を検証セットにして選んだ。CIFAR で選ばれた値は 0.02〜0.2 の間だった。また は「solid default」だとも言っている。付録ではすべての CIFAR とファインチューニングの実験を 0.05 で走らせ直していて、結果は を調整した版とほとんど同じか、わずかな差しかなく、どれも SAM を使わないベースラインに勝っていた。ImageNet の実験はすべて 0.05 を使っている。
はパラメータ空間での絶対的な距離であることに注意してほしい。同じ 0.05 でも、値の大きな重みにとっては小さな摂動で、値の小さな重みにとっては大きな摂動だ。この点は後でまた出てくる。
議論
比較の条件
どの実験でも、元の学習手順をそのまま SAM に置き換えている。SAM は各ステップで勾配を 2 回計算するので、著者らは SAM を使わないベースラインに 2 倍のエポックを走らせ、標準の長さと 2 倍の長さのうち良いほうを取った。多くの場合、長くしてもはっきりした効果はなかったという。各設定を 5 回走らせ、平均と 95% 信頼区間を報告している。実装は JAX で、複数のデバイスを使うときは、各デバイスが割り当てられたサブバッチでそれぞれ と SAM の勾配を計算し、最後に平均する。この細部は、後でとても重要になる。
CIFAR
CIFAR のモデルは、すでによく調整された WideResNet、Shake-Shake、PyramidNet で、それ自体がさまざまな正則化を備えている。いくつかの行を抜き出して見る。
| モデルと拡張 | CIFAR-10 | CIFAR-100 |
|---|---|---|
| WRN-28-10、200 ep、基本 | 2.7/3.5 | 16.5/18.8 |
| WRN-28-10、1800 ep、AA | 1.6/2.2 | 12.8/16.1 |
| PyramidNet、基本 | 2.7/4.0 | 14.6/19.7 |
| PyramidNet+ShakeDrop、AA | 1.4/1.6 | 10.3/10.6 |
原論文 Table 1 をもとに整理。各セルは「SAM/SGD」のテスト誤り率(%)で、AA は AutoAugment。
単純な WideResNet に SAM を加えるだけで、CIFAR-10 の誤り率は 2.2% から 1.6% に下がる。以前なら PyramidNet に ShakeDrop を加えるような複雑な組み合わせでないと届かなかった水準だ。すでに強く正則化された PyramidNet+ShakeDrop では改善はずっと小さく、CIFAR-100 は 10.6% から 10.3% だが、これも当時、追加データを使わない場合の最高成績だった。
ImageNet
ResNet-50、101、152 を、バッチ 4096、モーメンタム付き SGD、cosine スケジュール、label smoothing、 で、最大 400 エポック学習させる。
| モデル | 100 ep | 200 ep | 400 ep |
|---|---|---|---|
| ResNet-50 | 22.5/22.9 | 21.4/22.3 | 20.9/22.3 |
| ResNet-101 | 20.2/21.2 | 19.4/20.9 | 19.0/22.3 |
| ResNet-152 | 19.2/20.4 | 18.5/20.3 | 18.4/20.9 |
原論文 Table 2 をもとに整理。各セルは「SAM/標準の学習」の top-1 誤り率(%)。
この表は横に読む。標準の学習は 200 から 400 エポックで良くなるどころか悪くなり、ResNet-101 は 20.9% から 22.3% に後退する。典型的な過学習だ。SAM はずっと良くなり続ける。さらに計算量でそろえると、SAM の 200 エポックのコストは標準の学習の 400 エポックにほぼ等しく、ResNet-50 は 21.4% 対 22.3%、ResNet-152 は 18.5% 対 20.9% で、やはり SAM が勝つ。100 対 200 エポックにすると、ResNet-50 の SAM は 22.5% で、標準の学習の 22.3% にわずかに負ける。
ファインチューニング
公開されている EfficientNet のチェックポイントからファインチューニングする。EfficientNet-L2 自体は、すでに NoisyStudent で ImageNet と JFT を使って 88.2% まで学習されている。SAM でファインチューニングすると、ImageNet の top-1 誤り率は 11.8% から 11.39% に、CIFAR-100 は 4.07% から 3.92% に、Stanford Cars は 4.93% から 4.04% に下がった。このうち ImageNet と CIFAR-100 は当時の記録を更新した。ファインチューニングでは BN の統計量を凍結し、ImageNet では 10 エポックだけ学習させた。
ラベルノイズ
SAM が探すのは「周りのどこでも摂動に強い」パラメータなのだから、学習データのノイズにも強いのではないか、と著者らは考えた。実験では CIFAR-10 の学習セットの一部のラベルをランダムに入れ替え、テストセットはきれいなままにして、ResNet-32 を 200 エポック学習させた。
| 手法 | 20% | 40% | 60% | 80% |
|---|---|---|---|---|
| SGD | 84.8 | 68.8 | 48.2 | 26.2 |
| Mixup | 93.0 | 90.0 | 83.8 | 70.2 |
| SAM | 95.1 | 93.4 | 90.5 | 77.9 |
| Bootstrap+SAM | 95.4 | 94.2 | 91.8 | 79.9 |
| MentorMix | 95.6 | 94.2 | 91.3 | 81.0 |
原論文 Table 4 をもとに整理。列はノイズの割合で、数値はきれいなテストセットでの正解率(%)。MentorMix は文献の数値。
ラベルの 80% が間違っているとき、SGD は 26.2% しか残らないが、SAM は 77.9% を保つ。SAM を単独で使うだけで、ノイズラベル専用のどの手法にも勝ち、負けるのは MentorMix だけだ。一度学習させてから、モデル自身の予測をラベルにして学習し直す(Bootstrap)と、MentorMix とほぼ並ぶ。この実験の は 0.1 で、80% のノイズでは 0.05 に変えてようやく安定して収束した。
m-sharpness:各デバイスで別々に摂動する
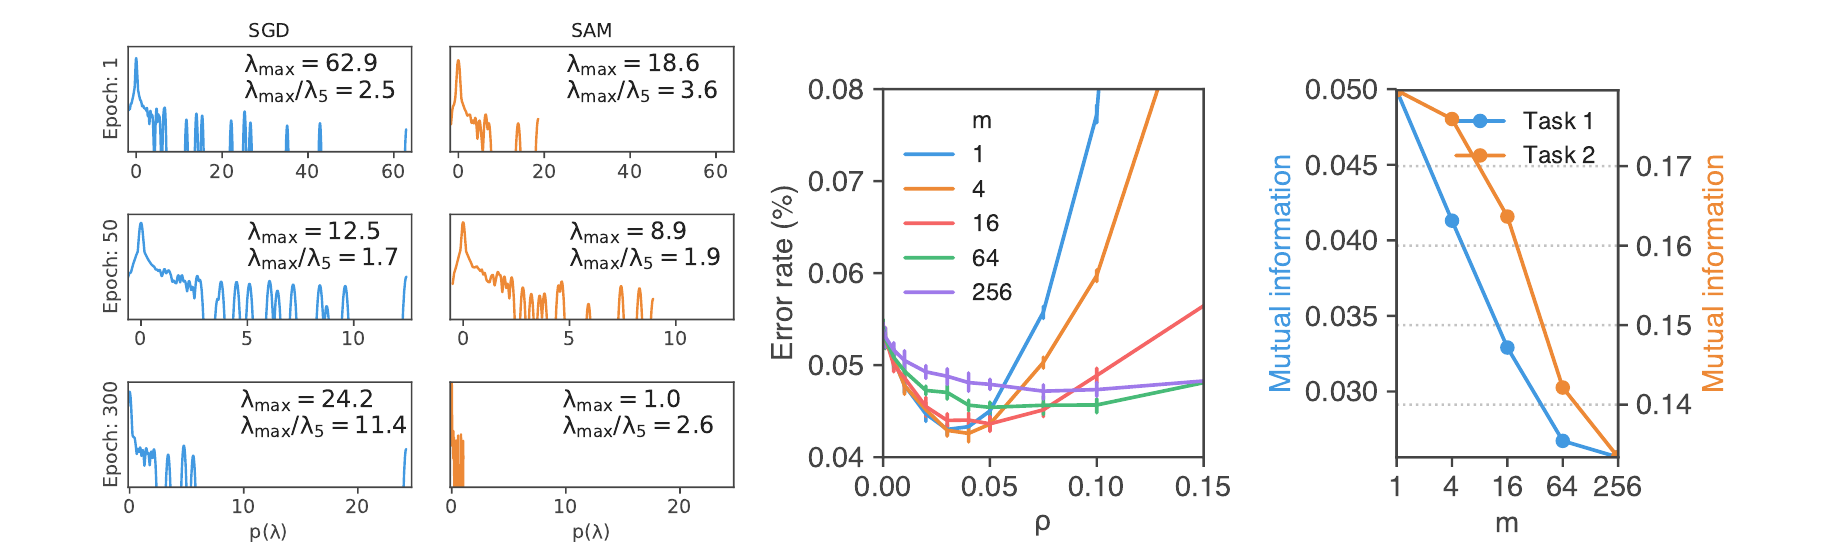
先ほど、複数デバイスでは各デバイスが別々に摂動を計算すると触れた。これは目的関数を「 件のデータごとに 1 回ずつ最大化し、それを足し合わせる」ものに変えることに等しく、 は各デバイスに割り当てられたサンプル数だ。著者らはこのシャープネスを m-sharpness と呼んでいる。
まず中央の図を見る。縦軸には % と書かれているが、数値は比率で、0.05 は 5% のことだ。 のとき誤り率は約 5.3%。 と の最低点は約 4.3% だが、 が 0.05 を超えるとすぐに悪くなる。 の紫の線が最も平らで、最低でも約 4.7% までしか下がらない。小さな のほうが効果が高く、これはちょうど複数デバイスでの並列化の要求とも両立する。右図は、 が小さいほど、m-sharpness が実際の汎化ギャップを予測する力が強いことを示している。著者らはこれをもとに、m-sharpness は学習セット全体のシャープネスよりも汎化をうまく記述できるかもしれないと考えている。
左の 6 枚の小さな図は、SAM が本当に曲率の低い場所に止まっていることを確かめるものだ。これは BN を含まない WideResNet-40-10 で、Lanczos 法でヘッセ行列の固有値分布を推定している。学習の終わりには、SGD の最大固有値は約 24、SAM は約 1.0 で、分布全体を表す は 11.4 から 2.6 に下がる。
この節には実装上の帰結が一つある。PyTorch の DistributedDataParallel では、backward() が各デバイスの勾配を自動的に平均する。1 回目の逆伝播をいつもどおり同期させると、 はバッチ全体で計算したものになり、 が一気に大きくなる。davda54/sam は、1 回目の逆伝播を model.no_sync() の中に置き、各デバイスで別々に摂動させたままにすることを勧めている。
その後の SAM の理解
シャープネスそのものに問題がある
SAM の発表の 3 年前に、Dinh らは「平坦」という概念が深層ネットワークではあまりしっかり成り立たないことを指摘していた。ReLU は を満たすので、ある層の重みを 倍し、次の層を で割っても、ネットワークが計算する関数はまったく同じだが、パラメータ空間での損失地形の形は引き伸ばされる。彼らはまず 1 隠れ層のネットワークで証明し、それから多層に一般化して、ヘッセ行列が 0 でないどんな最小値に対しても、関数が同じでヘッセ行列のスペクトルノルムが任意に大きいパラメータを見つけられることを示した。関数が同じなら汎化も当然同じなのに、シャープネスはいくらでも変えられる。だから元のパラメータ座標で測ったシャープネスは、それだけでは汎化を説明できない。
SAM の にも同じ問題がある。 はパラメータ空間での絶対的な距離だからだ。ASAM(Kwon ら、2021)は摂動の範囲を重みの大きさに応じてスケーリングするように変え、制約を にした。ここで で、この「adaptive sharpness」は上のスケーリングに対して不変だ。 のとき摂動は となり、重みが大きい座標ほど摂動が大きい。そのため は約 10 倍大きくする必要がある(CIFAR-10 で 0.5、CIFAR-100 で 1.0)。ImageNet での ResNet-50 の top-1 正解率は、SGD、SAM、ASAM でそれぞれ 75.79%、76.39%、76.63% だ。
汎化界では SAM を説明できない
Andriushchenko と Flammarion(2022)は、SAM の理論的根拠を改めて検証した。汎化界から導かれるのは学習セット全体で最大化する版で、彼らはこれを n-SAM と呼ぶ。論文で実際に使っているのは、バッチごとに摂動する m-SAM だ。CIFAR で実測すると、ランダムな摂動はほとんど効果がなく、n-SAM もほとんど効果がなかった。 が小さい版(たとえば 128-SAM)だけが、はっきりと汎化を改善した。汎化界が理由なら n-SAM が最も良いはずなのに、結果はちょうど逆だった。彼らの結論は、既存の汎化界では SAM を説明できず、しかも m-sharpness で測った「より平坦」が、より良い汎化をもたらすとも限らない、というものだ。
彼らは使える観察もいくつか示している。対角線形ネットワークでは、1-SAM の暗黙のバイアスはより疎な解を好み、その傾向は n-SAM や通常の学習よりも強い。CIFAR では、最後の約 10% のエポックだけ通常の学習から SAM に切り替えるだけで、汎化がはっきり改善する。だから既存のモデルのファインチューニングに SAM を使える。
2023 年、Andriushchenko らは範囲を ImageNet での Transformer、CLIP のファインチューニング、BERT にまで広げた。結果は、シャープネス(adaptive sharpness を含む)と汎化の相関は良くなく、むしろ学習率のような学習設定と相関していた。いくつかのケースでは、尖った最小値ほど分布外データでの性能が良かった。
広く使われている
理論の論争はともかく、SAM は実務で広く使われている。Chen ら(2022)は、大規模な事前学習を使わず、単純なデータ拡張だけで ImageNet でゼロから学習させると、ViT が収束する最小値が極めて尖っていることを見出した。SAM を加えると、ViT-B/16 の top-1 は 74.6% から 79.9% に、MLP-Mixer-B/16 は 66.4% から 77.4% に上がった。NFNet の最大の F6 モデルも、SAM を加えてようやく 86.5% の正解率を得た。
結論
SAM は「近傍全体の損失が低くなければならない」ことを min-max の目的関数として書き、一次近似で内側の最大化を「勾配に沿って だけ上る」ことに変え、その点で勾配を取って元の重みを更新する。代償は各ステップ 2 回の逆伝播だ。CIFAR、ImageNet、ファインチューニング、ノイズラベルのどれでも広く勝っていて、CIFAR の比較ではベースラインに 2 倍のエポックを走らせてさえいる。
実際に使うなら、 は良い出発点で、予算は 2 倍見込んでおく。BN を含むモデルでは 2 回目の順伝播で統計量を更新しないこと。複数デバイスでは 1 回目の逆伝播を同期させず、各デバイスで別々に摂動させること。予算が足りなければ、学習の最後の区間だけ、あるいはファインチューニングのときだけ SAM を使えばよい。
「平坦なら汎化する」という言葉には、2023 年になってもまだ反論する論文が出ている。SAM のほうは、ずっと使われ続けている。