原論文
Quasi-Dense Similarity Learning for Multiple Object Tracking
- 発表先
- CVPR 2021国際会議
- arXiv への初回投稿
- arXiv:2006.06664
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingqdtrack2020,
  title = {{Quasi-Dense Similarity Learning for Multiple Object Tracking}},
  author = {Jiangmiao Pang and Linlu Qiu and Xia Li and Haofeng Chen and Qi Li and Trevor Darrell and Fisher Yu},
  year = {2020},
  eprint = {2006.06664},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.06664}
}
2020 年の時点で、複数物体追跡の関連付けは主に位置に頼っていた。
SORT は IoU を使い、CenterTrack は中心点の変位を予測し、Tracktor は検出器の回帰ヘッドにボックスを次のフレームへ押し出させる。検出さえ十分に正確なら、隣り合う二フレームのあいだの位置関係はとても強い手がかりになる。外観特徴はたいてい脇役で、しばらく姿を消した目標を取り戻すのに使われるだけだった。しかも探索範囲は近くに限らなければならなかった。外観特徴が十分に信頼できず、範囲を広げるとかえって取り違えやすくなるからだ。
だが人間が物体を追うときは、見た目だけで足りることが多い。浙江大学の Jiangmiao Pang、ETH Zürich の Fisher Yu、UC Berkeley の Trevor Darrell らは、外観特徴が信頼できないのは、訓練のやり方が無駄だらけだからだと考えた。
問題の定義
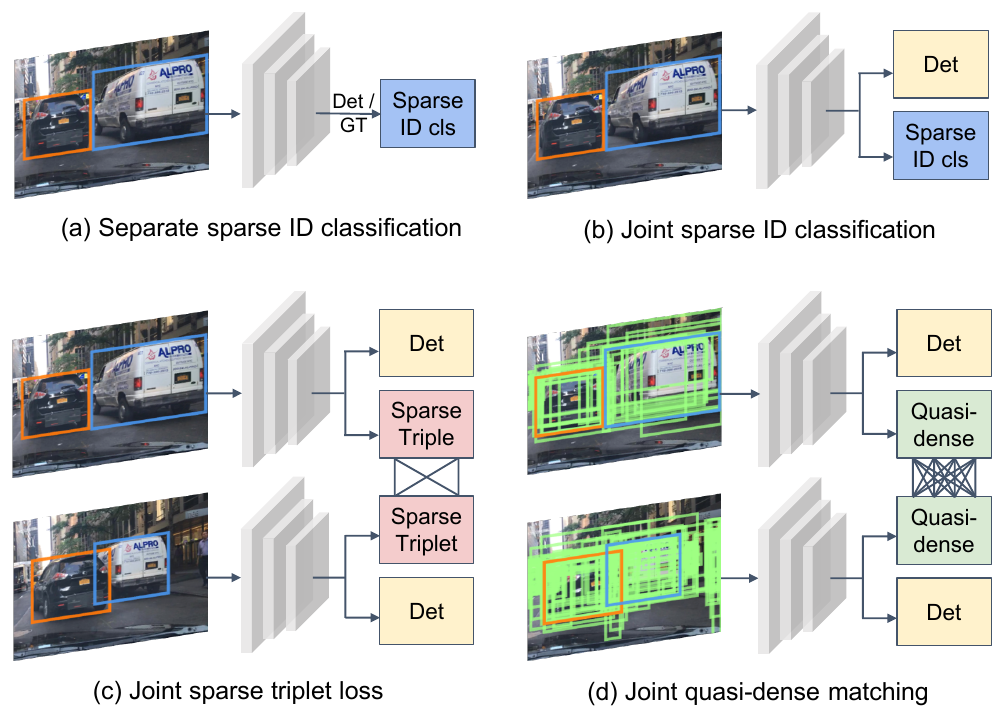
当時、外観特徴を学ぶ方法はおおよそ次のように分かれていた。
- 身元の分類: 訓練セットの身元一人ひとりを一つのクラスとみなす。たとえば DeepSORT の re-ID モデルや、JDE、FairMOT が検出器に加えた埋め込みの分岐がそうだ。データセットが大きいほどクラス数が増え、規模を広げるのが難しい。
- 三つ組損失: 各サンプルを、正例一つ、負例一つとだけ比べる。
どちらにしても、訓練サンプルは真のボックスだけで、一枚の画像にせいぜい十数個しかない。
ところが検出器は、一枚の画像ごとに何百もの候補領域を提案する。真のボックスに近いものは追加の正例として使えるし、背景に落ちたものは、そのまま使える難しい負例だ。これらの領域はもともと検出の訓練にしか使われず、外観を学ぶときにはすべて捨てられていた。
著者らは、これらの候補領域をすべて外観の学習に使いたいと考えた。特徴空間が十分にうまく学べていれば、関連付けに位置も運動も変位の予測も要らず、特徴空間で最近傍を探すだけで済む。
問題を解く
準密なサンプリング
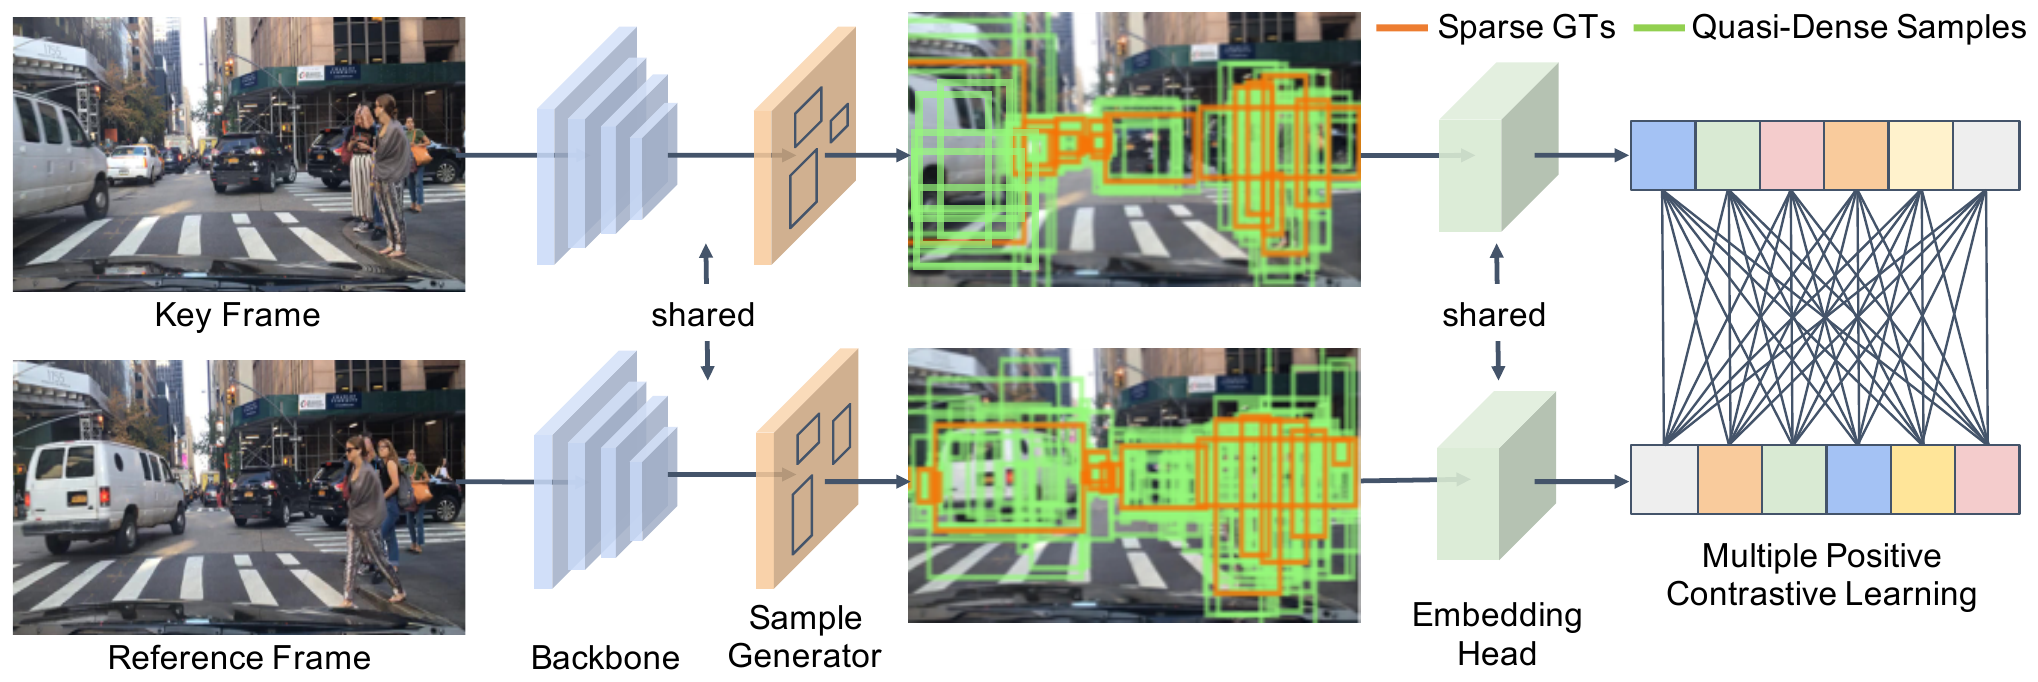
著者らは、すべてのピクセル位置で候補ボックスを照合することを「密なマッチング」と定義した。「準密」は、物体がありそうな情報を持つ領域、つまり RPN が提案した候補ボックスだけを取る。
検出器は標準的な Faster R-CNN と FPN で、バックボーンは ResNet-50 だ。もともとのボックス分類とボックス回帰のヘッドの隣に、軽量な埋め込みヘッド(畳み込み 4 層と全結合 1 層)を並列に加え、候補ボックスごとに 256 次元の特徴を出力する。
訓練では、毎回キーフレームを一枚取り、その前後 3 フレーム以内から参照フレームを一枚ランダムに選ぶ。二枚の画像それぞれで RPN を走らせ、候補ボックスを得る。
- 候補ボックスとある真の物体との IoU が 0.7 を超えれば、その物体のサンプルとする。IoU が 0.3 未満なら背景とする。
- キーフレームの候補ボックスと参照フレームの候補ボックスが同じ物体に属していれば、その組は正例で、そうでなければ負例だ。
キーフレームからは 128 個の候補ボックスを訓練サンプルとして取り、参照フレームからは 256 個を対照の目標として取る。正例と負例は半々だ。各訓練サンプルは、参照フレームの 256 個の目標すべてと比べられる。
複数の正例を持つ対照損失
正例が一つだけなら、標準的な softmax 交差エントロピーが使える。 を訓練サンプルの特徴、 を正例、 を負例とする。
ところが準密にサンプリングすると、一つの訓練サンプルが参照フレーム上に正例をいくつも持つことになる。同じ物体の近くの候補ボックスは、どれも正例になるからだ。正例をそのまま合計して分子に入れると、各負例は何度も重複して数えられるのに、正例は一度しか数えられない。
著者らはまず上の式を次のように書き換えた。
それから正例も一緒に足し合わせる。
こうすると、正例と負例のどの組も、公平に一度ずつ比べられる。
さらに、特徴のコサイン類似度を制約する補助の L2 損失を一つ加える。
正例の組では 、負例の組では だ。著者らの説明では、この損失の役割は logit の大きさとコサイン類似度を制約することで、効果を直接上げるものではない。
全体の損失は次のとおりだ。
ここで 、。付録には、 が 0.5 を超えると効果が下がるとある。
外観だけに頼る関連付け
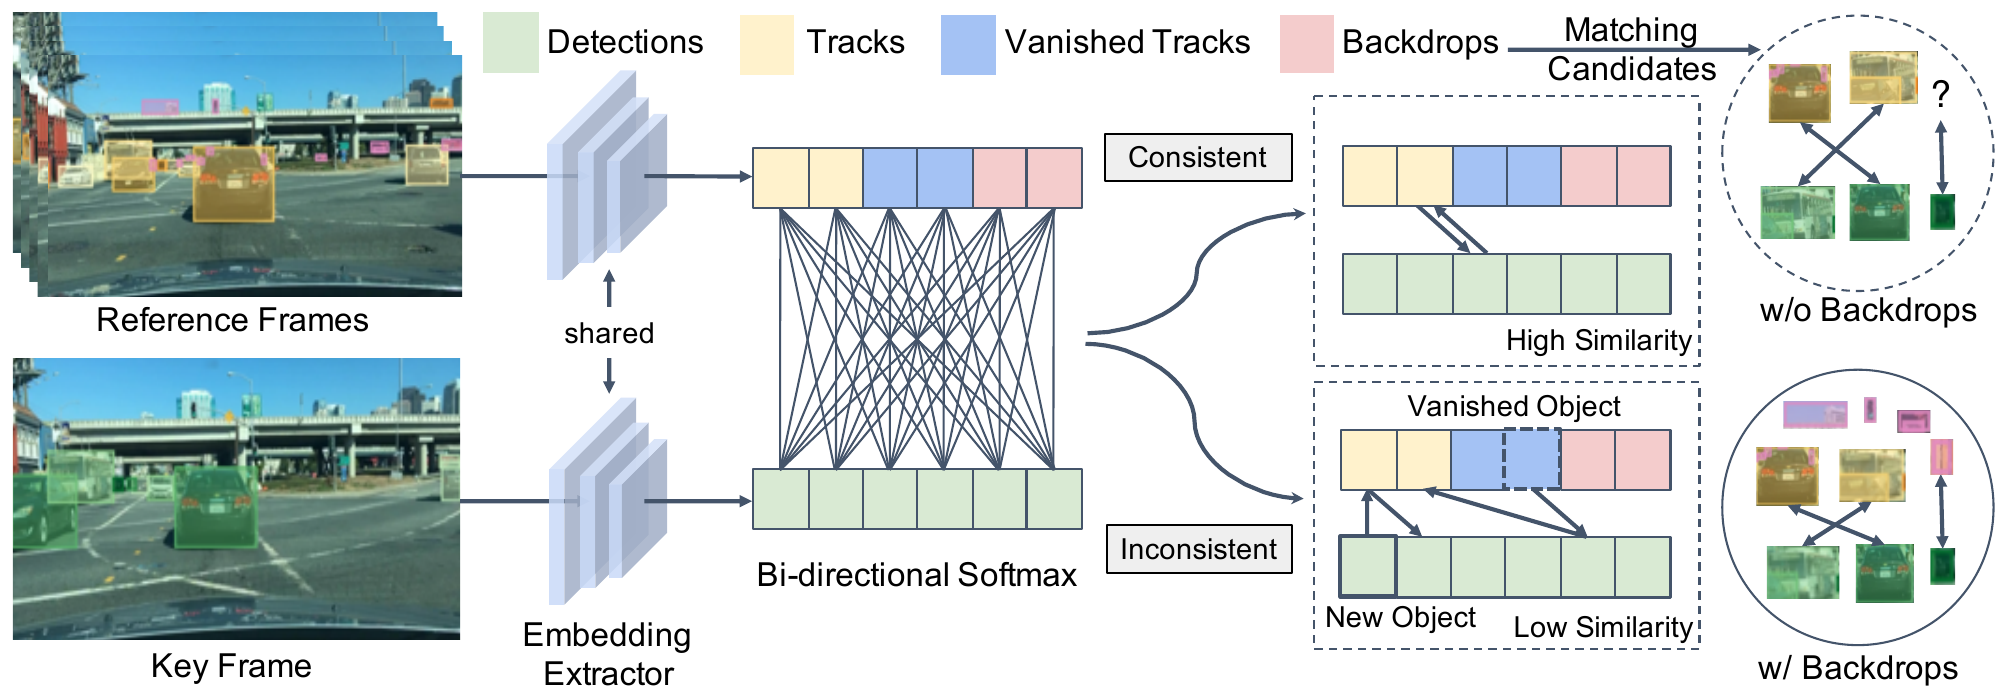
推論では、関連付けに位置を一切使わない。だが特徴だけで最近傍を探すと、対応する軌跡がそもそもない検出(新しい物体、誤検出)や、どれも似て見える候補がいくつもある場合に、厄介なことになる。著者らは三つの設計でこれに対処した。
双方向 softmax。 現在のフレームに 個の検出があり、特徴は 。照合の候補は 個で、特徴は 。両者の類似度には、二つの方向の softmax の平均を使う。
第一項が問うのは「すべての候補の中で、検出 は誰に最も似ているか」、第二項が問うのは「すべての検出の中で、候補 は誰に最も似ているか」だ。両者が互いに最近傍のときだけ、スコアが高くなる。新しく現れた物体は候補の中に本当の相手が見つからず、二つの方向のスコアが同時に高くなることはまずないので、自然と対応づけられない。
背景ボックス(backdrops)を残す。 これまでの手法は、どの軌跡とも対応しなかった検出をそのまま捨てていた。著者らは、こうしたボックスはたいてい誤検出だが、次のフレームの誤検出もおそらく同じような見た目をしていると考えた。それらを 1 フレームだけ照合の候補として残しておけば、次のフレームの誤検出はこの背景ボックスと対応し、本物の軌跡に無理やり押し込まれることがなくなる。
クラスをまたいだ重複除去。 一般的な検出器は同じクラスの中でしか非最大値抑制をかけないので、同じ位置に「歩行者」と「ライダー」の二つのボックスが同時に出て、それぞれがほとんど同じ特徴を持つことがある。著者らは関連付けの前に、クラスをまたいだ非最大値抑制をもう一度かける。しきい値は、信頼度の高いボックスで 0.7、低いボックスで 0.3 だ。
残りはよくあるしきい値だ。検出の信頼度が 0.8 を超えたときだけ新しい軌跡を始め、姿を消した軌跡は 10 フレーム保持し、軌跡の特徴はモメンタム 0.8 で更新し、同じクラスの物体同士だけが対応できる。
議論
どの設計が効いているか
| 訓練 | 類似度 | 重複除去 | 背景 | MOTA | IDF1 | 歩行者 MOTA | 歩行者 IDF1 |
|---|---|---|---|---|---|---|---|
| 疎 | cosine | 60.4 | 63.0 | 37.6 | 49.7 | ||
| 準密、単一正例 | cosine | 61.5 | 66.8 | 40.5 | 52.7 | ||
| 準密、複数正例 | cosine | 62.5 | 67.8 | 44.0 | 54.3 | ||
| 準密、複数正例 | bi-softmax | 62.9 | 70.0 | 45.5 | 58.8 | ||
| 準密、複数正例 | bi-softmax | ✓ | 63.2 | 70.1 | 45.5 | 58.3 | |
| 準密、複数正例 | bi-softmax | ✓ | ✓ | 63.5 | 71.5 | 46.7 | 60.2 |
原論文 Table 4 をもとに整理。BDD100K 追跡検証セット。
アブレーションは BDD100K の検証セットで行っている。ドライブレコーダーのデータセットで、クラスは 8 つあり、MOT17 よりずっと大きい。
疎から準密に変えると、IDF1 は 63.0 から 67.8 に上がる。そのうち、負例を増やしただけで、損失は単一正例のままでも 3.8 ポイント貢献していて、この改善の約八割を占める。対照の目標が多いほど、たとえその大半が負例でも、特徴はよりうまく学べる。複数正例の損失で、さらに 1 ポイント加わる。
推論側では、双方向 softmax で IDF1 がさらに 2.2 ポイント、歩行者クラスでは 4.5 ポイント増える。重複除去と背景ボックスで、さらに 1.5 ポイント加わる。最初から最後まで通して、IDF1 は合計 8.5 ポイント上がり、ID スイッチは 30% 減った。最もはっきり効いたのは歩行者クラスで、MOTA と IDF1 がそれぞれ 9.1 ポイントと 10.5 ポイント増えた。
位置はまだ役に立つか
| 外観 | IoU | 運動 | 回帰 | mMOTA | mIDF1 |
|---|---|---|---|---|---|
| ✓ | 26.3 | 36.0 | |||
| ✓ | ✓ | 27.7 | 38.5 | ||
| ✓ | ✓ | 28.6 | 39.3 | ||
| ✓ | 36.6 | 50.8 | |||
| ✓ | ✓ | 36.3 | 49.8 | ||
| ✓ | ✓ | ✓ | 36.4 | 49.9 | |
| ✓ | ✓ | ✓ | 36.4 | 50.1 |
原論文 Table 5 をもとに整理。BDD100K 追跡検証セット。mMOTA、mIDF1 は 8 クラスの平均。
著者らは Tracktor のやり方にならい、同じ検出器に IoU、運動モデル、ボックスの回帰といった位置の手がかりを加えた。
外観特徴がないときは、位置の手がかりを一つ加えるごとに効果が上がる。ところが準密に学んだ外観特徴があると、位置の手がかりを何を加えても役に立たず、わずかに下がることさえある。最も良い結果は、外観だけを使ったものだ。
外観特徴が十分にうまく学べていれば、位置の手がかりは要らない。これがこの論文の最も核心的な主張だ。ただし、これは BDD100K での結果だ。BDD100K の追跡のアノテーションは毎秒 5 フレームで、しかもカメラは走行中の車に取り付けられているので、隣り合う二つのアノテーション付きフレームのあいだで、物体の位置も大きさも大きく変わりうる。位置の手がかりは、もともとそれほど当てにならない。
各ベンチマーク
QDTrack は四つのベンチマークで結果を報告していて、COCO での事前学習以外には追加の訓練データを使っていない。
- MOT17(独自検出): MOTA 68.7、IDF1 66.3 で、毎秒 20.3 フレーム。当時の CenterTrack より 0.9 ポイントと 1.6 ポイント高く、しかも CenterTrack は追加のデータを使っていた。ID スイッチ 3,378 は CenterTrack の 3,039 より多いが、著者らの説明では、再現率が高めで FN が 1.4 万個少なく、追えている軌跡が多いほど ID が入れ替わる機会も増えるからだ。
- BDD100K: テストセットで mMOTA 35.5、mIDF1 52.3 で、公式のベースラインより 9.2 ポイントと 7.6 ポイント高く、2020 年の BDD100K 追跡チャレンジの優勝チームにも勝っている。
- Waymo: 検証セットの車両クラスで MOTA 55.6 で、RetinaTrack より 10.7 ポイント高い。ResNet-101 と変形可能畳み込みに替えると、テストセットでの成績は 2020 年の Waymo 2D 追跡チャレンジの優勝チームと同等になり、しかも単一のモデルだ。
- TAO: このデータセットには数百のクラスがあり、ロングテールの分布がとても激しい。全体の AP50 はベースラインより 2~3 ポイント高いだけだが、歩行者というよく出てくるクラスでは 38.6 対 18.5 だ。
ボトルネックは検出にある
付録にある二つの oracle の実験は、とても参考になる。
検出を真のボックスに置き換え、QDTrack の特徴で関連付けると、8 クラスの平均の IDF1 は 88.8 で、元より 38 ポイント高い。逆に、検出はそのままで、真の追跡ラベルを使って関連付けると、mIDF1 は 4.3 ポイントしか増えない。
つまり BDD100K では、QDTrack の関連付けはすでに上限にかなり近く、誤差の大部分は検出から来ている。失敗例もそうだ。見逃しの多くはとても小さい物体や、混み合って埋もれた物体で、誤検出は鏡や広告看板の中の人だ。もう一つ、クラスが揺れ動く場合もある。たとえば自転車が隠れると、「ライダー」が「歩行者」として検出される。QDTrack は同じクラスの対応しか許さないので、ID が途切れてしまう。
その後
「外観だけで十分」というこの結論は、のちに MOT17 で検証し直された。ByteTrack は MOT17 の後半検証セットで、QDTrack の re-ID の類似度にカルマンフィルタの運動の手がかりを加え、その上で自分たちの BYTE の関連付けを適用した。MOTA は 67.3 から 67.7 になり、IDF1 は 67.8 から 72.0 に上がり、ID スイッチは 377 から 281 に減った。監視映像の歩行者はゆっくり規則的に歩くので、ここでは運動の手がかりがやはりとても役に立つ。
DanceTrack は反対の極端だ。そこではダンサーたちが似た服を着ていて、外観で区別するのはとても難しい。DanceTrack の著者らは自分たちの関連付けの実験で、外観の照合をそのまま加えると、かえって悪くなることにも気づいた。ところが同じ論文の中で、YOLOX の検出器に替えて訓練し直した QDTrack は HOTA 54.2 を取り、ByteTrack の 47.7 より高く、関連付けの精度 AssA も 36.8 対 32.1 だった。準密に学んだ特徴は、見た目がほとんど同じ場面でも、まだいくらかの違いを見分けられる。
結論
QDTrack が替えたのは、外観特徴を学ぶときのサンプリングのしかただ。もともとは十数個の真のボックスしか使っていなかったのを、何百もの候補ボックスをすべて互いに比べるようにし、さらに複数の正例を公平に扱う対照損失を組み合わせた。
推論で残るのは外観だけで、それに双方向 softmax、1 フレームだけ残す背景ボックス、クラスをまたいだ重複除去という、いくつかの単純なルールが加わる。カルマンフィルタも IoU もなく、BDD100K では位置の手がかりを加えるとかえってわずかに悪くなった。
背景ボックスの手は特に面白い。たいていのトラッカーは誤検出をどうやって捨てるかに知恵を絞っているのに、QDTrack はそれをわざわざ残しておき、次のフレームの誤検出に行き場を用意してやる。