原論文
Tracking Objects as Points
- 発表先
- ECCV 2020国際会議
- arXiv への初回投稿
- arXiv:2004.01177
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingcentertrack2020,
  title = {{Tracking Objects as Points}},
  author = {Xingyi Zhou and Vladlen Koltun and Philipp Krähenbühl},
  year = {2020},
  eprint = {2004.01177},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2004.01177}
}
2020 年 4 月の初め、arXiv に二日違いで、CenterNet をもとにした追跡の論文が二本現れた。
一本は FairMOT で、CenterNet に re-ID の分岐を加え、検出器についでに外観特徴も出力させて、DeepSORT 流の手順でマッチングする。もう一本がこの CenterTrack だ。筆頭著者の Xingyi Zhou はまさに CenterNet の著者で、共著者はテキサス大学オースティン校での指導教員 Philipp Krähenbühl と、Intel Labs の Vladlen Koltun だ。彼らは別の方向に進んだ。外観は学ばずに、検出器に二フレームの画像を直接見せ、ついでに各物体がどこから来たのかを教えてもらうのだ。
同じ検出器に、まったく違う二つの改造。
問題の定義
コンピュータビジョンの初期には、追跡といえば画像の中の特徴点、たとえばコーナーを追うことで、それが次のフレームでどこへ動いたかを見ていた。この方法は単純で速いが、はっきりしたコーナーや輝度のピークがない場所では役に立たない。
深層の検出器が強くなると、tracking-by-detection が主流になった。まず各フレームで検出し、次にボックスをつなぐ。著者らはこの流れに二つの厄介な点があると考えた。一つ目に、最も良いトラッカーはたいてい遅くて複雑な関連付けの戦略に頼っていて、外観特徴を使うものは、さらに高価な特徴ネットワークを走らせなければならない。二つ目に、検出と追跡が分かれているので、検出器は第 フレームで物体を探すとき、第 フレームで何が起きたかをまったく知らない。
Tracktor はすでに検出と追跡を一つにしていたが、前のフレームのボックスを候補ボックスとして Faster R-CNN の回帰に渡すので、隣り合う二フレームのあいだで物体のボックスに十分な重なりが残っていることが前提になる。フレームレートの低い動画ではこの前提が成り立たず、Tracktor は運動モデルを別に加えなければならない。
物体を一つの点として表せば、話はずっと簡単になる。CenterTrack の出発点は、物体の中心点を時間方向に追跡させることだ。初期の「点を追う」考え方に戻るのだが、その点を見つけるのは検出器だ。
著者らは早い段階で範囲も決めている。CenterTrack は局所的な追跡しかせず、隣り合う二フレームの物体だけを関連付ける。物体が画面から出たり、隠れてから再び現れたりしたら、新しい ID を与える。長距離でつなぎ直す力と引き換えに、単純さ、速度、局所的な正確さを手に入れている。
問題を解く
まず CenterNet をおさらい
CenterNet は、物体を点で表す検出器だ。画像を一枚入力すると、4 分の 1 に縮小したヒートマップ をクラスごとに一チャネルずつ出力する。ヒートマップ上の局所的な最大値( の近傍で最も強い点)が一つの物体の中心で、ピークの高さが信頼度スコアだ。ほかに二つの出力の分岐があり、同じ位置からボックスの幅と高さ、そして丸め誤差を補う局所的なオフセットを読み出す。
訓練では、各物体の中心をガウスのピークとして描き、ガウスの幅は物体の大きさに合わせて調整する。損失は focal loss で、、。ボックスの大きさと局所的なオフセットは、中心点の上でだけ L1 損失で教師づけする。
CenterTrack は何を余分に見ているか
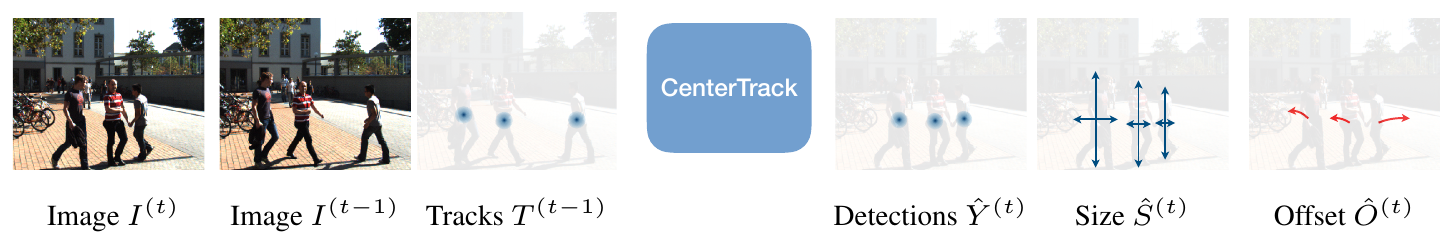
CenterTrack のネットワークは CenterNet とほとんど同じで、入力チャネルが四つ、出力チャネルが二つ増えただけだ。
増えた入力: 前のフレームの画像 で三チャネル。前のフレームで追跡済みの物体の中心を、一チャネルのクラスを区別しないヒートマップ に描いたもので一チャネル。誤検出が次々に伝わっていかないよう、このヒートマップに描かれるのは、信頼度スコアがしきい値 を超えた物体だけだ。
前のフレームの画像が見えれば、ネットワークは場面の変化を推定できる。前のフレームの物体がどこにいたかが見えれば、このフレームで誰かが半分隠れていても、ネットワークはその人を見つけ直せる見込みが高くなる。
増えた出力: 二チャネルの変位マップ 。検出された各中心 で読み出す二次元ベクトル は、その物体の前のフレームからこのフレームへの変位を表す。
訓練のしかたはボックスの大きさと同じで、真の中心点の上で L1 損失を使い、真の変位を回帰する。
一台の車を一歩だけ追ってみる
変位が予測できれば、関連付けではほとんど何もしなくていい。例で一度たどってみよう。
前のフレームに軌跡が二本あり、A の中心は特徴マップ上の 、B の中心は だとする。このフレームで、ネットワークが信頼度スコア 0.9 の中心 を検出し、その位置で読み出した変位は だった。
変位を逆にたどると、この物体は前のフレームでは次の位置にいたはずだ。
A までの距離は約 0.5、B までは約 29.6。A がまだ他の検出に取られておらず、距離が半径 以内であれば、この検出を A につなぎ、A の ID を引き継ぐ。 には予測ボックスの幅と高さの幾何平均 を使う。つまり大きな物体ほど、大きめの誤差を許す。
すべての検出について、信頼度スコアの高い順に、この貪欲なマッチングを順番に行う。半径内に前のフレームの物体が見つからなければ、新しい軌跡を始める。
カルマンフィルタも、外観の距離も、ハンガリアン法もない。
Tracktor との違いは、前のフレームの物体が候補ボックスとしてではなく、ヒートマップの形でネットワークの入力になる点にある。ネットワークは受容野全体で二フレームの物体の対応を推論するので、二つのフレームのボックスがまったく重なっていなくても、つなぐことができる。
訓練の鍵:答えを写させない
単純そうに聞こえるが、著者らは細部が重要だと言う。
隣り合う二フレームの物体は、ほとんどまったく同じだ。訓練のとき、真のアノテーションをそのまま使って前のフレームのヒートマップ を描くと、ネットワークはすぐに、入力されたヒートマップをそのまま出力に写せば損失が十分低くなることに気づいてしまう。学ぶのは追跡ではなく、コピーだ。
ところが推論のときの は、ネットワーク自身の前のフレームの予測から来ていて、見逃した物体も、位置のずれた物体も、誤検出もある。著者らは訓練のとき、この三種類の誤りを意図的に再現した。
- 位置のゆらぎ。 前のフレームの各中心にガウスノイズを加える。大きさはボックスの幅と高さの 倍。
- 偽のピーク。 確率 で、真の物体の近くにノイズのピークを一つ余分に描く。
- 抜け落ちたピーク。 確率 で、いくつかの物体をランダムに取り除く。
MOT17 では 、 で、つまり前のフレームのヒートマップでは、平均して四割の物体がわざと取り除かれる。さらに、前のフレームは本当に一つ前のフレームとは限らず、前後 2 フレーム以内からランダムに一つ選ぶ()。特定のフレームレートに過剰に適応しないようにするためだ。
このデータ拡張は強力で、CenterTrack は動画をまったく使わずに訓練できるほどだ。静止画像を一枚取ってきて、ランダムに拡大縮小・平行移動したものを「前のフレーム」とし、元の検出のアノテーションから変位を再現すれば、トラッカーが訓練できる。
その他の細部
- 3D 追跡。 CenterNet の単眼 3D 検出版に替え、深度、回転、3D の大きさの出力ヘッドを加えれば、単眼 3D 追跡ができる。
- 軌跡の再生(track rebirth)。 対応しなかった軌跡を フレームのあいだ保持し、そのあいだは再びマッチングされて元の ID を取り戻せる。ただしヒートマップには描かず、出力もしない。使ったのは MOT17 のテストセットだけで、。他の実験はすべて だ。
議論
著者らは三つのデータセットで評価した。
- MOT17: 混み合った場面での歩行者追跡で、フレームレートは 25~30 FPS。公式の検証セットがないので、アブレーションでは各訓練動画を前半と後半に分けている。
- KITTI: 車載カメラで、フレームレートは 10 FPS、フレーム間の変位が大きい。評価するのは自動車だけだ。
- nuScenes: 自動運転の場面での単眼 3D 追跡で、評価に使うキーフレームはわずか 2 FPS、フレーム間の変位がとても大きい。主な指標は AMOTA で、さまざまな信頼度のしきい値での MOTA の重み付き平均だ。
主な結果
MOT17 の公式のリーダーボードは public detection しか受け付けていない。CenterTrack はデフォルトでは自分で検出するので、著者らは別に public 版を作った。Tracktor のルールにならい、前のフレームで追跡済みのボックスの近くにあるボックスは残し、新しい軌跡は公開検出のボックスの近くでしか始められないようにした。
この設定で MOTA は 61.5 になり、当時発表されていた最良の手法 Tracktor v2(56.5)より 5 ポイント高く、FN は 235449 から 200672 に減った。著者らは理由を二つ挙げている。前のフレームのヒートマップのおかげで追跡済みの物体を見逃しにくく、学習した変位で関連付けもより安定する。IDF1 は 59.6 で、オフライン手法 LSST17 の 62.3 より低いが、他のオンライン手法よりは高い。
private 版の MOTA は 67.8、IDF1 は 64.7 で、検出込みで 1 フレーム 57 ミリ秒だ。
KITTI では MOTA 89.44 で、リーダーボードで次点の MASS(85.04)より 4 ポイント以上高い。nuScenes のテストセットでは [email protected] が 27.8 で、公式の単眼のベースラインは 6.9 だ。
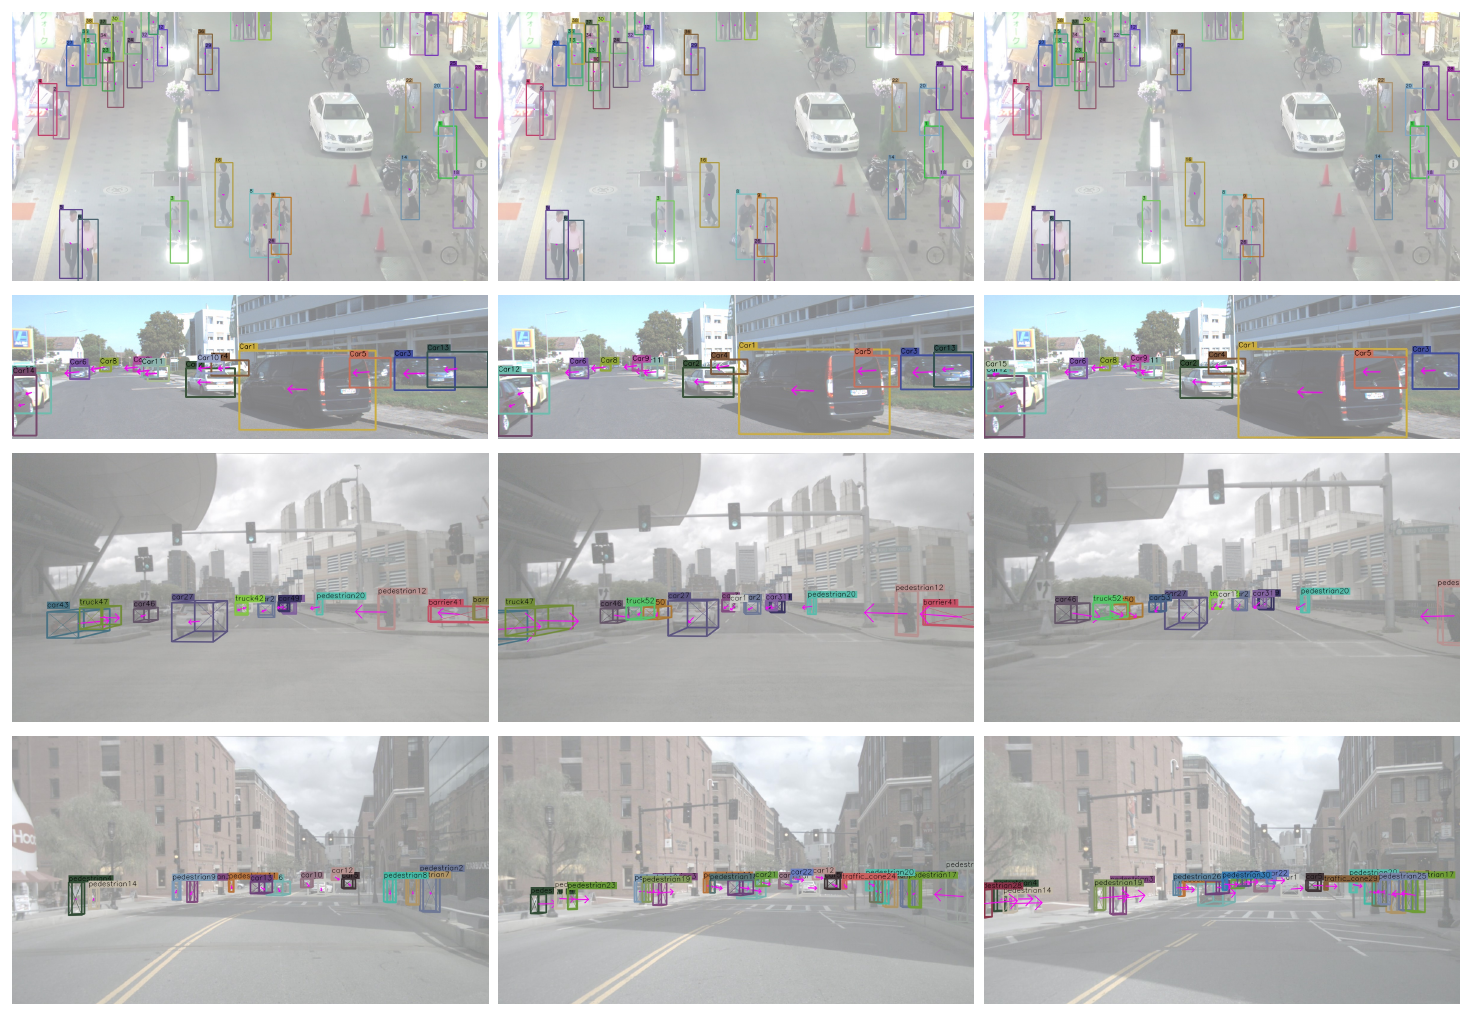
同じネットワークでも、訓練するデータセットを替えれば、歩行者も、車両も、単眼の 3D 物体も扱える。
二つの設計はそれぞれどれだけ貢献しているか
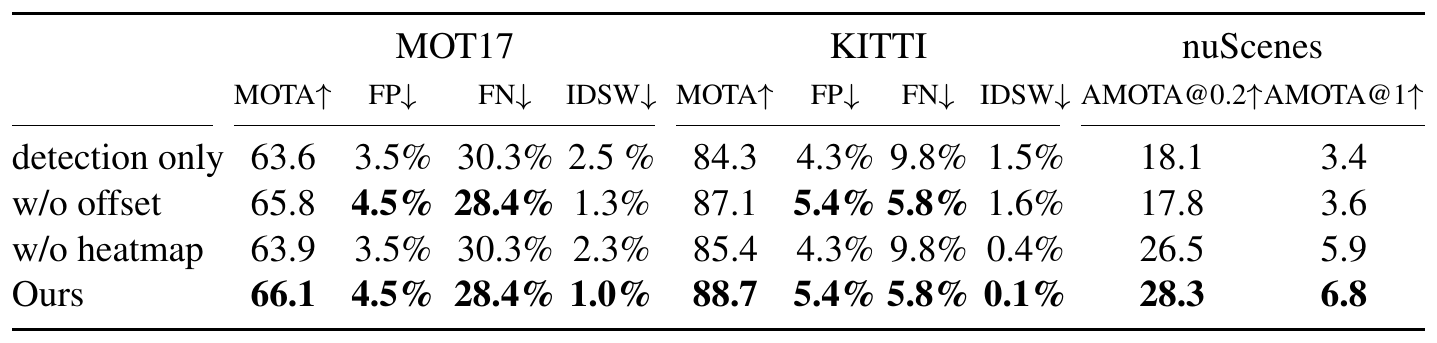
この表は四つの設定を比べている。
- detection only: 各フレームで個別に CenterNet を走らせ、中心点の距離で関連付ける。
- w/o offset: 前のフレームのヒートマップはあるが、変位をゼロにして、前のフレームで最も近い物体をそのまま探す。
- w/o heatmap: 変位の予測はあるが、前のフレームのヒートマップは与えない。
- Ours: 両方ある。
まずヒートマップの効果を見よう。detection only と w/o offset、あるいは w/o heatmap と Ours を比べると、ヒートマップを加えたことで、MOT17 の MOTA は約 2 ポイント、KITTI は約 3 ポイント増える。FN は減り、FP は増える。前のフレームの手がかりがあると、ネットワークは古いピークの近くで物体を多めに見つけようとする。隠れた人を取り戻せることもあれば、惑わされることもある。全体としては、それでも割に合う。
次に変位の効果。フレームレートの高い MOT17 と KITTI では、変位があってもなくても MOTA はあまり変わらないが、ID スイッチははっきり減る(MOT17 は 1.3% から 1.0%、KITTI は 1.6% から 0.1%)。2 FPS の nuScenes になると差が開き、変位のない w/o offset は 17.8 しかなく、完全なモデルは 28.3 だ。フレームレートが低いほど、物体は二つのフレームのあいだで大きく動き、「最も近いものをそのまま探す」やり方は当てにならなくなる。
ノイズ、静止画像、マッチングのアルゴリズム、再生
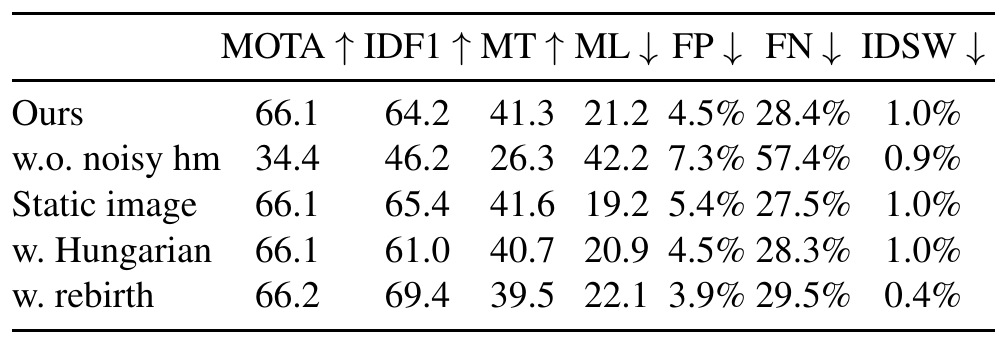
- ノイズを加えないと、モデルは壊れる。 訓練でヒートマップの誤りを再現しないと、MOTA は 66.1 から 34.4 に落ち、FN は 28.4% から 57.4% に跳ね上がる。著者らが挙げる理由の一つは、最初のフレームの入力ヒートマップが空だということだ。このモデルはヒートマップに沿って人を探すことしか学んでいないので、ヒートマップに印のない新しい物体を、自分で見つけるのが難しい。
- 静止画像で十分。 静止画像だけで訓練しても MOTA は同じ 66.1 で、IDF1 はむしろわずかに高い。ただし著者らは、フレームレートの低い nuScenes では、静止画像で訓練した効果は劣るとも述べている。
- ハンガリアン法は役に立たない。 全体最適のマッチングに替えても MOTA は変わらず、IDF1 はかえって 64.2 から 61.0 に下がる。そのため著者らは、単純な貪欲なマッチングを残した。
- 再生で ID が大きく改善する。 の軌跡の再生を加えると、MOTA はほとんど変わらないが、IDF1 は 64.2 から 69.4 に上がり、ID スイッチは 1.0% から 0.4% に減る。純粋に局所的な追跡で失われる身元は、MOT17 のように遮蔽の多い場面では、実はかなり影響が大きい。
学習した変位は、運動モデルより何を多くこなしているか
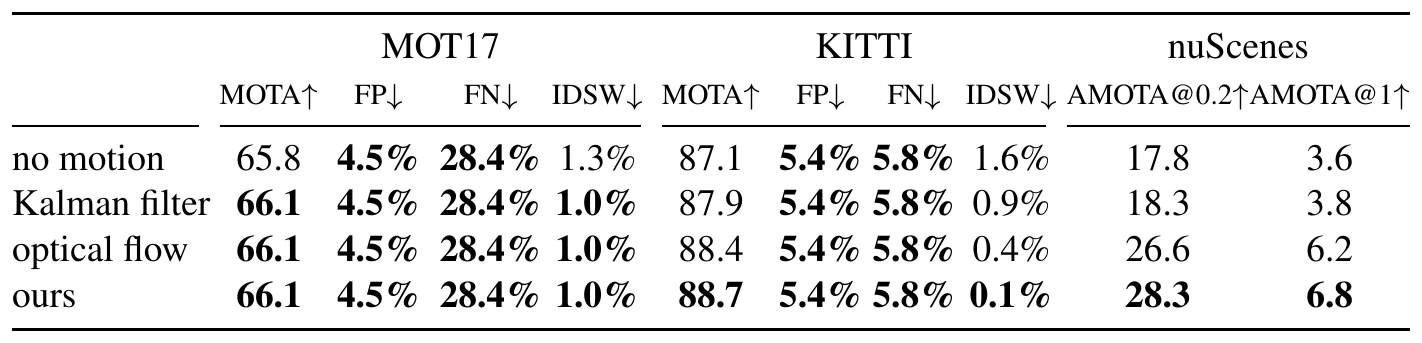
著者らは、学習した変位を三種類の運動モデルに置き換えた。動かない(変位ゼロ)、SORT のカルマンフィルタ、FlowNet2 のオプティカルフロー(予測した各中心でフローのベクトルを読む)だ。検出器はまったく同じにしている。
MOT17 では四つにほとんど差がなく、運動モデルを使わなくてもあまり変わらない。30 FPS の歩行者は 1 フレームにほんの少ししか動かないので、どう推測しても当たる。
KITTI と nuScenes では、カルマンフィルタの手作りの運動ルールでは明らかに足りず、nuScenes では 18.3 と、動かない場合とほとんど同じだ。オプティカルフローはずっと良い(26.6)が、それでも CenterTrack の 28.3 には負けるし、FlowNet2 は画像のペア一組に約 150 ミリ秒かかる。
著者らの説明では、CenterTrack の変位は運動を推定しているだけではない。ネットワークには前のフレームの物体がどこにいるかが見えていて、訓練ではノイズの入ったヒートマップの上で正しく答えるよう追い込まれ続ける。だから学ぶのは、変位を前のフレームに確かに存在するその物体に「合わせる」ことだ。変位一つで、運動の推定と関連付けを同時にこなしている。
その後
FairMOT の論文は CenterTrack を評して、外観特徴を取り出さず、隣り合うフレームしか関連付けないと述べている。FairMOT 自身は外観で長距離の関連付けができ、遮蔽も扱える。見失った長距離の軌跡を再初期化しないのは、もともと CenterTrack が序論で自ら決めた範囲で、先ほどの再生の実験もその代償を示している。見失った軌跡を 32 フレーム保持するだけで、IDF1 は 64.2 から 69.4 に上がる。著者らは MOT17 の結果の議論でも、こうした局所的なトラッカーを長距離の re-ID 手法と組み合わせるのは、取り組む価値のある方向だと述べている。
その後の ByteTrack は、CenterTrack を関連付けの手法を差し替えられるベースラインの一つとして扱った。KITTI のようなフレームレートの低いデータでも、CenterTrack をもとに発展させた手法が次々に出てきた。変位で二フレームの検出をつなぐやり方は、「検出と追跡を一体にする」路線の標準部品になった。
結論
物体を点として表し、検出器に前のフレームの画像一枚と、前のフレームの物体のヒートマップ一枚を余分に見せ、変位マップを一枚余分に出力させる。CenterTrack の関連付けは「逆にたどって、最も近いものを探す」だけになったのに、MOT17、KITTI、nuScenes のすべてで、当時発表されていた手法を上回った。
訓練でわざとヒートマップを壊すあのデータ拡張は、自分のプロジェクトにそのまま持ち込める。入れなければ MOTA は 66 から 34 に落ちる。入れれば、静止画像でさえトラッカーの訓練に使える。
一年半後、ByteTrack は CenterTrack の検出ボックスだけを使い、自前の関連付けに替えて、見失った軌跡を 30 フレーム長く残しただけで、IDF1 を 10 ポイント近く伸ばした。