原論文
Simple Online and Realtime Tracking
- 発表先
- ICIP 2016国際会議
- arXiv への初回投稿
- arXiv:1602.00763
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingsort2016,
  title = {{Simple Online and Realtime Tracking}},
  author = {Alex Bewley and Zongyuan Ge and Lionel Ott and Fabio Ramos and Ben Upcroft},
  year = {2016},
  eprint = {1602.00763},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1602.00763}
}
2015 年、MOTChallenge が公開された。このベンチマークは複数物体追跡の動画、アノテーション、公開検出の結果、評価プログラムをひとまとめにしたもので、これでようやく誰もが同じリーダーボードでトラッカーを比べられるようになった。
ランキングの上位は、凝ったシステムで埋め尽くされていた。多重仮説追跡(Multiple Hypothesis Tracking, MHT)や結合確率的データ関連付け(Joint Probabilistic Data Association, JPDA)といった、レーダー追跡に由来する古い手法が再び持ち出され、外観モデル、オンライン学習、さまざまな遮蔽処理のルールと組み合わされていた。精度は確かに上がったが、速度は毎秒 1~2 フレームまで落ちることも多かった。
クイーンズランド工科大学の Alex Bewley らはこのランキングを見て、二つのことに気づいた。一つ目は、最上位のトラッカーが、ちょうど公式の ACF 検出結果を使っていない唯一の手法だったこと。二つ目は、最も精度の高い手法がどれも、リアルタイムでは動かせないほど遅かったことだ。
検出の品質こそがボトルネックなら、トラッカーはこれほど複雑である必要があるのだろうか?
この論文が知りたかったのは、複数物体追跡はどこまで単純にでき、それでどこまでうまくやれるのか、ということだ。
問題の定義
複数物体追跡(Multi-Object Tracking, MOT)の入力は一本の動画で、出力は各フレームにいる各物体のボックスと、フレームをまたいで変わらない ID だ。
主流のやり方は tracking-by-detection と呼ばれる。まず検出器が各フレームで独立にすべてのボックスを見つけ、次にトラッカーがそれらのボックスをつないで軌跡にする。検出器は「このフレームに誰がいるか」だけを受け持ち、トラッカーは「このボックスは前のフレームのどれか」に答える。後者がデータ関連付け(data association)の問題だ。
この論文はさらに制約を一つ加えている。トラッカーは online でなければならない。つまり第 フレームを処理するときは、第 フレームとそれ以前の情報しか見られず、その場で ID を出さなければならない。もう一方の batch 手法は、動画全体を見終わってから振り返って全体最適化ができ、たいてい結果も良いが、自動運転車やロボットのように即座に反応しなければならない場面では使えない。
当時のランキングはこうなっていた。
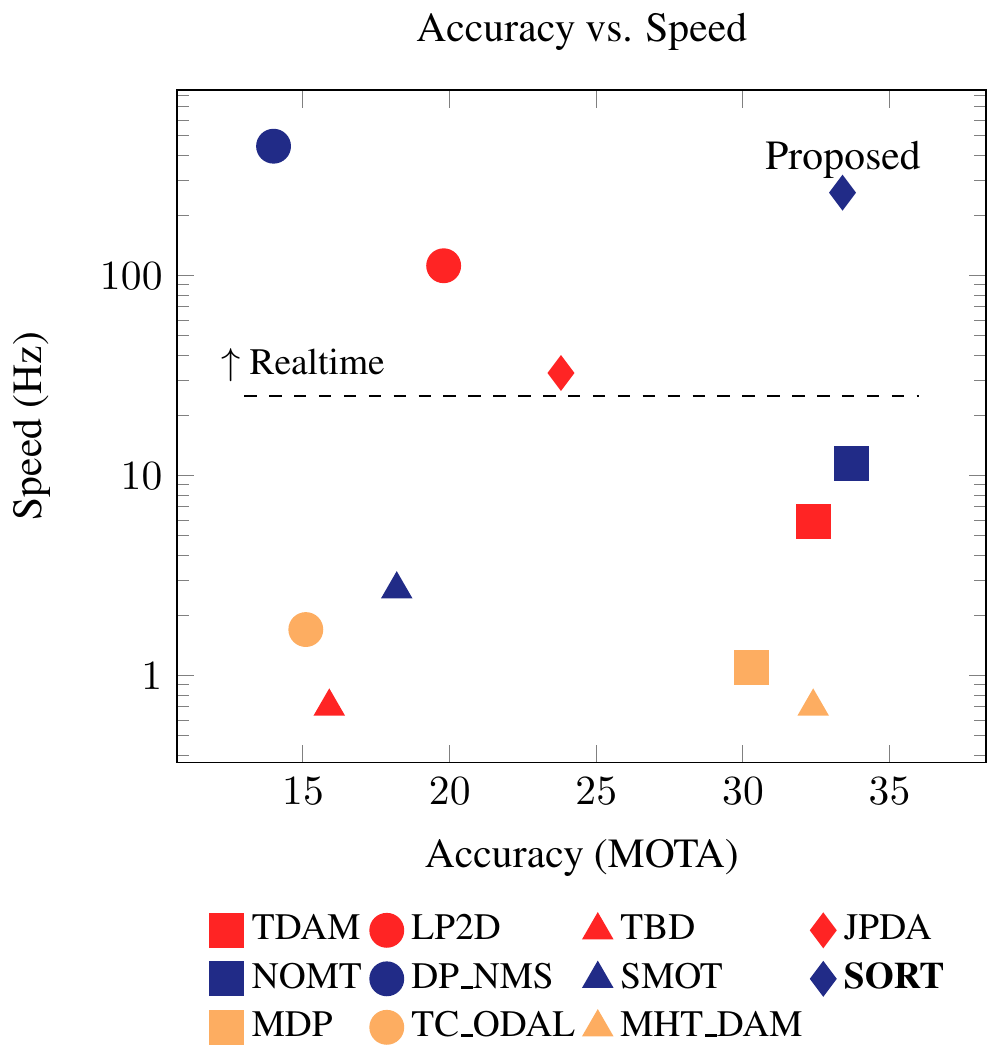
横軸が精度、縦軸が速度で、右上に行くほど良い。右下は正確だが遅い手法、左上は速いが不正確な手法で、右上はもともと空いていた。
著者らはオッカムの剃刀の原則を引き合いに出し、自分たちのトラッカーでかなり極端な割り切りをいくつか行った。
- ボックスの位置と大きさだけを使う。 検出器のほかには外観特徴を一切抽出せず、運動推定もデータ関連付けもボックスだけを見る。
- 遮蔽を扱わない。 著者らは、短期・長期の遮蔽はこのデータではめったに起こらず、そのための専用の仕組みを書いてもシステムが複雑になるだけだと考えた。(この「めったに起こらない」には、のちの MOT20 も DanceTrack もたぶん同意しないだろう。)
- 再識別をしない。 物体が画面から出てまた戻ってきたら、新しい物体として扱う。著者らの理由は、再識別はかなりの計算負担を生み、リアルタイム応用の妨げになるというものだ。
残ってうまくやるべきことは、隣り合う二フレーム間のマッチングだけになる。
問題を解く
SORT は四つの部分からなる。検出、状態推定、データ関連付け、そして軌跡の生成と削除だ。
検出器
著者らは Faster R-CNN を使い、浅めの ZF と深めの VGG16 の二つのバックボーンを比べた。重みは PASCAL VOC で訓練済みのデフォルトのパラメータをそのまま使い、歩行者向けに訓練し直してはいない。出力は「人」クラスだけを残し、しかも確率が 50% を超えるものに限った。
このステップは平凡に見えるが、実は論文全体で最も重要な実験変数だ。議論の節でまた戻ってこよう。
各目標の状態
追跡する物体はそれぞれ、七次元のベクトルで表す。
はボックス中心のピクセル座標、 はボックスの面積、 はアスペクト比で、最後の三項は前の三つの速度だ。アスペクト比には速度項がない。著者らはそれが変わらないと仮定している。
運動モデルは等速度モデルで、1 フレーム進むごとに位置に速度を足し、速度はそのままにする。公式のコードはこれを の状態遷移行列 と、最初の四項だけを取り出す観測行列 として書いている。
の最初の三行は「新しい位置 = 古い位置 + 速度」を表している。 が表しているのは、検出器が直接見られるのは だけで、速度は見えないということだ。速度は、カルマンフィルタ(Kalman filter)で連続する数フレームの観測から推し量るしかない。
カルマンフィルタは毎フレーム二つのことをする。一つ目は予測で、運動モデルで状態を 1 フレーム先へ進め、同時に不確かさを大きくする。
二つ目は更新だ。このフレームで検出ボックス が割り当てられたら、検出結果で予測を補正する。
は状態の共分散で、フィルタが自分の推定にどれだけ自信がないかを表す。 は運動モデルのノイズ、 は検出ボックスのノイズだ。カルマンゲイン は、予測と検出のどちらを信じるかを決める。予測が不確かなほど( が大きいほど)検出に従い、検出が信頼できないほど( が大きいほど)予測に従う。
このフレームで検出ボックスが割り当てられなければ、予測だけを行い、更新はしない。
どうマッチングするか
各フレームの最初に、既存の軌跡すべてにまず一度予測をさせ、このフレームで「出てくるはず」のボックスを得る。次に、各検出ボックスと各予測ボックスの間の IoU(Intersection over Union)を計算し、行列に並べる。
マッチングは一対一でなければならない。一つの検出ボックスは最大で一本の軌跡に、一本の軌跡は最大で一つの検出ボックスにしか割り当てられない。この制約のもとで IoU の合計を最大にするのが古典的な割当問題(assignment problem)で、ハンガリアン法(Hungarian algorithm)で最適解が求まる。
なぜ IoU が最大のものから順に組ませるだけではだめなのか? 小さな例で見てみよう。
軌跡 A、B の二本と、検出ボックス 1、2 の二つがあり、IoU 行列が次のようだとする。
| 検出 1 | 検出 2 | |
|---|---|---|
| 軌跡 A | 0.60 | 0.50 |
| 軌跡 B | 0.55 | 0.00 |
貪欲法なら、まず表全体で最大の 0.60 を選び、検出 1 を A に割り当てる。残った B は検出 2 と組むしかないが、IoU が 0 なのでマッチングできない。結果として B はこのフレームで観測を失い、検出 2 は新しい物体として扱われ、IoU の合計は 0.60 になる。
ハンガリアン法は全体を見る。A に検出 2(0.50)、B に検出 1(0.55)を割り当てれば、IoU の合計は 1.05 になり、二本の軌跡のどちらにも相手が見つかる。二人が並んで歩き、ボックスが互いに重なっているときには、こういう状況はよくある。
マッチングが終わったら、IoU がしきい値 を下回るペアを外し、まったく重なっていない二つのボックスが無理やり組まされるのを防ぐ。公式のコードのしきい値は 0.3 だ。
著者らは、IoU にはおまけの利点があることにも気づいた。ある人が別の人の前を横切るとき、検出器はたいてい手前の人しか囲まない。このボックスの大きさは手前の人の予測ボックスに近いので、IoU はそれを手前の人に割り当てるほうに傾く。隠れた人には検出ボックスが割り当てられず、状態は予測だけになるので、誤った観測に引っ張られることもない。短いすれ違いは、遮蔽処理のルールが一つもないまま、こうして乗り切れる。
軌跡の生と死
ある検出ボックスとすべての予測ボックスとの IoU がどれも を下回ったら、新しく現れた物体とみなし、新しい軌跡を作る。位置は検出ボックスをそのまま使い、速度はゼロにして、速度の共分散はとても大きく設定する。どちらへ進むのかまだわからない、ということだ。
新しい軌跡はまず試用期間を経て、何回か続けてマッチングに成功してはじめて正式なものになる。検出器がときどき出す誤検出をふるい落とすためだ。論文には回数が書かれていないが、公式のコードの min_hits は 3 だ。
削除のルールはもっとあっさりしている。軌跡が フレーム続けて検出ボックスとマッチングしなかったら、削除する。著者らはすべての実験で を 1 にしていて、理由は二つある。等速度モデルはそもそも予測が不正確で、放っておけばずれていく一方だということ。そしてこの論文は隣り合うフレームのマッチングだけを扱い、再識別は範囲外だということだ。
物体がしばらく隠れてから再び現れたら、新しい ID がつく。
議論
著者らは MOTChallenge 2015(MOT15)で評価した。カルマンフィルタの初期共分散、、 を調整するときは、MDP の論文の訓練/検証の分割を使っている。
ここでまず、二つの指標を知っておく必要がある。
- MOTA(Multi-Object Tracking Accuracy):検出漏れ(FN)、誤検出(FP)、ID スイッチ(ID switch)の三種類の誤りを合計し、真のボックスの総数で割って、1 から引いたもの。三種類の誤りは同じ重みで扱われるが、前の二つの数は ID スイッチより 1~2 桁多いのがふつうなので、MOTA は主に検出の品質を反映する。
- ID sw:一本の真の軌跡に割り当てられた ID が何回変わったか。マッチングの出来をそのまま反映する。
検出器を替えてみる
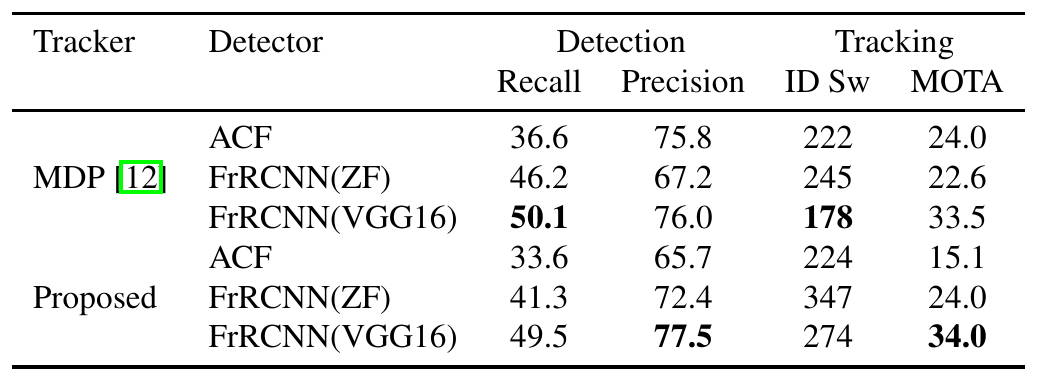
この表は検証セットで、二つのトラッカーをそれぞれ三種類の検出器と組み合わせたものだ。MDP は当時成績の良かったオンライントラッカーで、学習による意思決定の流れを持っている。SORT が本論文の手法だ。
まず SORT の三行を見てみよう。検出器を ACF から FrRCNN(VGG16) に替えると、MOTA は 15.1 から 34.0 に上がり、その差は 18.9 ポイントになる。アブストラクトの「検出器を替えると最大 18.9% 改善する」は、この差のことだ。追跡アルゴリズムには一切手を加えていない。
次に MDP。FrRCNN(ZF) に替えると、再現率は 36.6 から 46.2 に上がったのに、MOTA は 24.0 から 22.6 に下がった。原因は適合率にある。ZF の適合率は 75.8 から 67.2 に落ち、誤検出が増えて、MOTA もそのぶん減点された。検出器が「より多く見つける」ことが、追跡に有利になるとは限らない。誤検出にも同じように代償がある。
二つのトラッカーを最良の検出器と組み合わせたときの MOTA は、それぞれ 33.5 と 34.0 で、差はごくわずかだ。検出器がもたらす差は、トラッカー同士の差よりずっと大きい。
MOT15 テストセット
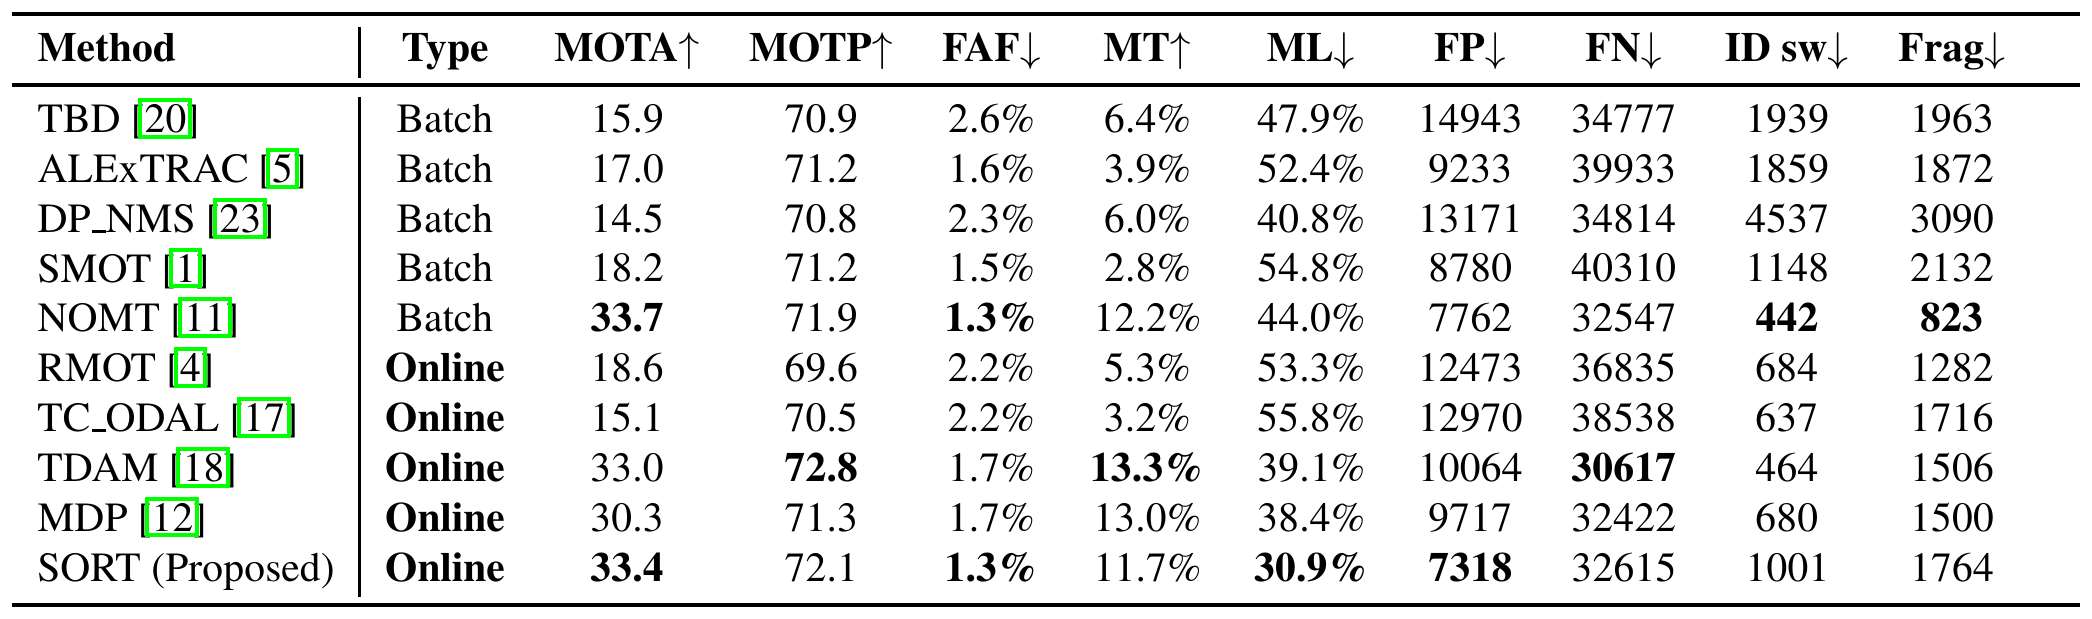
テストセットには 11 本の動画があり、正解のアノテーションは公開されておらず、結果は公式サーバーが計算する。
SORT の MOTA は 33.4 で、オンライン手法の中で最も高く、数フレーム先の未来をのぞき見する NOMT(33.7)とほとんど変わらない。誤検出数 7318 は表全体で最も少なく、ほとんど追えなかった軌跡の割合(ML)30.9% も最も低い。
だが ID スイッチの列は、あまり見栄えがよくない。SORT は 1001 回で、MDP は 680、TDAM は 464、NOMT はわずか 442 だ。これが と外観情報を使わないことの代償で、物体が 1~2 フレームより長く隠れると、戻ってきたときには別の ID になっている。軌跡の途切れ回数(Frag)1764 も、同じく高めだ。
MOTA は検出が良いから高く、ID スイッチはマッチングが単純すぎるから多い。この二列を並べてみると、SORT の強みと弱点がはっきりする。
速度
追跡部分は、シングルコアの Intel i7 2.5GHz で 260 Hz、つまり 1 フレームあたり 4 ミリ秒未満で動き、表の他の手法より 20 倍以上速い。
ただし、この数字は追跡だけのもので、検出は含まない。SORT が使う FrRCNN(VGG16) は、Faster R-CNN の原論文の GPU でおよそ毎秒 5 フレームだ。システム全体をリアルタイムで動かそうとすると、ボトルネックは実は検出器にある。それで論文の主張が揺らぐわけではない。論文が示したいのは、追跡のステップにはほとんど時間をかけずに済み、計算の予算を検出器に回せるということだ。
その後
公式のコードの説明には、SORT は発表時に MOT15 で最上位のオープンソースのトラッカーだったと書かれていて、SORT の精度のかなりの部分は検出結果のおかげだという注意書きもある。コード自体は 300 行足らずで、すぐにさまざまなプロジェクトの定番のベースラインになった。
パラメータもそれにつれてばらばらになった。移植版によって max_age は 1 のものも 30 のものもあり、min_hits や IoU のしきい値もそれぞれ調整されている。他人の SORT の数字と比べるときは、どの設定を使っているのかを先に確かめたほうがいい。
著者らは結論で、単純な枠組みはベースラインに向いていて、新しい手法が長時間の遮蔽と再識別に専念できるようになると書き、今後は検出と追跡をもっと密に結びつけるつもりだと述べた。一年後に Wojke、Bewley らが発表した DeepSORT は、この骨組みに外観特徴を戻した。JDE、FairMOT、CenterTrack のように検出と追跡を一つのネットワークに入れる手法は、別の道を進んだ。
結論
カルマンフィルタ、IoU、ハンガリアン法という教科書に載っている三つの道具だけで、SORT は MOT15 でオンライン手法として最高の MOTA を達成し、追跡そのものは 1 フレームあたり 4 ミリ秒もかからない。論文で最も説得力のある数字の組は、検出器を替えると MOTA が 15.1 から 34.0 に跳ね上がる一方で、二つのトラッカーに同じ良い検出器を組み合わせると、差が 0.5 ポイントしかないことだ。
新しい追跡システムを作るなら、まず SORT を動かしてベースラインにし、次にもっと良い検出器に替えて、スコアがどれだけ変わるかを見る。残った差を埋めるところで、ようやく追跡アルゴリズムの出番になる。
五年後の ByteTrack は MOT17 で一位を取った。使った関連付けの手法はやはりカルマンフィルタと IoU で、低スコアのボックスをいくつか余分に拾っただけだった。