原論文
DanceTrack: Multi-Object Tracking in Uniform Appearance and Diverse Motion
- 発表先
- CVPR 2022国際会議
- arXiv への初回投稿
- arXiv:2111.14690
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingdancetrack2021,
  title = {{DanceTrack: Multi-Object Tracking in Uniform Appearance and Diverse Motion}},
  author = {Peize Sun and Jinkun Cao and Yi Jiang and Zehuan Yuan and Song Bai and Kris Kitani and Ping Luo},
  year = {2021},
  eprint = {2111.14690},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2111.14690}
}
2021 年には、複数物体追跡の主流のやり方はほぼ固まっていた。まず検出し、それから re-ID 特徴で各フレームのボックスをつなぐ。JDE や FairMOT は検出ネットワークに埋め込みのブランチを加え、QDTrack は準密な対照学習で外観特徴をさらに鍛え、TrackFormer や MOTR といった Transformer 系の手法が頼っているのも、クエリが持つ外観の情報だ。
香港大学、カーネギーメロン大学、ByteDance の研究者、Peize Sun、Jinkun Cao、Kris Kitani、Ping Luo らは、この流れに疑問を投げかけた。外観特徴がこれほど役に立つのは、単にデータセットが都合よくできているからではないのか?
MOT17 の歩行者は服装がそれぞれ違い、歩く方向や速度も規則的で、ほとんど直線運動だ。こうしたデータでは、見た目で人を見分けるのも、線形の運動モデルで位置を予測するのも、たやすく成功する。だが場面を変えて、たとえば同じ衣装を着たダンサーの一団が、舞台の上ですばやく立ち位置を変え、互いに交差するとしたら、これらの手法は持ちこたえられるだろうか?
面白いことに、著者のうち Peize Sun、Yi Jiang、Zehuan Yuan、Ping Luo は、そのわずか一か月あまり前に、ほかの人たちと一緒に ByteTrack を発表している。運動と IoU だけで MOT17 で非常に高いスコアを取ったトラッカーだ。
問題の定義
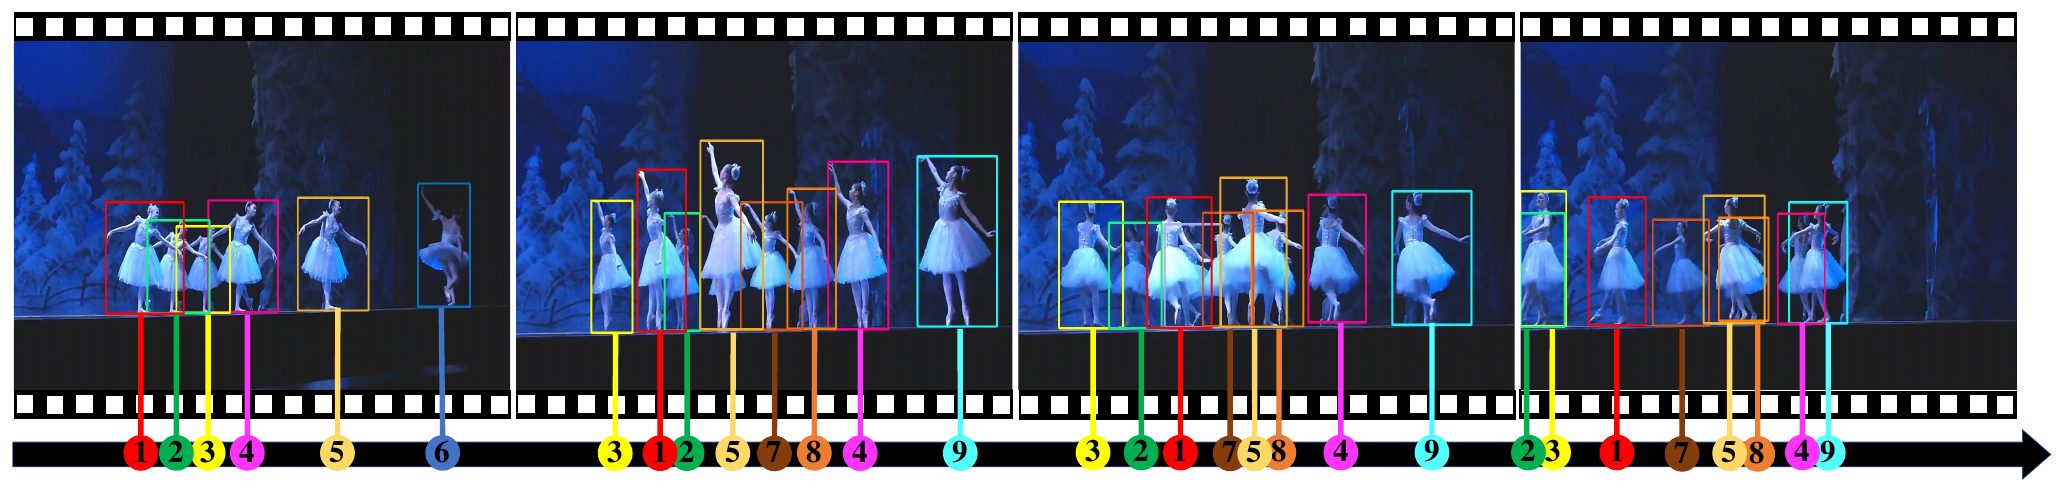
著者らは、既存のデータセットには二つの偏りがあると考える。
- 外観が見分けやすすぎる。 大半の物体は見た目がそれぞれ違い、re-ID モデルで簡単に区別できる。
- 運動が規則的すぎる。 歩行者や車両の動きはたいてい等速直線に近く、単純な線形の運動モデルで十分に足りる。
こうしたデータの上で発展してきたトラッカーは、当然ながらますます外観の照合に頼るようになり、ほかの手がかりはほとんど真剣に検討されなくなる。
ここで一つ注意がある。混雑の度合いを上げても、この問題は解決しない。MOT20 の人混みは非常に密だが、歩行者の動きは規則的で、互いの相対位置や遮蔽される領域はほとんど変わらない。こういう「混雑」は、外観の照合にとってまったく障害にならない。著者らが求めたのは別種の難しさだ。物体が広い範囲を動き回り、遮蔽される領域がたえず変わり、互いに位置を入れ替えもする。
問題を解く
収集とアノテーション
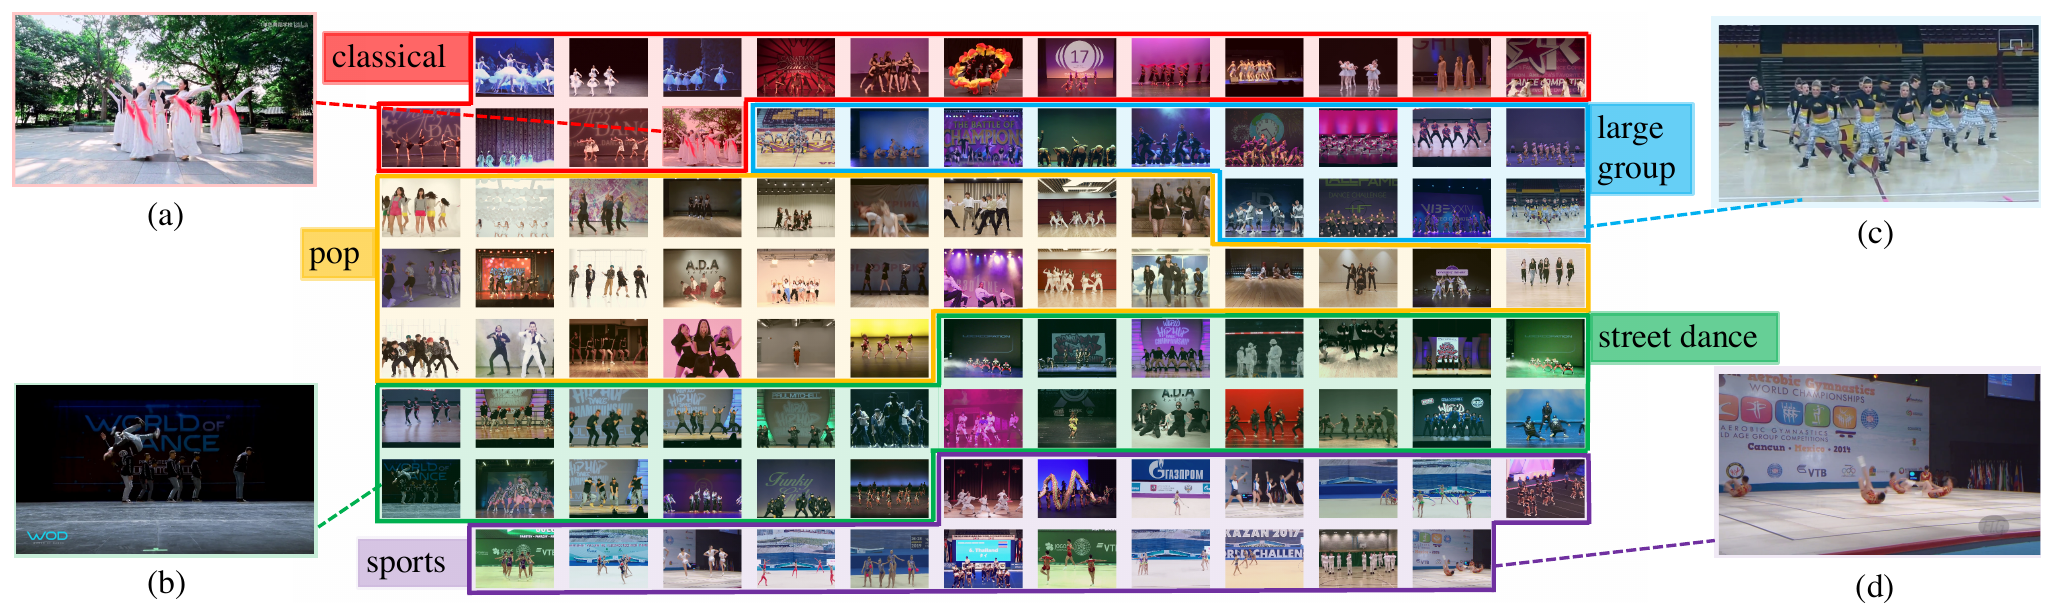
グループダンスは、ちょうどこの二つの難しさを同時に備えている。ダンサーは似た、ときにはまったく同じ衣装を着ていることが多く、しかも広い範囲で立ち位置を変え、さまざまなポーズを取り、頻繁に交差する。
著者らは「ストリートダンス」「ヒップホップダンス」「チアリーディング」「新体操」といったキーワードで、ネット上から公開されている動画を集め、合計 100 本になった。種類はストリートダンス、ポップダンス、バレエやタンゴなどの古典舞踊、大人数のグループダンス、さらに体操、中国武術、チアリーディングといったスポーツの場面まである。大部分は屋内だが、屋外のもの、光が暗いもの、カメラが遠いものもあり、最も人が多い動画には 40 人が映っている。
アノテーションはボックスと身元だけで、規則は次のとおりだ。
- 一部が遮蔽された人には、全身の完全なボックスをつける。
- 完全に遮蔽された人にはつけない。後で再び現れたときは、元の身元を引き継ぐ。
アノテーションツールは前のフレームのボックスを自動で次のフレームに持ち越すので、アノテーターは修正するだけでよい。つけ終わった後は別のグループが確認し、誤りがあれば差し戻してつけ直させる。
100 本の動画は訓練 40 本、検証 25 本、テスト 35 本に分けられ、分割の際には平均の長さ、平均のボックス数、場面と動作の多様性が三つの間でほぼ同じになるようにした。テストセットのアノテーションは公開されず、コンペティションに使われる。
| MOT17 | MOT20 | DanceTrack | |
|---|---|---|---|
| 動画数 | 14 | 8 | 100 |
| 動画あたり平均軌跡数 | 96 | 432 | 9 |
| 総軌跡数 | 1,342 | 3,456 | 990 |
| 平均長(秒) | 35.4 | 66.8 | 52.9 |
| 総長(秒) | 463 | 535 | 5,292 |
| 総画像数 | 11,235 | 13,410 | 105,855 |
原論文 Table 1 をもとに整理。
動画数も画像数も、MOT のデータセットのおよそ十倍だ。ただし動画あたりの軌跡は平均 9 本しかなく、MOT17 よりずっと少ない。DanceTrack の難しさは人の多さではなく、一人ひとりがよく似ていて、しかもめちゃくちゃに動くことにある。
難しさを数字で示す
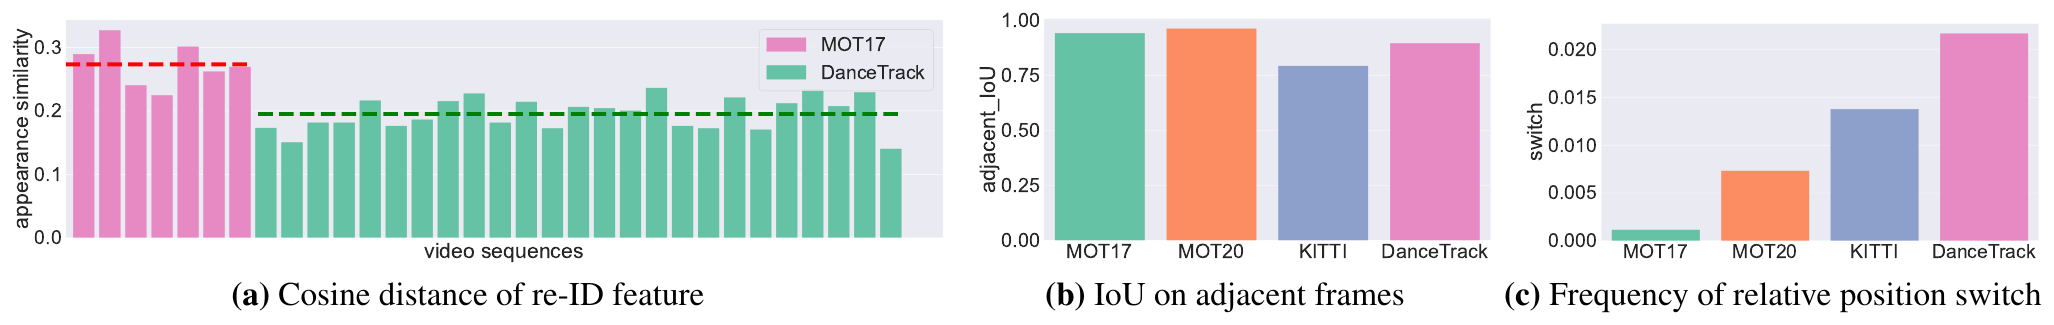
著者らは三つの統計量で、この二つの難しさを数値化した。
外観の類似度。 事前学習済みの re-ID モデルで一人ひとりの特徴を取り出し、同じフレーム内のすべての人の組についてコサイン距離を計算し、さらに動画全体で平均する。DanceTrack の平均距離は MOT17 よりはっきり小さい。つまり、異なる人同士の外観がより近い。
隣り合うフレームの IoU。 同じ人の隣り合う二フレームのボックスの IoU を求め、すべての人、すべてのフレームで平均する。IoU が低いのは、移動が速いかフレームレートが低いことを表す。DanceTrack は MOT のデータセットと同程度で、このデータセットの難しさは不自然な高速移動によるものではない。
相対位置が入れ替わる頻度。 ボックスが重なっている二人の、左右または上下の相対位置が、隣り合う二フレームの間で入れ替わったら一回と数える。等速で動く物体はめったに位置を入れ替えず、非線形の運動であってはじめて頻繁に入れ替わる。DanceTrack はこの項目で MOT17 や MOT20 をはるかに上回り、カメラがずっと動いている車載データセットの KITTI よりも高い。
後の二つを合わせて見ると、DanceTrack の人はフレームごとにはあまり動いていないのに、軌跡はたえず交差している。これはまさに、線形の運動モデルが最も間違えやすい状況だ。
評価指標
DanceTrack は HOTA を主要な指標にしている。関連付けの能力は AssA と IDF1 で、検出の質は DetA と MOTA で見る。著者らの理由は、MOTA は検出に偏りすぎていて、HOTA でこそ検出と関連付けを分けて見られるというものだ。
議論
正解ボックスを与えても、うまく追えるか
| 関連付けの方法 | MOT17 HOTA | DanceTrack HOTA | DanceTrack AssA | DanceTrack IDF1 |
|---|---|---|---|---|
| IoU | 98.1 | 72.8 | 53.6 | 63.5 |
| IoU + 運動 | 96.4 | 69.4 | 54.8 | 71.3 |
| 外観 + IoU + 運動 | 95.0 | 59.7 | 43.2 | 60.5 |
| 外観 | 93.3 | 68.0 | 47.4 | 58.7 |
原論文 Table 2 をもとに整理。両データセットの検証セットで、検出ボックスには正解ボックスをそのまま使用。
著者らはまず oracle 実験を行った。検出ボックスに正解ボックスをそのまま与え、関連付けの手法だけを比べる。
MOT17 では、IoU だけでマッチングしても HOTA は 98.1 で、ほぼ完璧だ。つまり、検出さえ十分に正確なら、MOT17 の関連付けはほとんど問題にならない。
DanceTrack では、同じく正解ボックスでも、IoU マッチングの HOTA は 72.8、AssA は 53.6 しかない。検出はすでに完璧なので、ボトルネックは完全に関連付けにある。
最後の二行は外観特徴を加えたもので、すべての指標が悪くなった。「外観 + IoU + 運動」の HOTA は、IoU だけの場合より 13 ポイントも低い。全員が同じに見える場面では、外観は役に立たないどころか、関連付けを誤った方向へ引っ張る。
既存のトラッカーの性能
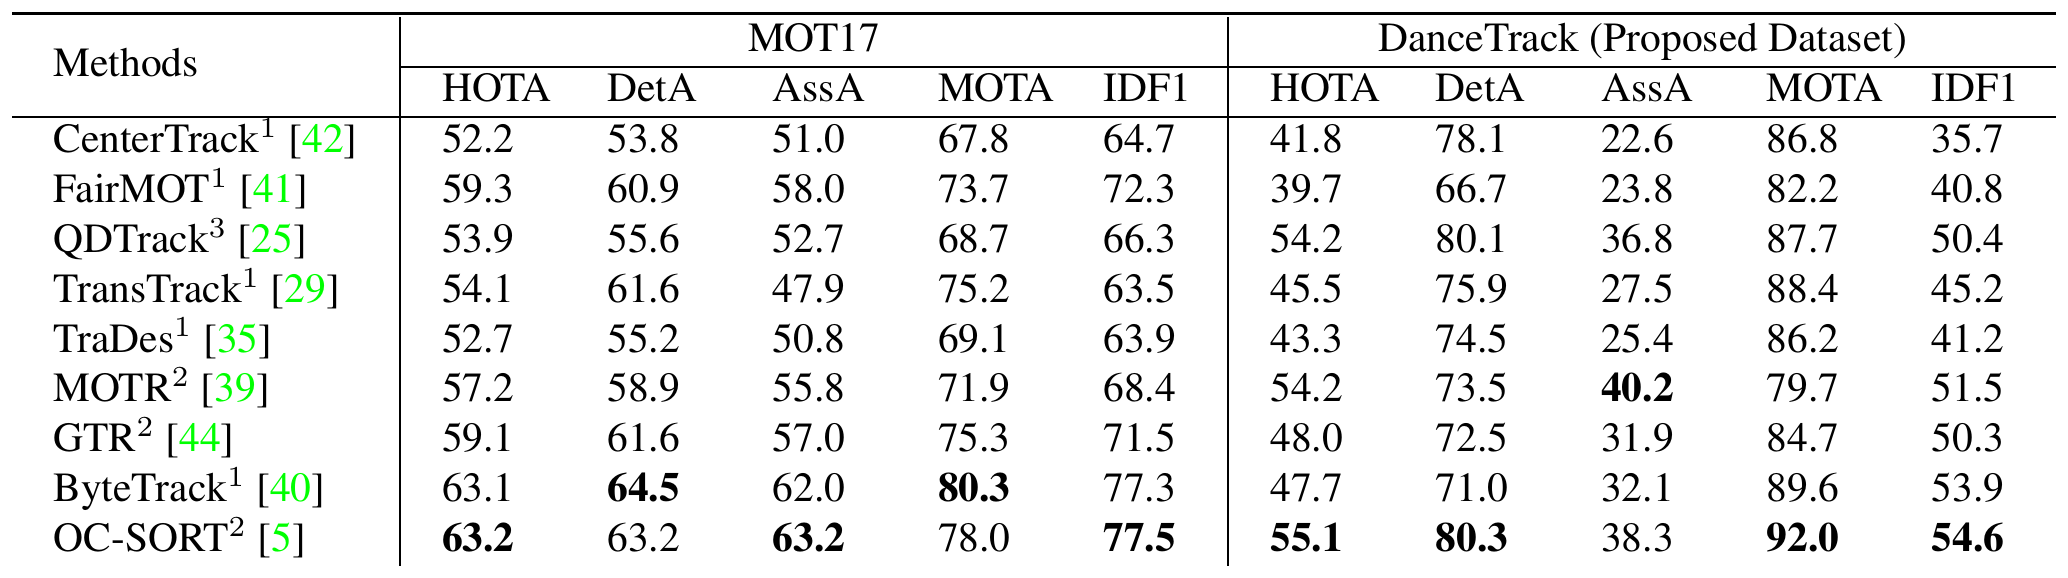
著者らは当時の主流のトラッカーを、すべて DanceTrack で訓練し直してテストした。
どの手法も、DanceTrack では HOTA、AssA、IDF1 が大きく下がった。ByteTrack は MOT17 では 63.1 なのに、DanceTrack では 47.7 しかない。FairMOT は 59.3 から 39.7 に落ちた。
ところが検出の指標はむしろ良くなった。どの手法も、DanceTrack での MOTA と DetA は MOT17 より高く、MOTA はおおむね 80 から 90 の間にある。舞台の上の人は検出しやすい。ただ、誰が誰なのかを見分けられないだけだ。
この表は論文の版によって更新されている。第三版では QDTrack の検出器を YOLOX に替え、ByteTrack のデータ拡張としきい値で訓練し直した。外観学習の部分はまったく変えていない。その結果、HOTA は 54.2 で、ByteTrack よりも高くなった。MOTR の AssA 40.2 は表全体で最も高いが、DetA 73.5 は多くの手法より低い。関連付けが強く検出が弱いというこの組み合わせが、後に MOTRv2 の出発点になった。
関連付けの手法と運動モデル
関連付けだけを比べるため、著者らは検出を YOLOX に固定し、関連付けの手法だけを替えた。
| 関連付け手法 | HOTA | DetA | AssA | MOTA | IDF1 |
|---|---|---|---|---|---|
| IoU | 44.7 | 79.6 | 25.3 | 87.3 | 36.8 |
| SORT | 47.8 | 74.0 | 31.0 | 88.2 | 48.3 |
| DeepSORT | 45.8 | 70.9 | 29.7 | 87.1 | 46.8 |
| MOTDT | 39.2 | 68.8 | 22.5 | 84.3 | 39.6 |
| BYTE | 47.1 | 70.5 | 31.5 | 88.2 | 51.9 |
| OC-SORT | 52.1 | 79.8 | 35.3 | 87.3 | 51.6 |
原論文 Table 4 をもとに整理。DanceTrack 検証セット、検出器は YOLOX。
この表から三つのことがわかる。
- DeepSORT は SORT より悪い。 DeepSORT は SORT に外観の照合を加えたものだが、HOTA は 47.8 から 45.8 に下がった。ここでは外観はマイナスに働いている。
- MOTDT が最も悪い。 MOTDT は追跡の結果で検出を補うが、DanceTrack の検出はもともと良好なので、この設計はかえって検出も関連付けも悪くした。
- OC-SORT が最も良い。 運動だけに頼る手法で、非線形の運動に的を絞ってカルマンフィルタを改良している。HOTA は 52.1 で、AssA 35.3 も最も高い。
別の表では運動モデルを比べている。運動をまったく使わず IoU だけのときの HOTA は 44.7、カルマンフィルタを加えると 47.8、LSTM で学習した運動モデルに替えると 51.6 だ。外観が当てにならないとき、運動モデルには大きな可能性がある。
情報をもっと加える
検出が問題でないのなら、と著者らはボックス以外の情報をモデルにもっと与えてみた。DanceTrack にはボックスのアノテーションしかないので、CenterNet と BYTE の関連付けを使い、ほかのデータセットと一緒に訓練した。
- セグメンテーションマスク: COCO のマスクを加えて一緒に訓練すると、HOTA は 36.9 から 38.1 に上がる。関連付けでもマスクを使うと 39.2 になる。
- 人体の姿勢: COCO の姿勢を加えて一緒に訓練すると、HOTA は 40.6 に上がる。関連付けでも姿勢を使うと 41.0 になる。改善はマスクより大きい。体の大半が隠れているときにはボックスは当てにならず、キーポイントのほうがむしろ安定している。
- 深度: KITTI の深度を加えて一緒に訓練すると、HOTA はかえって 34.4 に下がる。KITTI はおもに車で、舞台とは違いすぎる。それでも混合訓練したモデルを基準にすれば、関連付けで深度を使うと IDF1 は 1.7 上がった。
著者らの結論は、ボックスより細かい表現(マスク、姿勢)は役に立ち、深度の情報にも可能性があり、運動のモデル化は重要だというものだ。
限界
著者ら自身が二つの限界を挙げている。この論文はデータセットを提案しただけで、大きく先行する新しいアルゴリズムは提案しておらず、問題を後続の研究に委ねている。また、データセットにはボックスのアノテーションしかなく、姿勢やマスクはないので、より細かい研究をしたければほかのデータセットを借りる必要がある。
その後
DanceTrack はすぐに、関連付けの能力を試す標準的なベンチマークになった。
数か月後、同じく著者である Jinkun Cao と Kris Kitani が、非線形の運動と遮蔽に的を絞った OC-SORT を発表した。さらに後の MOTRv2 や Deep OC-SORT も、DanceTrack を主な比較の舞台にしている。
結論
DanceTrack は新しいトラッカーを提案したのではなく、既存の手法がどれも苦しむ場面を見つけてきた。みんなが同じ服を着て、跳んだり跳ねたりする場面だ。
この場面では、検出はほとんど問題にならず、問題は関連付けだ。外観特徴はしばしば足を引っ張り、線形の運動モデルもダンスのステップについていけない。
これまで追跡の難しさといえば、まず思い浮かぶのは「混雑」だった。DanceTrack の動画には平均 9 人しかいないのに、MOT20 の何百人もの人混みより追うのが難しい。