原論文
ByteTrack: Multi-Object Tracking by Associating Every Detection Box
- 発表先
- ECCV 2022国際会議
- arXiv への初回投稿
- arXiv:2110.06864
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingbytetrack2021,
  title = {{ByteTrack: Multi-Object Tracking by Associating Every Detection Box}},
  author = {Yifu Zhang and Peize Sun and Yi Jiang and Dongdong Yu and Fucheng Weng and Zehuan Yuan and Ping Luo and Wenyu Liu and Xinggang Wang},
  year = {2021},
  eprint = {2110.06864},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2110.06864}
}
この論文の序論は、ヘーゲルの一節の引用から始まる。「理性的なものは現実的であり、現実的なものは理性的である。」
追跡の論文が哲学者を引くのは、あまり見かけない。著者らが言いたいのは、検出器が出すスコアの低いボックスの中にも、本物が混じっているということだ。
SORT 以来、ほとんどすべてのトラッカーには一つの習慣がある。検出スコアがあるしきい値を下回るボックスを先に捨て、スコアの高いボックスだけでマッチングするのだ。理由はもっともで、低スコアのボックスには背景や誤検出が多く、残しておいても追跡の邪魔になるだけだからだ。
ところが、ある人が別の人に半分隠れると、検出器のスコアも下がる。こうしたボックスを捨てると、その人の軌跡は途切れてしまう。
FairMOT の筆頭著者である張一夫(Yifu Zhang)は今回、華中科技大学、香港大学、ByteDance のチームとともに、注目をネットワークのアーキテクチャからこのしきい値へと移した。
問題の定義
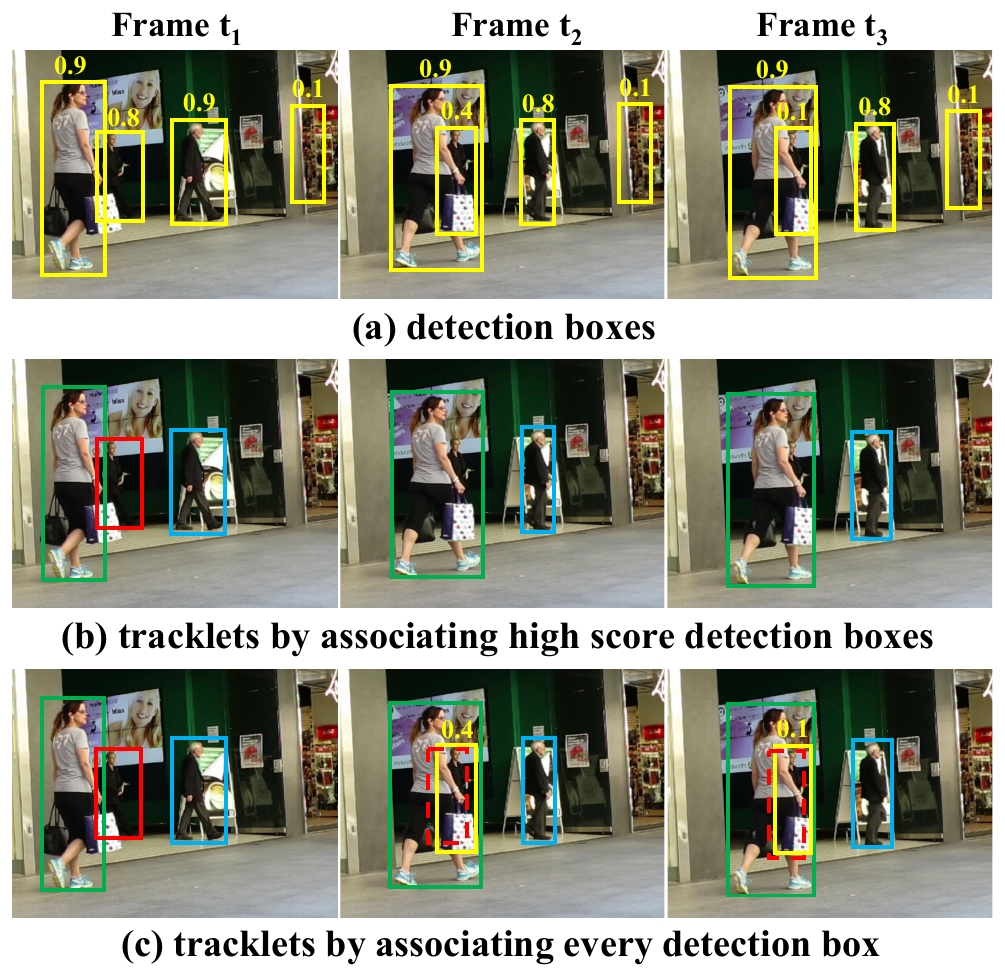
まず (a) の段を見よう。最初のフレームにはボックスが四つあり、そのうち三人のスコアはどれも 0.8 以上で、いちばん右の 0.1 のボックスは背景だ。
二番目のフレームになると、左の女性が中央の人の前に歩いてきて、その人を一部隠してしまい、その人のスコアは 0.8 から 0.4 に下がる。三番目のフレームではもっと隠れて、スコアは 0.1 しか残らない。
(b) は一般的なやり方で、スコアが 0.5 より高いボックスだけでマッチングする。隠れた人は二番目のフレームで観測を失い、赤い軌跡もそれにつれて消える。その人が女性の後ろから出てくると、新しい人として扱われることになる。
では全部残したらどうか? いちばん右の 0.1 の背景のボックスも残ってしまい、偽の軌跡になる。
これが検出しきい値のジレンマだ。しきい値が高いと隠れた人を取りこぼし、しきい値が低いと背景の誤検出を招く。著者らは、このジレンマに本気で取り組んだ手法はほとんどないと指摘する。
彼らが目をつけた手がかりは、既存の軌跡との類似度だ。隠れた人はスコアこそ低いが、そのボックスはカルマンフィルタが予測した赤い軌跡の位置と大きく重なっている。いちばん右の背景のボックスの近くには、軌跡が一本もない。低スコアのボックスを「前の段階でマッチしなかった軌跡」と照合するだけで、本物の物体をすくい上げ、同時に背景をふるい落とせる。
(c) がそうした結果だ。
問題を解く
著者らはこの関連付けの手法を BYTE と名づけた。名前はコンピュータのバイトから来ている。バイトがプログラムの基本単位であるように、検出ボックスの一つひとつが軌跡の基本単位だというわけだ。
流れ全体には関連付けが二回あるだけだ。
準備: 検出スコアのしきい値 で、このフレームの検出ボックスを二組に分ける。高スコアのボックス と低スコアのボックス だ。カルマンフィルタで、このフレームでの各軌跡の位置を予測する。
一回目の関連付け: 高スコアのボックスを、一時的に見失った軌跡も含めたすべての軌跡とマッチングする。類似度には予測ボックスと検出ボックスの IoU を使ってもよいし、re-ID 特徴の距離を使ってもよく、ハンガリアン法で解く。マッチしなかった高スコアのボックスを 、マッチしなかった軌跡を とする。
二回目の関連付け: 低スコアのボックスを とマッチングし、類似度には IoU だけを使う。この段階が終わってもまだマッチしない低スコアのボックスは、背景としてそのまま捨てる。
後始末: 二回ともマッチしなかった軌跡は見失った軌跡の集合に移して 30 フレーム保持し、その間に一回目の関連付けでマッチすれば元の ID に戻す。30 フレームを超えてはじめて削除する。一回目の関連付けでマッチしなかった高スコアのボックスは、新しい軌跡を始める。見失っている軌跡は出力しない。
なぜ二回目の関連付けでは IoU だけを使うのか? 低スコアのボックスのスコアが低いのは、たいていひどい遮蔽か動きによるブレのせいで、そういうときの外観特徴は当てにならない。むしろ位置のほうが当てになる。隠れた人は、一フレームの間にそう遠くまでは行かない。
BYTE は検出器に依存せず、一回目の関連付けにどんな類似度を使うかも限定しないので、どんなトラッカーの後ろにもつなげられる。
著者らはさらに、BYTE を当時の強力な検出器 YOLOX につなげ、ByteTrack と名づけた。MOT17 や MOT20 といった歩行者のデータセットでは、ByteTrack は二回の関連付けのどちらでも IoU だけを使い、re-ID 特徴は一切使わない。
議論
ByteTrack の検出器は YOLOX-X で、COCO で事前学習したあと、MOT17、CrowdHuman、CityPersons、ETHZ を合わせて 80 epoch 訓練する。入力サイズは で、V100 8 枚でおよそ 12 時間かかる。速度は V100、FP16、バッチサイズ 1 で測っている。
アブレーション実験では、MOT17 訓練セットの各動画を前半と後半に分け、前半で訓練して後半で検証する。訓練データにはさらに CrowdHuman を加える。
ほかの関連付け手法との比較
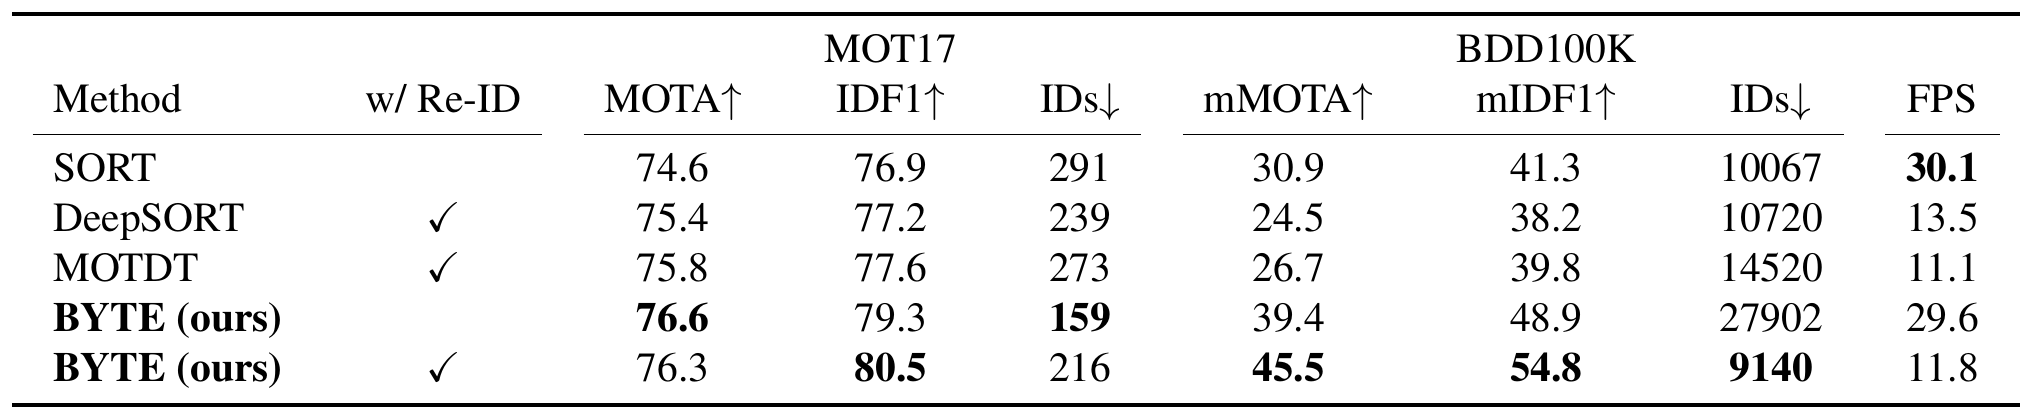
この表では検出器はすべて同じで、違うのは関連付けの手法だけだ。
SORT は BYTE のベースラインと見なせる。どちらもカルマンフィルタと IoU だけを使い、違いは二回目の関連付けがあるかどうかだけだ。BYTE は MOTA を 74.6 から 76.6 に、IDF1 を 76.9 から 79.3 に上げ、ID スイッチを 291 から 159 に減らした。速度はほとんど変わらない(30.1 対 29.6 FPS)。これが低スコアのボックスの価値だ。
著者らがさらに意外に思ったのは DeepSORT だ。re-ID モデルが加わっているのに、MOTA、IDF1、ID スイッチのどれでも IoU だけの BYTE に負け、速度も半分に届かない。著者らの解釈では、検出ボックスが十分に正確なら、単純なカルマンフィルタでも長い距離の関連付けをうまくこなせるし、ひどい遮蔽に出くわすと re-ID 特徴はかえって間違えやすく、運動モデルのほうが当てになる。
BYTE に re-ID を加えると、IDF1 は 80.5 に上がるが、MOTA はやや下がり、ID スイッチは増える。
BDD100K では事情が違う。こちらは車載動画で、カメラの動きが大きく、アノテーションのフレームレートも低いので、カルマンフィルタはここでは役に立たない。そこで著者らは BDD100K ではカルマンフィルタを使っていない。IoU だけの BYTE は SORT を大きく上回る(39.4 対 30.9)ものの、ID スイッチは 27902 にものぼる。re-ID を加えると mMOTA は 45.5 に上がり、ID スイッチは 9140 に下がる。
著者らは、二回の関連付けにそれぞれどの類似度を使うべきかも比べた。MOT17 では、一回目は IoU でも re-ID でもよく、IoU のほうが MOTA と ID スイッチが良く、re-ID のほうが IDF1 が高い。BDD100K では、一回目の関連付けは re-ID のほうがずっと良い。ただし二回目の関連付けは、どちらのデータセットでも IoU のほうが良く、IoU を使うと re-ID より MOTA がおよそ 1 ポイント高い。低スコアのボックスの外観特徴は当てにならないという判断を裏づける結果だ。
しきい値にあまり敏感でなくなる
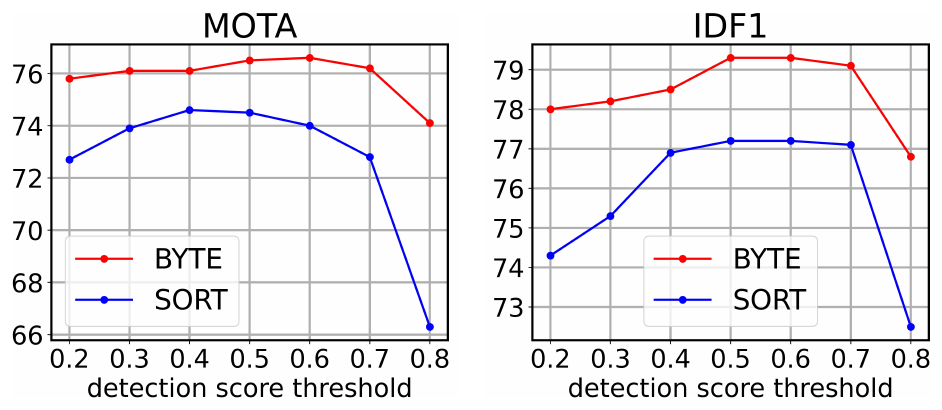
検出しきい値は、たいていトラッカーで最も敏感で、最も丁寧に調整しなければならないハイパーパラメータだ。著者らはしきい値を 0.2 から 0.8 まで変えた。SORT の MOTA はしきい値が高くなると急速に下がり、0.4 での約 74.5 から 0.8 での約 66 まで落ちる。BYTE は比較的安定している。
理屈は単純だ。BYTE の二回目の関連付けは、しきい値を下回ったボックスをすくい上げるので、しきい値を上げても、捨てられたボックスにはまだ二度目のチャンスがある。
著者らは低スコアのボックスの中の真陽性と誤検出も数えた。スコアが下限としきい値の間にあるすべてのボックスで見ると、動画によっては(たとえば MOT17-02)誤検出が真陽性よりずっと多い。それでも BYTE がそこからすくい上げたボックスでは、真陽性が誤検出よりはっきり多い。既存の軌跡との類似度は、確かに有効なふるいになっている。
ほかのトラッカーにつなげる
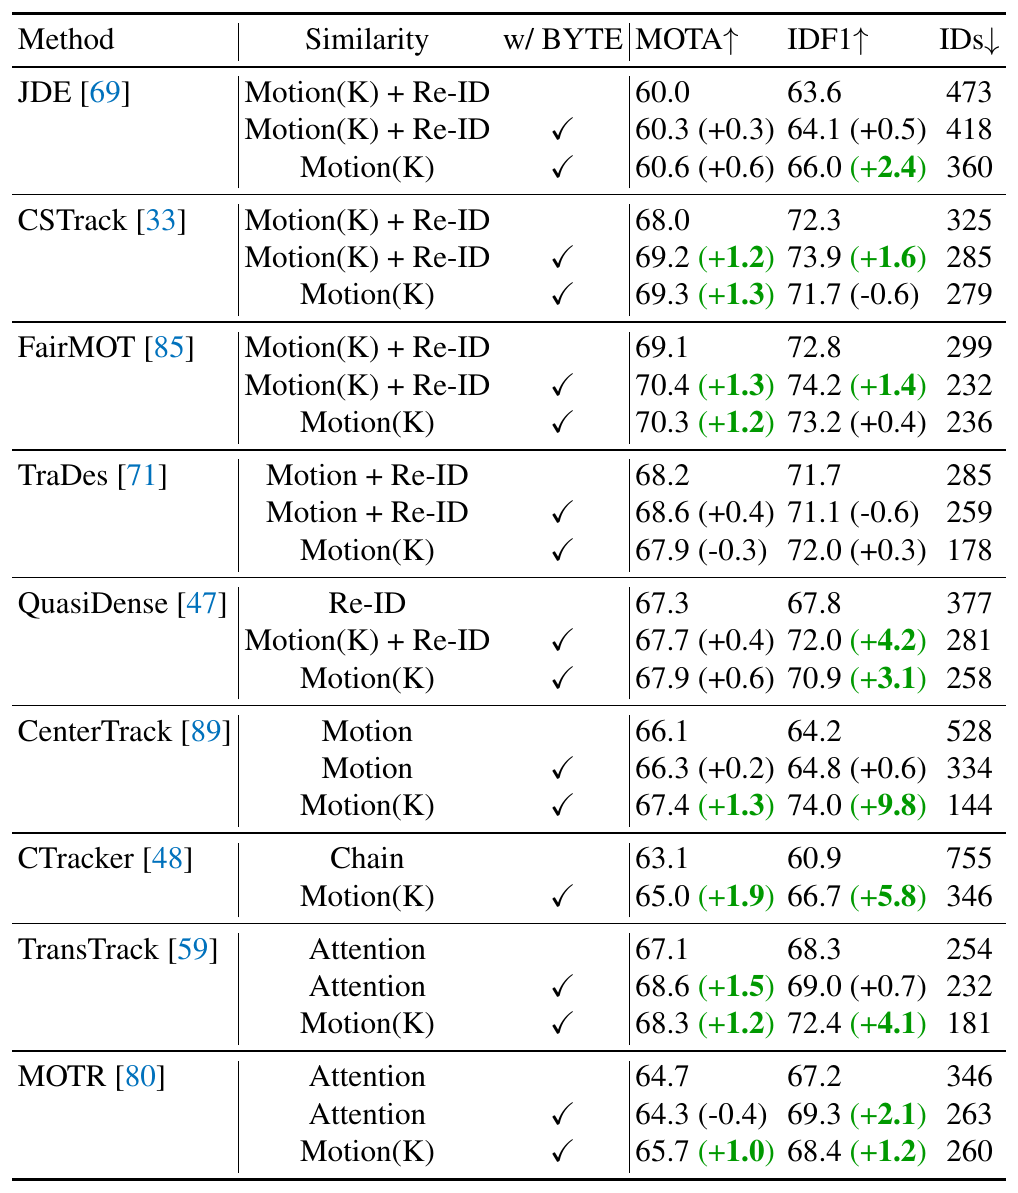
この論文で最も説得力のある表がこれだ。著者らは BYTE を、さまざまなタイプの九つのトラッカーに適用した。JDE、CSTrack、FairMOT、TraDeS のような運動と re-ID を組み合わせた手法、re-ID だけを使う QDTrack、学習による運動を使う CenterTrack、連鎖構造の Chained-Tracker、アテンションでボックスを受け渡す TransTrack と MOTR だ。
適用のしかたは二通りある。
- 差し込みモード: 元の関連付けはそのまま行い、終わったあとで、マッチしなかった軌跡を低スコアのボックスと IoU で一回マッチングする。
- 置き換えモード: そのトラッカーの検出ボックスだけを使い、関連付けはすべて BYTE に置き換える。
ほぼすべてのトラッカー、すべての指標で改善が見られる。最も目立つのは CenterTrack で、置き換えモードでは MOTA が 1.3、IDF1 が 9.8 上がり、ID スイッチは 528 から 144 に減る。CenterTrack はもともと変位からの逆算による局所的なマッチングだけに頼っていて、隠れた人の軌跡が途切れるとすぐ ID が変わってしまう。BYTE の見失った軌跡を保持する仕組みが、ちょうどこの穴を埋めた。
とはいえ、何もかも改善したわけではない。TraDeS は置き換えモードで MOTA が 0.3 下がり、MOTR は差し込みモードで MOTA が 0.4 下がって、IDF1 は 2.1 上がった。この表が比べているのは同じ検出器のもとでの関連付け手法の違いで、BYTE の貢献はおもに IDF1 と ID スイッチに出ている。
リーダーボード
| ベンチマーク | MOTA | IDF1 | HOTA | ID スイッチ | FPS |
|---|---|---|---|---|---|
| MOT17 | 80.3 | 77.3 | 63.1 | 2196 | 29.6 |
| MOT20 | 77.8 | 75.2 | 61.3 | 1223 | 17.5 |
原論文 Table 4、Table 5 の ByteTrack の行をもとに整理。
MOT17 テストセットで、ByteTrack は当時二位の ReMOT を MOTA で 3.3、IDF1 で 5.3、HOTA で 3.4 上回り、速度も表全体で最も速かった。著者らがとくに触れているのは、ByteTrack の訓練データが約 2.9 万枚の画像で、多くの手法が使う 7.3 万枚より少ないことだ。
MOT20 はテスト画像一枚あたり平均 170 人がいて、ずっと混雑している。論文によると、ByteTrack は MOTA を 68.6 から 77.8 に上げ、ID スイッチを 4209 から 1223 へと 71% 減らした。HiEve では MOTA 61.7、IDF1 63.1、BDD100K テストセットでは mMOTA を 35.5 から 40.1 に上げた。四つのベンチマークすべてで一位だ。
ここでは二つのことを区別しておく必要がある。ByteTrack がリーダーボードで大きくリードしたのは、かなりの部分が YOLOX-X という強力な検出器のおかげだ。同じ検出器のもとでの BYTE 自体の貢献は、前の二組のアブレーションを見る必要がある。SORT と比べると MOTA が 2 ポイント、IDF1 が 2.4 ポイント上がり、ほかのトラッカーに適用すると MOTA がおよそ 1~2 ポイント、IDF1 が最大で 10 ポイント近く上がる。付録ではさらに YOLOX の小さいモデルで比べており、BYTE はどの検出器のサイズでも DeepSORT に勝ち、最小の YOLOX-Nano では MOTA が 3 ポイント高かった。
その後
ByteTrack はすぐに、実務でのデフォルトの選択肢になった。Ultralytics の追跡モジュールは ByteTrack と BoT-SORT の二つのトラッカーを提供し、ByteTrack を最も速く最も単純なベースラインと位置づけている。OC-SORT と BoT-SORT はどちらも ByteTrack の YOLOX の重みをそのまま流用して比較しており、ByteTrack を新世代の SORT として扱っているようなものだ。
弱点も早くから見えていた。DanceTrack の論文が報告した ByteTrack の HOTA はわずか 47.7、AssA は 32.1 だった。ダンサーは似た服を着ていて動きも非線形なので、カルマンフィルタと IoU のマッチングでは持ちこたえられず、MOTR も OC-SORT もこのデータセットで ByteTrack を上回った。位置だけで人をつなぐやり方は、人がまっすぐ歩いているときにはよく効くが、人がくるくる回っているときには足りない。
結論
しきい値で捨てられた低スコアのボックスを、前の段階でマッチしなかった軌跡ともう一度マッチングする。使うのは IoU だけ。ByteTrack の手法はこの一つの変更だけで、SORT の ID スイッチは半分近く減り、九つの異なるトラッカーに適用してもほぼすべてが改善し、YOLOX と組み合わせると四つのベンチマークで一位を取った。
今度トラッカーの検出しきい値の調整にうんざりしたら、まず BYTE を試してみるといい。BYTE はしきい値を、一刀両断の生死の境目から、「誰が先にマッチングされるか」を決めるだけのものに変える。
ヘーゲルもまさか、いつか自分が追跡の論文で低スコアのボックスにお墨付きを与えることになるとは思っていなかっただろう。