原始論文
Quasi-Dense Similarity Learning for Multiple Object Tracking
- 發表版本
- CVPR 2021會議
- arXiv 首次提交
- arXiv:2006.06664
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingqdtrack2020,
  title = {{Quasi-Dense Similarity Learning for Multiple Object Tracking}},
  author = {Jiangmiao Pang and Linlu Qiu and Xia Li and Haofeng Chen and Qi Li and Trevor Darrell and Fisher Yu},
  year = {2020},
  eprint = {2006.06664},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.06664}
}
到了 2020 年,多目標追蹤的關聯主要靠位置。
SORT 用 IoU,CenterTrack 預測中心點位移,Tracktor 讓偵測器的迴歸頭把框推到下一幀。只要偵測夠準,相鄰兩幀之間的位置關係就是很強的線索。外觀特徵通常只在旁邊幫忙,用來找回消失一陣子的目標,而且搜尋範圍還得限制在附近,因為外觀特徵不夠可靠,放大範圍反而容易認錯。
但人類追蹤物體,常常只看長相就夠了。浙江大學的 Jiangmiao Pang、ETH Zürich 的 Fisher Yu、UC Berkeley 的 Trevor Darrell 等人認為,外觀特徵不可靠,是因為訓練的方式太浪費。
定義問題
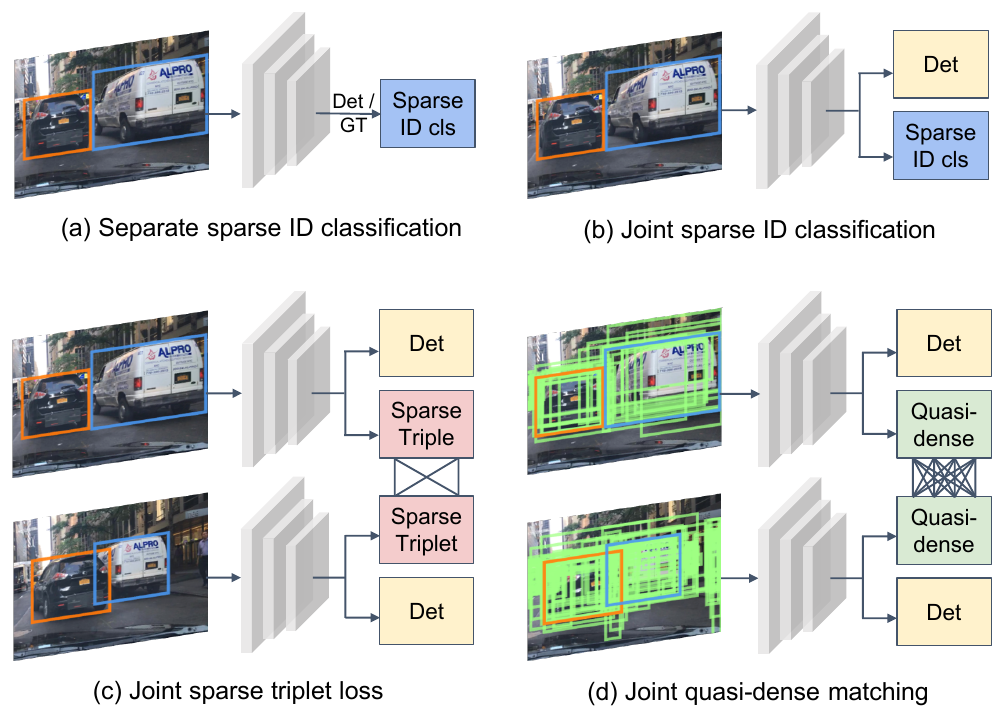
當時學外觀特徵的方法,大致分成這幾種:
- 身分分類: 把訓練集裡的每個身分當成一類,例如 DeepSORT 的 re-ID 模型,以及 JDE、FairMOT 加在偵測器上的嵌入分支。資料集越大,類別數越多,越難擴展。
- 三元組損失: 每個樣本只和一個正樣本、一個負樣本比較。
不管哪一種,訓練樣本都只有真實框,一張影像上可能就十幾個。
可是偵測器在每張影像上會提出幾百個候選區域。靠近真實框的那些,可以當作額外的正樣本;落在背景上的,就是現成的困難負樣本。這些區域原本只用來訓練偵測,學外觀時全被丟掉了。
作者想把這些候選區域全部拿來學外觀。如果特徵空間學得夠好,關聯時就不需要位置、運動、位移預測,只要在特徵空間裡找最近的鄰居就好。
解決問題
準密集取樣
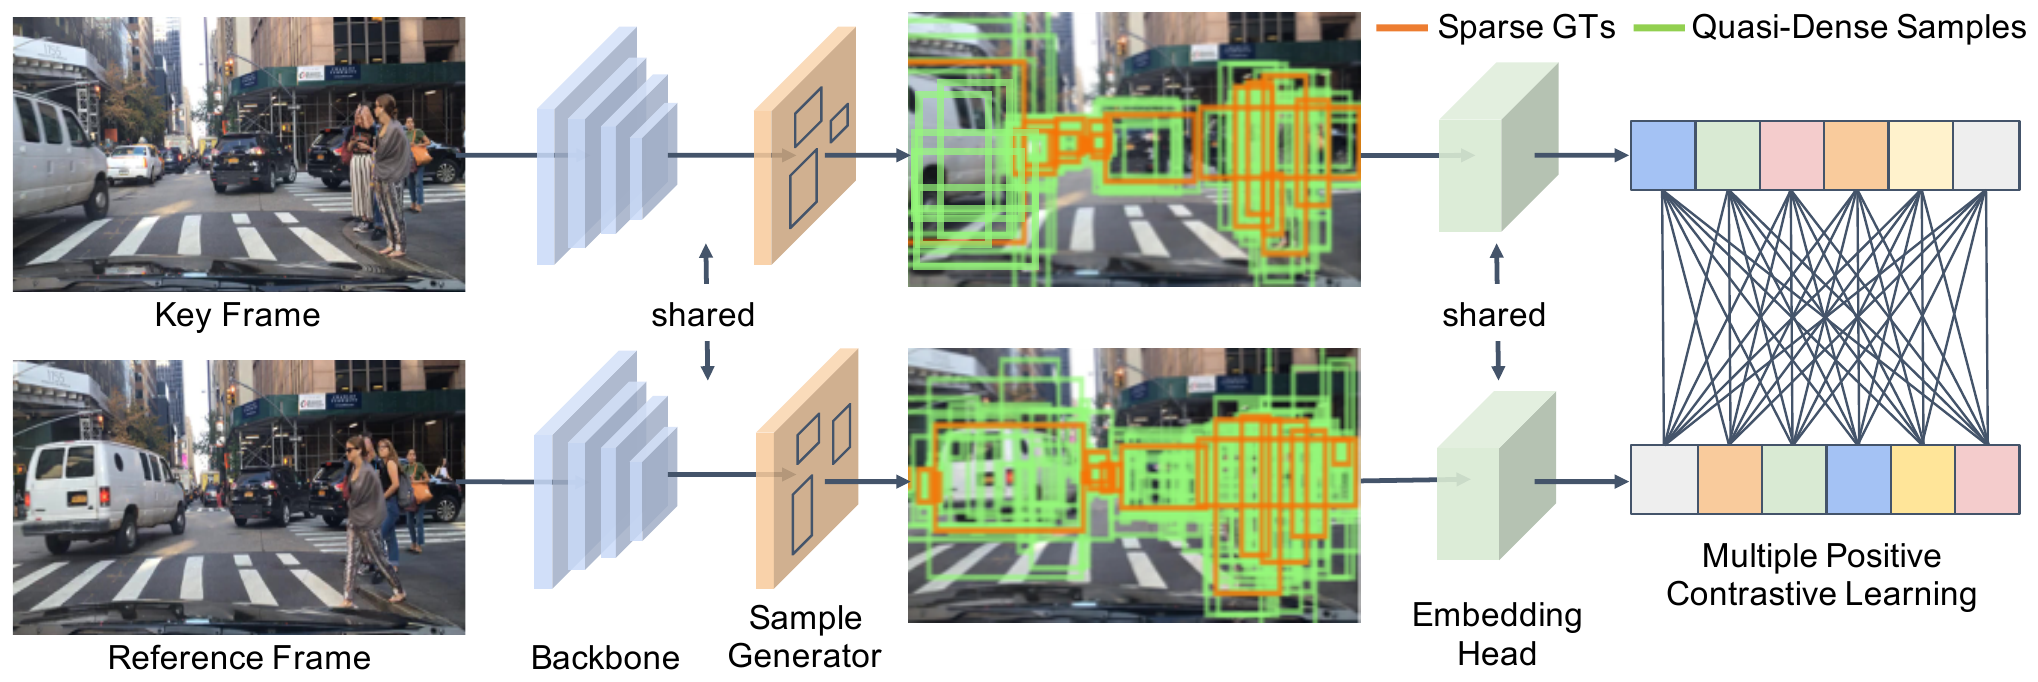
作者把「稠密比對」定義為在所有像素位置上比對候選框;「準密集」只取可能有物體的資訊區域,也就是 RPN 提出的候選框。
偵測器是標準的 Faster R-CNN 加 FPN,骨幹 ResNet-50。在原本的框分類與框迴歸頭旁邊,平行加了一個輕量的嵌入頭(4 層卷積加 1 層全連接),每個候選框輸出一個 256 維的特徵。
訓練時,每次取一張關鍵幀,再從它前後 3 幀內隨機挑一張參考幀。兩張影像各自跑 RPN,得到候選框:
- 一個候選框和某個真實物體的 IoU 大於 0.7,就算是那個物體的樣本;IoU 小於 0.3 就算背景。
- 關鍵幀上的候選框和參考幀上的候選框,若屬於同一個物體,這一對就是正樣本,否則是負樣本。
關鍵幀取 128 個候選框當訓練樣本,參考幀取 256 個當對比目標,正負各半。每個訓練樣本要和參考幀上的全部 256 個目標比較。
多正樣本的對比損失
只有一個正樣本時,可以用標準的 softmax 交叉熵。設 是訓練樣本的特徵, 是正樣本, 是負樣本:
但準密集取樣之後,一個訓練樣本在參考幀上會有好幾個正樣本,同一個物體附近的候選框都算。直接把正樣本加總放進分子,會讓每個負樣本被重複計算好幾次,正樣本卻只算一次。
作者先把上式改寫成
再把正樣本也一起累加:
這樣每一組正負樣本都被公平地比較一次。
另外加一個輔助的 L2 損失,限制特徵的餘弦相似度:
正樣本對 ,負樣本對 。作者說明這個損失的作用是約束 logit 的大小和餘弦相似度,並不直接提升效果。
整體損失是
其中 、。附錄提到 超過 0.5 時效果會下降。
只靠外觀的關聯
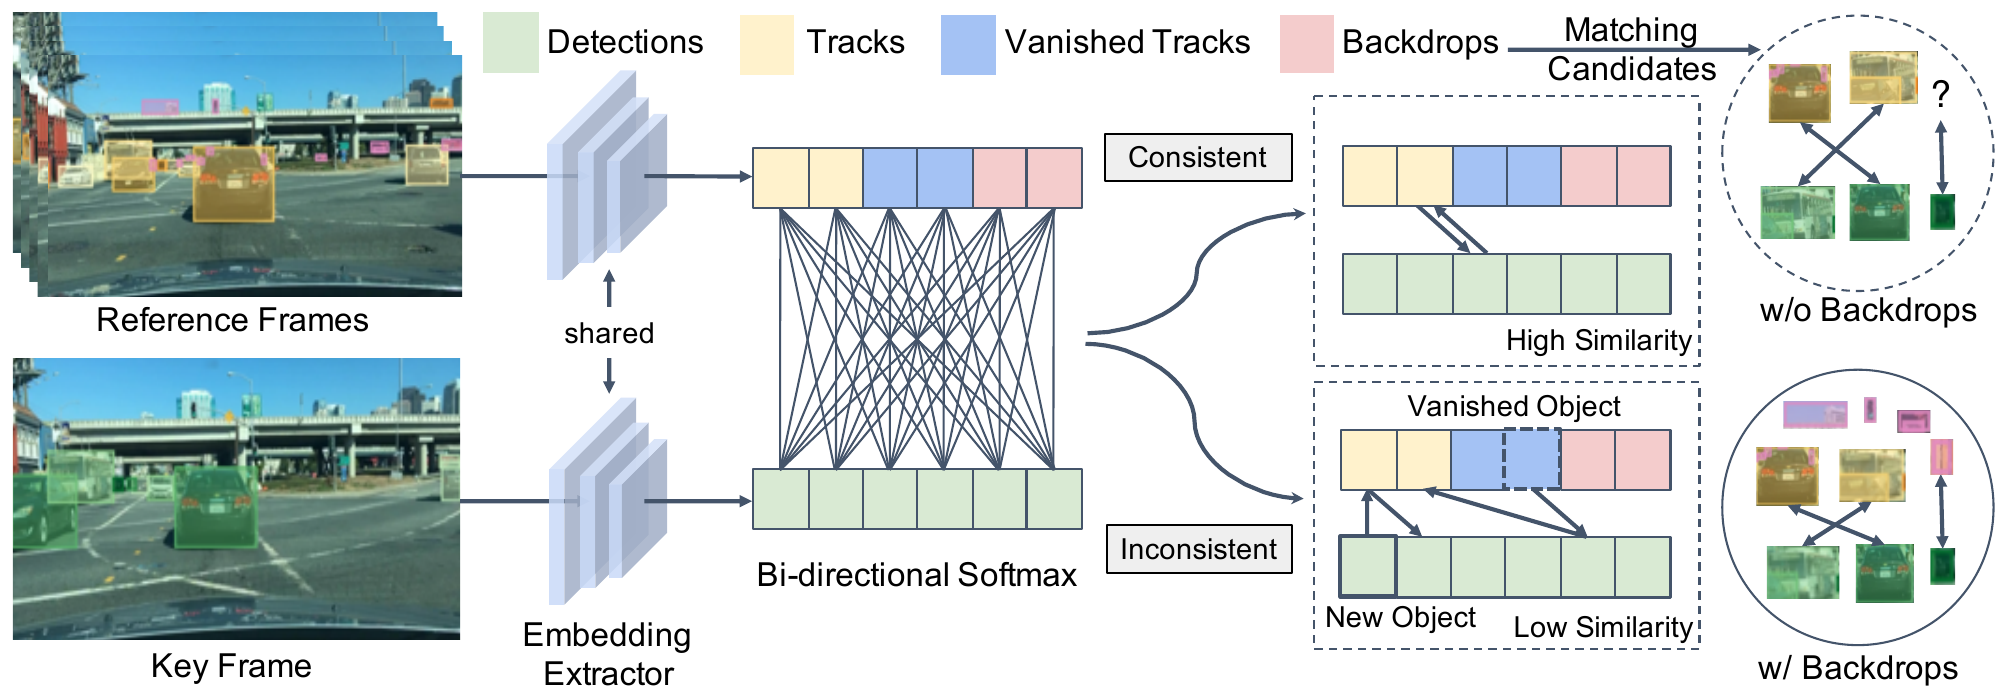
推論時,關聯完全不用位置。但只靠特徵找最近鄰,碰到一個偵測根本沒有對應的軌跡(新物體、誤報),或是有好幾個看起來都像的候選,就很麻煩。作者用三個設計處理。
雙向 softmax。 當前幀有 個偵測,特徵為 ;比對候選有 個,特徵為 。兩者的相似度取兩個方向 softmax 的平均:
第一項問的是「在所有候選裡,偵測 最像誰」,第二項問的是「在所有偵測裡,候選 最像誰」。只有兩邊互為最近鄰時,分數才會高。新出現的物體在候選裡找不到真正的對象,兩個方向的分數很難同時高,自然不會被配上。
保留背景框(backdrops)。 以往的方法會直接丟掉沒配上任何軌跡的偵測。作者認為這些框雖然大多是誤報,但下一幀的誤報很可能長得跟它一樣。把它們保留一幀,當作比對候選,下一幀的誤報就會去配這些背景框,不會被硬塞給真正的軌跡。
跨類別去重。 一般偵測器只在同一類別內做非極大值抑制,同一個位置可能同時出現「行人」和「騎士」兩個框,各自帶著幾乎一樣的特徵。作者在關聯前再做一次跨類別的非極大值抑制,高信心框門檻 0.7,低信心框 0.3。
剩下的都是常見的門檻。偵測信心大於 0.8 才開新軌跡,消失的軌跡保留 10 幀,軌跡特徵用動量 0.8 更新,只有同類別的物體可以互相配對。
討論
哪些設計有用
| 訓練 | 相似度 | 去重 | 背景框 | MOTA | IDF1 | 行人 MOTA | 行人 IDF1 |
|---|---|---|---|---|---|---|---|
| 稀疏 | cosine | 60.4 | 63.0 | 37.6 | 49.7 | ||
| 準密集、單正樣本 | cosine | 61.5 | 66.8 | 40.5 | 52.7 | ||
| 準密集、多正樣本 | cosine | 62.5 | 67.8 | 44.0 | 54.3 | ||
| 準密集、多正樣本 | bi-softmax | 62.9 | 70.0 | 45.5 | 58.8 | ||
| 準密集、多正樣本 | bi-softmax | ✓ | 63.2 | 70.1 | 45.5 | 58.3 | |
| 準密集、多正樣本 | bi-softmax | ✓ | ✓ | 63.5 | 71.5 | 46.7 | 60.2 |
整理自原論文 Table 4,BDD100K 追蹤驗證集。
消融做在 BDD100K 的驗證集上。這是一個行車紀錄器資料集,有 8 個類別,比 MOT17 大得多。
從稀疏改成準密集,IDF1 從 63.0 升到 67.8。其中光是增加負樣本、仍用單正樣本的損失,就貢獻了 3.8 分,約占這段改善的八成。對比目標越多,就算大部分是負樣本,特徵也學得更好。多正樣本的損失再加 1 分。
推論端,雙向 softmax 讓 IDF1 再多 2.2 分,行人類別多了 4.5 分。去重和背景框再加 1.5 分。從頭到尾,IDF1 總共提升了 8.5 分,ID 切換少了 30%。行人這一類最明顯,MOTA 和 IDF1 分別多了 9.1 和 10.5 分。
位置還有沒有用
| 外觀 | IoU | 運動 | 迴歸 | mMOTA | mIDF1 |
|---|---|---|---|---|---|
| ✓ | 26.3 | 36.0 | |||
| ✓ | ✓ | 27.7 | 38.5 | ||
| ✓ | ✓ | 28.6 | 39.3 | ||
| ✓ | 36.6 | 50.8 | |||
| ✓ | ✓ | 36.3 | 49.8 | ||
| ✓ | ✓ | ✓ | 36.4 | 49.9 | |
| ✓ | ✓ | ✓ | 36.4 | 50.1 |
整理自原論文 Table 5,BDD100K 追蹤驗證集;mMOTA、mIDF1 是 8 個類別的平均。
作者照 Tracktor 的作法,用同一個偵測器加上 IoU、運動模型、框迴歸等位置線索。
沒有外觀特徵時,每多一種位置線索,效果都會提升。但有了準密集學到的外觀特徵之後,再加任何位置線索都沒有幫助,甚至略降。最好的結果就是只用外觀。
外觀特徵學得夠好,就不需要位置線索,這是這篇最核心的主張。不過這是在 BDD100K 上的結果。它的追蹤標註是每秒 5 幀,相機又裝在行進中的車上,相鄰兩個標註幀之間,物體的位置和大小都可能變很多,位置線索本來就沒那麼可靠。
各個基準
QDTrack 在四個基準上都報告了結果,除了 COCO 預訓練以外,沒有用額外的訓練資料。
- MOT17(私有偵測): MOTA 68.7、IDF1 66.3,每秒 20.3 幀。比當時的 CenterTrack 高 0.9 和 1.6 分,而 CenterTrack 還用了額外資料。ID 切換 3,378 比 CenterTrack 的 3,039 多,作者的解釋是它的召回率比較高,FN 少了 1.4 萬個,追到的軌跡越多,換 ID 的機會也越多。
- BDD100K: 測試集 mMOTA 35.5、mIDF1 52.3,比官方基準高出 9.2 和 7.6 分,也贏過 2020 年 BDD100K 追蹤挑戰的冠軍。
- Waymo: 驗證集的車輛類別 MOTA 55.6,比 RetinaTrack 高 10.7 分。換上 ResNet-101 和可變形卷積後,測試集上的成績和 2020 年 Waymo 2D 追蹤挑戰的冠軍相當,而它只是一個單一模型。
- TAO: 這個資料集有數百個類別,長尾分布很嚴重。整體 AP50 只比基準高 2 到 3 分,但行人這個常見類別是 38.6 對 18.5。
瓶頸在偵測
附錄裡的兩個 oracle 實驗很有參考價值。
把偵測換成真實框,再用 QDTrack 的特徵去關聯,8 個類別的平均 IDF1 是 88.8,比原本高了 38 分。反過來,偵測維持原樣、改用真實的追蹤標籤去關聯,mIDF1 只多 4.3 分。
也就是說,在 BDD100K 上,QDTrack 的關聯已經很接近上限,大部分的誤差來自偵測。失敗案例也是如此。漏掉的大多是很小或被擠住的物體,誤報是鏡子或廣告看板裡的人。還有一種情況是類別跳動,例如腳踏車被遮住時,「騎士」被偵測成「行人」,QDTrack 只允許同類別配對,ID 就斷了。
後來
「只用外觀就夠」這個結論,後來在 MOT17 上被重新檢驗過。ByteTrack 在 MOT17 的半驗證集上,在 QDTrack 的 re-ID 相似度上加入卡爾曼濾波的運動線索,再套上自己的 BYTE 關聯。MOTA 從 67.3 變成 67.7,IDF1 從 67.8 升到 72.0,ID 切換從 377 降到 281。行人在監視畫面裡走得慢又規律,運動線索在這裡還是很有用。
DanceTrack 則是另一個極端。那裡的舞者穿著相似,外觀很難區分,DanceTrack 的作者在自己的關聯實驗裡也發現,直接加上外觀比對反而會變差。但在同一篇論文裡,換上 YOLOX 偵測器重新訓練的 QDTrack,HOTA 拿到 54.2,比 ByteTrack 的 47.7 還高,關聯準確度 AssA 也是 36.8 對 32.1。準密集學出來的特徵,在外觀幾乎一樣的場景裡,還是分得出一些差別。
結論
QDTrack 換掉的是學外觀特徵的取樣方式。原本只用十幾個真實框,現在把幾百個候選框全部拿來互相比較,再配上一個公平處理多個正樣本的對比損失。
推論時只剩外觀,加上雙向 softmax、保留一幀的背景框、跨類別去重這幾條簡單規則。沒有卡爾曼濾波,沒有 IoU,在 BDD100K 上加了位置線索反而略差。
背景框那一招特別有意思。大部分追蹤器都在想辦法把誤報丟掉,QDTrack 卻把它們留下來,讓下一幀的誤報有個地方可以去。