原論文
Observation-Centric SORT: Rethinking SORT for Robust Multi-Object Tracking
- 発表先
- CVPR 2023国際会議
- arXiv への初回投稿
- arXiv:2203.14360
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingocsort2022,
  title = {{Observation-Centric SORT: Rethinking SORT for Robust Multi-Object Tracking}},
  author = {Jinkun Cao and Jiangmiao Pang and Xinshuo Weng and Rawal Khirodkar and Kris Kitani},
  year = {2022},
  eprint = {2203.14360},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.14360}
}
ByteTrack は、検出器さえ十分に強ければ、カルマンフィルタと IoU マッチングで MOT17 の一位を取れることを示した。
ところが DanceTrack に移ると、事情が変わる。このデータセットが撮っているのは群舞で、ダンサーはほとんど同じ服を着て、回転し、交差し、跳び、位置を入れ替える。検出はまったく難しくない。難しいのは、一人ひとりの動きが直線ではないことだ。ここでの ByteTrack の HOTA は 48 に届かず、エンドツーエンドの MOTR に大きく水をあけられた。
こうして見ると、運動モデルに頼るトラッカーは行き止まりに来たように思える。
カーネギーメロン大学の Jinkun Cao、Kris Kitani らはそう考えなかった。彼らの考えでは、カルマンフィルタそのものは間違っていない。間違っているのは SORT のカルマンフィルタの使い方だ。「対象が見えない数フレーム」に溜まる誤差をうまく処理しさえすれば、最も基本的なカルマンフィルタでも当時の最高成績を出せる。
この論文は SORT を一から分解して点検し、最後に出してきたトラッカーは、ネットワークを一切訓練する必要がなく、検出ボックスが与えられれば CPU 一つで毎秒 700 フレーム以上を処理できる。
問題の定義
まず、SORT がカルマンフィルタをどう使っているかをおさらいしよう。
各対象の状態は で、それぞれボックスの中心、面積、縦横比、そして最初の三つの速度だ。各フレームではまず予測を行い、等速度モデルで状態を先へ進める。
このフレームで割り当てられた検出ボックスがあれば、それで更新して予測を補正する。
問題は検出ボックスがないとき、たとえば対象が遮蔽されたときに起こる。SORT は予測をそのまま更新後の結果として扱う。
著者らはこの手順を「ダミー更新」(dummy update)と呼ぶ。その背後にある考え方は、観測がないときは自分の推定を信じる、というものだ。軌跡はつねに推定によって先へ延び、検出ボックスは推定を補正するための補助的な情報にすぎない。著者らはこの設計を推定中心(estimation-centric)と呼んだ。
SORT の限界を見直す
著者らはこの設計を出発点に、互いに絡み合う三つの問題を指摘する。
一、状態のノイズに敏感すぎる。
推定した中心位置に標準偏差 のノイズが乗っていて、各フレームのノイズは互いに独立だとする。速度は二つの位置の差を時間間隔で割ったものだ。
が小さいほど、速度のノイズは大きくなる。
あいにく、複数物体追跡の動画はどれもフレームレートが高い。著者らが MOT17 の訓練セットで調べたところ、隣り合う二フレームの間での対象の平均移動量は、水平方向でわずか 1.93 ピクセル、垂直方向でわずか 0.65 ピクセルだった。計算してみよう。位置のノイズがたった 1 ピクセルだとしても、隣り合う二フレームから求めた速度のノイズの標準偏差は ピクセル/フレームになり、本当の速度とほぼ同じ大きさだ。
これは実に逆説的な現象だ。フレームレートが高いほど、等速度の線形仮定はもっともらしくなる。だが二フレーム間の移動量も小さくなり、ノイズと同じ桁まで小さくなると、推定した速度はかえって当てにならなくなる。
二、誤差が時間とともに増幅される。
検出ボックスがあれば、速度の推定が多少不正確でも、次の更新で位置を引き戻せる。ところが対象が遮蔽されたとたん、カルマンフィルタはダミー更新でひたすら先へ進めるしかない。 フレーム遮蔽された後はこうなる。
位置の誤差の標準偏差は に比例する。位置のノイズが 1 ピクセルで 10 フレーム遮蔽されれば、位置の標準偏差は ピクセルになる。付録の分析では、実際のカルマンフィルタは速度の項にもプロセスノイズがあるので、この簡略版よりも速く誤差が溜まることも指摘されている。混雑した場面では、十数ピクセルずれれば、もう隣の人を囲んでしまっている可能性が高い。
三、推定中心であること。
前の二つの問題の根っこは、SORT が推定を観測より優先していることにある。だが検出器のノイズはフレームごとにほぼ独立で、時間とともに溜まっていくことはない。しかも現代の検出器は正確で、単一フレームでの位置の誤差は、たいていカルマンフィルタがずっと推し進めてきた推定より小さい。
つまり、検出器が「人はここにいる」とはっきり告げているのに、トラッカーは自分の推定に従って、軌跡を別の場所へ延ばしてしまう。
これではまったく本末転倒だ。
なぜ再びマッチしてもまた見失うのか
付録には、さらに細かい観察もある。この三つの問題が実際にとりわけ厄介な理由を説明するものだ。
本来なら、対象が再び現れて検出ボックスとマッチした後、カルマンフィルタの更新で溜まったずれを補正できるはずだ。ところが実際には、SORT は速度の項のプロセスノイズをごく小さく設定している(公式のコードでわずか 0.01、面積の速度にいたってはわずか 0.0001)。速度の推定がもともと敏感すぎて、抑えておかないとあちこちに跳ねてしまうからだ。その代償として、フィルタは速度の補正にきわめて慎重になる。
その結果、対象が遮蔽されている間に速度の向きはとうにずれていて、再びマッチしたときの一回の更新で位置は引き戻されても、速度の向きはほとんど変わらない。次のフレームでは間違った向きのまま予測し、対象をまた見失う。
それなら、推定をより信じるのをやめて、いっそ追跡を観測中心にしてしまうのは、良い考えではないだろうか?
問題を解く
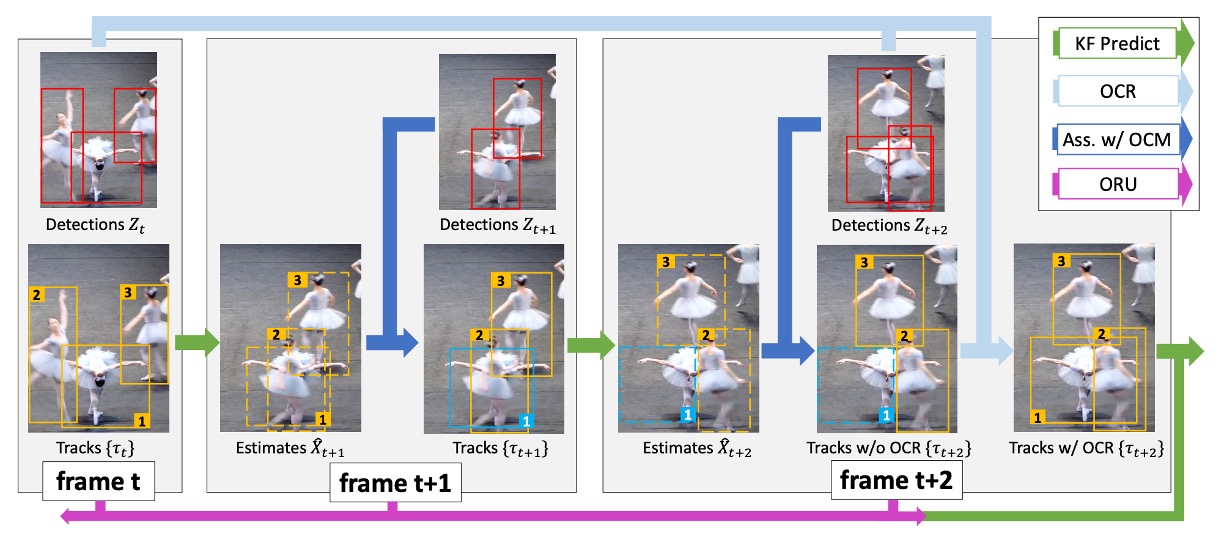
OC-SORT(Observation-Centric SORT)は SORT の骨格をそっくり残していて、カルマンフィルタも IoU もハンガリアン法もそのままだ。三つの箇所を観測中心に変えている。
図のバレエダンサー 1 番を追って、一通りたどってみよう。
- frame t: 1 番は普通に追跡されている。マッチングでは IoU に加えて、「運動の向きが一致しているか」というコストの項も入れる。これが OCM だ。
- frame t+1: 1 番がほかのダンサーに隠れ、検出ボックスが一つも割り当てられず、軌跡は一時的に見失った状態(青枠)になる。
- frame t+2: 1 番が再び現れる。カルマンフィルタの予測はすでにずれていて、新しい検出ボックスと合わない。だが OC-SORT は、frame t での 1 番の最後の観測を持ち出して、まだマッチしていない検出ボックスともう一度試し、1 番を見つけ直す。これが OCR だ。
- 見つけ直した後: 1 番が見失った状態から復帰すると ORU が発動し、frame t から t+2 までの間のカルマンフィルタのパラメータを巻き戻して計算し直す。
Observation-Centric Re-Update (ORU)
ORU は「再びマッチした後にまた見失う」問題を専門に扱う。
ある軌跡が、しばらく見失われた後で再び検出ボックスとマッチすると、ORU は見失っていた期間を振り返る。最後に見えた観測を 、再びマッチした観測を とする。この二つの本物の観測を端点にして、その間に仮想の軌跡を生成する。
ここで だ。
これは等速度の仮定のもとでの線形補間だ。続いてカルマンフィルタは から始め、これらの仮想の観測に沿って「予測、更新」のループをもう一度走らせる。
SORT との違いを数値の例で見てみよう(数字は説明用に設定したものだ)。ある人が第 10 フレームで最後に見えたとき、中心は にあった。5 フレーム遮蔽され、第 16 フレームで に再び現れる。その人は隠れている間に足を速めたが、カルマンフィルタが持っている速度はもとの 1 フレームあたり 2 ピクセルのままだ。
- SORT: 第 11 から 15 フレームはすべてダミー更新で、予測は第 16 フレームの まで進む。130 とマッチした後は一回しか更新しない。速度の項のノイズがごく小さく設定されているので、位置は引き戻されても、速度は 2 に近いままだ。次のフレームでは、また間違った場所を当て推量する。
- ORU: 100 と 130 を端点にして、第 11 から 15 フレームの仮想の観測 105、110、115、120、125 を生成する。カルマンフィルタはこの区間をもう一度たどり、どのステップでも 1 フレームあたり 5 ピクセルの移動を目にするので、速度は一歩ずつ 5 に引き寄せられていく。
ORU は予測を賢くするのではない。フィルタが再び走り出す前に、「見えている最初と最後」で間を埋め、何回か多く更新させるのだ。
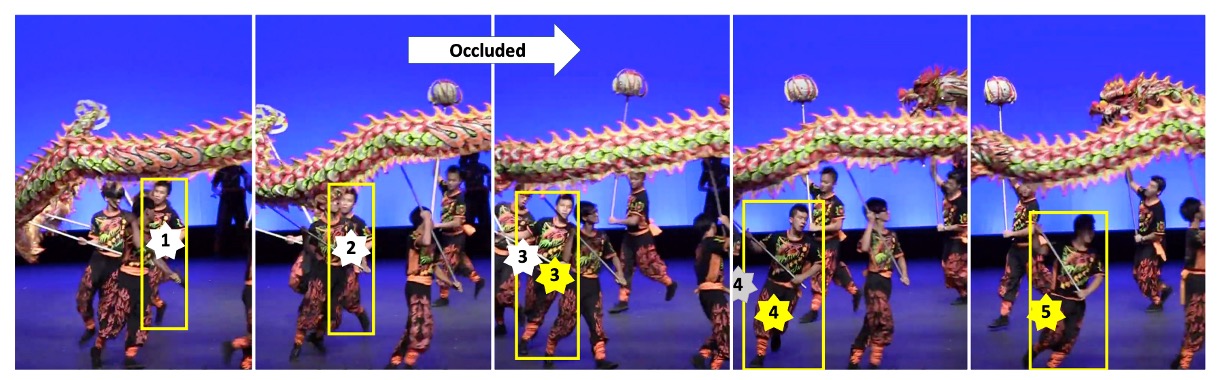
これは論文に載っている実例だ。龍舞の演者は二つ目と三つ目の時点の間で遮蔽され、三つ目の時点で再び見つかる。ORU がないと、推定した中心(白い星印)は古い向きのままずれていき、四つ目の時点(灰色の星印)ではもう観測とマッチしない。ORU で補正した推定(黄色い星印)は、ずっとその人についていっている。
Observation-Centric Momentum (OCM)
等速度の仮定には、「速度が変わらない」ことに加えて、実は「向きが変わらない」ことも含まれている。左へ歩いている人が、次のフレームで突然右側のボックスとマッチすることはまずない。SORT はこの手がかりを使えない。速度の向きを推定から計算していて、ノイズが大きすぎるからだ。
OCM は観測から向きを計算し、向きの一貫性をマッチングのコスト行列に加える。
は IoU の符号を反転したもの、 は向きの差で、 だ。 は既存のすべての軌跡の過去の観測、 はこのフレームの新しい検出である。
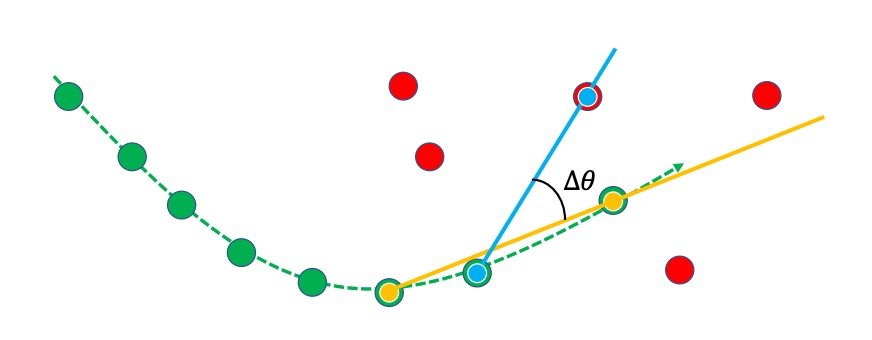
図では、緑が既存の軌跡、赤い点がこのフレームの新しい検出だ。軌跡と検出の組ごとに、二つの向きを計算する。
- (青い線):軌跡上で フレーム離れた二つの観測を結んだ向き。つまり、この軌跡がこれまでどちらへ進んできたか。
- (黄色い線):軌跡の過去の観測からこの新しい検出へ結んだ向き。つまり、「もしこの検出を割り当てたら」、この先どちらへ進むことになるか。
向きは でラジアン単位で計算し、両者の差 が向きのコストになる。向きが揃っているほどコストは低く、マッチしやすい。
ここには一つのトレードオフがある。付録 A では向きのノイズの確率分布を導いていて、二つの観測の間隔が長いほど向きの推定のノイズは小さくなるので、 は大きめにすべきだという結論になる。だが間隔が長すぎると、線形運動の仮定が成り立たなくなる。実装では、著者らは を取った。
Observation-Centric Recovery (OCR)
最後は経験的な小技だ。通常の関連付けが終わった後、まだマッチしていない軌跡について、その最後の観測を使い、まだマッチしていない検出ボックスともう一度 IoU でマッチングする。
この段階はカルマンフィルタの予測に頼らないので、対象が立ち止まったときや、ほんの短い間だけ遮蔽されたときにとくに役立つ。予測はもうずれてしまっているが、人は実はもとの場所の近くにいる。
議論
著者らは MOT17、MOT20、KITTI、DanceTrack で評価し、頭部追跡のデータセット CroHD の結果は付録に載せている。
追跡アルゴリズムだけを比べるため、OC-SORT は独自の検出器を訓練しない。MOT17、MOT20、DanceTrack では ByteTrack が公開した YOLOX の重みをそのまま使い、KITTI では PermaTrack が公開した検出結果を使う。すべてのデータセットで一組のパラメータを共有し、検出スコアのしきい値は 0.6(MOT20 は 0.4)、IoU のしきい値は 0.3 だ。
主要な指標は HOTA で、ほかに関連付けを測る AssA と IDF1 を重視する。著者らがとくに注意を促しているのは、MOTA は検出の質との関係が密接すぎるので、全員が同じ検出を使うときにしか比べるのに向かないという点だ。どの表でも、検出を共有する手法をいちばん下に別のグループとして囲んでいるのはそのためだ。
DanceTrack の結果
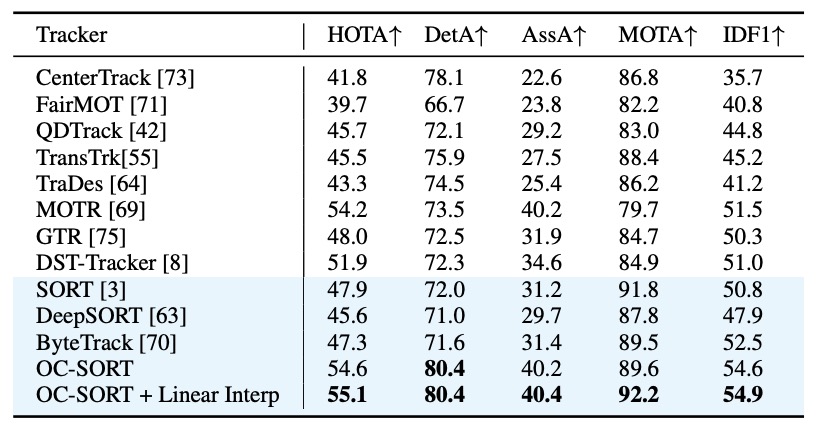
DanceTrack はこの論文のホームグラウンドなので、まずこれを見よう。
水色の区画の四つの手法は同じ検出を使っている。SORT の HOTA は 47.9、ByteTrack は 47.3 で、外観特徴を加えた DeepSORT はさらに低く 45.6 しかない。ダンサーはみな同じ服装なので、外観は役に立たない。OC-SORT は 54.6 で、AssA は 31 前後から一気に 40.2 まで上がり、IDF1 も四つの中で最も高い。
次に表の上のほうの MOTR と比べてみる。MOTR はエンドツーエンドの Transformer トラッカーで、HOTA 54.2、AssA 40.2 だ。OC-SORT は追跡用のネットワークを一切訓練せずに、HOTA 54.6、AssA も 40.2。両者の検出器は違い、OC-SORT のほうが DetA はずっと高いが、関連付けを測る AssA はまったく同じだ。関連付けが最も試されるデータセットで、運動モデルだけのトラッカーが、エンドツーエンドの学習手法に追いついた。
MOT17 の結果
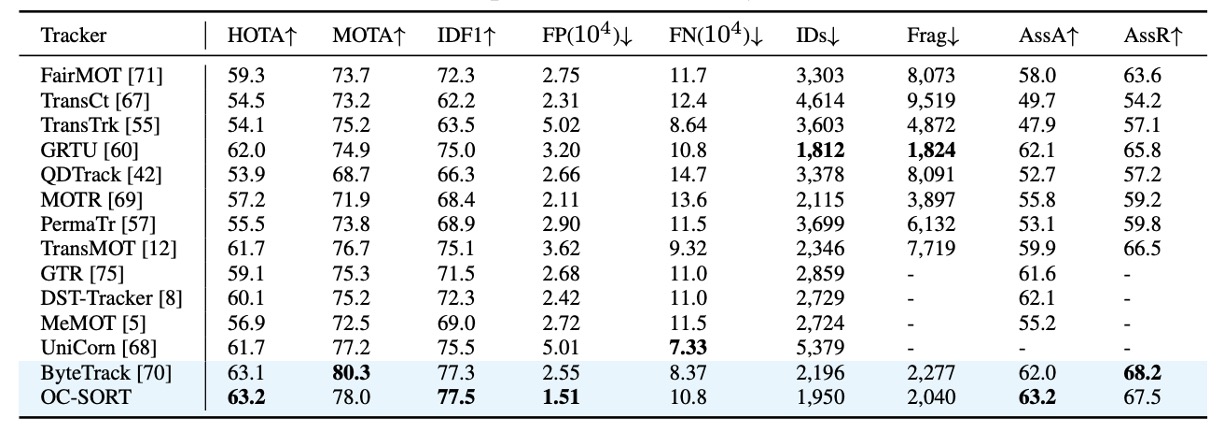
MOT17 の歩行者はたいてい直線的に歩くので、SORT の仮定はここではもともとそれなりに妥当だ。検出を共有する ByteTrack と比べると、OC-SORT は HOTA が 63.2 対 63.1、IDF1 が 77.5 対 77.3 で、ほぼ互角だ。ID スイッチは 2196 から 1950 に減った。
ただし MOTA は 2.3 ポイント低い(78.0 対 80.3)。原因は FP と FN の二列にある。OC-SORT は誤検出がずっと少ない(1.51 万対 2.55 万)が、検出漏れはずっと多い(10.8 万対 8.37 万)。ByteTrack は低スコアのボックスをすくい上げてマッチングするが、OC-SORT は一般的なやり方どおり低スコアのボックスを捨て、しきい値を別途調整することもしない。取りこぼしたボックスは、そのまま MOTA に表れる。
MOT20 の結果
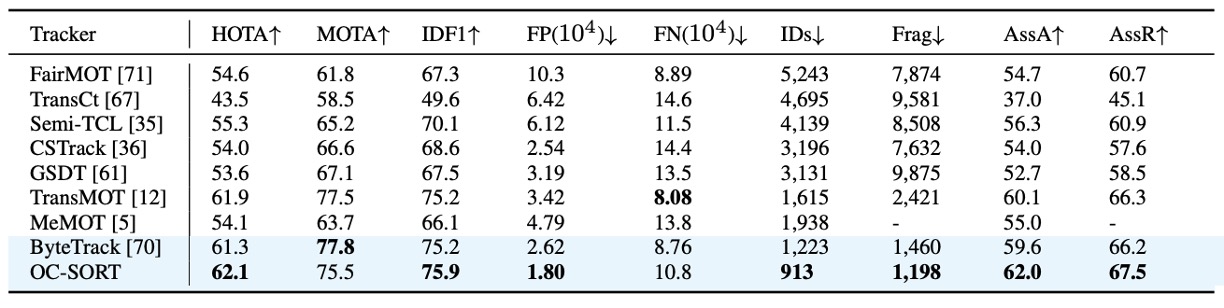
MOT20 はずっと混雑していて遮蔽も多く、まさに誤差の蓄積が最もひどくなる場面だ。ここで OC-SORT の優位がはっきり開く。HOTA は 62.1 対 61.3、AssA は 62.0 対 59.6、ID スイッチは 1223 から 913 に減り、HOTA は論文発表時点で MOT20 の最高スコアだった。MOTA はやはり検出漏れが多いせいで ByteTrack より低い。
この二つの表では、MOT17 と MOT20 のどちらでも、ベースラインの手法と同じく線形補間の後処理を引き継いでいる。検出器の影響を除くため、著者らは付録で公式の公開検出を使った結果も報告しており、この設定でも OC-SORT が上回っている。
KITTI の結果
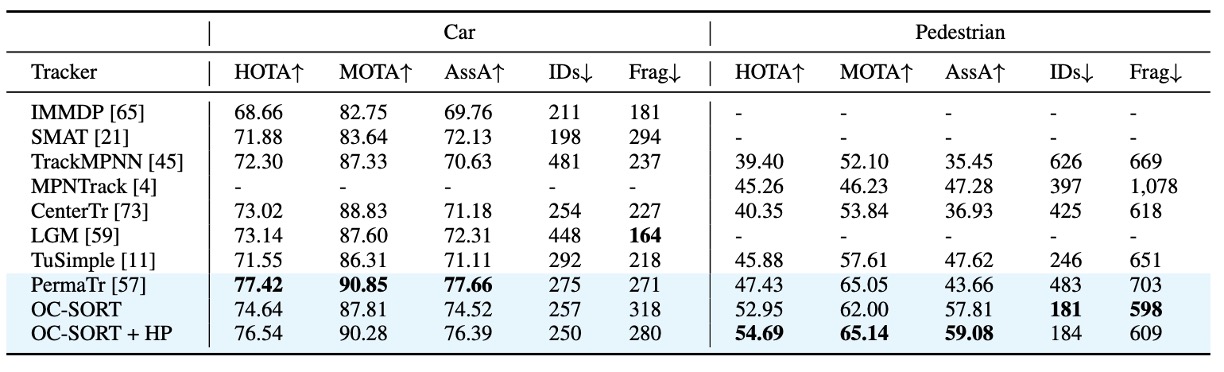
KITTI は車載動画で、フレームレートは 10 FPS しかない。結果は半分が良く、半分が悪い。
歩行者では、同じ検出を使って、OC-SORT の HOTA は 52.95 で、PermaTrack の 47.43 を 5 ポイント以上上回り、速度も 10 倍速い。表の HP はオフラインの「ヘッドパディング」だ。SORT 系列の軌跡は、何フレームか連続してマッチしてはじめて出力が始まる。この初期の出力されなかったボックスを、オンラインの追跡が終わった後で書き戻す。書き戻した後の歩行者の HOTA は 54.69 だ。
自動車はうまくいかない。OC-SORT の HOTA は 74.64 で、HP を加えても 76.54 にとどまり、どちらも PermaTrack の 77.42 より低い。著者らの説明は率直だ。車は速く走り、フレームレートも低いので、隣り合う二フレームのボックスはほとんど重ならず、IoU はゼロに近い。そして OC-SORT のデフォルトの関連付けが頼っているのが、まさにその IoU だ。これは観測中心の設計の問題ではなく、IoU で関連付けるすべての手法が直面する問題で、ほかの関連付けの手がかりや外観特徴を加えれば緩和できる。
モジュールの貢献の分析
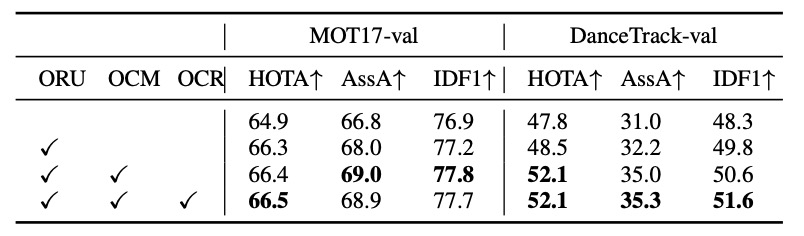
三つのモジュールを順に加えていく。
- ORU はどちらのデータセットでも効く。 MOT17 検証セットの HOTA は 64.9 から 66.3 に、DanceTrack は 47.8 から 48.5 に上がる。
- OCM の効果は場面しだい。 DanceTrack では、OCM で HOTA が 48.5 から 52.1 に跳ね上がり、三つのモジュールの中で最も大きな一歩になる。MOT17 では 66.3 から 66.4 に上がるだけだ。歩行者がたいてい直線的に歩くときには、向きの一貫性という手がかりにはもともと大した情報がない。ダンサーがくるくる回るときになって、ようやく出番が来る。
- OCR は仕上げ。 MOT17 の HOTA は 0.1 上がる。DanceTrack の HOTA は変わらず、IDF1 が 50.6 から 51.6 に上がる。
ORU の仮想軌跡の生成方法
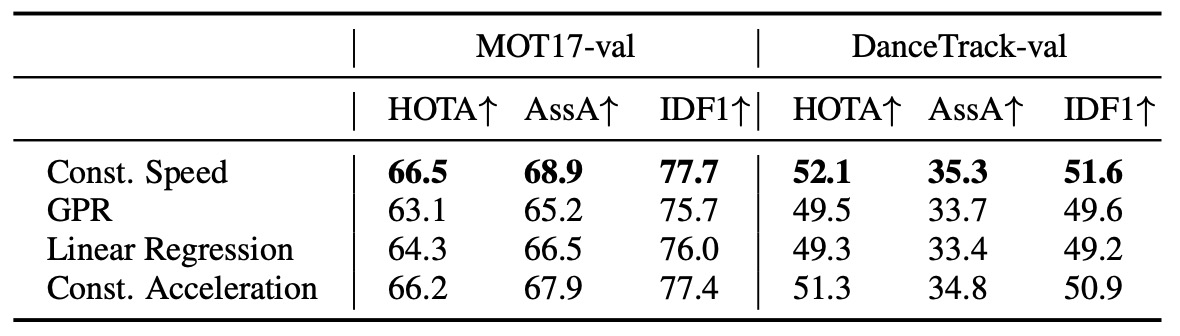
仮想の軌跡は、直線でなければならないのか? 著者らは等加速度、線形回帰、そして RBF カーネルを使ったガウス過程回帰(GPR)を試した。
結果は、最も単純な等速度が六つの数字すべてで最良で、等加速度がそれに次いだ。線形回帰と GPR ははっきり劣り、GPR は MOT17 で HOTA が 3.4 ポイントも下がった。著者らの推測では、ORU はオンラインで実行されるので手元には限られた過去の観測しかなく、大域的な当てはめの手法では信頼できる軌跡を得にくい。最初と最後の二点だけを見る局所的な仮定のほうが、かえって安定する。
付録ではさらにオフラインの補間による後処理も比べていて、結論は似ている。MOT17 検証セットで、線形補間は HOTA を 66.5 から 68.0 に上げるが、GPR による補間では 65.2 に下がる。面白いことに、同じ時期の StrongSORT は、その GSI が同じくガウス過程で穴を埋めているのに、改善をもたらしている。二つの論文の設定は同じではなく、GSI はカーネルの幅を軌跡の長さに応じて調整している。同じ道具でも、使い方が違えば結果は大きく変わりうる。
OCM の Δt の選び方
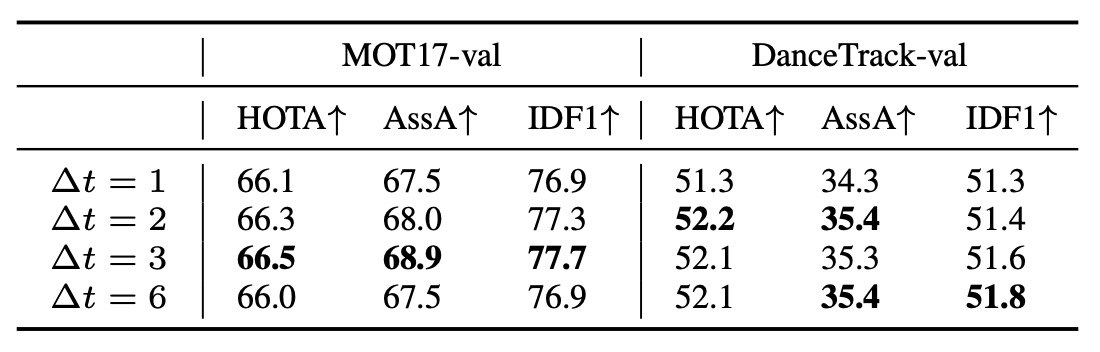
この表は、さきほどのトレードオフを裏づけている。 を 1 から 2、3 に増やすと、どちらのデータセットでも性能が上がる。向きの推定のノイズが小さくなるからだ。
ところが 6 まで延ばすと、MOT17 の HOTA は 66.5 から 66.0 に下がってしまう。間隔が長すぎると、対象はもうとっくに直線運動をしていない。DanceTrack では の HOTA がわずかに高く(52.2)、 と 6 はどちらも 52.1 で、差はごく小さい。著者らは最終的に、すべてのデータセットで に統一した。
速度
検出ボックスが与えられれば、OC-SORT は Intel i9-9980XE CPU 一つで毎秒 793 フレームを処理する。新しく加えた三つのモジュールはどれも幾何的な計算だけで、ニューラルネットワークは一切なく、コストはほとんど増えない。
その後
著者らは付録で、OC-SORT は運動モデルだけの手法だが、外観の手がかりを加えるのは簡単だと述べている。同じ研究室が翌年発表した Deep OC-SORT は、OC-SORT に適応的な re-ID を加え、MOT17、MOT20、DanceTrack でさらに性能を伸ばした。2023 年の Hybrid-SORT は、OC-SORT の観測中心のモメンタムと関連付けを受け継ぎ、さらにボックスの角の向き、検出の信頼度、高さといった弱い手がかりを加えた。
同じ年の少し後に出た BoT-SORT も、OC-SORT を比較表に入れている。BoT-SORT は ByteTrack にカメラ運動補償を加える道を選び、別の種類の「予測のずれ」に取り組んだ。人は動いておらず、カメラが動いている場合だ。
結論
OC-SORT はカルマンフィルタを取り替えず、対象が見えないときの振る舞いだけを変えた。ORU は対象が戻ってきたときに、最初と最後の二つの本物の観測で間を埋め、速度を補正し直す。OCM は観測から計算した向きでマッチングを助ける。OCR は最後の観測でもう一度探す。その結果、DanceTrack では、訓練の要らない運動モデルのトラッカーが、エンドツーエンドの MOTR に追いついた。
応用に引きつけて言えば、この論文から得られる示唆は一文にまとめられる。
検出器が十分に信頼できるなら、追跡の核心はより複雑な予測モデルではなく、観測をいかに有効に使うかにある。
手元のシステムがすでに SORT か ByteTrack なら、この三つのモジュールはどれも何も訓練し直す必要がない。ただ、車が速くなりフレームレートが低くなると、IoU マッチングがやはり真っ先に持ちこたえられなくなることは覚えておきたい。
隠れている数フレームのあいだ、フィルタにやみくもに当て推量させ続けるより、人が戻ってくるのを待って、巻き戻して計算し直したほうがいい。