原論文
StrongSORT: Make DeepSORT Great Again
- arXiv への初回投稿
- arXiv:2202.13514
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingstrongsort2022,
  title = {{StrongSORT: Make DeepSORT Great Again}},
  author = {Yunhao Du and Zhicheng Zhao and Yang Song and Yanyun Zhao and Fei Su and Tao Gong and Hongying Meng},
  year = {2022},
  eprint = {2202.13514},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2202.13514}
}
複数物体追跡のリーダーボードは、ますます読み解きにくくなってきた。
論文ごとに検出器が違う。Faster R-CNN を使うもの、CenterNet を使うもの、YOLOX を使うものがある。re-ID モデルもまちまちで、追加の訓練データの量もばらばら、推論時にはそれぞれ別の小技も足している。ある手法が別の手法より 2 ポイント高くても、関連付けのアルゴリズムが優れているのか、検出器が強いのか、それとも何かの小技を一つ多く足しただけなのか、はっきり言うのは難しい。
北京郵電大学の Yunhao Du らは、古なじみの DeepSORT を振り返ってみることにした。
2017 年に生まれたこのトラッカーは単純で拡張しやすく、実務では広く使われているが、リーダーボードではとうに置いていかれている。著者らの考えでは、後れを取った原因は部品が古すぎることにあり、追跡の枠組みとは関係ない。それなら部品を一つずつ新しくして、どこまで走れるか見てみよう、というわけだ。
論文のタイトルは「Make DeepSORT Great Again」。
論文を読み慣れてくると気づくが、近ごろはみんな何かを「再び偉大に」するのに大忙しだ。RepVGG は VGG を再び偉大にしようとし、翌年にはさっそく RepVGG を「もっと」偉大にしようとする人が現れた。GCN、FCN、エンコーダ・デコーダ、LoRA、果ては Sigmoid と MSE の組み合わせまでが列をなして、もう一度偉大になる順番を待っている。せっかくの選挙スローガンも、研究界で使い回されすぎてカビが生えそうだ。(著者の皆さん、このネタはもう本当に引退させてあげていい。)
幸い、今回順番が回ってきた DeepSORT は、この後ちゃんと結果を出している。
問題の定義
著者らが解決したいことは二つある。
一つ目は公平な比較だ。現在の優れた検出器と re-ID モデルに、整理した推論の工夫一式を加えて、強くて公平なベースラインを提供したい。新しい手法はこのベースラインと比べてはじめて、自分の貢献がどこにあるのかわかる。著者らはさらに、この部分ではアルゴリズム上の新しさは一切主張せず、貢献は DeepSORT をきちんと分解して新しい部品を取りつけたことにあると、わざわざ断っている。
二つ目は、複数物体追跡に固有の二種類の「欠落」だ。
- 関連付けの欠落(missing association): 同じ物体がいくつもの短い軌跡に分断される。オンラインのトラッカーは全体を見渡す情報を持たないので、とくに起こりやすい。
- 検出の欠落(missing detection): 物体が背景と見なされる、つまり検出漏れで、たいていは遮蔽か解像度の低さが原因だ。
既存の解き方にはそれぞれ代償がある。短い軌跡をつないで長い軌跡にするには、オフラインの大域的な連結モデルを使うのが一般的だが、その多くは外観特徴に頼っていて計算量が大きい。検出漏れを埋めるには線形補間がよく使われるが、線形補間は運動の情報をまったく考慮しない。
問題を解く
まず DeepSORT を分解する
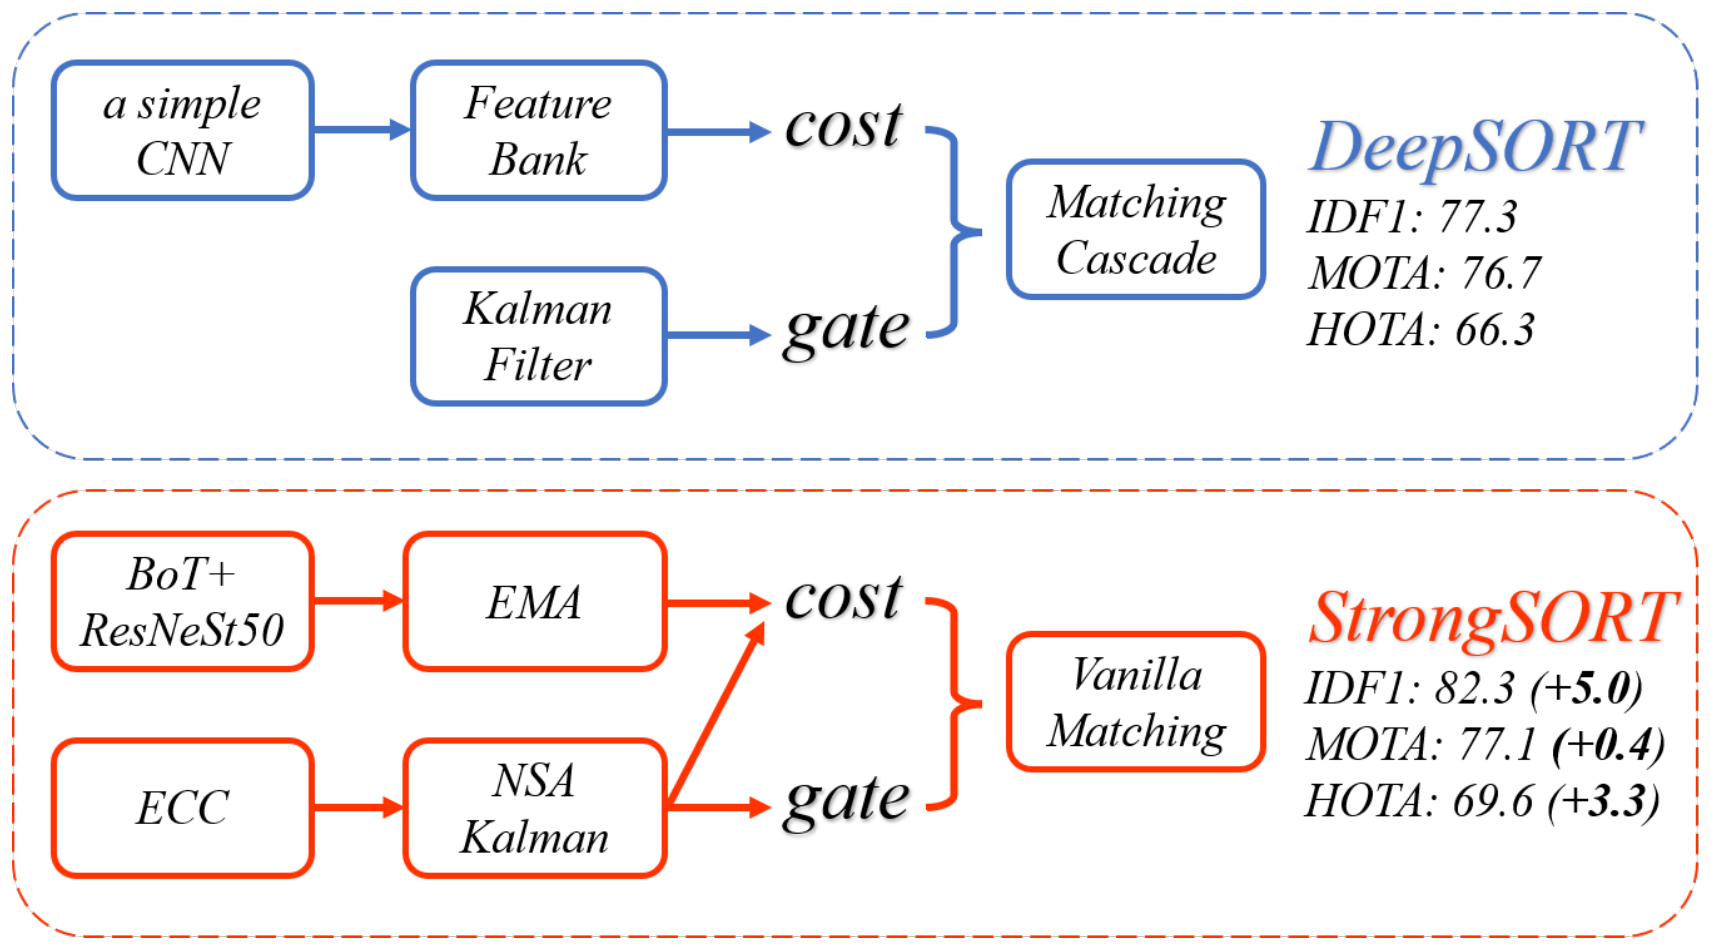
著者らは DeepSORT を二つのブランチとして捉える。
外観ブランチ: MARS 歩行者データセットで事前学習した単純な CNN が、各検出ボックスから特徴を抽出する。各軌跡は直近 100 フレームの特徴を保持して特徴バンクを作る。新しい検出と軌跡の外観距離は、特徴バンクの中で最も似ている一つとのコサイン距離を取る。
運動ブランチ: カルマンフィルタで軌跡のこのフレームでの位置を予測し、マハラノビス距離をゲートとして使って、ありえないマッチングを除く。
最後に、マッチングカスケードがマッチングをいくつかの部分問題に分け、最近見かけた軌跡から先に選ばせる。
公平に比べるには、まず検出器を揃えなければならない。上の図の上半分のスコアは、著者らが DeepSORT の検出器を ByteTrack と同じ YOLOX-X に替えた後の結果だ。検出が揃えば、残りの差はすべてトラッカー自体から来る。
部品を一つずつ替える
より強い外観モデル(BoT)。 もとの単純な CNN を BoT に替える。BoT は re-ID の分野で多くの訓練の工夫をまとめた強力なベースラインで、バックボーンには ResNeSt50 を使い、先に DukeMTMC で事前学習する。
EMA による特徴の更新。 DeepSORT の特徴バンクは、たまに品質がひどく悪い検出の特徴まで溜め込んでしまう。著者らはこれを、指数移動平均(EMA)で各軌跡の外観の状態を保つ方式に変えた。
はこのフレームでマッチした検出の特徴で、 だ。古い外観の状態が九割を占め、新しいフレームは一割にすぎないので、単一フレームのノイズで外観が引きずられにくい。特徴バンクの 100 個の特徴と一つずつ距離を計算する必要もなくなり、速度も上がる。
カメラ運動補償(ECC)。 MOTChallenge、DanceTrack、KITTI には、どれもカメラが動く動画がある。著者らは拡張相関係数(ECC)による画像の位置合わせを流用して、隣り合う二フレーム間の全体的な回転と平行移動を推定し、軌跡の予測位置を先にカメラに合わせて動かしておく。これは Tracktor++ が使ったのと同じ方法だ。
NSA カルマンフィルタ。 通常のカルマンフィルタは、どの検出ボックスの観測ノイズも同じとして扱う。NSA(Noise Scale Adaptive)カルマンフィルタは GIAOTracker から借りたもので、観測ノイズを検出スコアに応じて調整する。
は検出スコアだ。スコア 0.9 のボックスでは観測ノイズがもとの一割しか残らず、フィルタはそのボックスをより信用する。スコア 0.6 のボックスではノイズがまだ四割残り、フィルタは自分の予測のほうに頼る。
運動コスト。 DeepSORT は実験でコストを外観距離だけにし、運動はゲートとしてしか使わなかった。StrongSORT は両者を重み付けしてコストにする。
この重みは FairMOT などの手法の設定を引き継いでいる。
通常のマッチング。 最後にマッチングカスケードを取り除き、単一の大域的な線形割り当てに戻す。理由は後でアブレーションを見るときに話そう。
二つのプラグイン:AFLink と GSI
これらの部品を組み込んだトラッカーが StrongSORT だ。著者らはさらに、軽量でモデルに依存せず、外観特徴も使わない後処理のアルゴリズムを二つ提案し、それを加えたものを StrongSORT++ と呼ぶ。二つのアルゴリズムはどちらも動画全体の軌跡を見る必要があるので、StrongSORT++ はオフラインの手法だ。
AFLink(Appearance-Free Link):途切れた軌跡をつなぐ。
AFLink は二つの短い軌跡の時空間情報だけを見て、それらが同じ物体かどうかを判定する。各短い軌跡からは直近 30 フレームを取り、各フレームはフレーム番号 、位置 、 の三つの数で表す。30 フレームに満たない場合はゼロで埋める。だから短い軌跡一本は の小さな行列になる。
二つの短い軌跡はそれぞれ別のブランチに入り、二つのブランチの重みは共有しない。
- 時間モジュール: Conv-BN-ReLU が四層で、カーネルは 。時間方向にだけ畳み込み、チャネル数は順に 32、64、128、256。
- 融合モジュール: の畳み込みが一層で、フレーム番号、、 の三つの次元の情報を融合する。
二つのブランチの出力はプーリングと平坦化の後に連結され、二層の全結合の分類器に送られて、この二つの軌跡が同じ物体に属する確率を出力する。
訓練データは正解の軌跡から直接切り出す。アノテーションの軌跡を短い軌跡に切り分け、ランダムな時空間ノイズを加え、正例と負例の比率を 1:3 にして、二値交差エントロピーで 20 epoch 訓練する。訓練全体でも十数秒しかかからない。
推論時は、まず時間の間隔が 30 フレームを超えるか、空間的な距離が 75 ピクセルを超える軌跡の組を除き、それから AFLink のスコアを類似度として線形割り当てを一回行う。スコアが 0.95 より高くなければつながない。
GSI(Gaussian-Smoothed Interpolation):穴を埋め、ついでに揺れもならす。
線形補間は欠損の両端の間に直線を引くだけで、物体が実際にどう動いたかは気にしない。GSI は各軌跡のボックスの位置を時間の関数と見なし、ガウス過程回帰で当てはめる。
は第 フレームのボックスの で、 はガウスノイズだ。予測したいフレームが与えられると、平滑化された位置はガウス過程の事後平均で計算される。
カーネル関数の幅 が軌跡の滑らかさを決める。著者らはこれを軌跡の長さ に応じて調整し、、 とした。補間する欠損の最大長は 20 フレームだ。
GSI がするのは穴埋めだけではない。軌跡全体を当てはめ直すので、もとの検出ボックスのフレームごとの細かな揺れもならされる。著者らはこれを、検出ノイズのフィルタの一種と捉えている。線形補間した軌跡は速度の曲線が激しく揺れるが、GSI を使うとずっと安定し、後で速度を推定するような応用に役立つ。
議論
検出器は YOLOX-X で、訓練方法は ByteTrack を引き継いでいる。推論時の NMS のしきい値は 0.8、検出スコアのしきい値は 0.6、マッチング距離のしきい値は 0.45。アブレーション実験では MOT17 訓練セットの各動画を前半と後半に分け、すべての実験を V100 一枚で走らせた。
各部品はどれだけ効くか
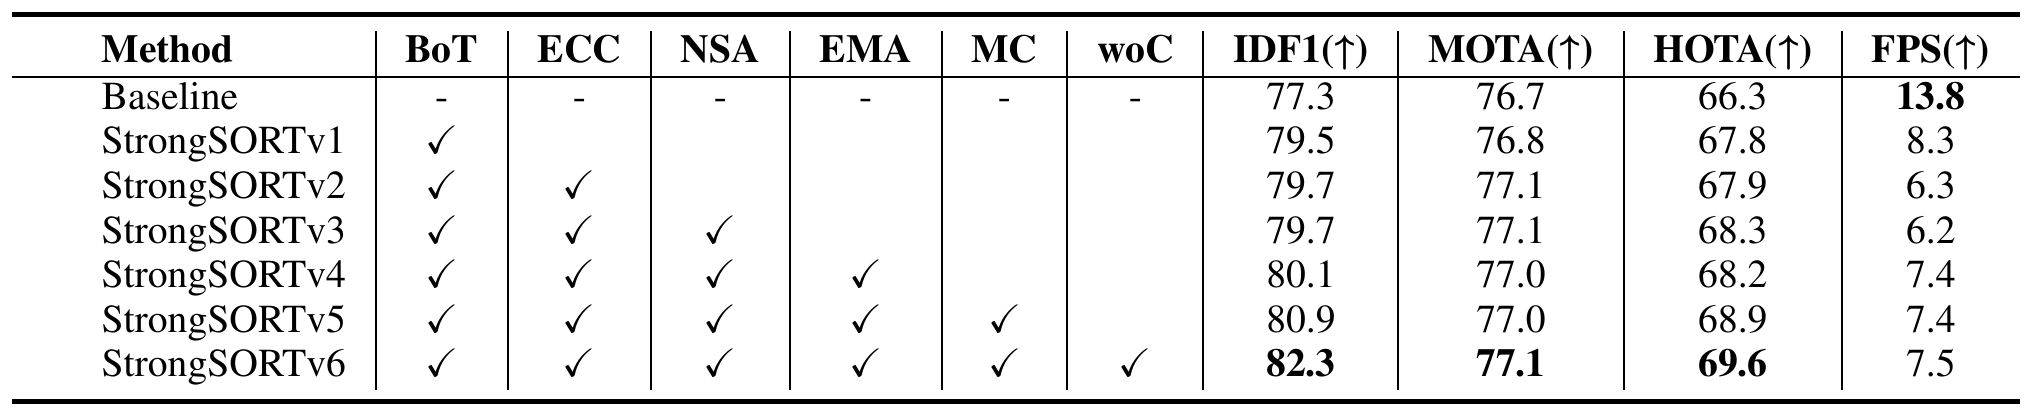
上から下へ読むと、行ごとに部品が一つずつ加わる。
- BoT: IDF1 +2.2、HOTA +1.5。より良い外観特徴は、すべての変更の中で最も効いた項目だが、FPS は 13.8 から 8.3 に落ちる。
- ECC: IDF1 +0.2、MOTA +0.3 で、FPS はさらに 6.3 に落ちる。
- NSA: HOTA +0.4 で、MOTA と IDF1 は変わらない。改善したのは位置の正確さで、これはちょうど HOTA が評価し、MOTA と IDF1 はあまり評価しない部分だ。
- EMA: IDF1 +0.4 で、FPS は 7.4 に持ち直す。
- 運動コスト: IDF1 +0.8。
- マッチングカスケードを除く: IDF1 +1.4、HOTA +0.7。
六段階を終えると、IDF1 は 77.3 から 82.3 に、HOTA は 66.3 から 69.6 に上がったが、MOTA は 0.4 しか増えていない。これらの部品がおもに改善したのは関連付けで、検出は変わっていない。
速度のほうは、ほぼ半分に落ちた。
なぜマッチングカスケードを除くのか
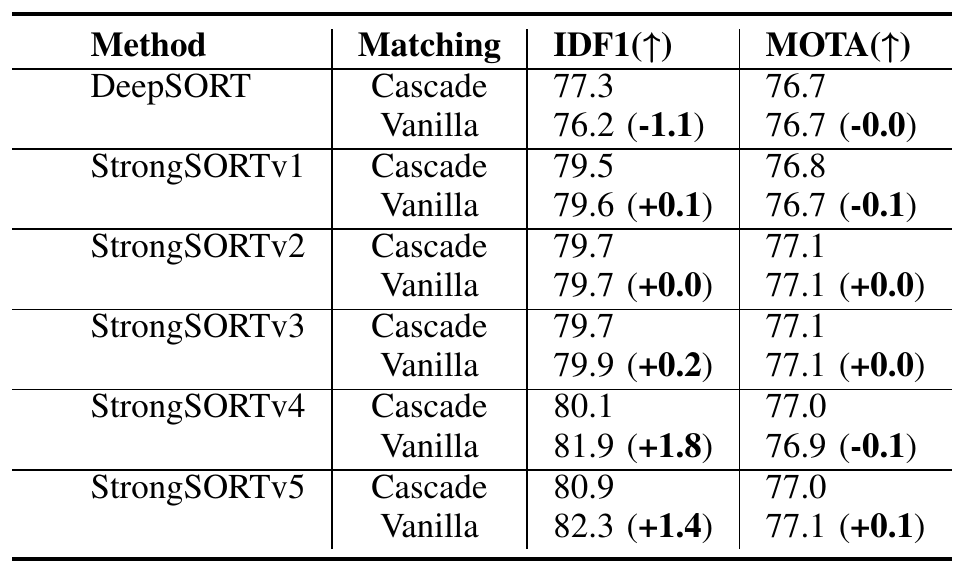
この表は、どの版でもカスケードと通常のマッチングを比べている。
もとの DeepSORT ではカスケードは役に立っていて、除くと IDF1 が 1.1 下がる。ところがトラッカーが強くなるほど、カスケードの恩恵は小さくなる。v4、v5 になると、カスケードを除くとかえって IDF1 が 1.8 と 1.4 上がる。
カスケードの動機は DeepSORT のノートで見た。マハラノビス距離は不確かな軌跡をひいきするので、最近見かけた軌跡から先に選ばせる。著者らの結論では、この事前知識は弱いトラッカーでは紛らわしいマッチングを減らせるが、外観特徴が十分に強く、コストにも運動の情報が加わると、トラッカーはもともと取り違えにくくなっていて、この余分な制約がかえって足かせになる。
AFLink と GSI は何につなげられるか
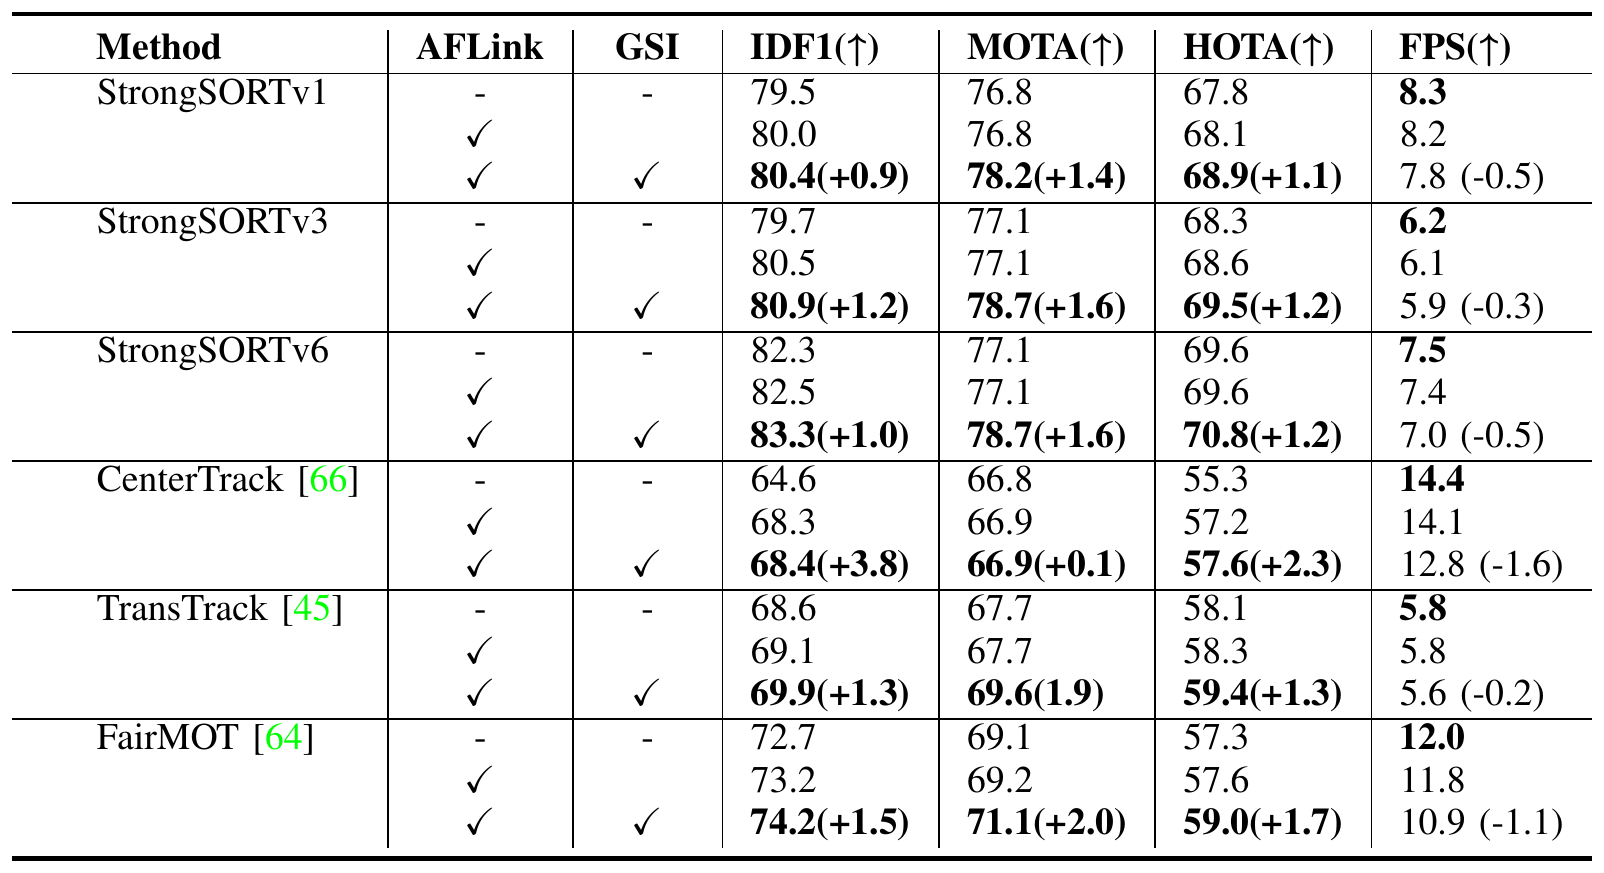
各トラッカーには三行ある。元のもの、AFLink を加えたもの、さらに GSI を加えたものだ。
AFLink は弱いトラッカーほどよく効く。CenterTrack は隣り合うフレームの局所的なマッチングしかしないので、隠れた人の軌跡は途切れるとすぐ新しい軌跡になる。AFLink を加えると IDF1 が 3.7 上がる。StrongSORTv6 はもともと途切れることが少なく、0.2 しか上がらない。
著者らによれば、GSI は逆で、強いトラッカーほど役に立つ。MOTA と HOTA を同時に改善し、補ったボックスは検出漏れを減らし、平滑化したボックスは本当の位置により近づく。ただし軌跡そのものに誤った関連付けが多ければ、GSI は間違った軌跡まできれいに平滑化してしまう。
二つの処理にかかる時間は、MOT17 で画像一枚あたりそれぞれ 1.7 ミリ秒と 7.1 ミリ秒だ。
リーダーボード
MOT17 テストセットで、StrongSORT は HOTA 63.5、IDF1 78.5、MOTA 78.3、ID スイッチ 1446 だった。著者らが YOLOX で再現した DeepSORT は 61.2、74.5、78.0、再現した ByteTrack(線形補間なし)は 62.8、77.2、78.9 だ。同じ検出器のもとで、StrongSORT の関連付けはどちらよりも良く、MOTA は ByteTrack とほぼ同じだった。
AFLink と GSI を加えた StrongSORT++ は 64.4、79.5、79.6 で、HOTA、IDF1、AssA、DetA はどれも当時一位だった。IDF1 と AssA はどちらも二位より 2.1 高い。
MOT20 では、StrongSORT++ の HOTA は 62.6、IDF1 は 77.0、ID スイッチはわずか 770 回だ。ただし MOTA の 73.8 は、ByteTrack の論文が報告した 77.8 より低い。著者らの説明では、MOT17 の検出スコアのしきい値をそのまま使ったので、混雑した MOT20 で多くの人を見逃した。StrongSORT++ の FN は 117,920 で、ByteTrack はわずか 87,594 だ。これはまさに ByteTrack の論文が解決しようとした問題だ。
DanceTrack では、StrongSORT++ の HOTA は 55.6 で、OC-SORT の 55.1 をわずかに上回った。面白いことに、著者らは DanceTrack では BoT と EMA という外観に関わる二つの改良を外している。ダンサーはみな似た服装なので、外観特徴は役に立たない。
著者らが認める限界
一つ目は、速度が遅いこと。DeepSORT 型の枠組みは別に re-ID モデルを必要とし、StrongSORT は MOT17 で 7.5 FPS、MOT20 で 1.5 FPS しか出ない。二つ目は、検出のしきい値が高すぎて、MOT17 と MOT20 での MOTA が低めになること。三つ目は、AFLink は途切れた軌跡をつなぐことしかできず、混ざり合った軌跡を切り分けることはできないこと。
その後
StrongSORT は実際によく使われる比較用のベースラインになり、Deep OC-SORT などの後続手法はどれも比較表に入れている。同じ年の少し後に出た BoT-SORT も似た道をたどり、ByteTrack にカメラ運動補償と re-ID の融合を加えた。BoxMOT のようなオープンソースの追跡パッケージも、StrongSORT を差し替え可能なトラッカーの一つとして収録している。
結論
新しい追跡の枠組みはなく、あるのは一つずつ新しくした部品だけだ。StrongSORT は DeepSORT の検出器、外観モデル、特徴の更新、カルマンフィルタ、コスト、マッチングをひととおり替え、2017 年の枠組みが 2022 年でも上位に入れることを示した。本当に新しいのは AFLink と GSI で、どちらも外観を使わず、数ミリ秒で走り終わり、どんなトラッカーの後ろにもつなげられる後処理だ。
この論文は「強いトラッカー」を、一歩ずつの増分に分解してみせた。re-ID モデルの交換は IDF1 で 2.2 ポイント、マッチングカスケードの除去は 1.4 ポイントの価値があり、全部替え終えると速度は 13.8 FPS から 7.5 FPS に落ちる。工夫を選ぶとき、この価格表はとても役に立つ。
四か月後、BoT-SORT は似たようなカメラ補償と re-ID を ByteTrack に取りつけ、MOT17 でもう少し先へ進んだ。