原論文
HOTA: A Higher Order Metric for Evaluating Multi-Object Tracking
- arXiv への初回投稿
- arXiv:2009.07736
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackinghota2020,
  title = {{HOTA: A Higher Order Metric for Evaluating Multi-Object Tracking}},
  author = {Jonathon Luiten and Aljosa Osep and Patrick Dendorfer and Philip Torr and Andreas Geiger and Laura Leal-Taixe and Bastian Leibe},
  year = {2020},
  eprint = {2009.07736},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2009.07736}
}
追跡の論文を何本か読んでいれば、MOTA という数字にはもうすっかりなじんでいるだろう。SORT も使い、DeepSORT も使い、Tracktor と FairMOT のメインの表でも最初の列はこれだ。
ところが DeepSORT のノートで見たとおり、ID スイッチが 45% 減っても、MOTA は 1.6 ポイントしか上がらなかった。FairMOT にもこんな実験がある。検出だけを訓練し、re-ID 特徴がほぼランダムなモデルのほうが、二つのタスクを一緒に訓練したモデルより MOTA が高かったのだ。
「追跡」を測るとうたう指標なのに、「正しい人を追えているか」にはあまり敏感でないらしい。
この論文は RWTH Aachen、ミュンヘン工科大学、オックスフォード、テュービンゲンによるもので、著者には MOTChallenge のメンテナもいれば、KITTI を作った Andreas Geiger もいる。彼らは MOTA、IDF1、Track-mAP を一つずつ分解して検証し、新しい指標 HOTA(Higher Order Tracking Accuracy)を提案した。この論文の影響の大きさは、この後のいくつかのノートのメインの表を見ればわかる。HOTA は ByteTrack や OC-SORT の世代の論文で主要な指標になった。
問題の定義
複数物体追跡では、三つのことを正しくこなす必要がある。
- 検出:各フレームで見つけるべき物体を、多すぎず少なすぎず見つける。
- 位置特定:ボックスが正確であること。
- 関連付け:同じ物体は異なる時刻でも同じ ID を受け取り、異なる物体が ID を共有してはならない。
よい指標はこの三つを同時に反映し、しかもそれぞれの重みが妥当であるべきだ。著者らはまず、当時最もよく使われていた二つの指標を調べた。
MOTA
MOTA は各フレームで予測ボックスと正解ボックスを一対一でマッチングする(IoU は 0.5 以上)。マッチしたものが真陽性(TP)、余った予測が誤検出(FP)、マッチしなかった正解ボックスが検出漏れ(FN)だ。関連付けの誤りは ID スイッチ(IDSW)で数える。ある正解物体が今回マッチした予測 ID が、前回マッチした予測 ID と違えば、一回と数える。
分母はすべての正解ボックスの数だ。
IDF1
IDF1 はフレームごとにはマッチングしない。予測軌跡全体と正解軌跡全体を一対一でマッチングし、重なりが最大になる組み合わせを選ぶ。マッチした軌跡の重なった部分が IDTP、それ以外のすべての正解ボックスが IDFN、それ以外のすべての予測ボックスが IDFP になる。
同じ一人を、二通りに追う
原論文の最初の図の例で、実際に計算してみよう。
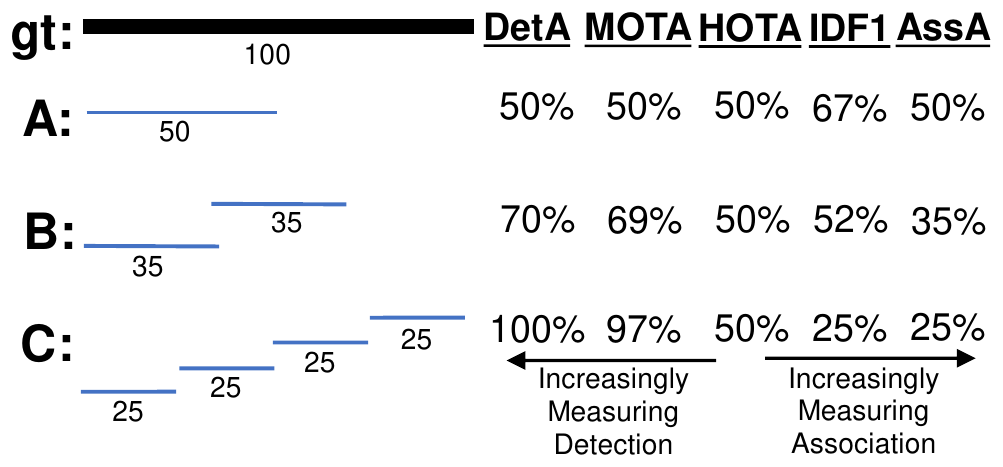
画面にいるのは一人だけで、100 フレームにわたって映っている。A と C の二つのトラッカーを見てみよう。
- A は最初の 50 フレームを追い、最初から最後まで同じ ID だが、後半の 50 フレームはまったく追えていない。
- C は全フレームで追えているが、25 フレームごとに ID が変わり、ID は全部で四つになる。
どちらが良いだろうか?
まず MOTA を計算する。A は検出漏れが 50 個、誤検出なし、ID スイッチなしで、。C は検出漏れも誤検出もなく、ID スイッチが 3 回で、。
MOTA によれば C のほうがずっと良い。ID を三回変えても、引かれるのは 3 ポイントだけだ。
次に IDF1。A の唯一の軌跡が正解軌跡とマッチし、IDTP = 50、IDFN = 50、IDFP = 0 で、IDF1 = 。C は 25 フレームの軌跡を一本しかマッチングに選べないので、IDTP = 25、残り 75 個の正解ボックスはすべて IDFN、ほかの三本の軌跡の予測ボックス 75 個はすべて IDFP となり、IDF1 = 。
IDF1 によれば A のほうがずっと良い。C が全フレームで追えていたことは、ほとんど反映されていない。
二つの指標はそれぞれ片方の側に立ち、しかもどちらも極端だ。
問題を解く
HOTA の狙いは、一つのスコアで検出、関連付け、位置特定を公平に測り、同時にそれを分解して、誤りがどこから来たのかを見られるようにすることだ。
まず MOTA と同じく、フレームごとにマッチングする
HOTA のマッチングは MOTA と同じで、各フレームで予測ボックスと正解ボックスを一対一でマッチングする。位置の類似度 (たとえば IoU)はしきい値 以上でなければならない。マッチしたものが TP、残りが FP と FN だ。
検出のスコアは標準的な Jaccard 指数だ。
次に、各 TP について軌跡がどれだけ正しいかを問う
関連付けの部分が、この論文の新しいところだ。マッチした各 TP を とし、著者らは三つの集合を定義した。
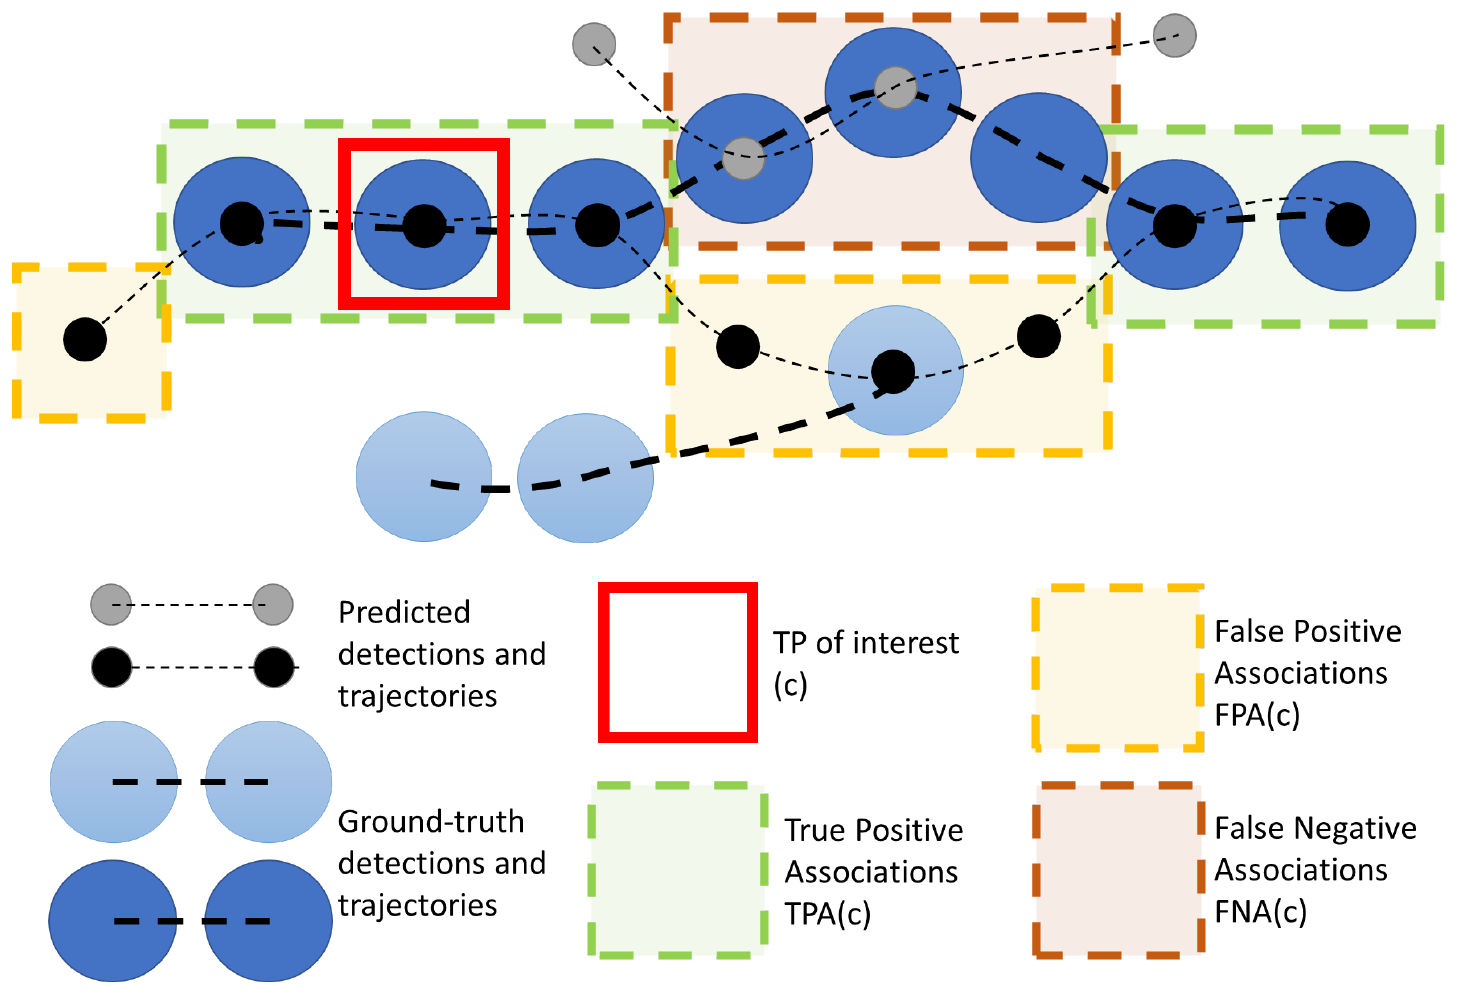
- TPA(True Positive Associations): と同じ正解 ID を持ち、同じ予測 ID も持つ TP。つまり「同じ人で、トラッカーも同じ人として扱っている」瞬間だ。
- FNA(False Negative Associations): と同じ正解 ID を持つが、別の予測 ID を与えられたか、そもそも検出されなかった正解ボックス。同じ人なのに、トラッカーが見分けられていない。
- FPA(False Positive Associations): と同じ予測 ID を持つが、実は別の人のものか、どの物体にも対応しない予測ボックス。トラッカーは同じ人だと思っているが、実は違う。
図の には TPA が五つ、FPA が四つ、FNA が三つある。その関連付けスコアも、また Jaccard 指数だ。
図の数字を代入すると次のようになる。
すべての TP の関連付けスコアを平均したものが、関連付けの精度だ。
二つのスコアの幾何平均を取る
著者らはこれを「二重の Jaccard」と呼ぶ。外側は検出の Jaccard だが、分子の各 TP は 1 と数えるのではなく、それぞれの関連付けスコアを掛けて数える。
さっきの例に戻ろう。
A の DetA は 。どの TP も TPA は 50、FNA は後半の追えなかった 50 個の正解ボックス、FPA は 0 で、関連付けスコアはどれも 、AssA も 50% になる。HOTA 。
C の DetA は 100%。どの TP も、属している軌跡は 25 フレームしかないので TPA は 25。同じ人の残り 75 フレームには別の ID が与えられていて、すべて FNA になる。関連付けスコアはどれも 25%、AssA も 25% だ。HOTA 。
二つのトラッカーは引き分けだ。A は半分しか追えていないが見分けは正確で、C は全部追えたが ID が変わり続ける。HOTA はどちらの肩も持たず、喧嘩両成敗にする。
最後に、位置精度も取り込む
ここまでの計算はすべて、位置のしきい値 を固定して行った。ボックスの正確さも取り込むため、HOTA は の 19 個のしきい値でそれぞれ計算し、平均を取る。
しきい値ごとにマッチングをやり直す。ボックスが正確なほど、高いしきい値でもマッチできる TP が多くなり、最終的なスコアも高くなる。
著者らがとくに注意を促しているのは順序だ。DetA と AssA を各 でまず にまとめ、それから について平均する。この順序を逆にしてはいけない。だから論文の表にある HOTA は、ふつう表にある DetA と AssA の幾何平均とぴったりは一致しない。
分解して見る
HOTA は五つのサブ指標にまで分解でき、それぞれが一種類の誤りに対応する。
- DetRe :検出漏れ。
- DetPr :誤検出。
- AssRe: から FPA を除いたものの平均。一人が何本もの軌跡に分断されると、AssRe が低くなる。
- AssPr: から FNA を除いたものの平均。一本の軌跡が何人にもまたがると、AssPr が低くなる。
- LocA:すべての TP の位置の類似度の平均で、これも各 について平均する。
この分解のおかげで、使う側は用途に応じて重視する点を選べる。著者らの例では、人の動作解析、群衆解析、スポーツの試合解析は身元を最後まで正しく追えているかが大事なので、AssRe と AssPr が重要になる。運転支援システムは歩行者を一人残らず見つけなければならず、存在しない人のために急に回避してもいけないので、DetRe と DetPr が重要になる。監視の場面では、たいてい見逃すくらいなら多めに報告するほうがよい。
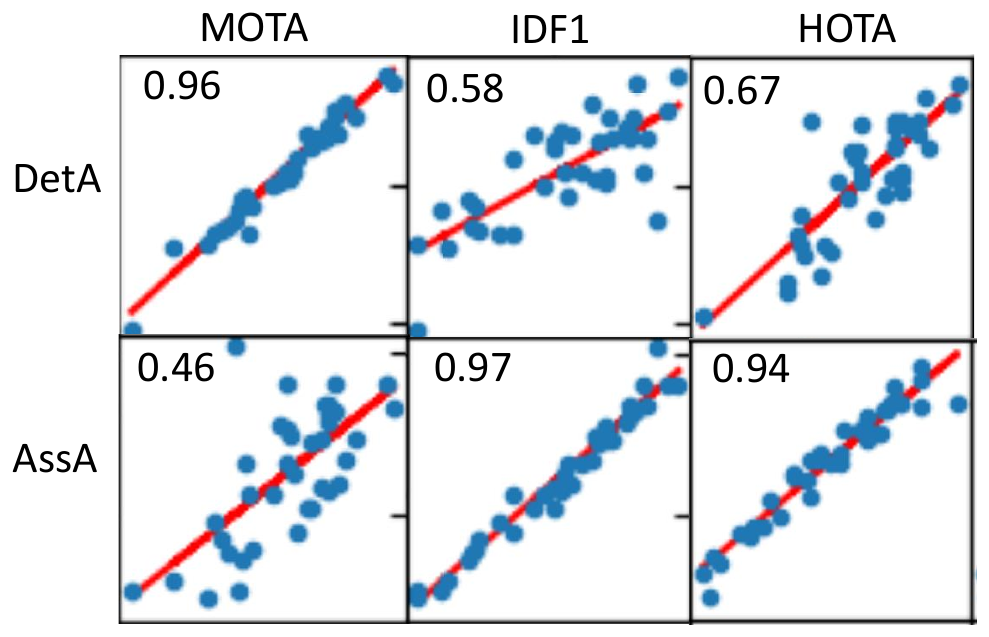
この図は三つの指標を MOT17 で DetA、AssA と突き合わせたものだ。MOTA はほぼ検出だけに連動し()、関連付けとの関係は弱い(0.46)。IDF1 はちょうどその逆だ(0.58 と 0.97)。HOTA はどちらともはっきりした関係がある(0.67 と 0.94)。
HOTA と AssA の関係のほうが強いのは、関連付けの重みが大きいからではない。両者の重みは等しい。原因は、これらのトラッカーがみな同じ公開検出を使っていて検出スコアが似通っており、互いの差がおもに関連付けから生じていることにある。
議論
MOTA の九つの問題
著者らは MOTA の問題を九つ挙げている。とくに説得力のあるものをいくつか見ていこう。
- 検出の影響が関連付けよりはるかに大きい。 2020 年 4 月 1 日時点の MOT17 リーダーボード上位 10 位では、FN + FP と IDSW の数の比は 42.3 から 186.4 の間で、平均は 98.6 だった。著者らはさらに 175 個のトラッカーで線形回帰を行った。検出だけを見る MODA(MOTA から IDSW の項を除いたもの)は MOTA のばらつきの 99.4% を説明できるが、IDSW では 23.7% しか説明できない。
- 適合率の影響が再現率よりはるかに大きい。 IDSW を除くと、MOTA は と書き直せる。再現率に対しては線形なのに、適合率に対しては双曲線だ。適合率が少し悪いと、再現率が同じだけ悪い場合よりずっと大きくスコアが下がる。これはみんなに検出しきい値を上げさせ、誤検出を出すくらいなら見逃すほうを選ばせてしまう。
- IDSW は一つ前しか見ない。 ID スイッチは、今回の ID が前回と同じかどうかを調べるだけで、軌跡全体がどれだけ揃っているかは見えない。トラッカーが間違えた後に自分で元に戻すと、MOTA はその「元に戻した」ことも IDSW 一回と数えるので、二度罰することになる。
- ID の乗り移りを罰しない。 一本の予測軌跡が A から B に乗り移っても、A と B それぞれの ID が変わっていなければ IDSW にはならない。論文の例は二フレームしかない動画だ。一人が二本の軌跡に分断されると MOTA は 0.5、別々の二人が一本の軌跡にまとめられると MOTA は満点の 1.0 になる。
- フレームレートに左右される。 同じ 2.5 秒の軌跡で、途中で ID が一回変わるとする。40 FPS で評価すると分母のボックスは 100 個で、MOTA は 0.99。4 FPS で評価すると分母のボックスは 10 個しかなく、MOTA は 0.90 になる。HOTA はどちらも だ。
- 下限がない。 誤検出はいくらでも増やせるので、MOTA は負の無限大まで落ちうる。負の MOTA を見ても、それが何を表しているのかをはっきり言うのは難しい。
IDF1 の問題
IDF1 はもともとマルチカメラ追跡のために設計された。核心的な問題は、最適な軌跡マッチングを一組しか許さないことだ。選ばれなかった軌跡は、どれだけうまく追えていても、中の正しい検出がすべて IDFP と数えられ、かえってスコアを下げる。だから IDF1 は検出に対して単調ではない。検出が良くなると、スコアが悪くなることがある。
多くの新しいベンチマークがいまだに MOTA を選ぶ理由も、これで説明がつく。検出は追跡のとても重要な一部なのに、IDF1 はそれをうまく測れない。
なぜ Jaccard なのか、なぜ平方根を取るのか
論文の第 7 節では、いくつもの設計上の選択を検証している。
- F1 や MODA ではなく Jaccard。 著者らは例を使って、単調性を保証できるのは Jaccard の形だけだと示した。正しい検出が一つ増えればスコアは必ず上がり、予測と正解を入れ替えても結果は変わらない。F1 は長さの比によっては悪い結果を上位に並べてしまい、MODA は対称でない。
- 平方根の三つの役割。 一つ目は、HOTA の値の範囲を見慣れた MOTA や IDF1 に近づけること。二つ目は、HOTA を検出と関連付けの幾何平均にして、どちらか一方がゼロに近づけば総合スコアもゼロに近づくようにすること。三つ目は二重カウントを打ち消すこと。関連付けスコアにはマッチした軌跡の中の FN と FP がもともと含まれているので、平方根を取らなければ、これらの誤りが二度罰せられる。物体が一つだけの単一物体追跡では DetA と AssA が完全に一致し、平方根を取ると HOTA はちょうど一つの Jaccard 指数になる。
- DetA は省けない。 どの軌跡ともマッチしなかった FN と FP は AssA に現れないので、DetA で罰する必要がある。しかも AssA だけでは単調でない。関連付けのひどい TP を一つ加えると、平均値が下がってしまう。
人はどう見るか
最後に、著者らはユーザー調査を行った。MOT17 の七本のテスト動画を 6 秒ずつの 36 本のクリップに切り分け、二つの指標の判定が食い違うトラッカーの組を選び出して、被験者に二つの追跡結果を見せ、良いほうを選んでもらった。
参加者は 230 人で、うち 62 人が複数物体追跡の研究者、122 人がコンピュータビジョンの研究者だった。比較は合計 2075 組で、一組あたり平均 2 分 13 秒かかった。
引き分けの票を除くと、HOTA 対 MOTA では被験者の 61.6% が HOTA の側についた。HOTA 対 IDF1 ではこの割合が 72.0% で、MOTA 対 IDF1 はほぼ五分五分だった。複数物体追跡の研究者だけに絞ると、HOTA の勝率は MOTA に対して 79.3%、IDF1 に対して 85.9% に上がる。
その後
HOTA はすぐに採用された。KITTI の追跡リーダーボードは 2021 年 2 月から HOTA で順位をつけるようになり、評価プログラムは著者らが管理する TrackEval だ。DanceTrack などの新しいベンチマークも HOTA を主要な指標にしている。この後で読む ByteTrack、OC-SORT、StrongSORT、BoT-SORT は、どれもメインの表に HOTA、MOTA、IDF1 を並べている。
HOTA がまだ最終解ではないと考える人もいる。2021 年、Google Research の Jack Valmadre と Alex Bewley(そう、SORT の著者だ)らは、時間的に局所的な追跡指標 ALTA を提案した。彼らは、多くの応用ではある程度の関連付けの誤りは許容できるので、検出と関連付けの相対的な重要度は調整できるべきだと考え、時間窓の長さを調整のつまみにした。HOTA が両者を五分五分に固定したのは一つの選択であって、唯一の選択ではない。
結論
まずフレームごとにマッチングし、マッチした各ボックスについて軌跡全体で関連付けの正しさを測り、最後に検出と関連付けの幾何平均を取って、19 個の位置しきい値で平均する。これが HOTA だ。検出の再現率、検出の適合率、関連付けの再現率、関連付けの適合率、位置精度の五つのサブ指標に分解できる。
この先、追跡論文の表を読むときは、HOTA の列だけを見ずに、ついでに DetA と AssA も見てほしい。ある手法の HOTA が上がったのは、検出器が良いものに替わったからなのか、関連付けが本当に強くなったからなのか、この二列を見れば一目でわかる。
MOTA は、ID を三回変えても 3 ポイント引けば済むと言い、IDF1 は、最初から最後まで追えたことなど大したことではないと言う。
HOTA は言う。君たちはどちらも正しく、どちらも間違っている。