原論文
BoT-SORT: Robust Associations Multi-Pedestrian Tracking
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2206.14651
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingbotsort2022,
  title = {{BoT-SORT: Robust Associations Multi-Pedestrian Tracking}},
  author = {Nir Aharon and Roy Orfaig and Ben-Zion Bobrovsky},
  year = {2022},
  eprint = {2206.14651},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2206.14651}
}
ByteTrack は、検出器が十分に強ければ、カルマンフィルタと IoU で MOT17 の MOTA 80.3 を取れることを示した。
だが「IoU で足りる」には、前のフレームで予測したボックスが、このフレームの検出ボックスと重なっていることが前提になる。撮影者が体の向きを変えたり、車がカーブを曲がったりすれば、画面の中のものはすべて一斉に動き、カルマンフィルタが予測したボックスはことごとく間違った位置に落ちる。歩行者自身はまったく動いていないのに、トラッカーは一群の人をまとめて見失う。
イスラエルのテルアビブ大学の Nir Aharon、Roy Orfaig、Ben-Zion Bobrovsky は、SORT 系のトラッカーが抱える昔からの問題をいくつか洗い出し、それぞれに対応する改良を一つずつ ByteTrack に取りつけた。名前の BoT は bag of tricks、小技をひと袋分という意味だ。
問題の定義
著者らは SORT 系のトラッカーの限界を三つ指摘する。
カルマンフィルタの状態ベクトル。 SORT は 、つまり中心、面積、縦横比を使う。DeepSORT 以降の多くのトラッカーは、ByteTrack も含めて 、つまり中心、縦横比、高さに切り替えた。どちらの表現も縦横比を推定していて、幅は縦横比に面積か高さを組み合わせて逆算しなければならない。著者らは、こうして逆算した幅がしばしば不正確で、ボックスが人に合わないことに気づいた。
カメラの動き。 IoU マッチングは予測ボックスの位置に完全に頼っている。カメラが動くと、予測ボックスと検出ボックスの重なりが小さくなり、ID スイッチや検出漏れを引き起こす。固定カメラでも、風や振動で画面が揺れることがあり、混雑した場面ではやはり問題になる。
IoU と外観のトレードオフ。 IoU でマッチングすると、たいてい MOTA が良くなる。re-ID 特徴でマッチングすると、たいてい IDF1 が良くなる。二つの手がかりをどう組み合わせれば、一方を立てて他方を損なわずに済むのか?
問題を解く
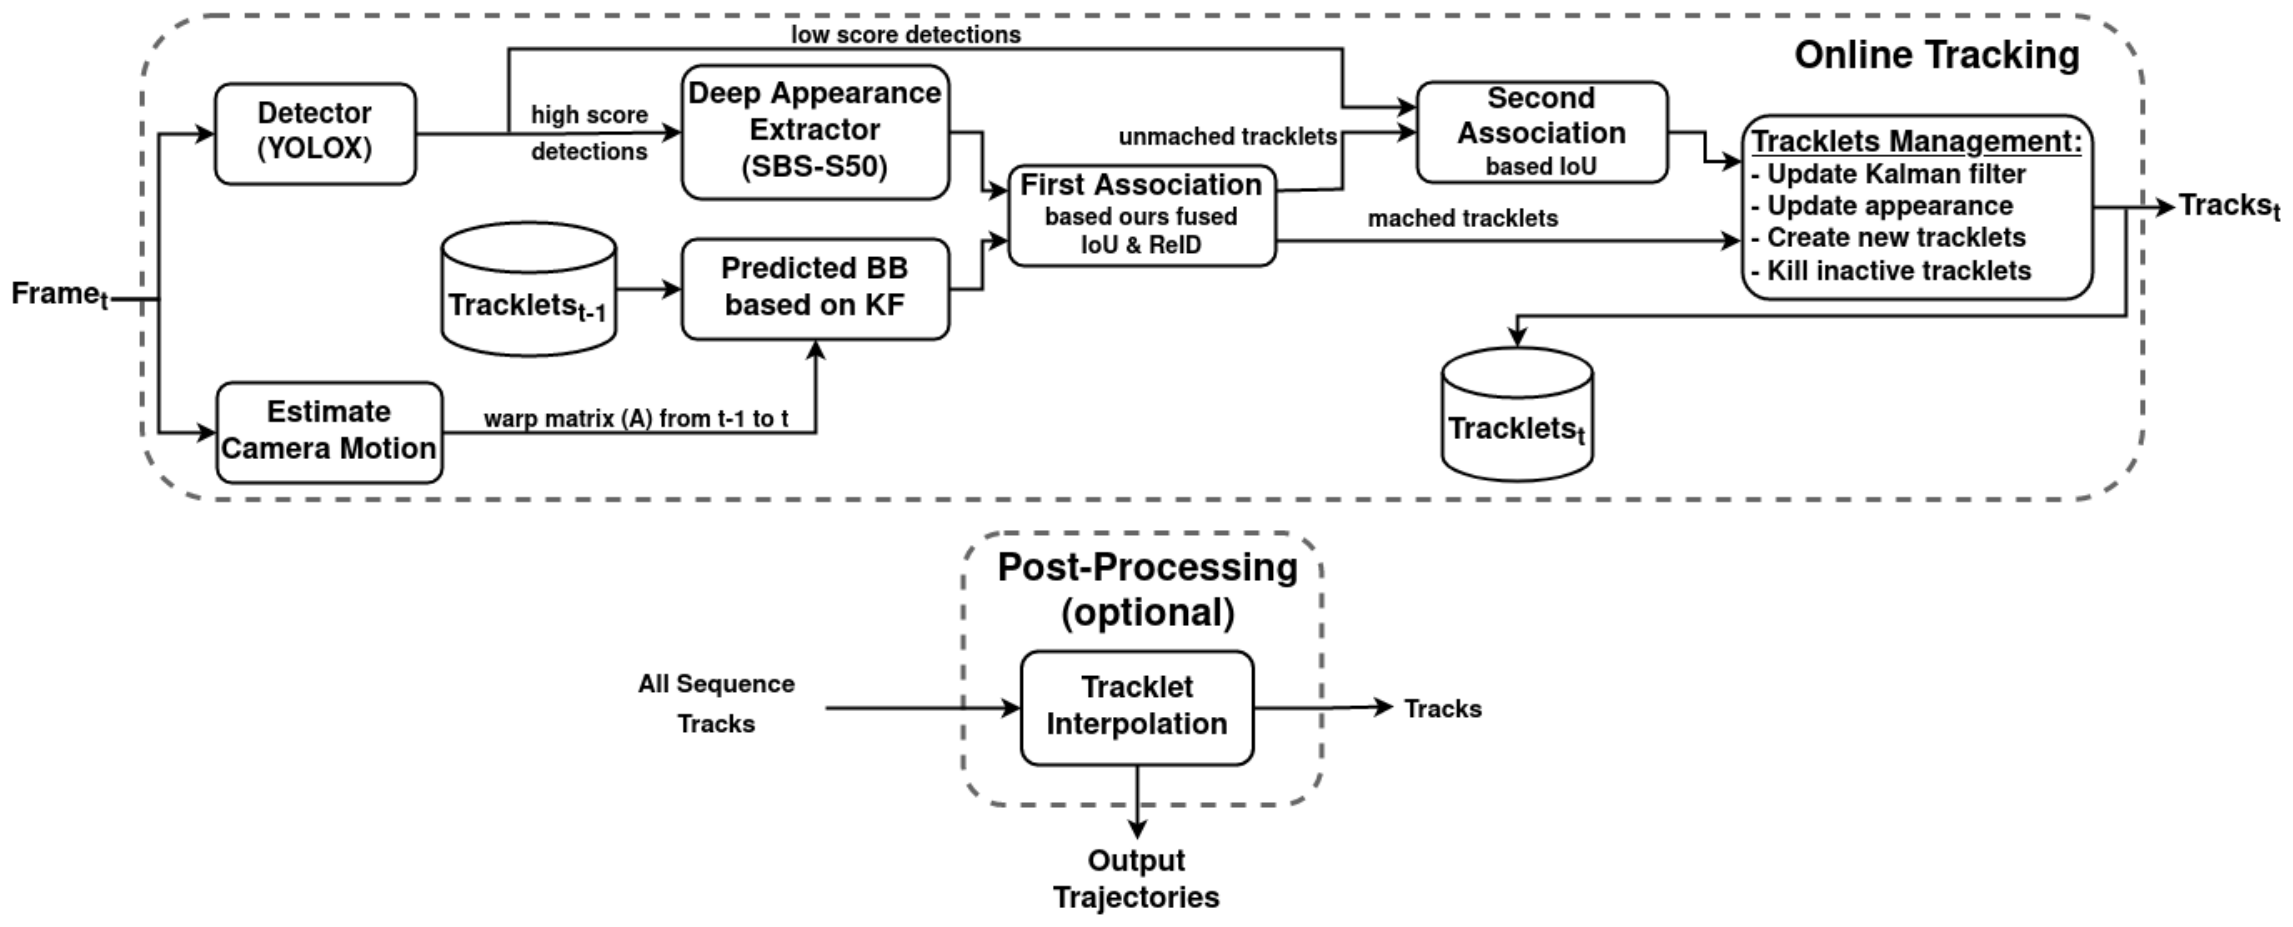
全体の骨格は ByteTrack そのもので、高スコアのボックスとすべての軌跡で一回目の関連付けを行い、低スコアのボックスと残りの軌跡で IoU による二回目の関連付けを行う。BoT-SORT はこの骨格の三か所を変えていて、re-ID を加えた版は BoT-SORT-ReID と呼ばれる。
一、幅と高さを直接推定する
著者らはカルマンフィルタの状態ベクトルを、幅と高さを直接含むものに変えた。
ノイズの行列は DeepSORT の考え方を引き継ぎ、ノイズをボックスの大きさに合わせてスケーリングするが、幅と高さにそれぞれ連動させる形に変えた。
、、 で、それぞれ DeepSORT のコードにある 1/20 と 1/160 そのものだ。
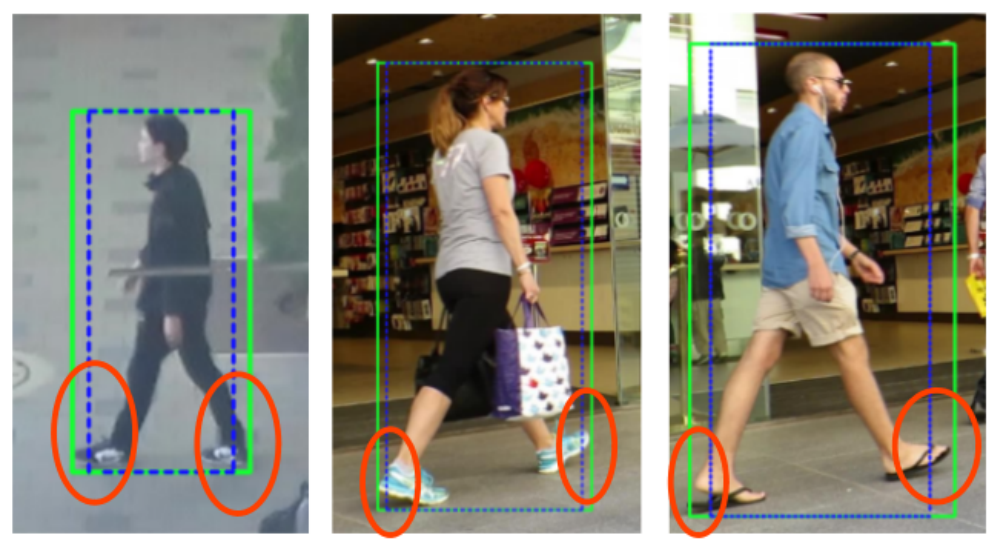
この図では、青い破線のボックスは歩行者の足を切り落としていて、緑のボックスは人全体を包んでいる。歩くときは足が開いたり閉じたりして幅が大きく変わるので、縦横比から逆算した幅はついていけない。
著者らは論文の中でとても率直だ。この変更で HOTA は確かに上がったが、厳密に言えば理由ははっきりわからず、ボックスの幅が物体によりよく合うようになったからだろうと推測するしかない、と書いている。
二、カメラ運動補償(CMC)
IMU やナビゲーションの情報がなく、カメラの内部パラメータもわからない状況では、隣り合う二フレーム間の画像の位置合わせが、カメラの剛体運動を画像平面に投影したものの良い近似になる。
著者らは OpenCV の動画安定化モジュールにある大域的な運動補償(Global Motion Compensation, GMC)を流用した。
- 前のフレームから画像のキーポイントを抽出する。
- 疎なオプティカルフローでこれらのキーポイントをこのフレームまで追跡し、局所的な外れ値を取り除く。
- RANSAC で のアフィン行列を推定する。
は拡大縮小と回転、 は平行移動だ。著者らはさらに、検出ボックスのある領域は動的な物体なので、推定の際に除外して、推定が背景の動きだけを反映するようにできるとも述べている。
が得られたら、カルマンフィルタの予測を新しい座標系へ移す。著者らは小さな工夫として、 を のブロック対角行列 に並べ、 をゼロで埋めて 8 次元の にする(値があるのは中心位置の二次元だけ)。
この式が状態ベクトルに何をしているのか、分解して見てみよう。八次元の状態は二つずつ組にできる。中心 、幅と高さ 、中心の速度 、幅と高さの速度 だ。 はどの組にも同じ を掛けるので、カメラが回転すれば、中心もボックスの大きさも速度の向きも一緒に回る。 は中心にだけ足される。カメラの平行移動は物体の位置を動かすだけで、大きさや速度は変えないからだ。共分散も一緒に変換し、フィルタの不確かさを新しい座標系に合わせる。
補償を終えた予測を、このフレームの検出と IoU でマッチングする。
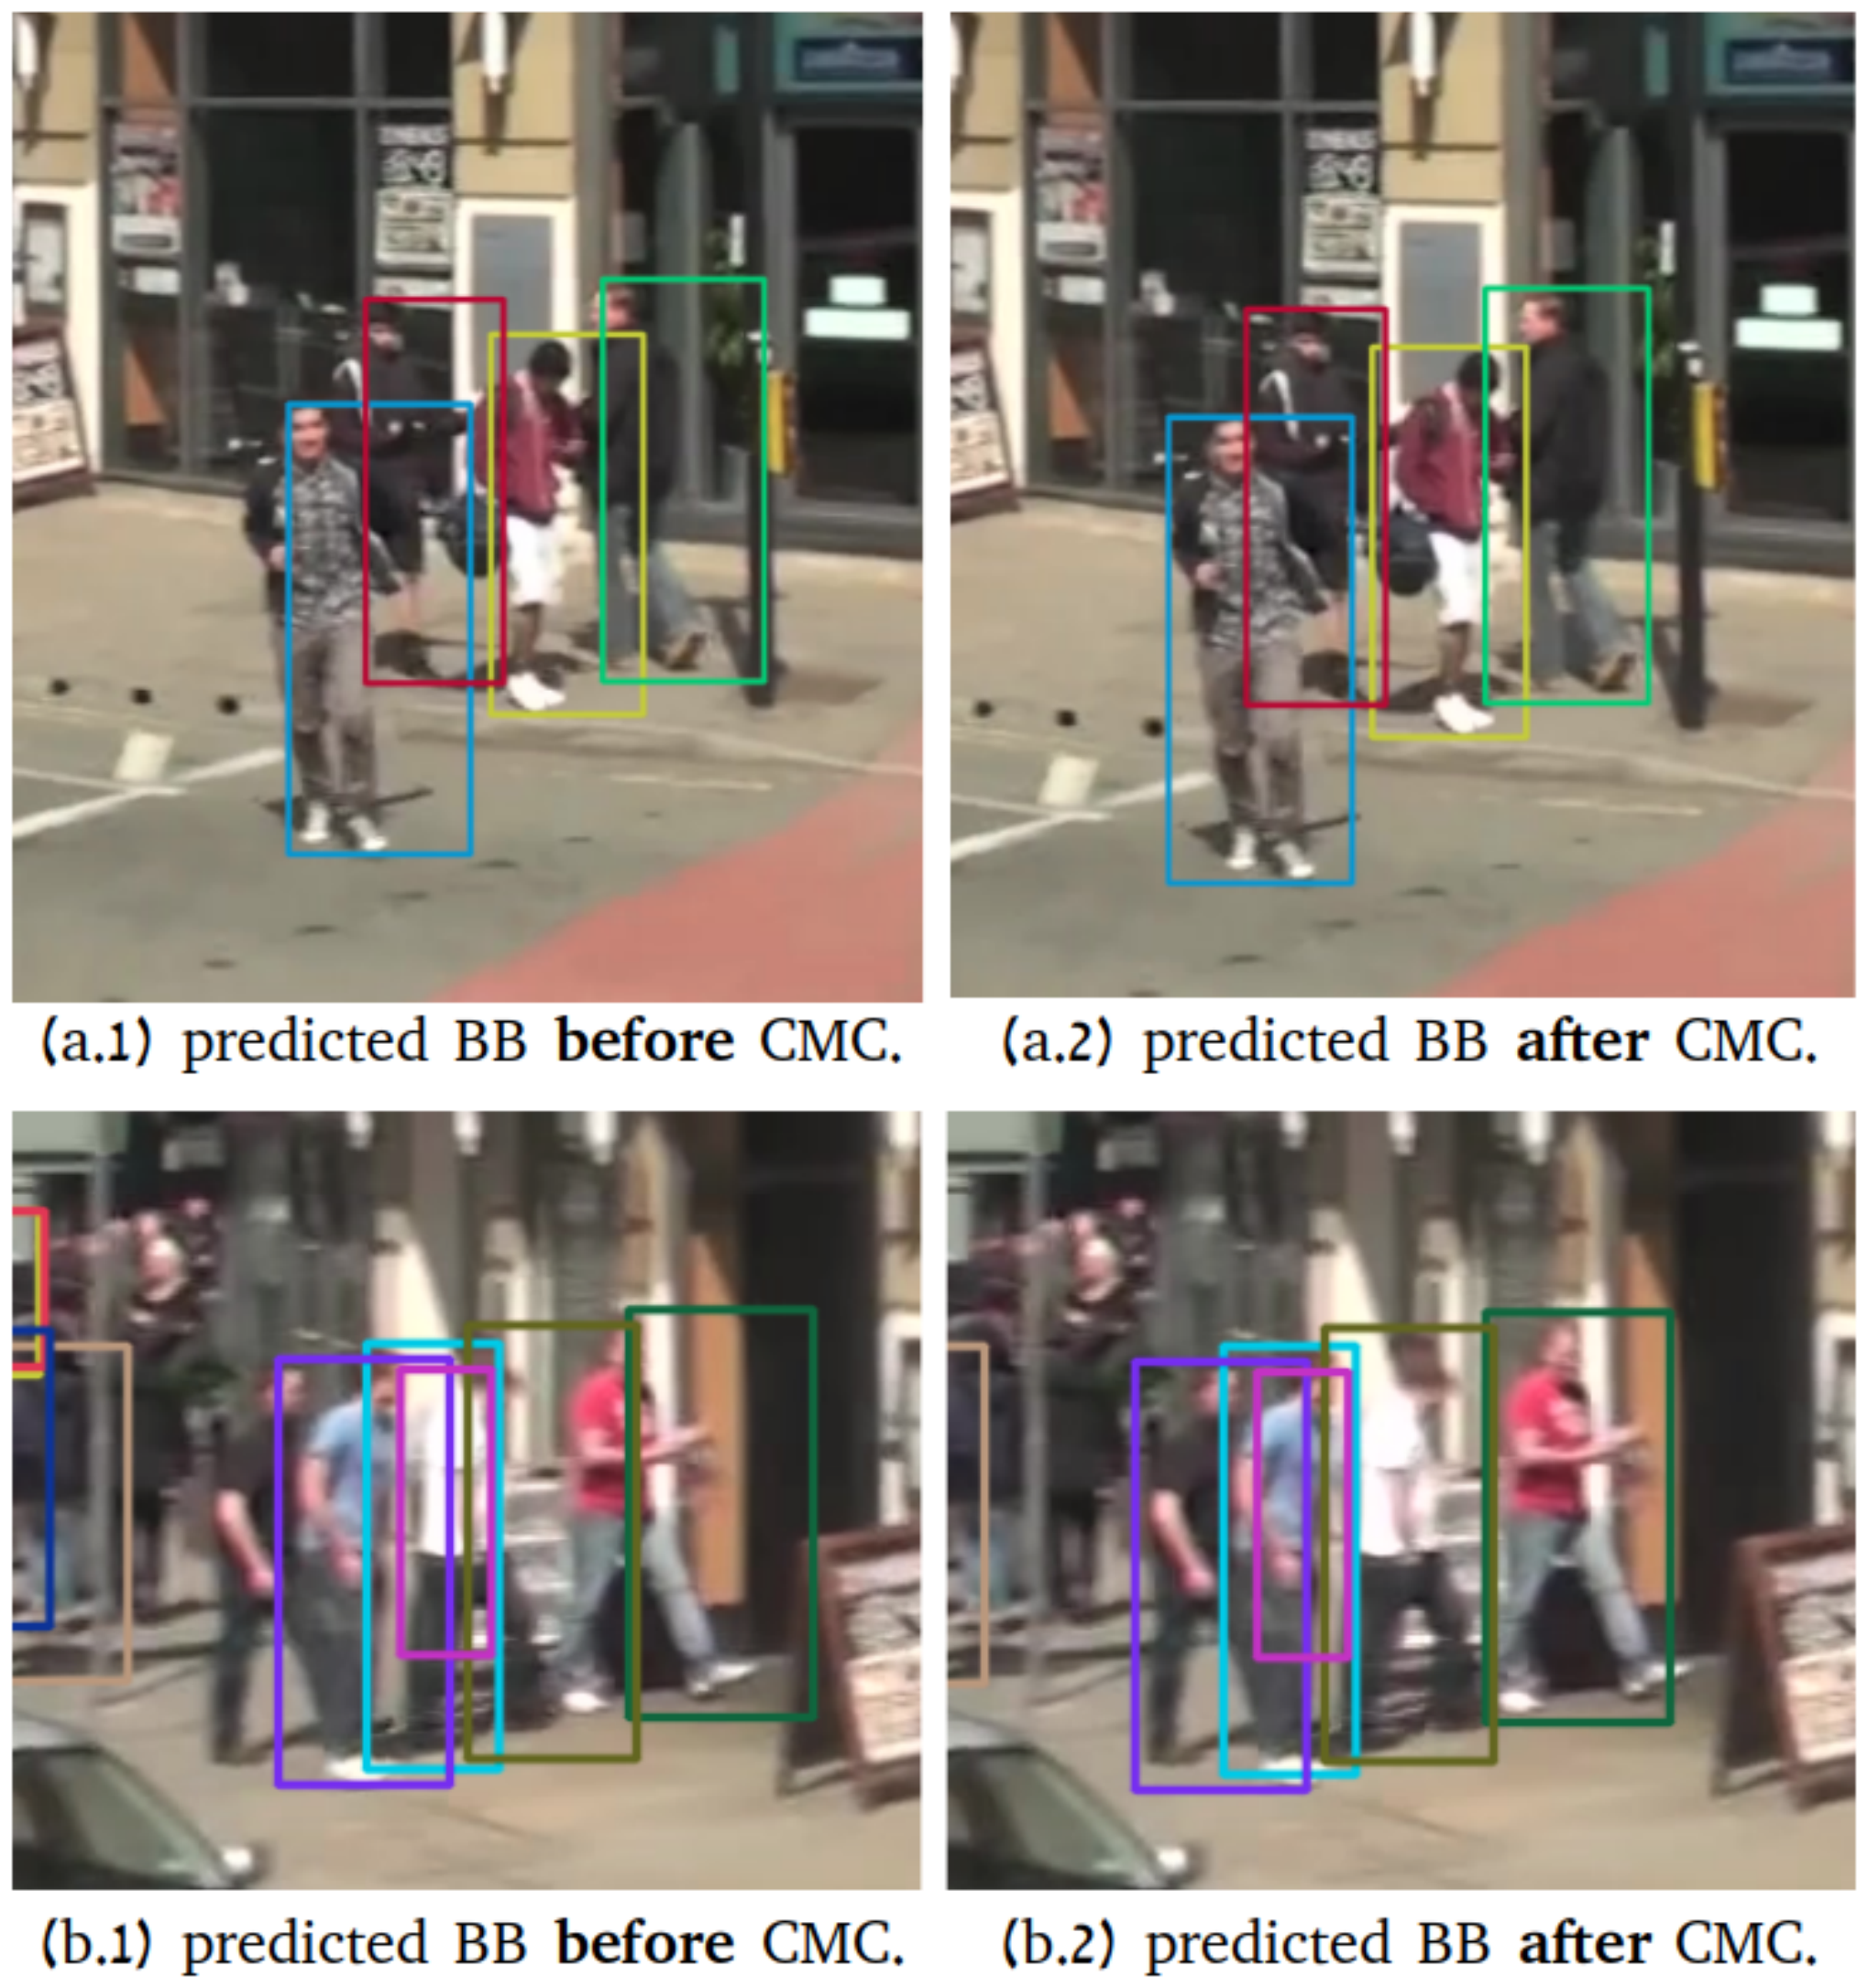
これは MOT17-13 の画面で、カメラは右に曲がっている最中の車に取りつけられている。補償前は、予測ボックスが列ごと歩行者の脇にずれていて、IoU マッチングは確実に失敗する。補償後は、ボックスが人の上に戻っている。
三、IoU と re-ID の融合
外観特徴には FastReID ライブラリの SBS(stronger baseline on top of BoT)を使い、バックボーンは ResNeSt50 だ。StrongSORT と同じく、各軌跡の外観は EMA で更新し、 とする。遮蔽されたりぼやけたりしたボックスで外観が汚れないよう、特徴を抽出するのは高スコアの検出だけだ。
よくあるやり方は、外観距離と運動距離を重み付けして足すもので、FairMOT も StrongSORT も を使っている。著者らは別の組み合わせ方を使う。先にふるいにかけ、それから最小値を取るのだ。
は IoU 距離(1 から IoU を引いたもの)、 は軌跡の外観と検出の特徴のコサイン距離だ。、。
この式は読むと少しややこしいので、軌跡と検出ボックスの組を三つ代入してみよう。
- 位置が近く、見た目も似ている。 IoU は 0.7 なので 、コサイン距離は 0.1。二つの条件がどちらも成り立ち、 で、コストは小さいほうの 0.05 を取る。外観と位置がどちらも賛成しているので、コストはぐっと低く抑えられ、この組はほぼ確実にマッチする。
- 位置は近いが、見た目は似ていない。 IoU は 0.8 で 、コサイン距離は 0.4 で 0.25 を超える。外観は考慮されず で、コストは 0.2 を取る。外観は減点はせず、助けないだけで、マッチングは完全に IoU で決まる。
- 見た目は似ているが、位置が遠い。 IoU は 0.3 で 、0.5 を超える。コサイン距離は 0.05。位置が遠すぎるので外観も考慮されず、コストは 0.7 を取る。
外観がコストを押し下げる助けになれるのは、「位置も筋が通っている」ときだけだ。見た目は似ていても遠く離れた人が、同じ服を着ているというだけでつながれることはない。
というしきい値は、著者らが MOT17 検証セットで同一人物と別人物の外観距離の分布を描いたうえで選んだものだ。同一人物の距離はごく狭い範囲に集まり、別人物の距離はたいていもっと遠いところにある。
おまけのデバッグツール:cMOTA
著者らはさらに、current-MOTA という分析ツールも提案している。 は、最初のフレームから第 フレームまでで計算した MOTA だ。最後のフレームまで計算すれば、通常の MOTA になる。
これを時間に沿った曲線として描けば、トラッカーがどの区間で間違え始めたのかが一目でわかる。
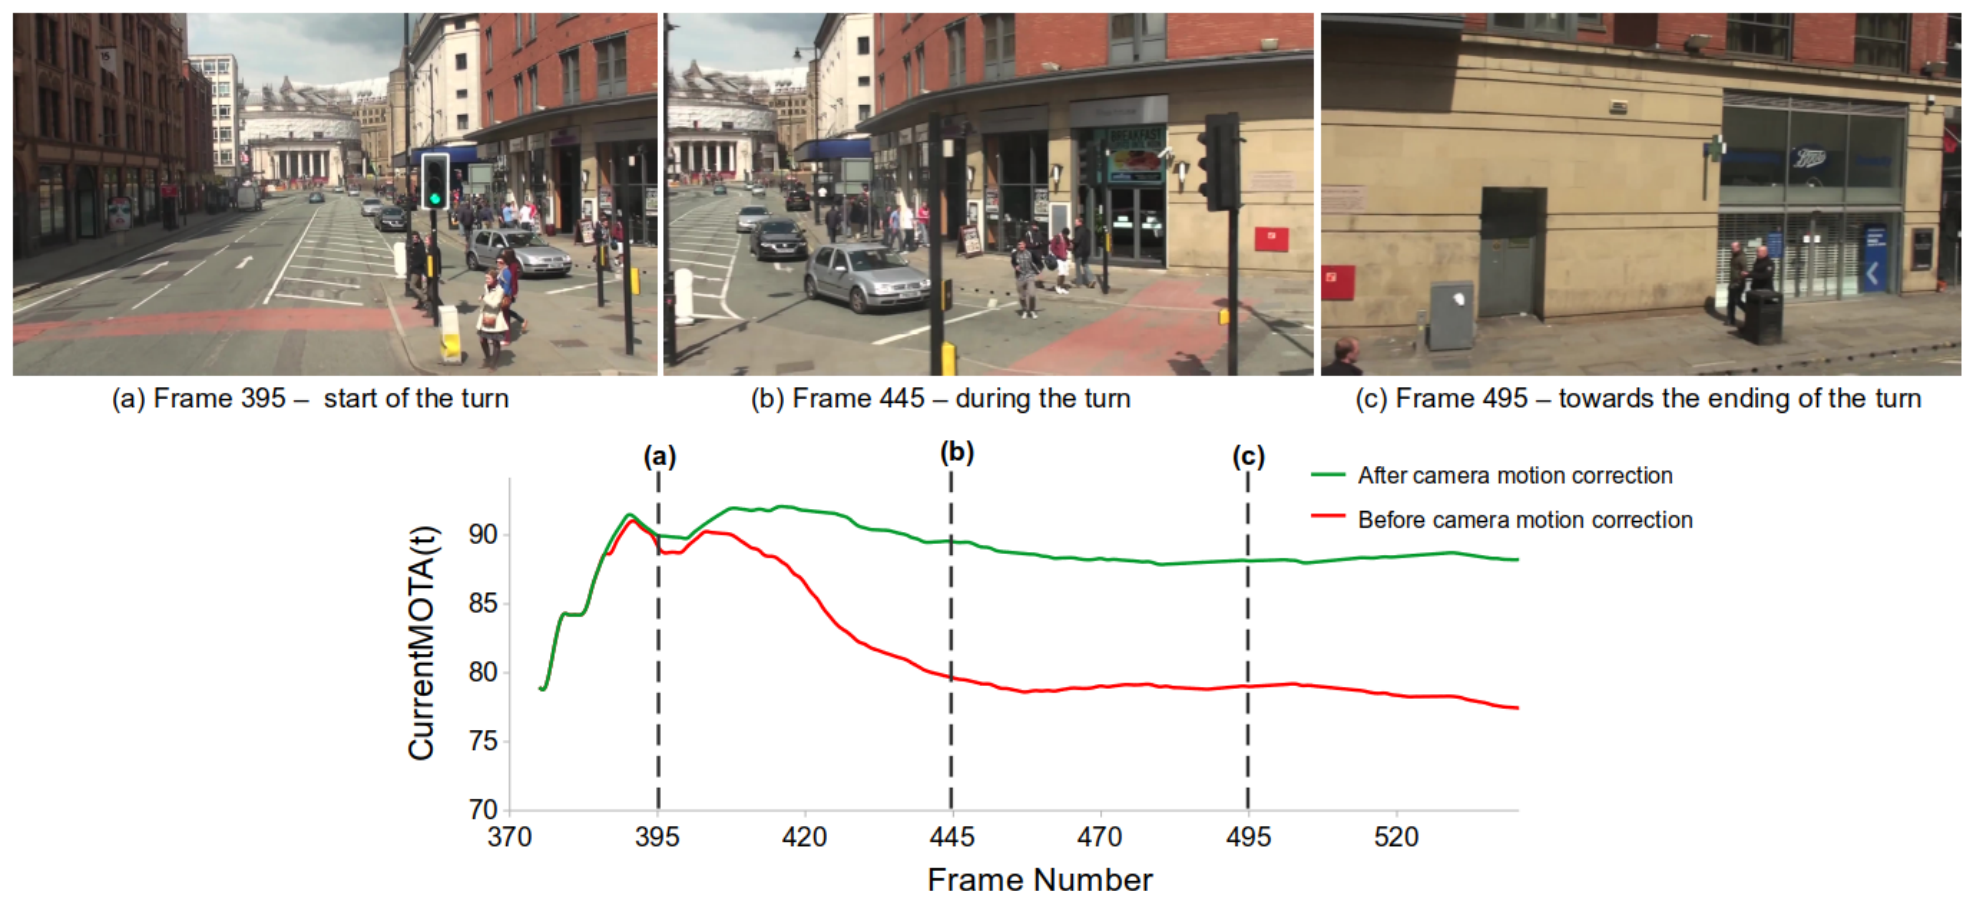
赤線は第 400 から 470 フレームの間で急落していて、上の画面と見比べると、ちょうどカメラが曲がっている区間だ。カメラ運動補償を加えると、緑線はほとんど下がらない。
議論
検出器には ByteTrack が公開した YOLOX の重みをそのまま使い、re-ID モデルは FastReID の SBS-50 で、60 epoch 訓練する。追跡のパラメータは ByteTrack を引き継ぎ、スコアのしきい値は 0.6、類似度が 0.2 を下回るとマッチングを棄却し、見失った軌跡は 30 フレーム保持する。公平に比べるため、ByteTrack と同じく最大間隔 20 フレームの線形補間も使う。実験は RTX 3060 一枚で走らせた。
各変更の貢献
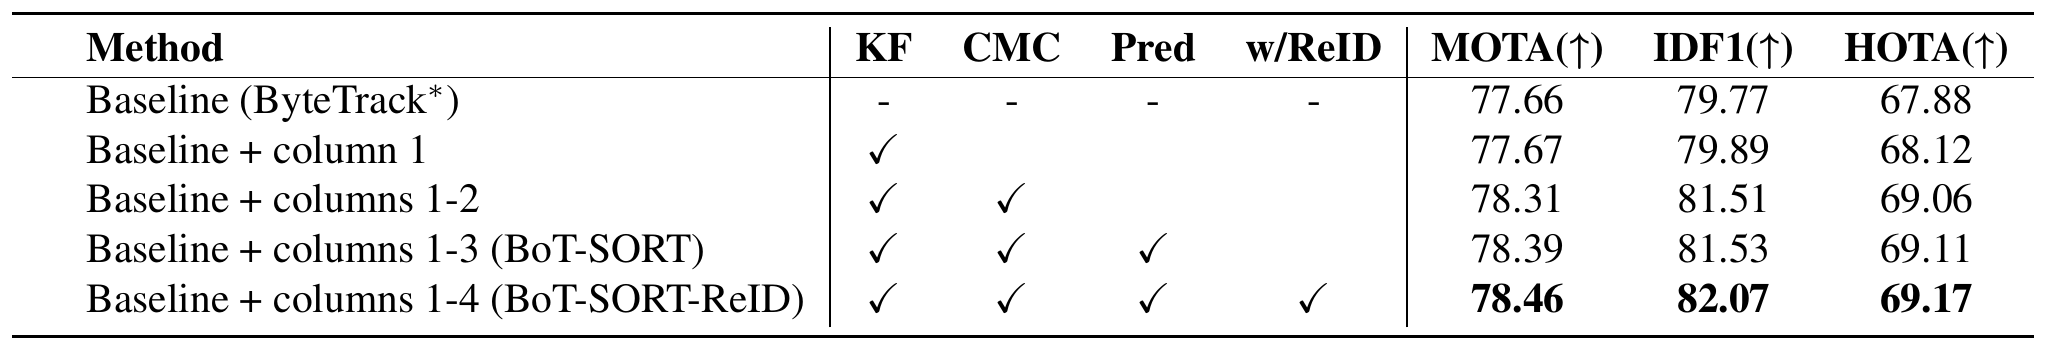
表の Pred はもう一つの小さな変更だ。高フレームレートの動画で、軌跡が一時的に検出とマッチしなかったとき、消してしまうのではなく、カルマンフィルタの予測ボックスで出力を続ける。
ベースラインから順に加えていくと、こうなる。
- 新しいカルマンフィルタ: HOTA +0.24 で、MOTA と IDF1 はほぼ変わらない。
- カメラ運動補償: MOTA +0.64、IDF1 +1.62、HOTA +0.94 で、四つの項目の中で最も大きな一歩だ。
- 予測の出力: 三つの指標とも、ほんのわずか上がるだけ。
- re-ID: IDF1 がさらに +0.54 で、MOTA と HOTA は小幅に上がる。
ByteTrack から BoT-SORT-ReID までで、HOTA は約 1.3、IDF1 は約 2.3 上がり、そのうち半分以上がカメラ運動補償によるものだ。
著者らは、一回目の関連付けで外観特徴をどう使うべきかも比べている。IoU だけでは MOTA 78.4、IDF1 81.5、HOTA 69.1。コサイン距離だけだと 73.7、70.0、62.4 に下がる。JDE 流の「外観距離にカルマンフィルタのゲートを組み合わせる」方式は 77.7、80.1、68.2。IoU でふるいにかけた後にコサイン距離だけを見る方式は 78.3、81.0、68.7。著者らの提案する融合の方式(78.5、82.1、69.2)を除けば、re-ID を使うほかのやり方はどれも単純な IoU に負けている。そこで著者らは、資源が限られた応用なら、IoU だけでも良い選択だと勧めている。
リーダーボード
MOT17 テストセットでの結果は次のとおりだ。
- BoT-SORT:MOTA 80.6、IDF1 79.5、HOTA 64.6。
- BoT-SORT-ReID:MOTA 80.5、IDF1 80.2、HOTA 65.0。
著者らによれば、BoT-SORT-ReID は MOT17 で IDF1 が 80 を超えた最初のトラッカーだ。ByteTrack の 80.3、77.3、63.1 と比べると、MOTA はほぼ同じで、IDF1 と HOTA はどちらもはっきり上がっている。ID スイッチは ByteTrack の 2196 回から 1212 回に減った。
MOT20 テストセットでは、BoT-SORT-ReID は MOTA 77.8、IDF1 77.5、HOTA 63.3、ByteTrack は 77.8、75.2、61.3 だ。MOTA は横ばいで、IDF1 と HOTA はこちらでも改善している。
代償は速度だ。表では、MOT17 での BoT-SORT は 6.6 FPS、BoT-SORT-ReID は 4.5 FPS で、ByteTrack は 29.6 FPS だ。ただし著者らも注意しているように、手法ごとに速度を測ったハードウェアが違い、ほとんどは検出の時間も含めていないので、FPS をそのまま比べるのは難しい。
著者らが認める限界
- カメラ運動補償は失敗することがある。 画面に動く物体が多すぎると背景のキーポイントが足りず、カメラの動きの推定が誤る。誤った補償は、トラッカーに予想外の振る舞いをさせかねない。
- 計算時間。 大きな画像での大域的な運動推定には時間がかかる。著者らは、検出器の推論時間に比べれば無視できる程度で、マルチスレッドで並列に計算することもできると考えている。
- 外観特徴がトラッカーを遅くする。 彼らは高スコアの検出だけから特徴を抽出してコストを下げている。必要なら、特徴抽出を検出器の出力ヘッドに組み込み、JDE のような結合型のアーキテクチャにすることもできる。
その後
BoT-SORT はその後、Ultralytics YOLO の追跡モジュールのデフォルトのトラッカーになり、もう一つの選択肢が ByteTrack だ。Ultralytics の説明では、手持ち、空撮、車載のような動くカメラの動画には BoT-SORT を、速度だけを求めてカメラが固定されているなら負担が最も小さい ByteTrack を勧めている。その設定ファイルでは、カメラの動きの推定を差し替え可能な選択肢にしていて、デフォルトは疎なオプティカルフローだが、ORB、SIFT、ECC に替えたり、オフにしたりもできる。re-ID はオプションだ。
Roboflow のトラッカーのドキュメントも似たような勧め方をしている。動くカメラではカメラ運動補償をオンにし、固定カメラで最速が必要ならオフにしてよい。テクスチャに乏しい背景では、疎な特徴に基づく運動推定は当てにならないことがある。これは論文自身が書いている一つ目の限界と同じ話だ。
結論
カルマンフィルタで幅と高さを直接推定し、予測ボックスをカメラと一緒に動かし、IoU と外観は先にふるいにかけてから最小値を取る。BoT-SORT が ByteTrack の上でやったのは、この三つだけだ。アブレーションによれば、最も大きな一歩はカメラ運動補償だ。さらに re-ID を加えた BoT-SORT-ReID で、MOT17 の IDF1 は 80 の大台を越えた。
スマートフォン、ドローン、車で撮った動画なら、カメラ運動補償はたぶん真っ先にオンにすべきスイッチだ。監視カメラが壁に固定されて動かないなら、オフにして、その数ミリ秒は検出器に回してやろう!