原論文
MOT16: A Benchmark for Multi-Object Tracking
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:1603.00831
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmot162016,
  title = {{MOT16: A Benchmark for Multi-Object Tracking}},
  author = {Anton Milan and Laura Leal-Taixe and Ian Reid and Stefan Roth and Konrad Schindler},
  year = {2016},
  eprint = {1603.00831},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1603.00831}
}
追跡の論文を読み続けていると、MOT16、MOT17 という二つの名前はほぼどの論文にも出てくる。DeepSORT は MOT16 で成績を報告し、Tracktor、FairMOT、ByteTrack、BoT-SORT のメインの表はどれも MOT17 だ。
この論文が、それらの源流にあたる。
2014 年 10 月、アデレード大学、チューリッヒ工科大学、ダルムシュタット工科大学の研究者たちが MOTChallenge を公開した。共通のデータセット、一元化された評価プログラム、そして誰でも結果をアップロードできるリーダーボードからなる。最初の版は MOT15 と呼ばれ、訓練用の動画が 11 本、テスト用の動画が 11 本あった。この論文が書かれた時点で、すでに 47 の手法が結果をアップロードし、登録ユーザーは 180 人を超えていた。SORT の成績も MOT15 で出したものだ。
だが MOT15 を一年あまり使ううちに、問題も浮かび上がってきた。そこで Anton Milan、Laura Leal-Taixé らが第二版を出した。それが MOT16 だ。
問題の定義
複数物体追跡の評価は、多くの視覚タスクの評価より難しい。著者らは理由を三つ挙げている。
一、正解そのものがはっきりしない。 大部分が隠れている人は、追うべき目標に数えるのか? ショーウィンドウのガラスに映った姿、ポスターの中の人、マネキンはどうか? 人間にアノテーションを頼んでも、人によって意見が分かれうる。
二、指標がばらばら。 当時の主流は CLEAR MOT だったが、「予測ボックスと真のボックスが対応した」と判定する IoU のしきい値は、論文によって 25% から 50% までまちまちだった。評価プログラムの実装の細部もそれぞれ違い、結果は大きく変わった。
三、決まった訓練/テストの分割がない。 PETS 2009 を例にとると、最も簡単な S2L1 シーケンスでは、良い検出を与えれば追跡精度はとっくに 90% を超えていた。しかし使うサブセットも、訓練のしかたも、評価プログラムも、入力する検出も人によって違い、結果は実のところ比べようがなかった。著者らの問いかけは率直だ。これらのシーケンスは今の手法にとってもう簡単すぎるのか? それとも手法が単に過学習しているだけなのか、あるいは評価のやり方に問題があるのか?
MOTChallenge は、共通のデータ、一元化された評価、公開のリーダーボードでこれらの問いに答えようとした。だが第一版の MOT15 にも欠点があった。
- アノテーションのルールが統一されていない。一部のシーケンスのアノテーションは、それぞれの古いデータセットのものをそのまま引き継いでいて、基準がそろっていない。
- 訓練セットとテストセットで、混雑の度合いの分布が偏っている。
- 簡単すぎるうえに有名すぎるシーケンス(たとえば PETS09-S2L1)があり、手法がどれもそれに過学習している。
- 公式に提供された検出結果の質が悪すぎて、参加者の中には検出器ごと替えてしまう者もいた。
最後の点は、SORT の論文がすでに実演している。SORT の論文の主張は、まさに MOT15 公式の ACF 検出を替えれば追跡の成績が大きく上がる、というものだった。
問題を解く
MOT16 は、まったく新しい動画、厳格なアノテーションのルール、そしてきちんと説明された評価方法を用意した。
14 本の新しい動画
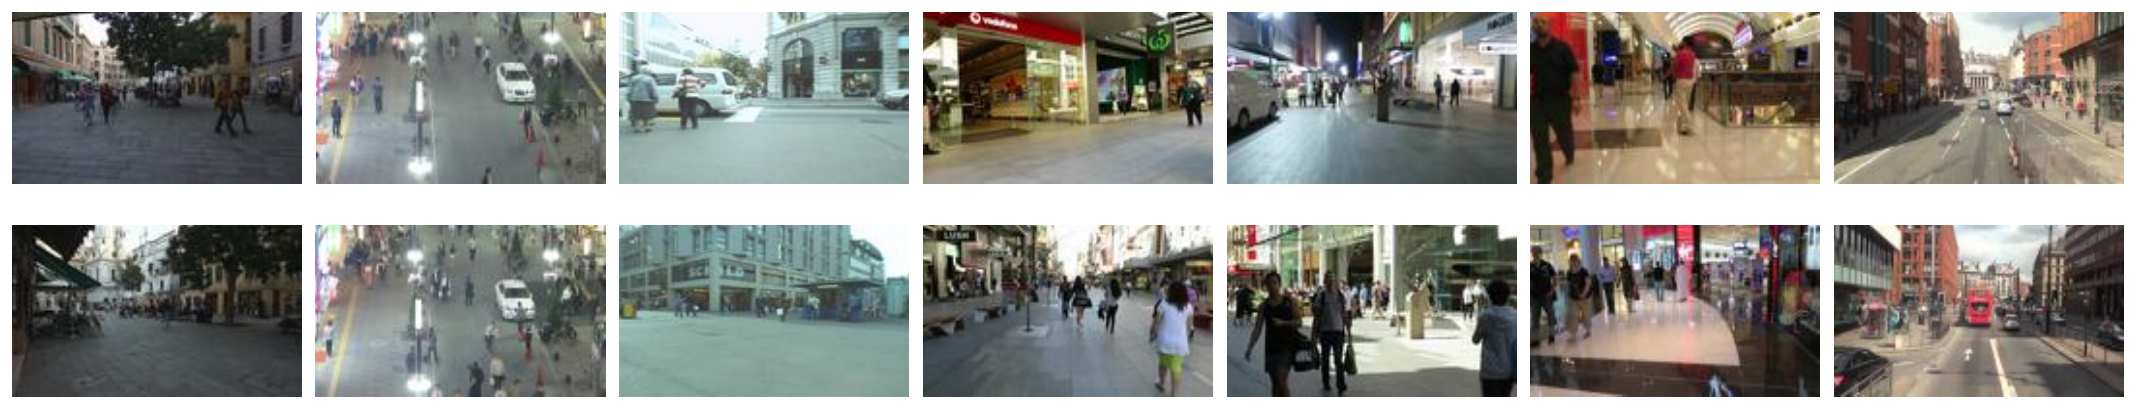
MOT16 には全部で 14 本の動画があり、半分が訓練用、半分がテスト用で、テストセットのアノテーションは公開されていない。MOT15 と比べると、ボックスの数は 3 倍近くに増え、平均の混雑度も 3 倍になった。
これらの動画は、意図的にばらばらな条件で撮られている。
- カメラ: シーンに固定されているもの、人が手で持つもの、ベビーカーに載せたもの、車に取り付けて動かすもの。
- 視点: 高所から見下ろす、歩行者と同じ高さ、あるいは低い位置から撮る。
- 環境: 晴天(影や白飛びがある)、曇天、夜(動きによるブレが多い)、屋内。
- フレームレート: 大半は 30 FPS だが、25 FPS や 14 FPS の動画もある。
原論文 Table 2 の統計によると、訓練セットは合計 5,316 フレーム、512 本の軌跡、110,407 個の歩行者ボックスで、1 フレームあたり平均 20.8 人。テストセットは合計 5,919 フレーム、830 本の軌跡、182,326 個の歩行者ボックスで、1 フレームあたり平均 30.8 人だ。
この統計には、もう一つ注目すべき点が隠れている。テストセットの MOT16-03 は夜の人混みを見下ろした動画で、1 フレームあたり平均 69.7 人、この一本だけで歩行者ボックスが 104,556 個あり、テストセット全体の 57% を占める。MOTA はすべてのシーケンスをつなげて計算するので、この一本での成績が全体のスコアを大きく左右する。
誰を追うべきか
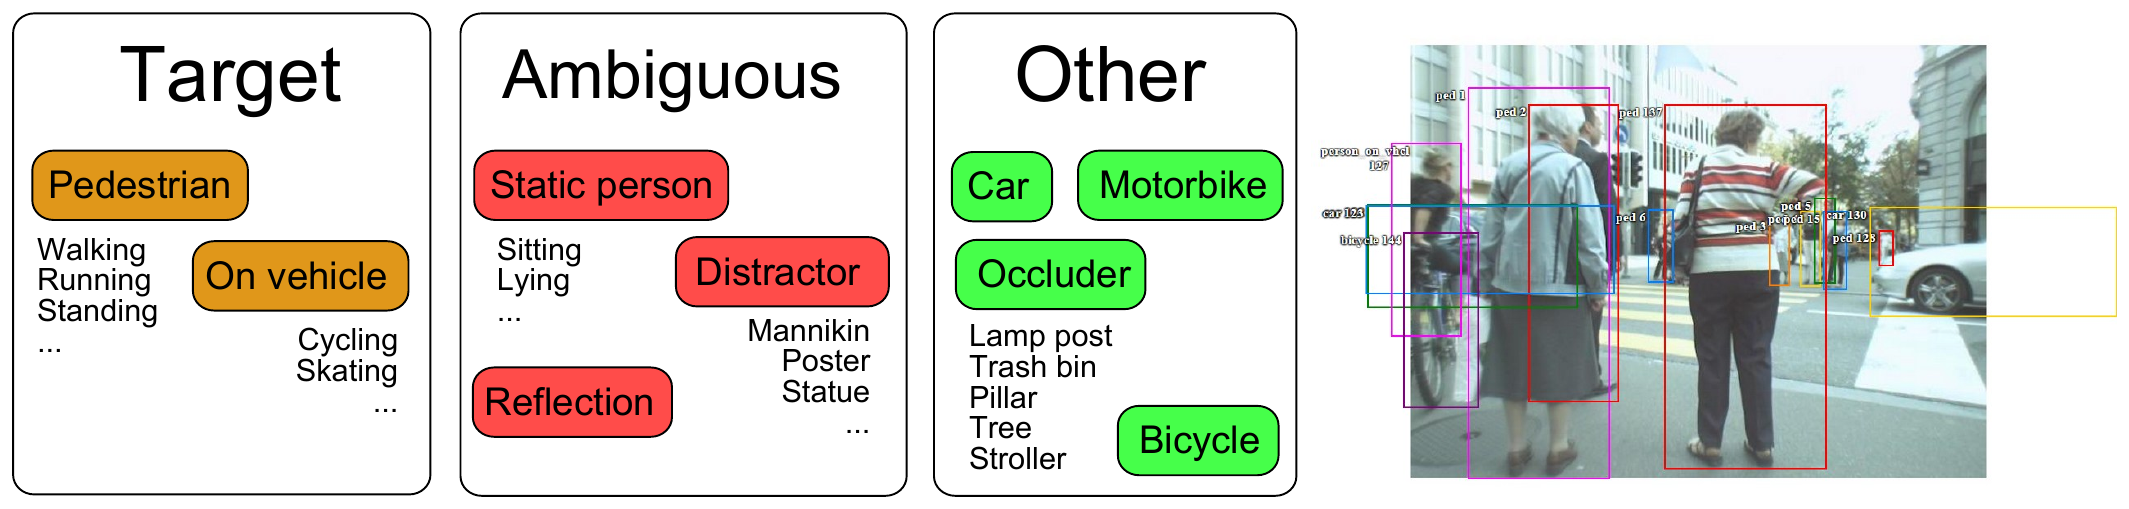
すべてのシーケンスは、研究者が同じルールに従って一からアノテーションし直し、相互にチェックした。ルールの核心は、「人に見えるもの」を三つのグループに分けることだ。
- 目標: 直立しているすべての人。歩いていても、走っていても、立っていてもよい。トラッカーが追う対象だ。
- あいまいなクラス: 直立姿勢ではない人(座っている、横になっている)と、映り込み、ポスター、写真、マネキン、ガラスの向こうの人といった、人のさまざまな「身代わり」。
- その他: 動いている車、バイク、自転車、ベビーカー、そして柱や木のような遮蔽物。
二つ目のグループが、この論文のうまいところだ。検出器はポスターの中の人を見れば、おそらくそれも囲む。トラッカーがそのボックスを素直に追ったら、それは誤りなのか? MOT16 の答えは、こうした場合は罰しもしないし、ほめもしないというものだ。評価のときは、ディストラクター、静止した人、映り込み、乗り物に乗っている人と 50% 以上重なる予測ボックスはそのまま取り除かれる。誤検出にもならず、追えなくても検出漏れにはならない。
三つ目のグループは評価には加わらないが、アノテーションしておけば訓練に使えるし、各歩行者がどれだけ隠れているかの計算にも使える。
ボックスそのものにもルールがある。
- ボックスはその人のすべてのピクセルを含み、しかもできるだけきつく囲む。 横向きに歩く人は、歩みの周期に合わせてボックスの幅が変わる。隠れている部分は、身長、影、前後のフレームといった手がかりから全体の範囲を推定する。画面の端で切れている人は、ボックスを画面の外まで延ばしてよい。
- 位置を確定できたらアノテーションを始める。おおよそ一割が見えたら始める。確定できなくなったら終える。
- ID はできるだけ保つ。 その人がまだ画面内にいて、経路をはっきり判断できるかぎり、同じ ID を保つ。隠れているあいだも、等速度のような単純な推論で位置を確定できるなら、アノテーションを続ける。長く隠れすぎて経路がわからなくなったら、再び現れたときに新しい ID をつける。
- すべてのボックスに可視度がある。 人手でアノテーションするのではなく、地面の仮定とすべてのボックスの位置から 0 から 1 の値で自動計算する。
最後にもう一段階「健全性チェック」がある。歩行者検出器ですべての動画を一通り処理し、検出器の信頼度が高いのにアノテーションから漏れている人やディストラクターを補う。
このルールはのちのちまで大きな影響を残した。Tracktor のノートで見る可視度の分析も、CenterTrack や ByteTrack が特別に扱う「ボックスが画面からはみ出す」問題も、ここから来ている。
公式の検出とデータ形式
著者らはいくつかの歩行者検出器を試し、最終的に DPM v5 の検出結果を公式の公開検出として提供した。理由は、当時そのまま使える R-CNN は「人」以外のクラスではどれも DPM より良かったのに、よりによって歩行者検出では DPM に負けていたからだ。再現率を少しでも上げるため、検出のしきい値はかなり低く設定されている。
アノテーションと検出はどれもカンマ区切りのテキストファイルで、1 行に 1 ボックス、9 つの列は順に、フレーム番号、ID、ボックス左上の x と y、幅、高さ、信頼度スコア(アノテーションファイルでは「評価に含めるかどうか」のフラグになる)で、最後の二列はアノテーションファイルではクラスと可視度だ。検出ファイルの ID は一律 −1 になっている。まだ追跡されていないからだ。
この形式は今日までずっと使われている。GitHub でトラッカーが結果を frame,id,x,y,w,h,... と一行ずつ書き出しているのを見かけたら、十中八九 MOTChallenge に合わせているのだ。
評価の計算方法
評価は CLEAR MOT(MOTA、MOTP)と、Wu と Nevatia が提案した軌跡の品質指標(MT、ML、FM)を引き継いでいる。肝心なのは、細部を一つ残らず明確にしたことだ。
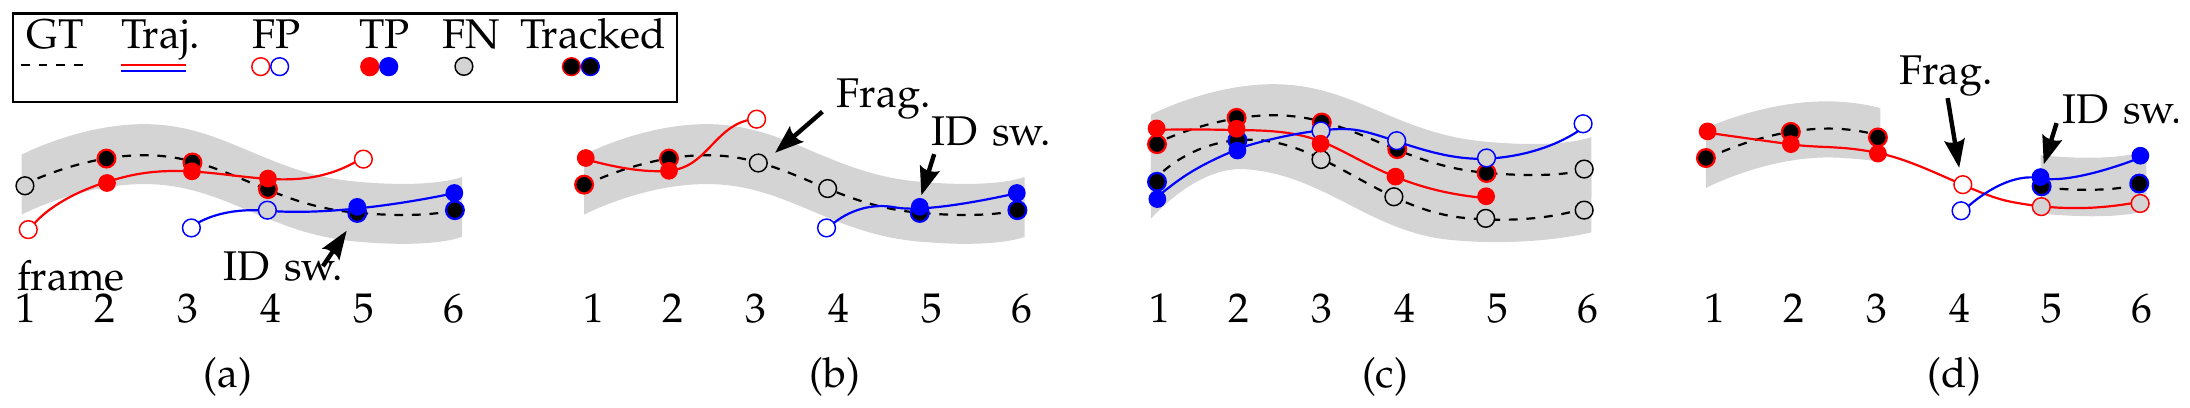
マッチング。 各フレームでハンガリアン法を使い、予測ボックスと真のボックスを一対一で対応づける。IoU のしきい値は 50% だ。ただし、マッチングはフレームごとに独立して行うわけではない。ある真の目標が前のフレームで軌跡 に対応していて、このフレームでも との距離がしきい値内なら、その対応をそのまま使い続ける。すぐ近くにもっと近い予測ボックスがあっても同じだ。
ID スイッチ。 ある真の目標が今回対応した軌跡が、前回対応した軌跡と違えば、ID スイッチ(IDSW)1 回と数える。著者らは、軌跡を 2 倍追えている手法は ID スイッチの回数も当然多くなると特に注意を促していて、ID スイッチを再現率で割った相対的な数字も別に報告している。
途切れ。 一本の真の軌跡が「追えている」から「追えていない」に変わり、その後また追い直されたら、途切れ(FM)1 回と数える。
MOTA と MOTP。 MOTA は検出漏れ、誤検出、ID スイッチを合計し、真のボックスの総数で割って 1 から引いたもので、範囲は負の無限大から 100% まで、誤りが多すぎるとマイナスにもなる。MOTP は対応したすべてのボックスの平均の重なりで、著者らははっきりと、これは主に検出器の位置決めの精度を反映していて、トラッカーそのものの性能についてはあまり多くを語らないと書いている。
MT と ML。 一本の真の軌跡が、その期間の 80% 以上で追えていれば「ほぼ追跡できた」、20% 未満なら「ほぼ見失った」と数える。この二つの指標は、ID が途中で変わったかどうかを問わない。
すべてのテストシーケンスはつなげて計算する。シーケンスごとに計算してから平均するのではない。シーケンスによって人数が違いすぎるからだ。
著者らは、これらの指標の限界も率直に説明している。MOTA は三種類の誤りを一つの数字にまとめる。比べやすいという利点はあるが、「それだけを唯一の指標にしてよいかは、大いに議論の余地がある」。著者らはまた、この評価は再識別を扱わないことも説明している。目標が画面から出てまた戻ってきたら、新しい目標として扱われる。
議論
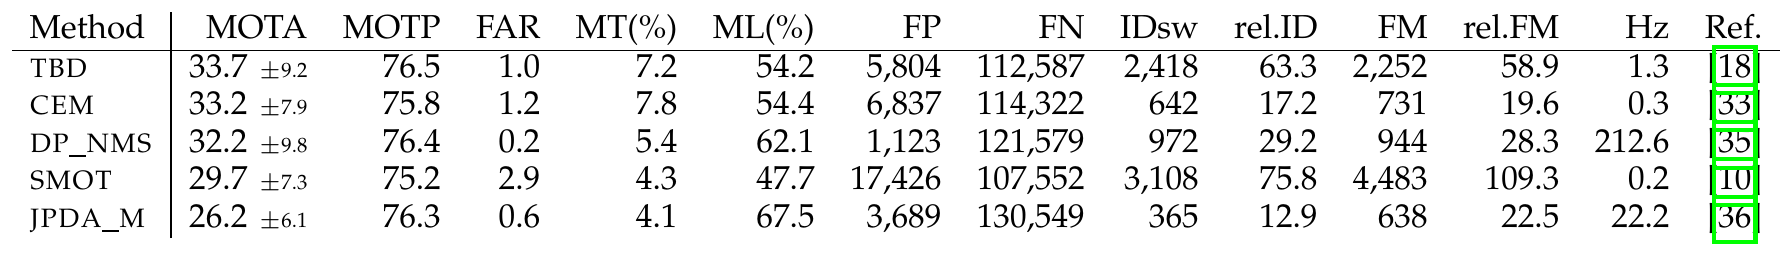
著者らは公開されているコードを使って、当時よく使われていた五つの手法を走らせ直した。ネットワークフロー(DP_NMS)、連続エネルギー最小化(CEM)、運動の類似度(SMOT)、二段階のマッチング(TBD)、近似した結合確率的データ関連付け(JPDA_M)だ。
パラメータの調整方法も、著者らははっきり書いている。各手法の作者が勧めるデフォルト値から出発し、各パラメータを の範囲でランダムにサンプリングして訓練セットで 20 回走らせ、MOTA が最も高かった組を選んで、テストセットでは一度だけ走らせる。著者らは、これらの数字が各手法の最良の成績とは限らないとも断っている。
結果には見るべき点が三つある。
- MOTA は最高でも 30 点台前半にとどまる。 最も良い TBD が 33.7、最も悪い JPDA_M が 26.2 だ。
- 大半の人を見失っている。 どの手法も ML は 47% 以上、FN は 10 万を超える。つまり、検出が見つけられなかった人はトラッカーにも救えず、しかも公式の DPM 検出は多くの人を見逃していた。
- 速度は千倍違う。 DP_NMS は毎秒 212.6 フレーム、SMOT はわずか 0.2 フレームだ。精度が同じくらいの手法でも、速度はここまで違いうる。
この表をのちの論文と見比べると、検出器の影響がどれほど大きいかがわかる。一年後、DeepSORT ははるかに質の良い独自検出に替えて、同じ MOT16 テストセットで MOTA 61.4 を取った。さらに数年後、FairMOT は 74.9 だ。追跡手法ももちろん進歩したが、30 点台から 70 点台まで一気に跳ね上がった功績の大半は検出器のものだ。
その後
2017 年、MOTChallenge は MOT17 を出した。動画は MOT16 とまったく同じだが、アノテーションはもう一度見直され、公式の検出も DPM の一組だけから、DPM、Faster R-CNN、SDP の三組に増えた。参加者は三組の検出でそれぞれ一回ずつ走らせ、結果を平均しなければならない。Tracktor のノートで見る「public detection」の部門は、この設定で競われている。
2020 年の MOT20 は混雑度を限界まで押し上げた。ByteTrack の論文の統計によると、テストセットでは 1 フレームあたり平均 170 人がいる。同じ年、Leal-Taixé ら MOTChallenge の運営者も加わって HOTA が提案され、この論文の「MOTA だけを唯一の指標にしてよいかは、大いに議論の余地がある」という一文に正式に応えた。
結論
MOT16 は複数物体追跡に、14 本の新しい動画、一から作り直したアノテーションのルール、そしてマッチング、ID スイッチ、途切れをすべて明確に定義した評価方法をもたらした。最も細やかな設計は、映り込み、ポスター、座っている人を「罰しもしないし、ほめもしない」あいまいなクラスに入れたことだ。これでトラッカーは、検出器のもっともな反応のせいで減点されずに済む。
次に論文の表で MOT17 の数字を見かけたら、まず、公開検出を使ったのか、それとも独自の検出か、と問うてみるといい。それから、テストセットの MOTA の中で、MOT16-03 の夜の人混みがどれほどの比重を占めているかも考えてみよう。
誰を追うべきかについては、十年たった今も、みんなこの論文の答えを使っている。