原論文
Tracking without bells and whistles
- 発表先
- ICCV 2019国際会議
- arXiv への初回投稿
- arXiv:1903.05625
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingtracktor2019,
  title = {{Tracking without bells and whistles}},
  author = {Philipp Bergmann and Tim Meinhardt and Laura Leal-Taixe},
  year = {2019},
  eprint = {1903.05625},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1903.05625}
}
複数物体追跡の論文は、どんどん複雑になっていった。グラフモデル、マルチカット、条件付き確率場、ソーシャルフォースモデルと、凝った全体最適化が次々に登場した。
それなのに MOT16 の MOTA は、二年でたった 2.4 ポイントしか伸びていなかった。
ミュンヘン工科大学の Philipp Bergmann、Tim Meinhardt、Laura Leal-Taixé は、別の方向を試してみたいと考えた。Leal-Taixé は MOTChallenge の発起人の一人でもあり、このリーダーボードのことは知り尽くしている。三人は追跡のための専用の仕掛けをすべて取り去り、検出器を一つだけ残して、どこまで行けるかを見てみた。
その結果、この「小細工なし」のトラッカーは、MOTChallenge の三つのベンチマークの public detection 部門で、MOTA が当時発表済みのすべての手法を上回った。
そうなると気になってくる。検出器一つで追跡の問題の大半が解けるなら、専用の追跡アルゴリズムはいったい何を解いているのか?
問題の定義
これまでに読んだ SORT と DeepSORT は、どちらも追跡を二つの独立したステップに分けている。検出器が各フレームで個別にボックスを見つけ、トラッカーがそれらのボックスをなんとかつなぐ。つなぐときには、物体が次のフレームでどこにいるかを予測し、二つのボックスが同じ人かどうかを判断し、さらに遮蔽、検出漏れ、誤検出も処理しなければならない。
こうした小問題は、それぞれ一揃いの手法群を生んできた。だが著者らは、物体検出器の中にはもともと「位置を予測する」部品があることに気づいた。
Faster R-CNN を例にとると、まず領域提案ネットワーク(RPN)で大量の候補ボックスを作り、それから各候補ボックスに二つのことをする。分類ヘッドはボックスの中が人かどうかを判断し、回帰ヘッドはボックスを物体にぴったり合う位置まで微調整する。
回帰ヘッドの仕事は、「だいたいのボックスを渡されたら、それを物体の本当の位置まで直す」ことだ。
では、前のフレームのボックスを渡したらどうなるか?
物体が二つのフレームのあいだであまり動いていなければ、前のフレームのボックスは、このフレームでもおおよそ同じ人を囲んでいる。回帰ヘッドはそれを、その人の新しい位置まで引き寄せる。ボックスの ID はそのまま引き継がれ、軌跡は 1 フレーム延びる。
カルマンフィルタも、ハンガリアン法も要らない。
問題を解く
著者らはこのトラッカーを Tracktor と名づけた。使うのは MOT17Det の歩行者検出データで訓練した Faster R-CNN で、バックボーンは ResNet-101 と FPN だ。
流れ全体はたった二つのステップしかない。原論文の図に沿って、第 フレームで何が起きるかを見ていこう。
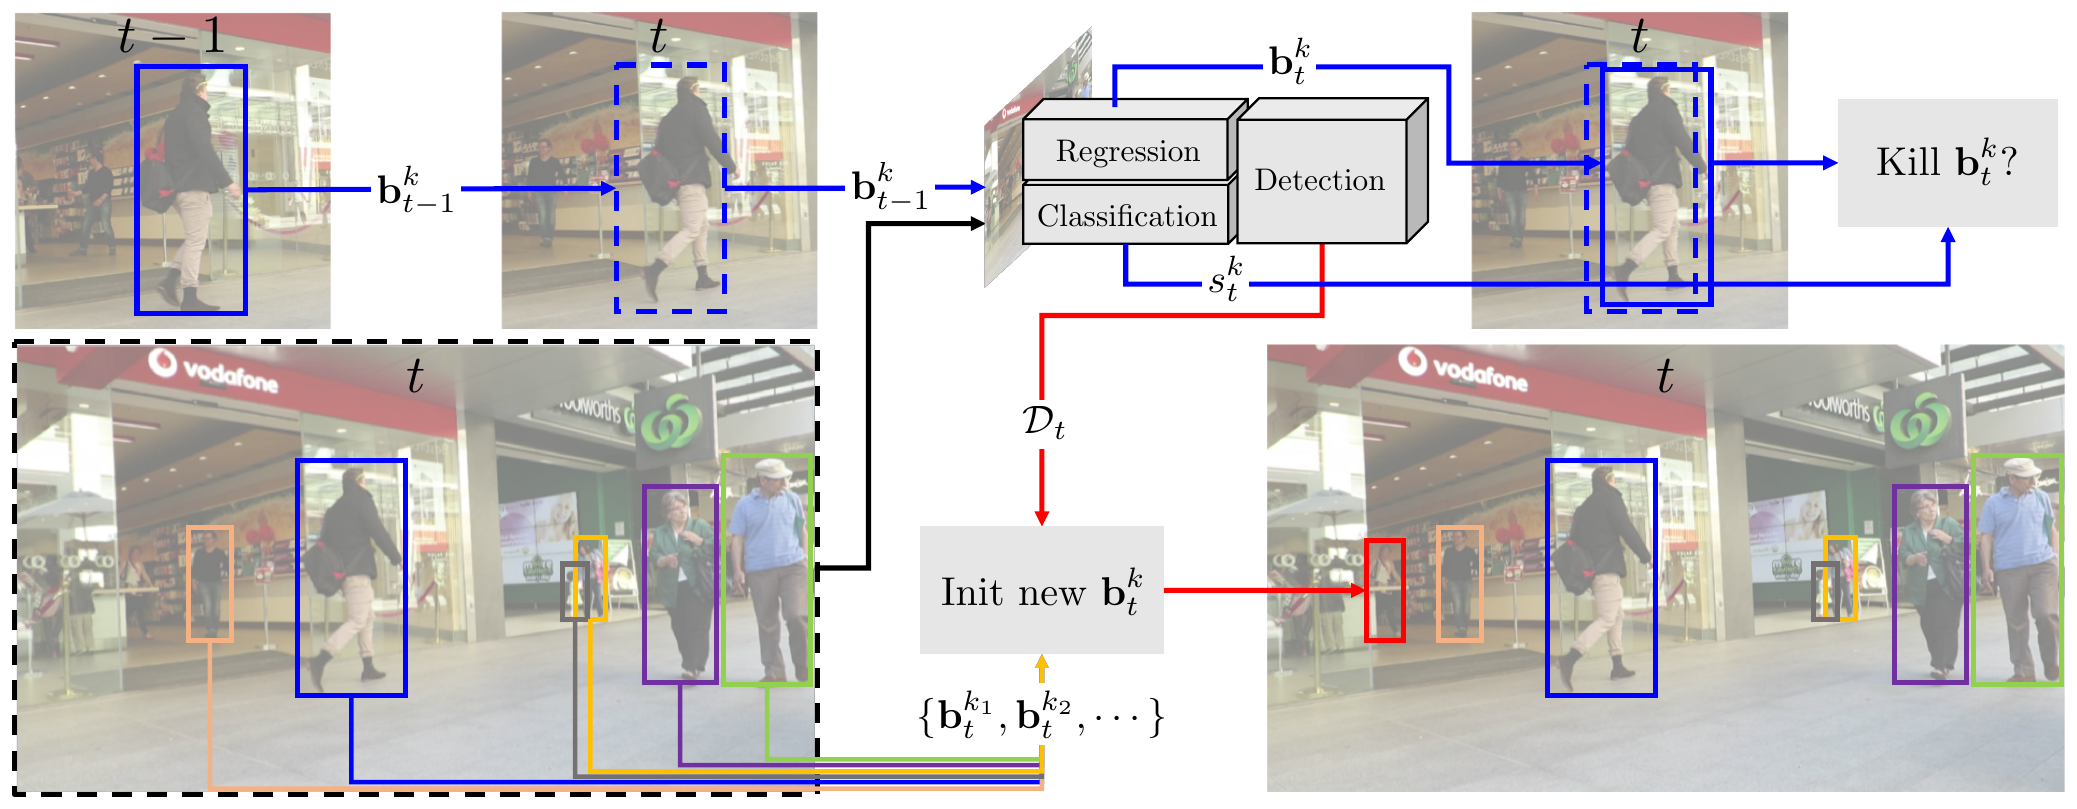
第一のステップ:回帰で古いボックスを新しい位置へ押し出す
まず、左上にいる暗い色の服の歩行者を見てほしい。第 フレームでのその人のボックスは だ。
第 フレームになると、Tracktor は同じ座標をそのまま新しい画像に置く。図の青い破線のボックスがそれだ。人はもう少し前に進んでいて、破線のボックスはその人を囲みきれていない。
次に Faster R-CNN は、第 フレームの特徴マップ上でこの破線のボックスを使って RoI pooling を行い、ふつうの候補ボックスを扱うのと同じように回帰ヘッドと分類ヘッドに送る。回帰ヘッドは補正したボックス を出力し、それは人の新しい位置にぴったり合っている。分類ヘッドはスコア を出力し、このボックスの中にまだ人がいるかどうかを表す。
ボックスの ID は から へそのまま渡される。追跡はこれで完了で、あいだにマッチングは一切ない。
回帰のあと、軌跡を終わらせる(kill)べき場合が二つある。
- スコアが低すぎる。 なら、ボックスの中にもう人はいない。物体が画面の外に出たか、柱や車のような歩行者以外のものに隠れたのかもしれない。
- 他の軌跡とぶつかった。 二人がすれ違うとき、二本の軌跡のボックスが同じ一人に回帰してしまうことがある。著者らはすべての軌跡の新しいボックスに非最大値抑制(NMS)を一度かけ、IoU のしきい値は とする。抑制された側の軌跡は終わる。
第二のステップ:検出ボックスで新しい人を補う
軌跡は古い物体を延ばしていくだけなので、新しく画面に入ってきた人は検出器で見つけるしかない。検出器が第 フレーム全体を一度処理し、検出結果 を得る。
検出ボックスが新しい軌跡を始められるのは、既存のすべての軌跡との IoU が 未満のときだけだ。つまり、まだどの軌跡でも説明されていない物体を覆っていなければならない。図の右下の赤いボックスは、こうして加えられたものだ。
論文の付録にある設定は 、、 で、どのベンチマークでも個別に調整していない。 は より緩いので、既存の軌跡は NMS で終わりにくく、新しい軌跡も出てきにくい。そのぶん追跡が安定する。
Tracktor 全体は、追跡のアノテーションで一度も訓練されていない。検出器が学んだのは「各フレームのどこに人がいるか」だけで、「誰が誰か」は一度も学んでいない。
二つの小さな拡張
回帰が成り立つのは、物体が隣り合う二フレームのあいだであまり動かないことが前提だ。カメラが大きく動いたり、動画のフレームレートが低かったりすると、この前提は崩れる。極端な場合、前のフレームのボックスはこのフレームで人をまったく囲んでいないこともある。
著者らは単純な運動モデルを二つ加えた。
- カメラ運動補償(CMC)。 拡張相関係数(Enhanced Correlation Coefficient, ECC)で隣り合う二フレームの画像を位置合わせし、まず古いボックスをカメラの動きに合わせて移してから、回帰ヘッドに渡す。
- 等速度の仮定(CVA)。 フレームレートの低い動画のためのもの。実験全体で使ったのは、MOT15 の AVG-TownCentre の一本だけだ。
もう一つの拡張は、短期の再識別(reID)だ。終わった軌跡はすぐには捨てず、しばらく保持しておく。そのあいだに新しい検出ボックスが現れたら、Siamese ネットワークで外観の距離を比べ、しきい値を下回れば古い ID をつなぎ直す。人の取り違えを避けるため、著者らは二つのボックスの IoU が十分に大きいことも求めていて、保持している古いボックスは運動モデルが動かし続ける。
この reID ネットワークは ResNet-50 をバックボーンとする TriNet で、MOT17 の追跡のアノテーションを使い、triplet loss で訓練した。だから reID を加えたあとは、厳密に言えば「追跡のアノテーションを一切使っていない」とは言えなくなる。論文もそのことをはっきり書いている。
CMC と reID を加えた版は Tracktor++ と呼ばれる。
議論
アブレーション:各拡張にどれだけの価値があるか
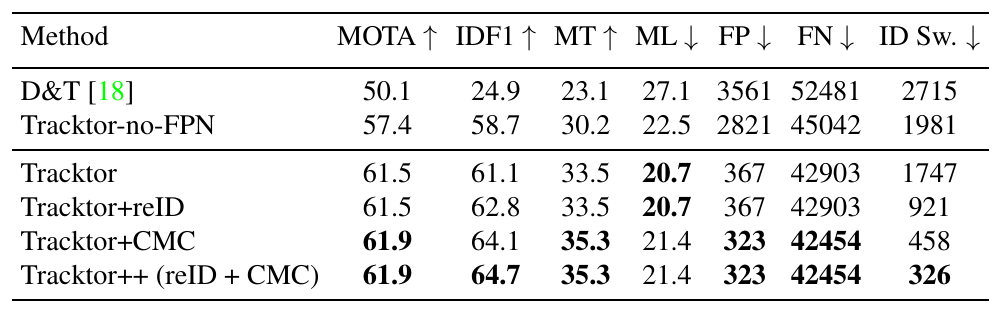
この表には三組の比較があり、それぞれが一つのことを示している。
- 検出器で追跡するほうが、専用に訓練した検出・追跡器より良い。 D&T は追跡のアノテーションで訓練し、二フレームの短い軌跡を作ってから、オフラインで長い軌跡につなぐ手法だ。その MOTA は 50.1、IDF1 はわずか 24.9。追跡のアノテーションに一度も触れていない Tracktor は 61.5 と 61.1 だ。
- 検出器が良くなれば、追跡も良くなる。 FPN を外した Tracktor-no-FPN では、MOTA が 61.5 から 57.4 に落ちる。検出器の品質が、回帰の品質をそのまま決めている。
- 二つの拡張は、主に ID を救っている。 Tracktor から Tracktor++ になると、MOTA は 0.4 しか増えないが、ID スイッチは 1747 から 326 に減り、IDF1 は 61.1 から 64.7 に上がる。そのうち CMC の効果は reID より大きく、CMC だけを加えても ID スイッチは 458 まで減る。MOT17 には移動カメラで撮った動画が何本もあり、古いボックスがカメラの揺れについていけないことが、ID が途切れる主な原因の一つだった。
テストセット
三つのベンチマークのテストセットで、Tracktor++ の MOTA は MOT17 で 53.5、MOT16 で 54.4、MOT15 で 44.1 で、いずれも当時の public detection の発表済み手法の中で最も高かった。三つのベンチマークで使ったのは、MOT17Det で訓練した同じ検出器で、MOT15 の訓練データはまったく使っていない。
MOT17 では、Tracktor++ の FP は 12201 で、次点の eHAF は 33212 だから、誤検出はぐっと少ない。一方 IDF1 52.3 は、eHAF の 54.7 や jCC の 54.5 にわずかに及ばない。MOTA の強みは主に誤検出の少なさから来ていて、身元の維持はなんとかついていけている程度だ。
本当に難しい場合
著者らはリーダーボードで立ち止まらなかった。MOT17 の訓練セットを使い、Tracktor と他のトップクラスの手法を並べて、物体の可視度、大きさ、検出の欠落の長さでグループに分けて比べた。
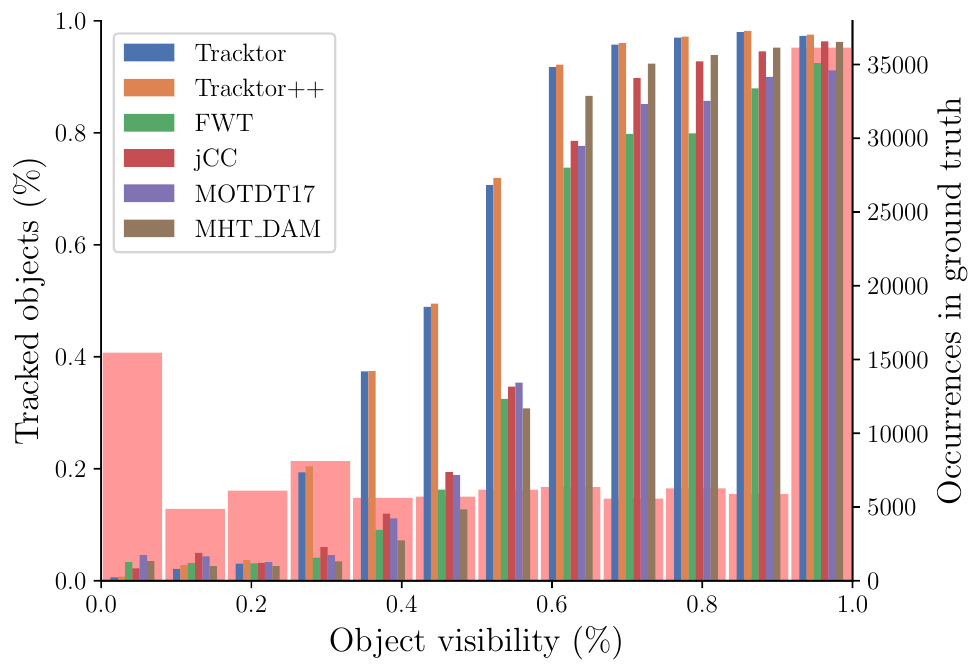
この図の色付きの棒は、可視度ごとに各手法が追えた割合で、薄い赤の棒は、真のアノテーションで可視度ごとのボックスがいくつあるかを示している。
まず右半分を見てみよう。可視度が 0.6 を超える物体は、どの手法もよく追えている。しかも薄い赤の棒から、この領域のボックス数が最も多いことがわかる。次に左半分。可視度が 0.3 未満の物体は、オンラインかオフラインか、外観モデルがあるかどうか、補間をするかどうかにかかわらず、どの手法も 2 割以下しか追えていない。
Tracktor は 0.3 から 0.6 のあいだではっきりリードしていて、これは回帰ヘッドが半分隠れた人をまだ囲み直せるからだ。ところが大きく隠れた領域になると、うまく扱える手法は一つもない。著者らはこれをもとに、テストセットでのそこそこの MOTA の大部分はデータの分布から来ていると指摘している。ボックスの大半は、もともとはっきり見えているのだ。
物体の大きさの分析も、同じ結論になる。可視度が 0.9 を超える物体のうち、身長が 250 ピクセルを超える人はどの手法もよく追えていて、物体が小さくなるほど、どの手法も悪くなる。検出の欠落の分析では、DPM と Faster R-CNN の二組の公開検出で、欠落が 15 フレームを超えると、Tracktor が回帰で穴を埋める力は他の手法よりはるかに強いことがわかった。より良い SDP の検出に替えると、いちばん恩恵を受けたのはかえってオフラインの補間を使う手法だった。どの手法も、欠落が長くなるほどカバー率が下がる。
上限はどこにあるか
最後に著者らは、Tracktor の各部品を真のアノテーションに置き換えた一連の oracle を作り、それぞれの方向でどこまで伸びうるかを見積もった。
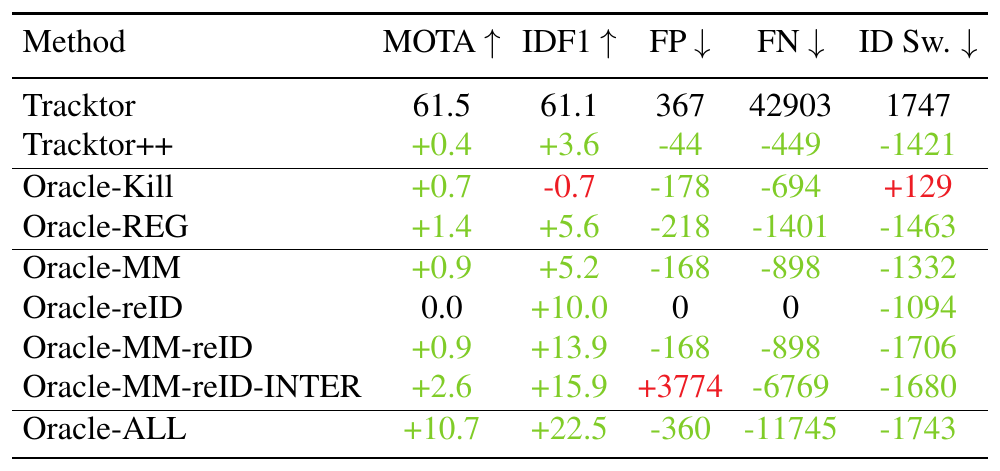
注目すべき数字がいくつかある。
- 完璧な reID(Oracle-reID)では MOTA は変わらないが、IDF1 は 10 ポイント増える。再識別は人を見分けるだけで、ボックスが正確かどうかには関わらない。
- 完璧な運動モデルと reID(Oracle-MM-reID)では、IDF1 が 13.9 増える。著者らはこれを、Tracktor++ という拡張路線の上限とみなしている。
- さらに遮蔽中の線形補間を加える(Oracle-MM-reID-INTER)と、IDF1 は 15.9 増え、FN も 6769 減るが、FP は 3774 増える。補間で補ったボックスの多くは、カメラが動いたときや長時間の遮蔽のときに、間違った位置に置かれている。
- すべてをアノテーションに置き換える(Oracle-ALL)と、MOTA は 10.7 増え、72.2 になる。これが Faster R-CNN と FPN というこの検出器の絶対的な上限だ。
Oracle-Kill も面白い。アノテーションを使って軌跡をいつ終わらせるかを決めると、MOTA は 0.7 上がるのに、ID スイッチは 129 増える。軌跡が長く残るほど、回帰ヘッドは隠れてよく見えないボックスに出会うことが増え、かえって別の人を引き寄せてしまう。
著者らの提案
著者らは、Tracktor を新しい出発点にしようと主張している。大きくてはっきり見える物体はフレームごとの回帰に任せ、残った難しい場合を専用の手法に回す。そのうえで二つの方向を提案した。一つは長時間の遮蔽のあいだも物体の位置を「想像で補える」運動モデル、もう一つは「tracking-by-detection」から「tracking-by-tracklet」への転換で、検出器に短い軌跡を直接出させ、難しい部分を後段の手法で処理するというものだ。
振り返ってみると、どちらの方向にも引き継ぐ人が現れた。検出と追跡を一つのネットワークに入れる CenterTrack や FairMOT はすぐに登場した。Tim Meinhardt 自身も二年後に Leal-Taixé らと TrackFormer を発表し、前のフレームの物体を「トラッククエリ」の形で次のフレームの Transformer デコーダに持ち込んだ。そこで引き継がれているのも、「前のフレームの物体を使って、このフレームの物体を探す」という発想だ。
結論
訓練済みの検出器が前のフレームのボックスを回帰ヘッドに渡すだけで、MOTChallenge の三つのベンチマークで public detection の最高の MOTA を取った。カメラ運動補償と短期の reID を加えると、ID スイッチはさらに 8 割減る。
リーダーボードよりも、後半の分析のほうが読みごたえがある。大部分が隠れた物体や、とても小さな物体は、当時どの手法もうまく扱えていなかった。リーダーボードのきれいな MOTA の多くは、もともとはっきり見えて追いやすいボックスから来ていた。
タイトルは小細工なしとうたっているが、著者ら自身も結局二つ加えた。加えたうえで、いちばん追いにくい人たちは当時まだ誰も追えていなかったと、正直に認めている。