原始論文
MOT16: A Benchmark for Multi-Object Tracking
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:1603.00831
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmot162016,
  title = {{MOT16: A Benchmark for Multi-Object Tracking}},
  author = {Anton Milan and Laura Leal-Taixe and Ian Reid and Stefan Roth and Konrad Schindler},
  year = {2016},
  eprint = {1603.00831},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1603.00831}
}
讀追蹤論文讀久了,MOT16、MOT17 這兩個名字幾乎每篇都會出現。DeepSORT 在 MOT16 上報成績,Tracktor、FairMOT、ByteTrack、BoT-SORT 的主表都是 MOT17。
這篇就是它們的源頭。
2014 年 10 月,阿德雷德大學、蘇黎世聯邦理工學院與達姆施塔特工業大學的研究者上線了 MOTChallenge。它包含一份共用的資料集、一套集中的評估程式,以及一個任何人都能上傳結果的排行榜。第一版叫 MOT15,有 11 段訓練影片、11 段測試影片。到這篇論文寫成時,已經有 47 個方法上傳結果,超過 180 個使用者註冊。SORT 的成績就是在 MOT15 上跑出來的。
但 MOT15 用了一年多,問題也浮出來了。Anton Milan、Laura Leal-Taixé 等人於是推出第二版,也就是 MOT16。
定義問題
評估多目標追蹤比評估很多視覺任務都難。作者列了三個原因。
一、正確答案本身就說不清楚。 一個人被擋住一大半,算不算要追的目標?櫥窗玻璃上的倒影、海報上的人、假人模特兒呢?就算請人類來標,彼此也可能意見不同。
二、指標各說各話。 CLEAR MOT 是當時的主流,但判斷「預測框和真實框配上了」的 IoU 門檻,不同論文從 25% 到 50% 都有;評估程式的實作細節也各不相同,結果差很多。
三、沒有固定的訓練與測試切分。 以 PETS 2009 為例,最簡單的 S2L1 序列,給了好的偵測後,追蹤準確度早就超過 90%。但大家用的子集、訓練方式、評估程式、偵測輸入都不一樣,結果其實沒辦法比較。作者問得很直接,這些序列對現在的方法來說已經太簡單了嗎?還是方法根本只是過擬合,或者評估方式出了問題?
MOTChallenge 用共用資料、集中評估、公開排行榜來回答這些問題。但第一版的 MOT15 也有它的毛病:
- 標註規則不一致。部分序列的標註直接沿用各個舊資料集,標準不一。
- 訓練集和測試集的擁擠程度分布不平衡。
- 有些序列太簡單又太有名(例如 PETS09-S2L1),方法都對它們過擬合了。
- 官方提供的偵測結果太差,有些參賽者乾脆換掉偵測器。
最後一點,SORT 那篇已經示範過。SORT 的論文主張,正是換掉 MOT15 官方的 ACF 偵測,追蹤成績就大幅提升。
解決問題
MOT16 準備了全新的影片、一套嚴格的標註規則,以及一套說清楚的評估方式。
14 段新影片
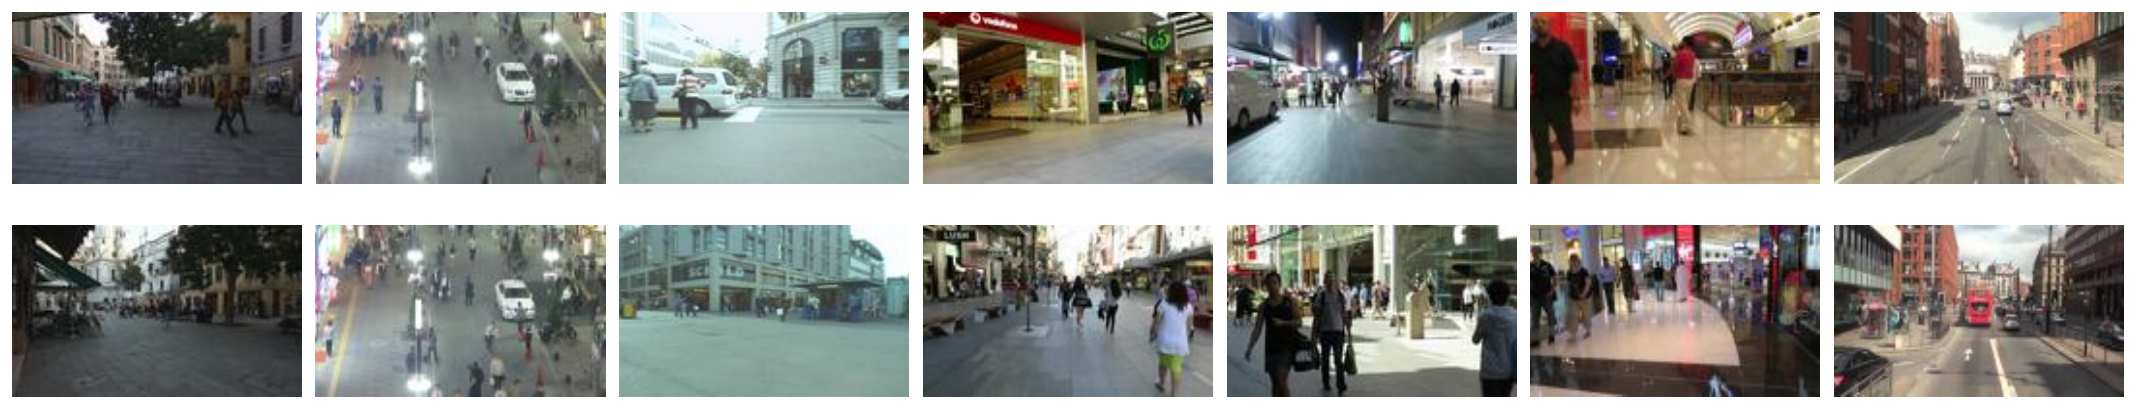
MOT16 共有 14 段影片,一半訓練、一半測試,測試集的標註不公開。和 MOT15 相比,框的數量是它的將近 3 倍,平均擁擠程度也是 3 倍。
這些影片刻意做得很不一樣:
- 相機: 固定在場景中,或由人手持、放在嬰兒車上、裝在車上移動。
- 視角: 從高處俯瞰、和行人同高,或從低處拍。
- 環境: 晴天(有陰影和過曝)、陰天、夜晚(大量動態模糊)、室內。
- 幀率: 大部分是 30 FPS,也有 25 和 14 FPS 的影片。
依原論文 Table 2 的統計,訓練集共 5,316 幀、512 條軌跡、110,407 個行人框,平均每幀 20.8 人;測試集共 5,919 幀、830 條軌跡、182,326 個行人框,平均每幀 30.8 人。
這份統計還藏了一個值得注意的地方。測試集裡的 MOT16-03 是一段夜間的俯瞰人群,平均每幀 69.7 人,單是這一段就有 104,556 個行人框,占整個測試集的 57%。MOTA 是把所有序列串在一起計算的,所以這一段的表現,會大幅左右整體分數。
誰該被追?
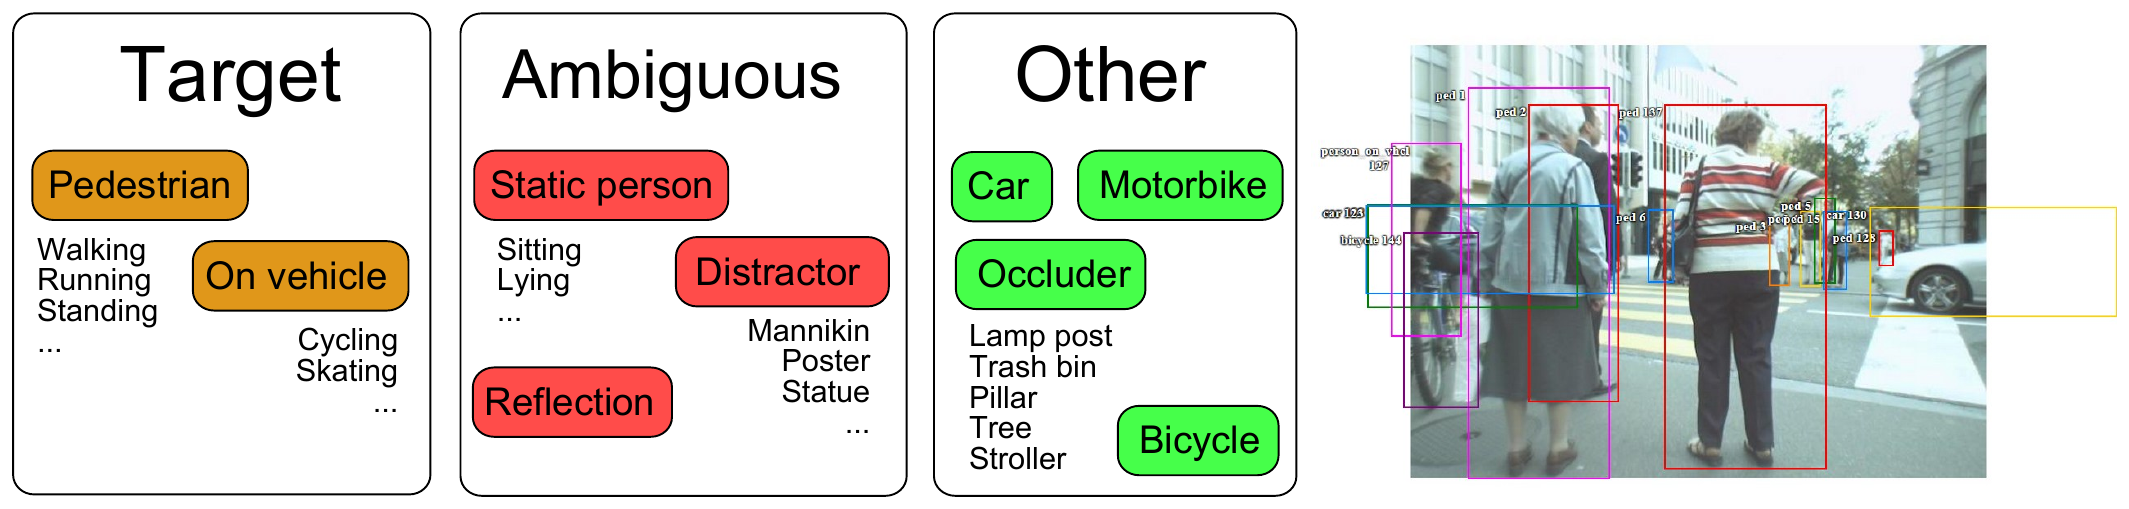
所有序列都由研究人員按照同一套規則從頭重新標註,再交叉檢查。規則的核心是把「像人的東西」分成三組:
- 目標: 所有直立的人,不管是走路、跑步還是站著。這是追蹤器要追的對象。
- 模糊類別: 不是直立姿勢的人(坐著、躺著),以及各種人的「替身」,包括倒影、海報、照片、假人模特兒,還有玻璃後面的人。
- 其他: 移動中的車輛、機車、腳踏車、嬰兒車,以及柱子、樹這類遮擋物。
第二組是這篇論文很聰明的地方。偵測器看到海報上的人,很可能也會框出來;追蹤器乖乖地追了這個框,算不算錯?MOT16 的回答是,這些情況不罰也不獎。評估時,和干擾物、靜止的人、倒影、騎在車上的人重疊超過 50% 的預測框會直接被移除,既不算誤報,沒追到也不算漏檢。
第三組雖然不參與評估,但標出來可以拿來訓練,也可以用來計算每個行人被擋住了多少。
框本身也有規則:
- 框要包住這個人的所有像素,同時盡可能緊。 側面走路的人,框的寬度會隨步伐週期變化;被擋住的部分,要依身高、影子、前後幀等線索推估完整範圍;被畫面邊緣切掉的人,框可以延伸到畫面外。
- 能確定位置就開始標,大約露出一成就開始;確定不了就結束。
- ID 盡量維持。 只要這個人還在畫面裡、路徑能清楚判斷,就維持同一個 ID;被擋住時,只要用等速度這類簡單推理就能確定位置,也要繼續標。擋得太久、看不出路徑,再出現時給新的 ID。
- 每個框都有可見度。 不用人工標,而是用地面假設和所有框的位置自動算出來,從 0 到 1。
最後還有一道「健全性檢查」,用行人偵測器把所有影片跑一遍,把偵測器信心很高、標註卻漏掉的人或干擾物補上。
這套規則後來影響很深。我們在 Tracktor 那篇看到的可見度分析、CenterTrack 和 ByteTrack 特別處理的「框超出畫面」問題,都來自這裡。
官方偵測與資料格式
作者測試了幾種行人偵測器,最後提供 DPM v5 的偵測結果作為官方的公用偵測。原因是當時現成的 R-CNN 除了「人」這一類,其他類別都比 DPM 好,偏偏行人偵測輸給 DPM。為了讓召回率高一點,偵測門檻設得很低。
所有標註和偵測都是逗號分隔的文字檔,每一列一個框,九個欄位依序是幀號、ID、框左上角的 x 與 y、寬、高、信心分數(標註檔裡改成「是否納入評估」的旗標),最後兩欄在標註檔裡是類別和可見度。偵測檔的 ID 一律填 −1,因為還沒有被追蹤。
這個格式一直用到今天。你在 GitHub 上看到追蹤器把結果寫成一行一行的 frame,id,x,y,w,h,...,十之八九就是在對齊 MOTChallenge。
評估怎麼算
評估沿用 CLEAR MOT(MOTA、MOTP)和 Wu 與 Nevatia 提出的軌跡品質指標(MT、ML、FM)。重點是把每個細節說清楚。
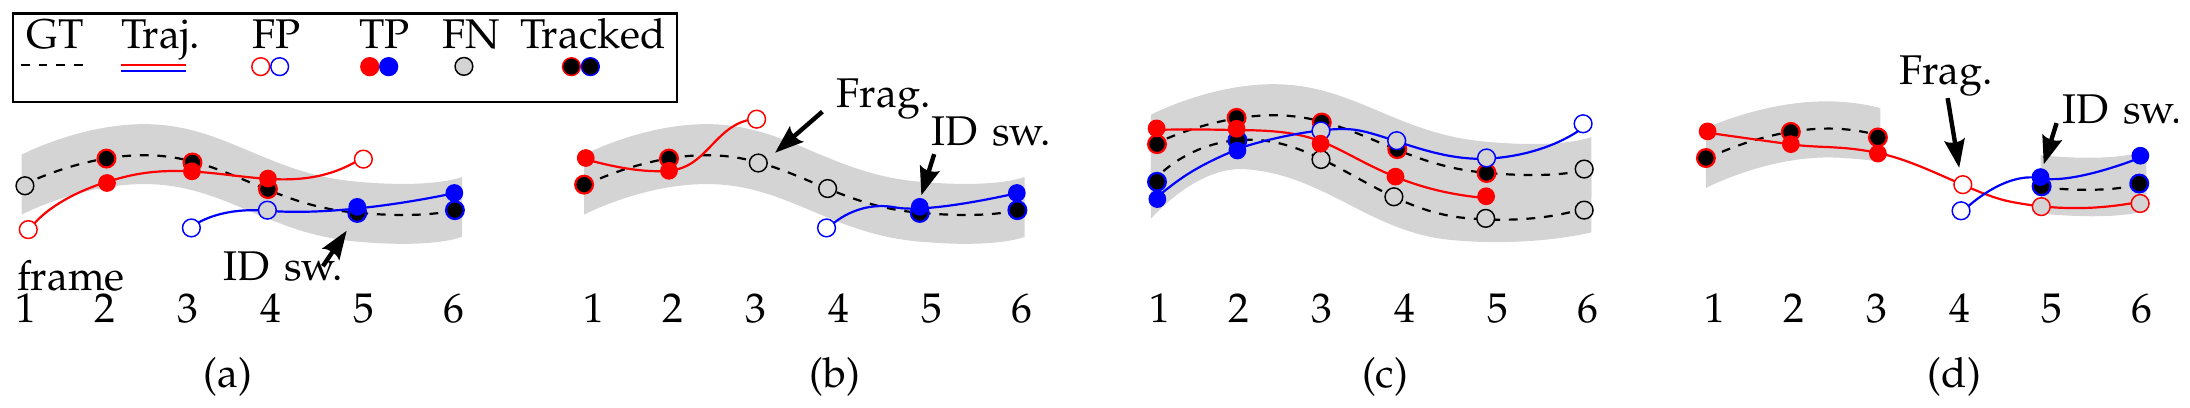
配對。 每一幀用匈牙利演算法把預測框和真實框一對一配對,IoU 門檻是 50%。但配對不是每一幀各自獨立做。如果某個真實目標在上一幀配給了軌跡 ,這一幀和 的距離仍在門檻內,就沿用這個配對,就算旁邊有更近的預測框也一樣。
ID 切換。 一個真實目標這一次配到的軌跡,和它上一次配到的軌跡不同,就算一次 ID 切換(IDSW)。作者特別提醒,追到兩倍軌跡的方法,ID 切換次數自然也會比較多,所以另外報告 ID 切換除以召回率的相對數字。
斷裂。 一條真實軌跡從「有追到」變成「沒追到」,之後又被追回來,算一次斷裂(FM)。
MOTA 與 MOTP。 MOTA 把漏檢、誤報和 ID 切換加總,除以真實框總數再用 1 去減,範圍是負無限大到 100%,錯太多時可以是負的。MOTP 是所有配上的框的平均重疊,作者直接說明,它主要反映偵測器的定位精度,對追蹤器本身的表現說明不多。
MT 與 ML。 一條真實軌跡有 80% 以上的時間被追到,算「大部分追到」;不到 20%,算「大部分跟丟」。這兩個指標不管 ID 有沒有換過。
所有測試序列串在一起計算,不是各自算完再平均,因為各序列的人數差太多了。
作者也坦白說明這些指標的限制。MOTA 把三種錯誤合成一個數字,好處是方便比較,但「它是否能單獨作為唯一的指標,非常值得爭論」。作者也說明,這套評估並不處理重新辨識。目標離開畫面再回來,就被當成新的目標。
討論
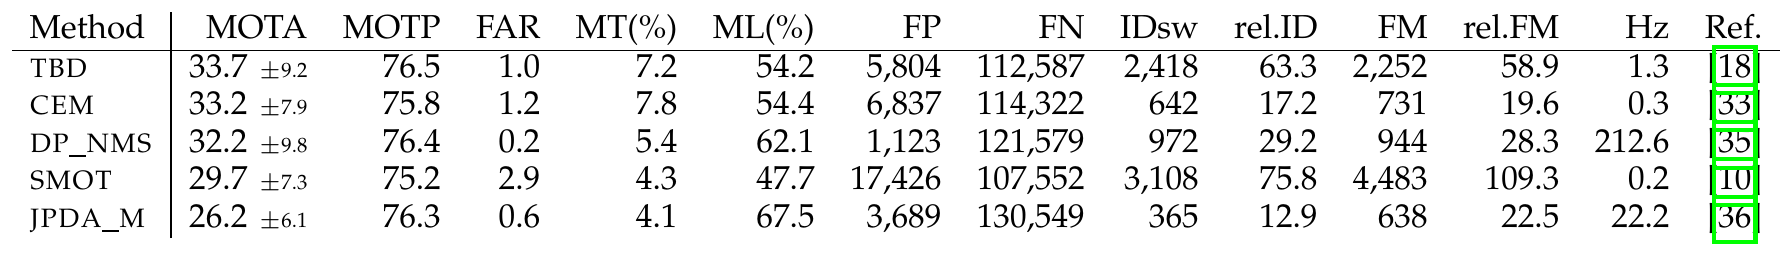
作者用公開的程式碼重跑了五個當時常見的方法,涵蓋網路流(DP_NMS)、連續能量最小化(CEM)、運動相似度(SMOT)、兩階段配對(TBD)和近似的聯合機率資料關聯(JPDA_M)。
參數怎麼調,作者也寫清楚了。從作者建議的預設值出發,每個參數在 之間隨機取樣,在訓練集上跑 20 次,挑 MOTA 最高的那組,只在測試集上跑一次。作者也聲明,這些數字未必是各方法的最佳表現。
結果有三個地方值得看:
- MOTA 最高也只有三十出頭。 最好的 TBD 是 33.7,最差的 JPDA_M 是 26.2。
- 大部分人都跟丟了。 每個方法的 ML 都在 47% 以上,FN 都超過十萬。也就是說,偵測沒找到的人,追蹤器也救不回來,而官方的 DPM 偵測漏掉了很多人。
- 速度差了一千倍。 DP_NMS 每秒 212.6 幀,SMOT 只有 0.2 幀。準確度差不多的方法,速度可以差到這種程度。
把這張表和後來的論文對照,就能看到偵測器的影響有多大。一年後,DeepSORT 換上一組品質好得多的私有偵測,在同一個 MOT16 測試集上拿到 61.4 的 MOTA;再過幾年,FairMOT 是 74.9。追蹤方法當然進步了,但從三十多分一路跳到七十多分,大部分的功勞屬於偵測器。
後來
2017 年,MOTChallenge 推出 MOT17。影片和 MOT16 完全相同,但標註再修正過一輪,官方偵測也從只有 DPM 一組,增加成 DPM、Faster R-CNN、SDP 三組,參賽者要用三組偵測各跑一次,再把結果平均。我們在 Tracktor 那篇看到的「public detection」賽道,就是在這個設定上比賽。
2020 年的 MOT20 則把擁擠程度推到極限,依 ByteTrack 論文的統計,測試集平均每幀有 170 人。同一年,Leal-Taixé 等 MOTChallenge 的維護者也參與提出 HOTA,正式回應了這篇論文裡那句「MOTA 能否單獨作為唯一指標,非常值得爭論」。
結論
MOT16 給了多目標追蹤 14 段新影片、一套從頭重做的標註規則,以及一套把配對、ID 切換、斷裂都定義清楚的評估方式。它最精細的設計,是把倒影、海報、坐著的人放進「不罰也不獎」的模糊類別,讓追蹤器不會因為偵測器的合理反應而被扣分。
下次在論文表格裡看到 MOT17 的數字,可以先問,用的是公用偵測還是自己的偵測?再想想測試集的 MOTA 裡,MOT16-03 那段夜間人群占了多少分量。
至於哪些人該被追,十年後大家還在用這篇論文的答案。