原論文
Simple Online and Realtime Tracking with a Deep Association Metric
- 発表先
- ICIP 2017国際会議
- arXiv への初回投稿
- arXiv:1703.07402
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingdeepsort2017,
  title = {{Simple Online and Realtime Tracking with a Deep Association Metric}},
  author = {Nicolai Wojke and Alex Bewley and Dietrich Paulus},
  year = {2017},
  eprint = {1703.07402},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1703.07402}
}
SORT はトラッカーを、カルマンフィルタ、IoU、ハンガリアン法だけになるまで削ぎ落とした。速度は抜群で、MOTA も悪くない。だが ID スイッチの回数は、ずっと見栄えが悪かった。
原因は想像がつく。SORT が見ているのはボックスの位置と大きさだけで、物体が 2 フレーム隠れると軌跡は削除される。再び現れたとき、トラッカーには「この人はさっき見た」とわかる手がかりが何もなく、新しい ID を発行するしかない。
一年後、SORT の著者 Alex Bewley が、ドイツのコブレンツ・ランダウ大学の Nicolai Wojke、Dietrich Paulus とともにこの穴を埋めた。埋め方は単純明快で、各人がどんな見た目をしているかをトラッカーに覚えさせる。
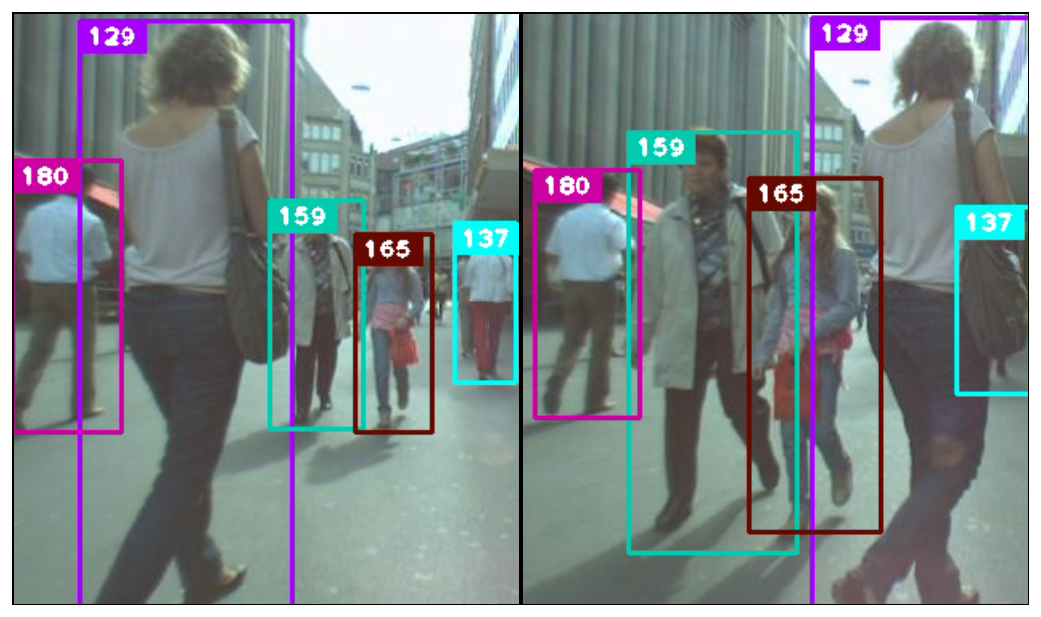
これが MOT16 での DeepSORT の出力だ。二枚の図のあいだで人々は互いに入り交じり、手前の 129 は画面の中央から右へ歩いて、後ろの 137 を隠している。奥の 159 と 165 は近づいてきて、ボックスが何倍にも大きくなった。それでも五人の番号は一つも変わっていない。
この論文はたった 5 ページなのに、その後何年にもわたって最もよく使われるトラッカーになった。名前の「Deep」もよく誤解されている。順に見ていこう。
問題の定義
著者らはまず、SORT の ID スイッチの原因を突き止めた。SORT は予測ボックスと検出ボックスの IoU でマッチングするが、この尺度が信頼できるのは状態推定が正確なときだけだ。
物体が隠れると、カルマンフィルタは予測を続けるしかなく、更新ができない。予測ボックスはどんどんずれていき、再び現れた検出ボックスと重ならなくなる。正面から撮った街の風景では、歩行者同士が隠し合うのは日常茶飯事で、そのため SORT は何度も途切れ、ID を発行し直す。
これを解決するには、位置が当てにならないときでも使える手がかりが要る。著者らが選んだのは外観だ。大規模な人物再識別(person re-identification, re-ID)データセットで訓練済みの畳み込みネットワークを使い、各検出ボックスを一つの特徴ベクトルに変換する。同じ人の異なる時点の特徴は近く、違う人の特徴は遠くなるはずだ。
設計は SORT の精神を受け継ぎ、複雑な部分をオフラインの段階に追いやっている。ネットワークは事前に訓練しておき、オンラインで追跡するときは最近傍の検索だけを行い、オンライン学習は一切しない。
問題を解く
状態と軌跡の管理
カルマンフィルタの枠組みはおおむね SORT を引き継いでいるが、状態は八次元になった。
はボックスの中心、 はアスペクト比、 は高さで、後ろの四項はそれぞれに対応する速度だ。SORT と比べると、面積が高さに置き換わり、アスペクト比にも独自の速度ができた。検出ボックスの をそのまま観測として使う。
各軌跡 はカウンタ を持ち、最後にマッチングに成功してから何フレーム経ったかを記録する。予測のたびに 1 を足し、マッチングに成功したら 0 に戻す。上限 を超えたら物体が画面から出たとみなし、軌跡を削除する。
新しい軌跡の最初の 3 フレームは「試用期間」(tentative)だ。この 3 フレームでは毎フレームマッチングに成功しなければならず、失敗したら即座に削除される。3 フレームを乗り切ってはじめて、確定(confirmed)の状態に移る。
SORT の は 1 だったが、ここでの は実験で 30 に設定されている。軌跡は丸 1 秒の消失を耐えられる。ただし、戻ってきたときに見分けられればの話だ。
二種類の距離
マッチングは依然として割当問題だが、コスト行列は二種類の距離の組み合わせになった。
一つ目はマハラノビス距離(Mahalanobis distance)で、運動を表す。
は 番目の軌跡の予測分布を観測空間に射影した平均と共分散で、 は 番目の検出ボックスだ。IoU と違い、マハラノビス距離は不確かさを考慮する。測っているのは、検出ボックスが予測の中心から「標準偏差いくつぶん」離れているかだ。
この距離は、ありえない対応を除外するのに使える。観測空間は四次元で、マハラノビス距離の二乗は自由度 4 のカイ二乗分布に従う。95% 信頼区間のしきい値 を取り、これを超えたらマッチングを認めない。
二つ目は外観の距離だ。各検出ボックスはネットワークを通って単位長の特徴 になる。各軌跡は直近 100 回のマッチング成功時の特徴を保持して、ギャラリー を作る。外観の距離には、検出の特徴とギャラリーの中で最も似ている一つとのコサイン距離を使う。
最小値を取る利点は、人が振り向いたり、影に入ったりしても、ギャラリーに角度の近い特徴が一枚あれば見分けられることだ。外観の距離にも独自のしきい値 があり、別の訓練データで決める。公式のコードのデフォルトは 0.2 だ。
二つを合わせたものが最終的なコストになる。
そして、ある対応が実行可能とみなされるのは、二つのしきい値を両方とも通ったときだけだ。
二つの役割分担について、著者らははっきり書いている。マハラノビス距離は短期の予測に向き、物体がついさっき見えていて位置がはっきりしているときに最も役立つ。外観の距離は長時間の遮蔽のあとで身元を取り戻すのに向いていて、そのころには運動の情報にはもうほとんど識別力がない。
そして、よく見落とされる細部がある。実験では、著者らは を 0 にしている。
つまり、コスト行列に残るのは外観の距離だけで、マハラノビス距離はしきい値としてだけ働き、位置的にありえない対応を締め出す。著者らの理由は、カメラが大きく動くと画像平面上の変位が大きく変わり、カルマンフィルタの予測は大まかな推定にすぎなくなる、というものだ。多くの解説が DeepSORT を「位置と外観の重み付き和」と説明しているが、論文が実際にスコアを出したのは「外観で順位をつけ、運動で門番をする」構成だ。
マッチングカスケード
著者らは、すべての軌跡と検出ボックスを一つの割当問題に放り込むのではなく、カスケード(matching cascade)を設計した。
なぜそうするのか? 問題はマハラノビス距離そのものにある。一次元の数字で一度計算してみよう(数字は説明のために置いたものだ)。
軌跡 A は前のフレームで見えたばかりで、予測位置は 100、標準偏差は 5 だとする。軌跡 B はもう十数フレーム隠れていて、予測位置は 120 だが、ずっと更新されていないので標準偏差は 30 まで膨らんでいる。ここで、検出ボックスが 108 に現れた。
- A から見ると、検出ボックスは 8 離れていて、 標準偏差、マハラノビス距離の二乗は 2.56。
- B から見ると、検出ボックスは 12 離れているが、 標準偏差にすぎず、マハラノビス距離の二乗は 0.16。
距離が近く、状態もはっきりしている A のほうが、かえって負けてしまう。
直感的には、軌跡が長く見えていないほど、それがどの検出ボックスと関係するのかはわからなくなるはずで、距離は大きくなるべきだ。ところがマハラノビス距離は標準偏差を単位にするので、不確かさが大きいほど、どの検出ボックスも「近く」見える。二本の軌跡が同じボックスを奪い合うとき、最も不確かなほうをひいきしてしまう。
カスケードのやり方は、「どれだけ長く見えていないか」で層に分けて処理することだ。
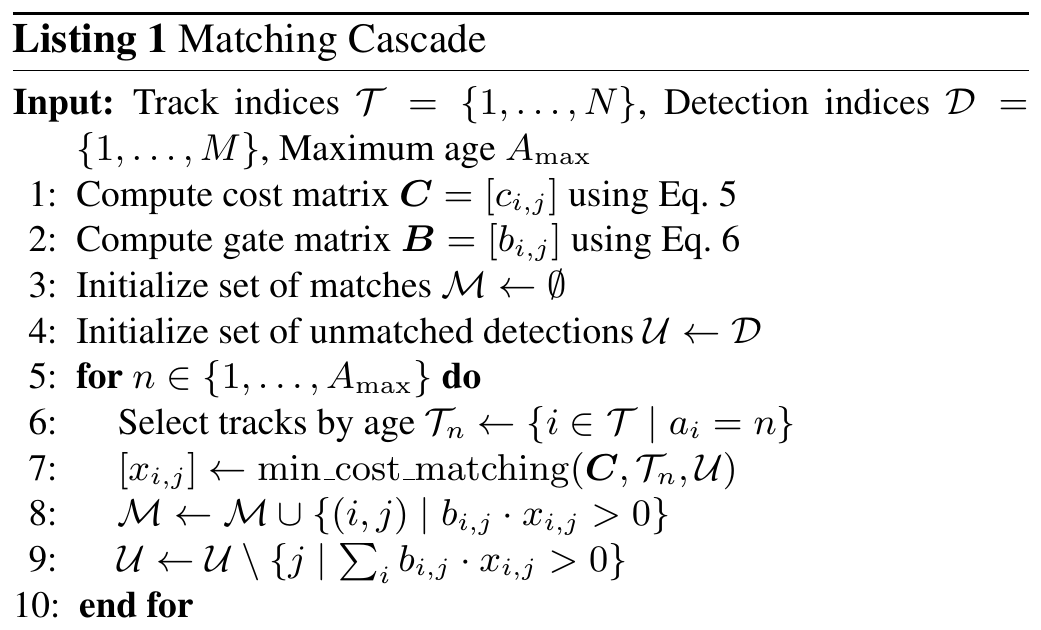
5 行目のループは から始まり、前のフレームでマッチングに成功したばかりの軌跡を先に処理して、検出ボックスを先に選ばせる。残った検出ボックスを の軌跡に回し、以下同様に まで続ける。さっきの例なら、A が第一層で検出ボックスを取ってしまい、B には順番すら回ってこない。
カスケードが終わったあと、最後にもう一段階ある。試用期間中の軌跡と、年齢 なのに対応しなかった軌跡を、残った検出ボックスと SORT 流の IoU マッチングにかける。これは外観が急に変わった場合、たとえば静止した物体に半身が隠れた場合に対処するためのもので、作られたばかりで外観のギャラリーがまだ乏しい軌跡にも、続いていくチャンスを与える。
外観ネットワーク
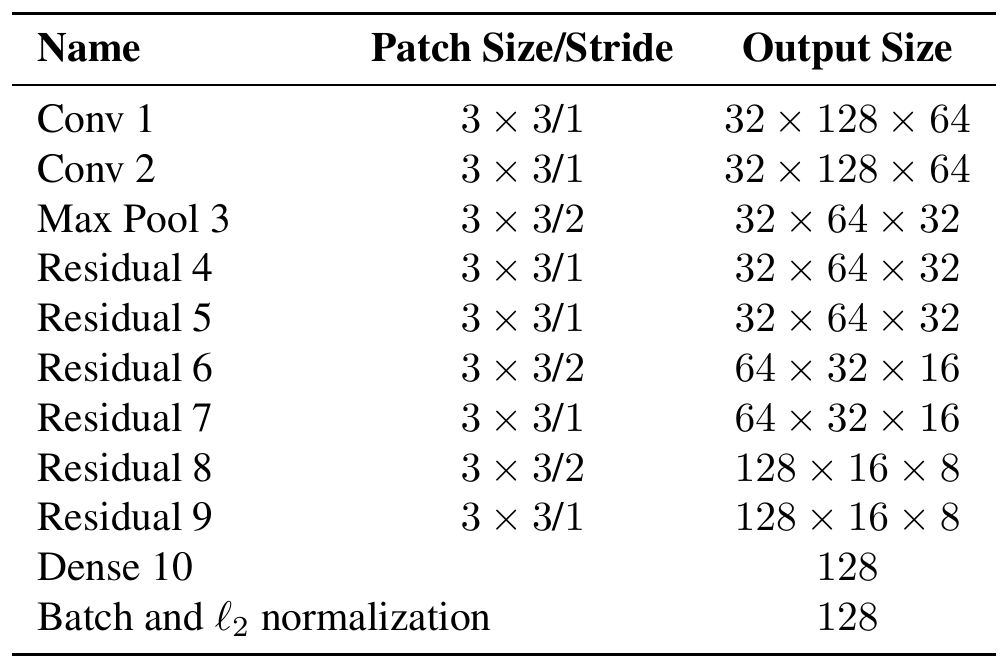
ネットワークはワイド残差ネットワークで、畳み込み二層、残差ブロック六つ、最後の全結合層が 128 次元を出力する。末尾のバッチ正規化と L2 正規化が特徴を単位球面に射影するので、二つの特徴の内積はそのままコサイン類似度になり、先ほどの外観の距離にぴったり合う。
ネットワーク全体は約 280 万パラメータで、ノート PC 向けの GTX 1050 GPU 一枚で、32 個のボックスを一度に処理して約 30 ミリ秒かかる。訓練データは MARS 人物再識別データセットで、110 万枚を超える画像、1,261 人ぶんだ。
訓練の詳細は論文に書かれておらず、著者らは範囲外だとしている。公式のコードの説明は、翌年の別の論文の cosine metric learning の手法を参照するよう案内している。
議論
著者らは MOT16 テストセットで評価した。MOT16 には 7 本のテスト動画があり、移動カメラで正面から撮った街の風景もあれば、見下ろしの監視カメラの映像もある。
検出結果には、Yu ら(POI という手法の著者)が公開した Faster R-CNN の検出を使った。公開データと非公開データで訓練されていて、品質は公式に提供された公開検出よりはるかに高い。公平を期すため、著者らは同じ検出を使って SORT も走らせ直した。設定は 、、検出の信頼度スコアのしきい値は 0.3 だ。
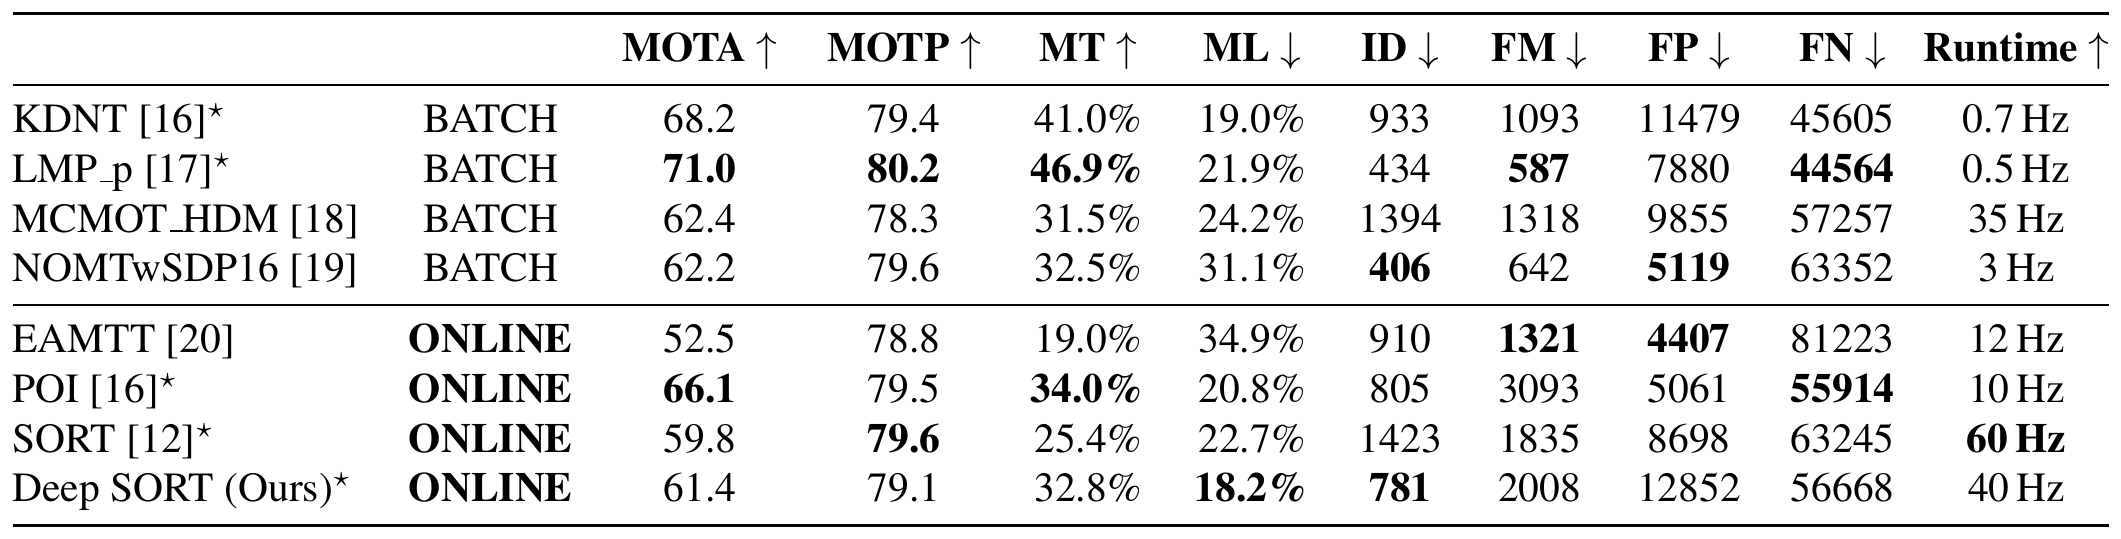
この表で星印のついた手法は、どれも同じ POI の検出を使っている。まず SORT と Deep SORT の二行を比べよう。この二つの差だけが、純粋にトラッカーから来ているからだ。
- ID スイッチは 1423 から 781 に減った。約 45% の減少だ。外観を加えたことによる最大の収穫で、online のグループで最も少ない。
- MT は 25.4% から 32.8% に上がり、ML は 22.7% から 18.2% に下がった。身元を保てる時間が長くなり、ほとんどの期間で追えた軌跡が増え、ほとんど見失った軌跡が減った。
- FM は 1835 から 2008 に増えた。著者らの説明では、軌跡が遮蔽や検出漏れを乗り切るようになったので、あいだの空いた数フレームが途切れ 1 回として数えられるのだという。
- FP は 8698 から 12852 に増えた。これが、MOTA が 59.8 から 61.4 にしか上がらなかった主な原因だ。
最後の点はもう少し見ておく価値がある。著者らが出力を確かめたところ、増えた誤検出の大半は、静止した背景で検出器がときどき出す誤判定から来ていた。 のおかげで軌跡は長く生き延びるので、こうした散発的な誤検出が軌跡に取り込まれ、その場から動かない安定した偽の軌跡が何本もできてしまう。著者らは、軌跡が誤検出のあいだを飛び移ることはめったにないことも観察している。言い換えると、これらの誤検出は主に MOTA を下げているだけで、身元の維持にはあまり害がない。検出のしきい値を上げれば MOTA は大きく改善するかもしれないが、論文はその結果を報告していない。
同じく POI の検出を使う POI の手法と比べると、Deep SORT は MOTA が 5 ポイント近く低く、ID スイッチはわずかに少なく(781 対 805)、速度は何倍も速い。
速度については、表には 40 Hz とある。著者らは本文で、実装全体はおよそ 20 Hz で、その半分近くの時間は外観特徴の生成に費やされていると述べている。どちらの数字も、検出器そのものは含まない。
その後
DeepSORT はコードが単純で、特徴ネットワークをそのまま差し替えられることから、すぐにエンジニアリングのプロジェクトの標準装備になった。MATLAB には公式のサンプルがあり、GitHub の「YOLO + DeepSORT」の組み合わせのプロジェクトに至っては数えきれない。
五年後、StrongSORT はこれを改修の出発点にして、外観ネットワークとカルマンフィルタを替え、マッチングカスケードも外して、単一の大域的な割当に戻した。彼らのアブレーションによると、カスケードは弱めのトラッカーには役立ち、誤った対応を減らせるが、トラッカーが強くなると、かえって足かせになる。StrongSORT の表では、元の DeepSORT を通常のマッチングに替えると IDF1 が 1.1 下がった。段階的に強化していくと、カスケードを外す利点はどんどんはっきりし、最も強い二つの版ではそれぞれ 1.8 と 1.4 上がった。
DeepSORT の設計が否定されたのではない。カスケードが扱っていた問題(不確かな軌跡がマハラノビス距離で得をすること)は、外観特徴が十分に強くなり、コスト行列がもはやマハラノビス距離中心でなくなると、それほど深刻ではなくなる。
結論
オフラインで訓練した外観ネットワークと、軌跡の年齢で層に分けたマッチングカスケードだけで、MOT16 の ID スイッチは 45% 減った。軌跡は丸 1 秒の消失を耐え、追跡そのものは毎秒数十フレームを保っている。
その「Deep」は外観特徴にしかない。運動モデルも、マッチングも、軌跡の管理も、どれもまだ手作りのルールだ。だから、もっと良い re-ID ネットワークに替えるのが、たいていいちばん安上がりなアップグレードになる。
そうそう、DeepSORT で歩行者以外のものを追うなら、MARS で訓練したあの特徴ネットワークは忘れずに替えておくこと。千人あまりの歩行者は見分けられても、あなたのトラックは見分けられない。