原論文
Deep OC-SORT: Multi-Pedestrian Tracking by Adaptive Re-Identification
- 発表先
- ICIP 2023国際会議
- arXiv への初回投稿
- arXiv:2302.11813
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingdeepocsort2023,
  title = {{Deep OC-SORT: Multi-Pedestrian Tracking by Adaptive Re-Identification}},
  author = {Gerard Maggiolino and Adnan Ahmad and Jinkun Cao and Kris Kitani},
  year = {2023},
  eprint = {2302.11813},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.11813}
}
2022 年前後、運動による関連付けに頼るトラッカーがまた脚光を浴びた。
検出器はますます強くなり、ByteTrack はカルマンフィルタと IoU だけで、外観特徴を学習する多くの手法を MOT17 で打ち負かした。OC-SORT は遮蔽の後にカルマンフィルタの誤差が溜まる問題を修正し、DanceTrack のように外観で見分けにくく動きも複雑な場面でも、さまざまな re-ID 手法を上回った。
だが外観の手がかりは役に立たないのではなく、使いこなしにくいだけだ。BoT-SORT や StrongSORT も外観を戻してきたが、やり方はどれもごく単純だった。軌跡の外観特徴は固定の重みの指数移動平均で更新し、外観距離をさらに固定の重みで運動のコストに足す。
カーネギーメロン大学の Gerard Maggiolino、Adnan Ahmad と、OC-SORT の著者である Jinkun Cao、Kris Kitani は、OC-SORT に外観を加え、外観特徴が当てにならないときは控えめに、当てになるときは多めに使えるようにしたいと考えた。
OC-SORT に深層の外観特徴を加えたものなので、Deep OC-SORT と呼ぶ。著者らは、これは DeepSORT が SORT に対してやったことをそのまま繰り返したものではないと、わざわざ断っている。
問題の定義
ボックスから抽出した外観特徴は、re-ID モデルがどれだけ強くても、ノイズが多い。人が半分隠れている、動きが速すぎてぼやける、すぐ隣にたまたま似た服装の人がいる、といった具合だ。
従来のやり方には、決め打ちになっている箇所が二つある。
- 更新の重みが固定。 指数移動平均の重み は定数で、そのフレームの検出の質がどうであれ、新しい特徴は同じ割合で軌跡の外観モデルに混ぜ込まれる。半分隠れたボックスでも、そのまま軌跡の外観を汚してしまう。
- 融合の重みが固定。 外観のコストは、決まった割合で運動のコストに足される。ある検出がある軌跡にとりわけよく似ていて、ほかの軌跡には似ていない場合も、ある検出がいくつもの軌跡に同じくらい似ている場合も、外観のコストの比重は同じになる。
著者らは、この二つの重みをどちらも状況に応じて調整できるようにしたい。さらに、OC-SORT は検出の位置に強く頼っていて、カメラが動くと位置も一緒に乱れるので、カメラ運動補償も加える。
問題を解く
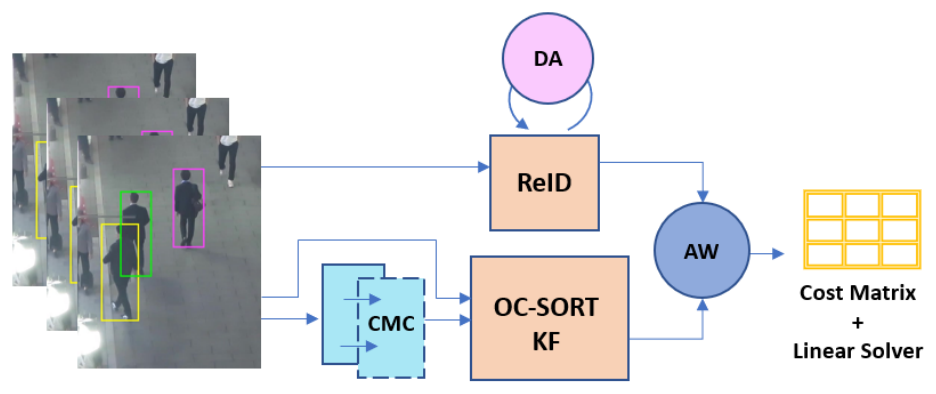
Deep OC-SORT は OC-SORT の流れをそっくり引き継いでいる。観測中心のモメンタム(OCM)、観測中心の復帰(OCR)、オンラインでの平滑化(OOS)、そして最後のハンガリアン法だ。新しく加わったモジュールは三つで、カメラ運動補償(CMC)、動的外観(DA)、適応的重み付け(AW)だ。
カメラ運動補償
カメラ運動補償では、OpenCV の VidStab モジュールで隣り合う二フレーム間の相似変換を推定する。まず特徴点を抽出してオプティカルフローを計算し、それから RANSAC で拡大縮小と回転の行列 と平行移動 を求める。
BoT-SORT もカメラ運動補償を行っているが、補正するのはカルマンフィルタの状態だけだ。OC-SORT には過去の観測ボックスを直接使う箇所がほかにもいくつかあり、それらもすべて一緒に補正しなければならない。
- OOS: 物体が再び現れると、OC-SORT は最後の観測から線形補間で仮想の軌跡を作り、カルマンフィルタを更新し直す。最後の観測のボックスの中心は、まず で補正してから補間を始める。
- OCM: OC-SORT は直近 個のボックスから運動の向きを計算する。これらのボックスの左上と右下の角の点は、フレームごとに で補正する。
- OCR: 最後に見えたボックスで見失った軌跡を見つけ直すので、このボックスの位置もフレームごとに補正する。
カルマンフィルタの状態は で、中心位置、面積、縦横比、そして最初の三つの速度だ。補正のしかたは次のとおり。
補正するのは中心位置と中心の速度、そしてそれらの共分散だけだ。理屈の上では、変換の拡大縮小を面積に当てはめ、回転を縦横比の変化として近似することもできる。だが回転した物体の外接ボックスは線形の関係にならず、正確に計算するには物体のマスクが要る。著者らによると、OCM と OCR はこの種の近似にそれなりに耐えるが、カルマンフィルタはずっと敏感なので、中心だけを補正した。補正はカルマンフィルタの予測ステップの前に行う。
動的外観
通常の指数移動平均は次のとおりだ。
はこのフレームでマッチした検出の外観特徴だ。著者らは固定の を、検出の信頼度に応じて変わる に置き換えた。
は検出の信頼度、 はノイズの多い検出を除くための信頼度のしきい値で、 だ。
発想は単純だ。検出の信頼度が低いのは、たいてい物体が遮蔽されているか画像がぼやけているからで、そういうときに抽出した外観特徴も当てにならない。
- 、つまりちょうどしきい値上にあるとき、 となり、新しい特徴は完全に無視される。
- のとき、 となり、新しい特徴は最大の割合で加わる。
- その間の信頼度では、線形に補間される。
はもともとトラッカーのパラメータで、 はもとの固定の そのものだ。動的外観は新しいハイパーパラメータを持ち込まず、計算量もほぼゼロだ。
適応的重み付け
外観のコスト行列 の大きさは で、 本の軌跡と 個の検出からなり、各マスは軌跡と検出のコサイン類似度だ。一般的なやり方では、これを固定の重み で IoU の行列に足す。 だ。
著者らの観察では、外観によるマッチングが信用できるかどうかは、それに「識別力」があるかどうかで決まる。本当の外観のマッチングなら、最高スコアと二番目のスコアの間にはっきりした差がある。ある軌跡がいくつもの検出に同じくらい似ているなら、外観にあまり発言権を与えるべきではない。
第 本目の軌跡について、識別力はその行の最高スコア から二番目のスコア を引いたものと定義し、上限 を設ける。
第 個目の検出についても、同じ方法でその列の を計算する。両者の平均が、そのマスの追加の重みになる。
最終的なコスト行列は次のとおりだ。
著者らはあえて上位二つだけを見て、KL ダイバージェンスのような分布の指標は使わない。後ろに並ぶ低いスコア同士がどれだけ違っていても、今回のマッチングが信用できるかどうかとは関係ないからだ。
実装
検出器は ByteTrack などの手法の YOLOX を引き継ぎ、re-ID モデルは fast-reid の SBS50 だ。
MOT17 と MOT20 では 、。DanceTrack では 、 で、著者らの説明によれば、そこでは外観のほうが IoU より役に立つからだ。
議論
各モジュールの貢献
| 設定 | MOT17 HOTA | MOT17 IDF1 | MOT20 HOTA | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|---|
| OC-SORT | 68.13 | 79.52 | 58.35 | 53.07 | 35.93 |
| +CMC | 69.66 | 82.44 | 58.33 | 53.57 | 36.68 |
| +外観 | 68.59 | 80.18 | 59.10 | 58.03 | 42.37 |
| +外観+DA | 68.65 | 80.45 | 59.16 | 58.36 | 43.00 |
| +外観+DA+CMC | 69.80 | 82.56 | 59.35 | 58.46 | 43.33 |
| すべて(さらに+AW) | 70.20 | 82.78 | 59.45 | 58.53 | 43.41 |
原論文 Table 3 をもとに整理。三つのデータセットの検証セット。「外観」は固定の重みの EMA で更新する外観特徴を指す。MOT20 の IDF1 は順に 74.77、74.63、75.71、75.87、76.11、76.30。
カメラ運動補償 だけを加えると、MOT17 の IDF1 は 3 ポイント近く上がり、DanceTrack でも小幅に改善する。MOT20 は改善しない。MOT20 の動画はどれも固定カメラだからだ。
外観特徴 は DanceTrack で最も大きな一歩だ。固定の EMA の外観を加えるだけで、HOTA は 53.07 から 58.03 に跳ね上がり、AssA は 6 ポイント以上上がる。
動的外観 と 適応的重み付け による改善はどちらも大きくないが、三つのデータセット、すべての指標でプラスになっている。
DanceTrack で外観は結局役に立つのか
この結果は、DanceTrack の論文の発見とはかなり違う。DanceTrack の著者らが YOLOX の検出を固定して関連付けの手法だけを比べたとき、DeepSORT は SORT より悪く、外観を加えるとかえって悪化した。正解ボックスを使った oracle 実験でも同じで、外観を加えるとすべての指標が下がった。
Jinkun Cao は両方の論文に名を連ねている。OC-SORT を土台にすると、外観はむしろ DanceTrack で最も改善をもたらす構成要素になった。
二つの論文の設定は大きく違い、re-ID モデルも運動モデルも異なる。DanceTrack の論文の DeepSORT は、遮蔽の後に狂いやすい SORT の運動モデルの上で、外観をマッチングの主な根拠にしている。Deep OC-SORT は外観を IoU に添える補助的なコストとして、もともと安定した運動ベースのトラッカーに加えている。ダンサーはよく似ているが、まったく同じではない。使い方さえ正しければ、外観からはまだ情報を搾り取れる。
テストセット
| データセット | 手法 | HOTA | MOTA | IDF1 | ID スイッチ | AssA |
|---|---|---|---|---|---|---|
| MOT17 | OC-SORT | 63.2 | 78.0 | 77.5 | 1,950 | 63.2 |
| MOT17 | StrongSORT++(オフライン) | 64.4 | 79.6 | 79.5 | 1,194 | 64.4 |
| MOT17 | Deep OC-SORT | 64.9 | 79.4 | 80.6 | 1,023 | 65.9 |
| MOT20 | OC-SORT | 62.1 | 75.5 | 75.9 | 913 | 62.0 |
| MOT20 | StrongSORT++(オフライン) | 62.6 | 73.8 | 77.0 | 770 | 64.0 |
| MOT20 | Deep OC-SORT | 63.9 | 75.6 | 79.2 | 779 | 65.7 |
原論文 Table 1 をもとに整理。MOT17 と MOT20 のテストセット。
MOT17 では、Deep OC-SORT の HOTA は 64.9 で、当時のリーダーボードで二位だった。MOT20 では 63.9 で一位だ。OC-SORT と比べると、MOT17 での ID スイッチはほぼ半分に減った。
StrongSORT++ はオフラインの後処理(AFLink、GSI)を使っているが、Deep OC-SORT は純粋なオンラインの手法で、それでも関連付けの精度 AssA は StrongSORT++ より高い。
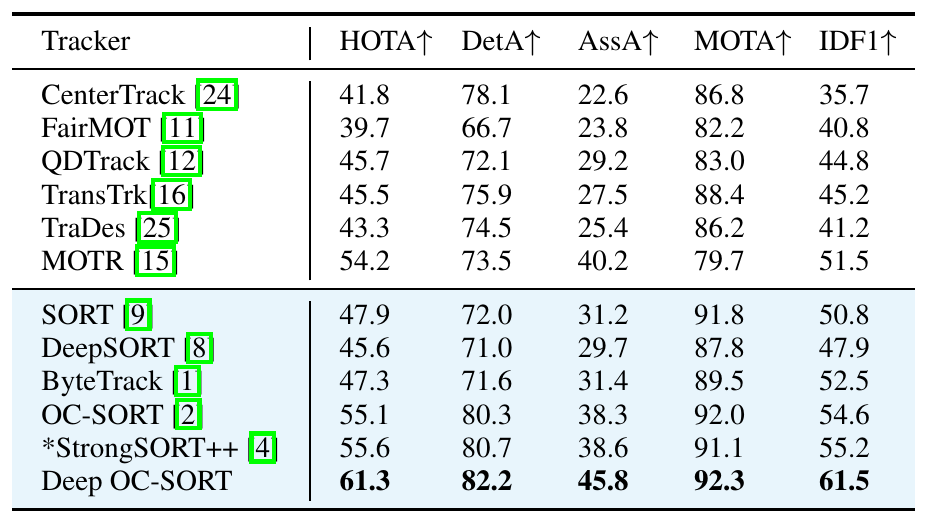
DanceTrack では、同じ YOLOX の検出を使う手法の中で、Deep OC-SORT の HOTA は 61.3 で、OC-SORT より 6.2 ポイント高く、AssA は 38.3 から 45.8 に上がった。DeepSORT は SORT より悪く、Deep OC-SORT は OC-SORT より良い。この二組の対照が同じ表に並んでいることが、外観の加え方の違いをちょうどよく示している。
著者らはこれを、発表済みの手法の中で最良の結果だとしている。ただし三か月前に arXiv に投稿された MOTRv2 は、DanceTrack でずっと高い成績をすでに報告していた。当時はまだ正式に発表されておらず、この表にも入っていない。
限界
これは 4 ページの短い会議論文で、分析の深さには限りがある。
三つの新しいモジュールはどれも人手で設計したルールで、外観の重み と上限 はデータセットごとに別々に調整する必要があり、DanceTrack の設定は MOT17 とかなり違う。論文は速度も報告していない。re-ID モデルが一つ増え、検出ごとに特徴を一回抽出しなければならないので、運動だけの OC-SORT より遅いのは確実だ。
結論
Deep OC-SORT は OC-SORT に外観を戻したが、その戻し方はとても控えめだった。検出の信頼度が低いときは外観を更新せず、外観に識別力がないときは外観の重みを大きくせず、カメラが動いたら使っている古いボックスをすべて一緒に補正する。
どのモジュールも小さいが、合わせると三つのデータセットすべてで安定した改善が得られる。
DanceTrack の論文は、ダンサーの服がかぶっていれば外観は役に立たないと教えてくれた。一年あまり後、同じ著者が DanceTrack で、外観の重みを MOT17 よりも高く設定した。