原論文
MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors
- 発表先
- CVPR 2023国際会議
- arXiv への初回投稿
- arXiv:2211.09791
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmotrv22022,
  title = {{MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors}},
  author = {Yuang Zhang and Tiancai Wang and Xiangyu Zhang},
  year = {2022},
  eprint = {2211.09791},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.09791}
}
MOTR は複数物体追跡を完全なエンドツーエンドにした。トラッククエリが一フレームずつ受け渡され、新しい物体は検出クエリに任され、マッチングも後処理も一切要らない。
DanceTrack では、MOTR の関連付けの能力は当時最高で、AssA は 40.2 と、ByteTrack や OC-SORT のような運動によるマッチングに頼る手法のどれよりも高かった。だが検出がだめだった。DanceTrack での DetA は 73.5 しかなく、OC-SORT の 80.3 より一段低い。MOT17 になると MOTA は 73.4 で、ByteTrack の 80.3 に 7 ポイント近く差をつけられた。
上海交通大学の Yuang Zhang と、曠視の Tiancai Wang、Xiangyu Zhang、つまりもとの MOTR チームのメンバーは、同じデコーダに二つのことを同時に学ばせているのが問題だと考えた。MOTR の中では検出と関連付けが互いに引っ張り合い、その結果、検出がうまく学べない。
それなら、出来合いのとても強い検出器に手伝ってもらおう。
問題の定義
外部の検出器を MOTR につなぐ最も直接的な方法は、TransTrack にならって、トラッククエリにボックスを予測させ、それを IoU で検出器のボックスとマッチングすることだ。
著者らは試してみたが、検出はわずかに改善しただけで、しかも「先に予測し、それからマッチングする」という古いやり方に逆戻りし、MOTR のエンドツーエンドという特性も失われた。
著者らが望んだのは、tracking-by-detection のように検出結果を入力とし、MOTR は関連付けを学ぶことだけに専念すればよい形だ。クエリを中心とした Transformer に、検出結果をどうやって「食べさせる」か。それがこの論文の解く問題だ。
問題を解く
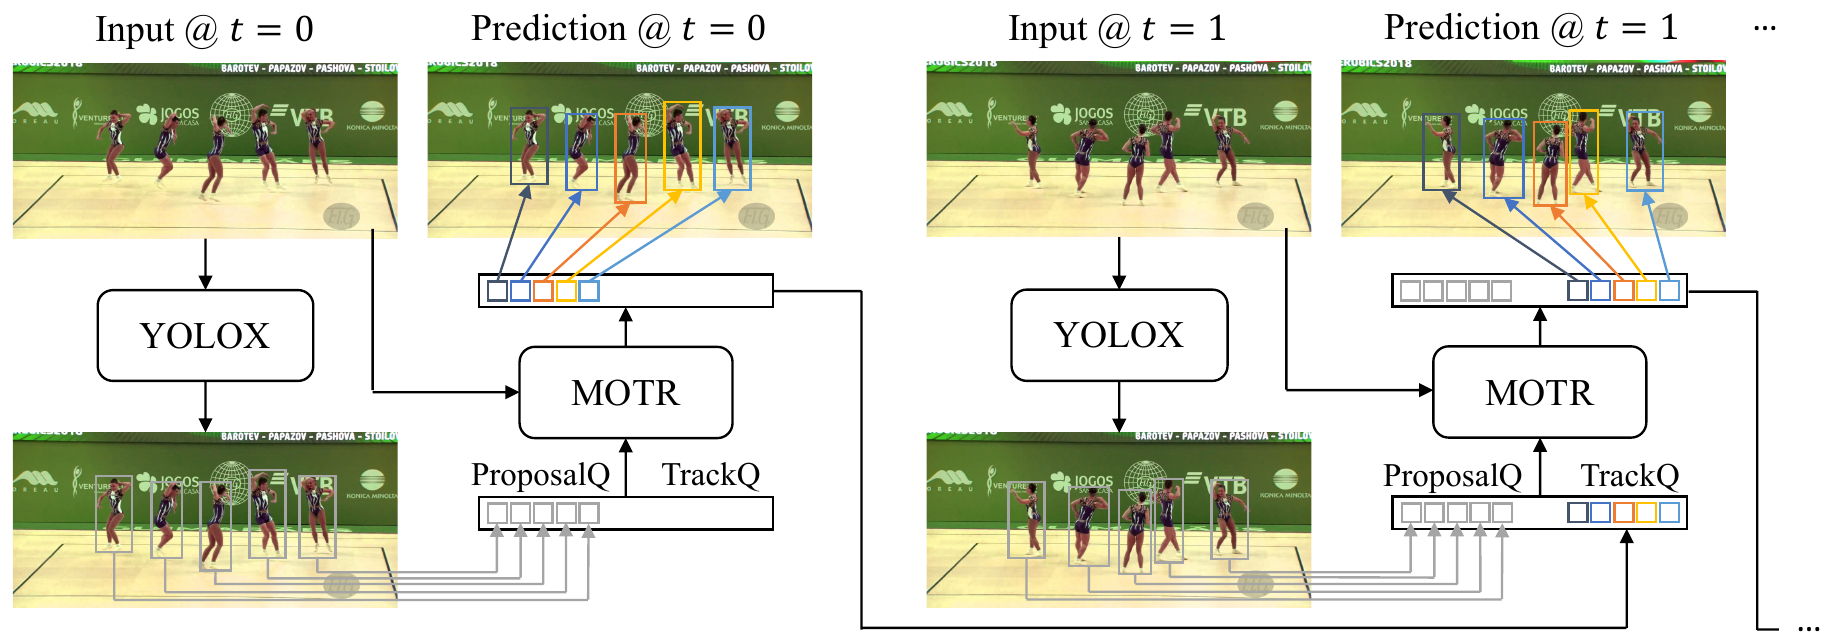
MOTRv2 は、出来合いの YOLOX 検出器と、アンカー型に改めた MOTR からなる。
アンカー型のクエリ
鍵となる一歩は、DAB-DETR のような検出器の発想から来ている。クエリは抽象的な埋め込みであるだけでなく、明示的なアンカーボックス(中心、幅、高さ)も持つ。デコーダはアンカーボックスに対するオフセットを予測すればよいので、検出がずっと容易になる。
著者らは、MOTR の検出クエリとトラッククエリをどちらもこのアンカー型の書き方に改めた。もともと学習可能だった位置埋め込みは、アンカーボックスの座標の sine-cosine エンコーディングに置き換えた。
こうすれば、外部の検出器のボックスをそのままアンカーボックスとして使えるので、検出の事前情報を MOTR に組み込める。
提案クエリ
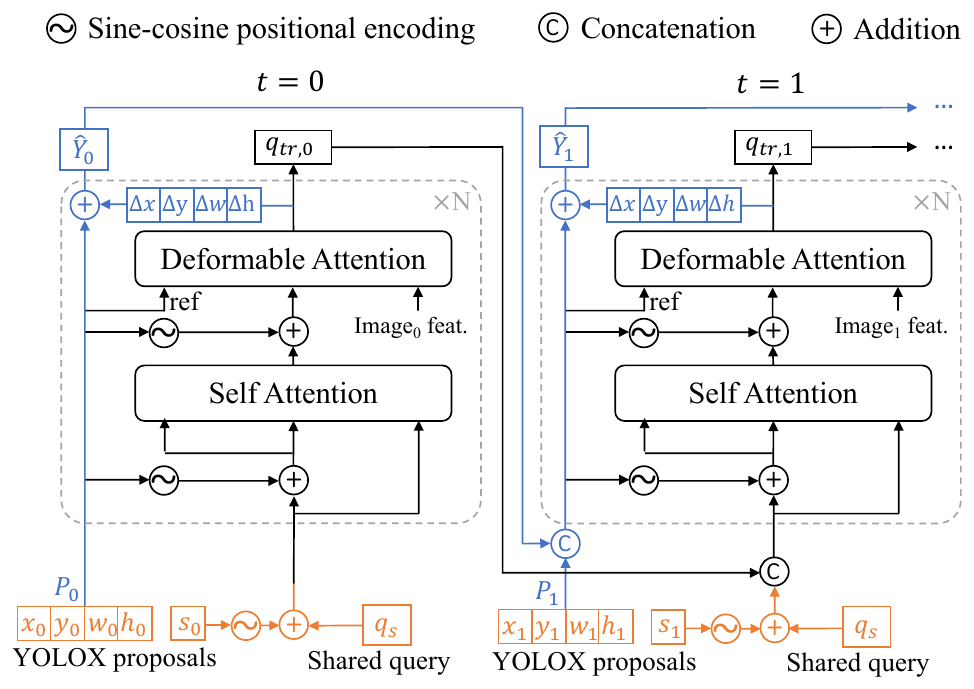
各フレームで、YOLOX は 個の候補ボックスを生成し、各ボックスは中心 、幅と高さ 、信頼度スコア を持つ。物体をできるだけ取りこぼさないよう、信頼度スコアが 0.05 を超えていれば残す。
提案クエリ(proposal query)は三つの段階で作られる。
- 大きさ の学習可能な共有クエリ を、 に複製する。
- 各候補ボックスの信頼度スコア を、sine-cosine エンコーディングで 次元のベクトルにする。
- 両者を足したものが、このフレームの提案クエリになる。候補ボックス自体は、それらのアンカーボックスとして使う。
すべての提案クエリは同じ埋め込みを共有していて、互いの違いはアンカーボックスの位置と信頼度スコアからしか生まれない。さらに、YOLOX が取りこぼした物体を拾うために、学習可能なアンカーボックスを 10 個残してある。
信頼度スコアをエンコードして入れるべきかどうかも、著者らは比べている。スコアをまったく使わないと検証セットの HOTA は 63.0、線形射影を使うと 63.4、sine-cosine エンコーディングを使うと 63.7 だ。信頼度スコアは MOTR にとって役に立つ情報だ。
ボックスの受け渡し
最初のフレームには新しい物体しかない。提案クエリはデコーダを通り、YOLOX のボックスに対するオフセットを出力し、それを足し戻したものが予測ボックス になる。更新されたクエリはトラッククエリ になる。
その後の各フレームでは、前のフレームのトラッククエリ とこのフレームの提案クエリ を連結する。前のフレームの予測ボックス も、このフレームの YOLOX のボックス と連結し、すべてのクエリのアンカーボックスとして使う。
これで役割分担が決まる。提案クエリは新しく現れた物体か、それまで取りこぼされていた物体だけを担当し、トラッククエリはすでに追跡している物体の位置を特定し直すことを担当する。両者の調整は、デコーダの自己注意に任せる。提案クエリはトラッククエリを見て、すでに追跡している人を重複して検出しないようにする。トラッククエリも YOLOX のボックスを参考にして、位置をより正確にできる。
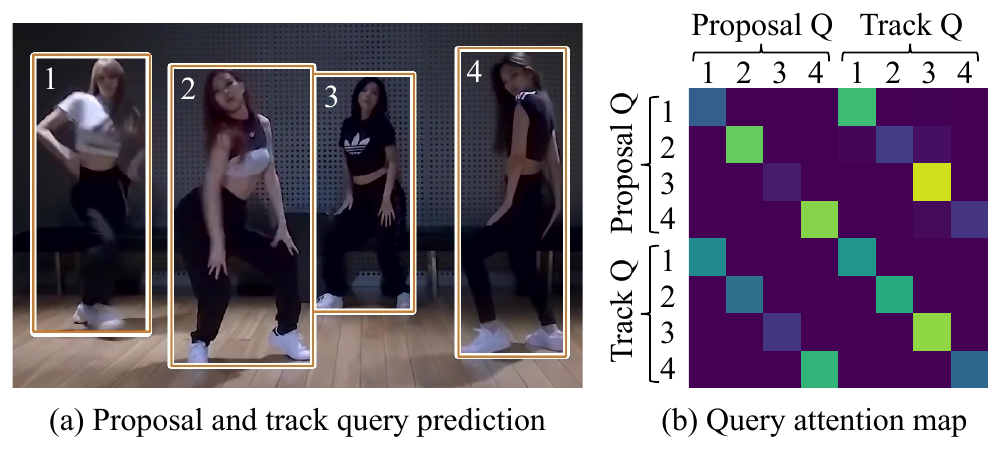
著者らは自己注意マップを描いてみた。同じ人の提案クエリとトラッククエリの間では注意がはっきり高く、両者は確かに情報をやり取りしている。
もとの MOTR は中心点だけを参照点として受け渡していたが、MOTRv2 はボックス全体を受け渡す。著者らはこの二つのやり方を比べている。DanceTrack 検証セットの AssA で見ると、中心点だけを渡すと 49.2、ボックス全体を渡すと 53.1 に上がる。前のフレームのボックスの幅と高さは、関連付けに大いに役立つ。
訓練
訓練では、各クリップは 5 フレームで、フレーム間の間隔は 1 から 10 の間でランダムに選ぶ。
もとの MOTR は、偽のトラッククエリを人為的に差し込んだり、本物をランダムに捨てたりして、誤検出と検出漏れを模擬していた。MOTRv2 はもうそうせず、信頼度スコアが 0.5 より高いトラッククエリをそのまま次へ渡す。訓練中に自然に生じる誤検出と検出漏れこそが、最も現実的なデータ拡張になる。
DanceTrack と MOT17 では、YOLOX 自体はもう訓練せず、DanceTrack と ByteTrack が公式に公開した重みをそのまま使い、訓練の前にすべての画像の候補ボックスを計算しておく。
ほかに訓練の工夫が二つある。
- CrowdHuman を混ぜる。 MOTR と同じく、CrowdHuman の静止画を 5 フレームの疑似動画にし、DanceTrack と一緒に訓練する。
- クエリのデノイジング。 DN-DETR のデノイジングの補助タスクを借りて収束を速める。ただしデフォルトのノイズは大きすぎて、隣り合う二フレーム間の移動よりも大きく、かえって関連付けを損なう。著者らがノイズを小さくすると、DetA が 2.1 ポイント上がった。
議論
一歩ずつ加えていく
| 設定 | 検証セット HOTA | テストセット HOTA |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| + 実装の調整 | 54.8 | |
| + ボックス全体の受け渡し | 57.1 | |
| + YOLOX と CrowdHuman | 63.7 | |
| + クエリのデノイジング | 64.5 | 69.9 |
| + 追加の関連付け、検証セット、アンサンブル | 73.4 |
原論文 Table 5 をもとに整理。DanceTrack。各行は前の行に累積して加えたもの。
MOTR の 54.2 から MOTRv2 の 69.9 まで、テストセットの HOTA は 15.7 ポイント上がった。最も大きな一歩は YOLOX をつなぎ、CrowdHuman を混ぜて訓練したことで、検証セットで一気に 6.6 ポイント上がった。
YOLOX と CrowdHuman のこの一歩を、著者らは別に分解して見ている。
| CrowdHuman | YOLOX | HOTA | DetA | AssA |
|---|---|---|---|---|
| 57.1 | 66.2 | 49.5 | ||
| ✓ | 60.7 | 74.8 | 49.6 | |
| ✓ | 56.7 | 73.7 | 43.9 | |
| ✓ | ✓ | 63.7 | 76.6 | 53.2 |
原論文 Table 6 をもとに整理。DanceTrack 検証セット。
CrowdHuman だけを加えると、検出は良くなったのに AssA は 5.6 ポイント下がり、HOTA もわずかに下がった。著者らの説明では、CrowdHuman の疑似動画はアフィン変換で作ったもので、人の「運動」がダンスとはまるで違う。しかも訓練がより難しい検出の処理に引っ張られ、検出に偏って関連付けを犠牲にしてしまう。
YOLOX が加わると、状況は逆転する。検出を YOLOX に任せれば、MOTR はもう検出に苦しまなくてよく、CrowdHuman がもたらす追加のデータを関連付けの能力に変えられる。AssA は 49.6 から 53.2 に上がった。
この二つの表を合わせて見ると、この論文の中心的な主張がちょうど裏づけられる。MOTR の中では検出と関連付けが衝突していて、検出を肩から降ろしてはじめて関連付けをうまく学べる。
DanceTrack
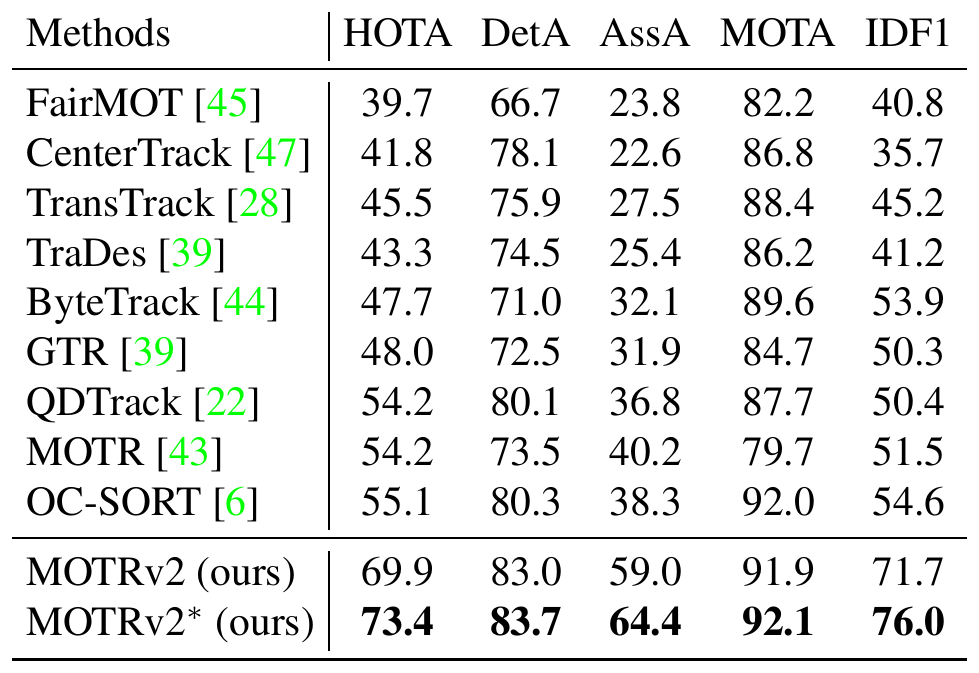
MOTRv2 の HOTA は 69.9 で、それまで最良だった OC-SORT を 14.8 ポイント上回った。AssA は 59.0 で、OC-SORT の 38.3 より 20 ポイント以上高い。DetA も 83.0 で、OC-SORT の 80.3 より高い。関連付けで大きくリードし、検出でももう後れを取っていない。
表の MOTRv2* は 73.4 を取り、第 1 回のグループダンス複数人追跡チャレンジで優勝した。ただしこの数字には、検証セットでの訓練、4 つのモデルのアンサンブル、そして後処理のルールが一つ加わっている。ある軌跡が終わってから 20 から 100 フレームの間に、新しい軌跡がちょうど一本だけ現れたら、両者を同じ人と見なす、というルールだ。このルールはとても実用的だが、もうエンドツーエンドではない。
BDD100K
BDD100K には 8 つのクラスがある。MOTRv2 はクラスごとに共有クエリを一つずつ用意し、検証セットで mMOTA 43.6、mIDF1 56.5 を出して、それまで最良だった Unicorn を 2.4 ポイントと 2.5 ポイント上回った。
同じく BDD100K の画像を加えて結合訓練し、ボックス全体も受け渡すが YOLOX は使わない MOTR と比べると、mMOTA は 8.1 ポイント、mIDF1 は 8.3 ポイント高い。YOLOX の助けは、複数クラスの場面でも同じようにはっきりしている。
MOT17 と MOT20
MOT17 では、MOTRv2 の HOTA は 62.0、MOTA は 78.6、IDF1 は 75.0 で、MOTR の 57.8、73.4、68.6 よりずっと良いが、それでも ByteTrack(63.1、80.3、77.3)や BoT-SORT(64.6、80.6、79.5)より低い。
MOT20 も同じだ。MOTRv2 の HOTA は 60.3、MOT17 との結合訓練を加えると 61.0 だが、それでも表にある ByteTrack の 61.3 や OC-SORT の 62.4 より低い。
著者らはこの差をデータ量のせいだとしている。MOT17 の訓練動画は少なすぎて、クエリを中心としたトラッカーを訓練するには足りない。MOT17 を加えて一緒に訓練すると、MOT20 での差は少し縮まった。
MOT17 や MOT20 のような混雑した場面で YOLOX のボックスをうまく使うため、著者らはさらに「トラッククエリの整合」を加えた。MOTR の予測ボックスと YOLOX のボックスを IoU でハンガリアン法によりマッチングし、IoU が 0.5 より大きければ YOLOX のボックスでアンカーボックスを置き換え、マッチしなかった予測は誤検出として削除する。アンカーボックスを揃えるだけで、MOT17 のハーフ検証セットでの MOTA は 75.9 から 84.3 に上がる。クエリの埋め込みそのものの受け渡しは変わっていないが、この一歩で、実は IoU マッチングがまた呼び戻されている。
限界
著者らは限界を三つ挙げている。
- 大量のデータが必要。 小さなデータセットでは十分な効果が出ない。MOT17 がその例だ。
- トラッククエリの重複。 二人がすれ違うとき、ときどきトラッククエリの一つが違う人についていき、その結果二つのトラッククエリが同じ人を追うことになる。
- 速度。 2080Ti で、YOLOX は毎秒 25 フレーム、MOTR は毎秒 9.5 フレームで、合わせると 6.9 フレームしか出ない。
結論
MOTRv2 は MOTR の関連付けには手を入れず、検出を外に出した。外部の検出器のボックスがクエリのアンカーボックスになり、MOTR は位置を微調整し、誰が誰かを決めるだけでよくなった。
DanceTrack のように検出が簡単で関連付けが難しい場面では、この役割分担は驚くほど効き、HOTA は一気に 15 ポイント近く上がった。
とはいえ、MOT17 でよりうまく追うために、著者らは結局 IoU マッチングでアンカーボックスを揃え、さらに後処理のルールを一つ加えて DanceTrack の優勝を狙った。エンドツーエンドのトラッカーが最高の成績を取ろうとすると、結局は tracking-by-detection から技をいくつか借りることになる。