原論文
Direct Preference Optimization: Your Language Model is Secretly a Reward Model
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2305.18290
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningdpo2023,
  title = {{Direct Preference Optimization: Your Language Model is Secretly a Reward Model}},
  author = {Rafael Rafailov and Archit Sharma and Eric Mitchell and Stefano Ermon and Christopher D. Manning and Chelsea Finn},
  year = {2023},
  eprint = {2305.18290},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.18290}
}
RLHF の流れは、2023 年にはすっかり定まっていた。まず教師あり微調整(SFT)を行い、次に二つの回答に対する人間の選好を集めて報酬モデルを訓練し、最後に PPO で言語モデルに高得点を狙わせる。同時に KL ペナルティで引き止めて、元のモデルから離れすぎないようにする。
この流れはよく効く。ChatGPT もこうして訓練された。ただ、面倒でもある。PPO の訓練中は大きなモデルをいくつも同時に載せておかなければならない。訓練中の方策、固定したままの参照モデル、報酬モデル、それにたいていは価値関数も。しかも訓練の途中で方策から何度もサンプリングする必要があり、ハイパーパラメータも多く、訓練が不安定になりやすい。
Stanford の Rafailov、Sharma、Mitchell らはこの論文で、少し意外な結果を示した。RLHF が最適化しようとしている目標は、実は強化学習を使わなくても、二値分類の損失一つで直接解ける。報酬モデルを別に訓練する必要もない。言語モデルそのものに、一つ隠れているからだ。
問題の定義
まず RLHF を式で書いてみよう。
プロンプト が与えられると、SFT モデルが回答を二つ生成し、アノテーターが良いほうの と悪いほうの を選ぶ。これらの選好の裏には目に見えない真の報酬 があり、Bradley-Terry モデルに従うと仮定する。つまり「 が に勝つ」確率は、両者の報酬の差で決まる。
第一段階では、最尤推定で報酬モデル を訓練する。
第二段階では、方策 に高得点を狙わせるが、参照モデル (たいていは SFT モデルそのもの)から離れすぎてはいけない。
は引き止める強さを決める。言語の生成は離散的なので、この目標は直接微分できない。だから PPO のような強化学習のアルゴリズムが必要になる。
では、この二段階を一段階にまとめられないだろうか?
問題を解く
最適方策には閉形式の解がある
鍵は、第二段階の KL 制約つき最大化問題にある。その最適解が直接書き下せることは、先行研究ですでに示されている。
つまり、参照モデルから出発して、報酬が高い回答ほど確率に大きな倍率を掛け、全体を正規化し直すということだ。
閉形式の解があるのに、なぜみんな PPO を使うのか? はありうるすべての回答について和を取らなければならず、言語モデルでは到底計算できないからだ。
向きを変えて書く
著者らは上の式を逆向きにし、両辺の対数を取って、報酬を方策で表した。
はまだ残っているが、これはプロンプト だけに依存し、回答 には依存しない。そして Bradley-Terry モデルが見るのは二つの回答の報酬の差だけなので、同じプロンプトに対する二つの回答を引き算すれば、 は消える。
暗黙の報酬と元の報酬の差は だけだ。この定数は同じプロンプトに対するどの回答でも同じなので、二つの回答の報酬を引き算すると消える。だから上の式は、方策だけを使って、元の報酬とまったく同じ選好確率を出せる。
DPO の損失
選好の確率が方策だけで書けるのなら、それを報酬モデルの段階の最尤推定にそのまま差し込めばよい。 を訓練する に置き換える。
報酬モデルの損失とまったく同じ形で、 が に置き換わっただけだ。言語モデルを訓練することは、報酬モデルを一つ訓練することに等しく、しかもその報酬モデルに対応する最適方策は、言語モデル自身である。論文の副題「あなたの言語モデルは、実は報酬モデルだ」は、そういう意味だ。
著者らは、この変数変換で表現できる報酬関数が制限されないことも証明している。 と同じくプロンプトだけに依存する部分は、もともと選好の確率にも最適方策にも影響しない。等価な報酬関数のどのクラスも、 の形で表せる。
実装はほんの数行で、論文の付録に PyTorch のコードがそのまま載っている。二組の選好で試算してみよう。各回答の対数確率は、文全体の合計だ。
import torch
import torch.nn.functional as F

def dpo_loss(pi_logps, ref_logps, yw_idxs, yl_idxs, beta):
    """論文の付録 B の実装"""
    pi_yw_logps, pi_yl_logps = pi_logps[yw_idxs], pi_logps[yl_idxs]
    ref_yw_logps, ref_yl_logps = ref_logps[yw_idxs], ref_logps[yl_idxs]
    pi_logratios = pi_yw_logps - pi_yl_logps
    ref_logratios = ref_yw_logps - ref_yl_logps
    losses = -F.logsigmoid(beta * (pi_logratios - ref_logratios))
    rewards = beta * (pi_logps - ref_logps).detach()
    return losses, rewards

# 二組の選好:回答 0 が 1 に勝ち、回答 2 が 3 に勝つ(回答全体の対数確率)
ref_logps = torch.tensor([-12.0, -11.0, -20.0, -21.0])
pi_logps = torch.tensor([-11.0, -12.0, -21.0, -18.0], requires_grad=True)
yw, yl = torch.tensor([0, 2]), torch.tensor([1, 3])

losses, rewards = dpo_loss(pi_logps, ref_logps, yw, yl, beta=0.1)
losses.sum().backward()
print(losses.detach().numpy().round(3), rewards.numpy().round(2))
print(pi_logps.grad.numpy().round(3))

# [0.598 0.913] [ 0.1 -0.1 -0.1  0.3]
# [-0.045  0.045 -0.06   0.06 ]
一組目では、方策はすでに参照モデルより良い回答を好んでいて、暗黙の報酬は 0.1 対 −0.1。順位は正しく、損失は 0.598。二組目では、方策はむしろ悪い回答 3 の確率を引き上げてしまっていて、暗黙の報酬は −0.1 対 0.3。順位を取り違えていて、損失は 0.913。
勾配の向きはどちらも同じで、良い回答の確率を押し上げ、悪い回答の確率を押し下げる。違うのは大きさで、二組目の勾配は 0.06、一組目は 0.045。勾配を展開してみれば理由がわかる。
が暗黙の報酬だ。暗黙の報酬が順位を大きく取り違えているほど、その組のサンプルの重みは大きくなり、すでに正しく並んでいる組の重みは小さい。著者らは、この重みを取り除いた単純版では言語モデルが劣化するとも指摘していて、付録に対応する実験がある。
全体の流れは二段階だけになる。各プロンプトについて回答を二つサンプリングし、人に選好をつけてもらい、あとは DPO の損失でそのまま訓練する。実際には、既存の選好データセットをそのまま使うことのほうが多い。参照モデルは、それらの回答を生成した SFT モデルにするのが望ましい。それがなければ、まず選好データの良いほうの回答で一度教師あり微調整を行い、それを参照モデルにする。
ハイパーパラメータはほとんど調整しなくてよい。論文の既定値は (要約タスクでは )、バッチサイズ 64、RMSprop、学習率 、最初の 150 ステップで線形ウォームアップ。
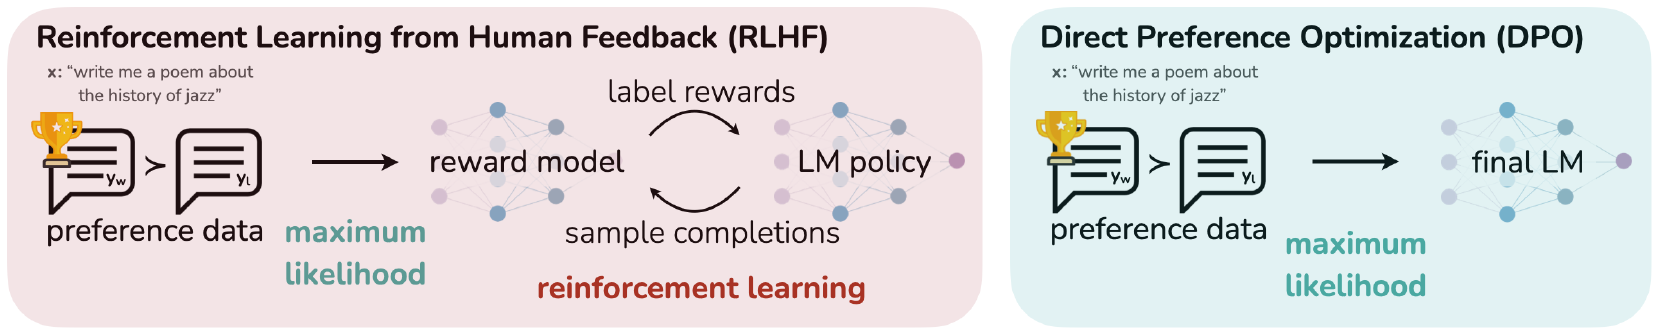
左右を並べてみると一目瞭然だ。RLHF の報酬モデルと強化学習のループが、まるごと一つの最尤推定のステップに置き換わっている。
議論
著者らは三つのタスクで比較しており、モデルは最大で 60 億パラメータだ。
同じ目標を誰がうまく最適化するか
一つ目のタスクは、感情を制御した生成だ。IMDb の映画レビューの書き出しを与え、モデルはその続きとして肯定的なレビューを書く。ここでの選好は事前学習済みの感情分類器が生成しているので、「真の報酬」がわかっており、アルゴリズム同士を正確に比べられる。モデルは GPT-2-large。
RLHF の目標は、高得点を取ると同時に参照モデルの近くにとどまることも求めるので、比べるときはスコアだけでなく、報酬と KL ダイバージェンスのトレードオフを見なければならない。著者らは手法ごとにさまざまなハイパーパラメータを掃引し、合計 22 回の訓練を行った。
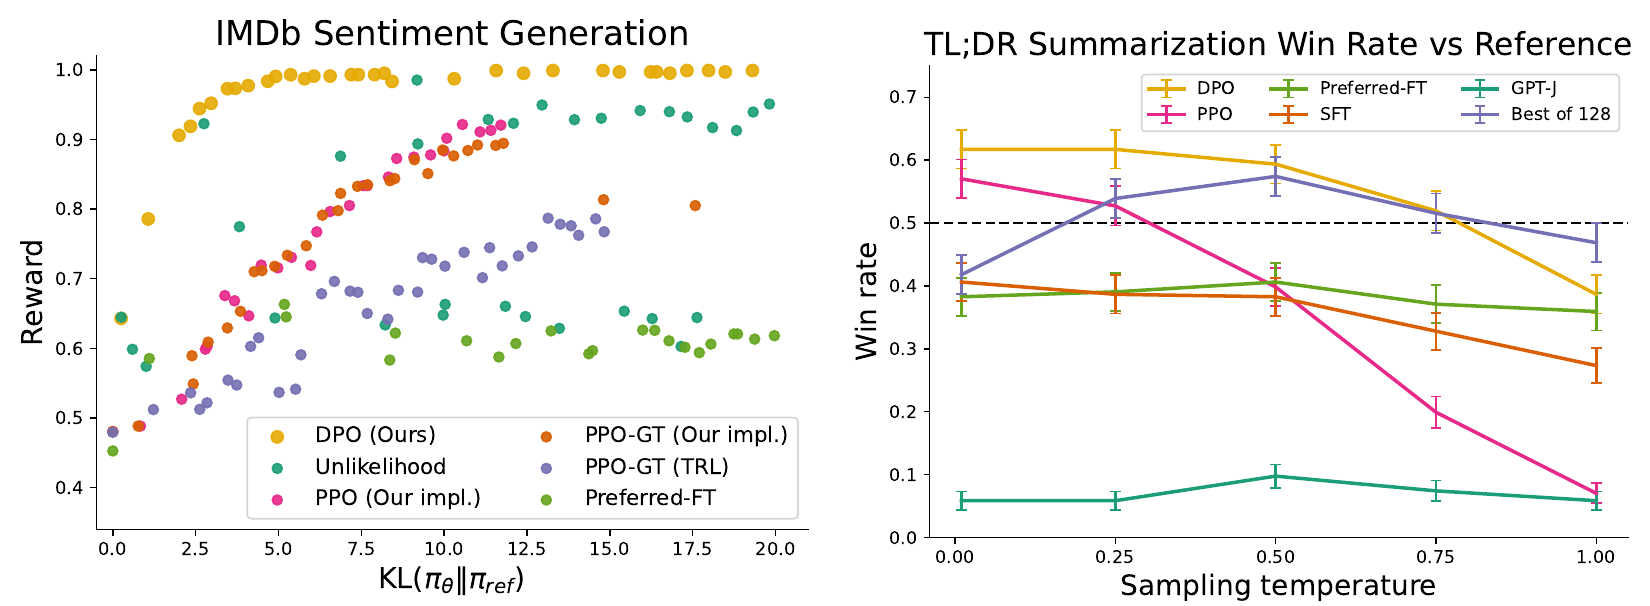
まず左図。横軸は参照モデルとの KL ダイバージェンス、縦軸は報酬で、左上ほど良い。黄色の DPO は KL がごく小さいところで報酬を 1 近くまで押し上げ、フロンティア全体が他の手法より上にある。PPO は同じ目標を最適化しているのに、明らかに効率が悪い。真の報酬を直接読める PPO-GT でさえ、フロンティアは DPO に及ばない。
要約と対話
右図は二つ目のタスク、Reddit TL;DR の要約で、使うのはまさに Stiennon らが集めた人間の選好だ。どの手法も同じ GPT-J の SFT モデルから出発し、モデルの要約と人が書いた参照要約のどちらが良いかを GPT-4 に判定させる。
DPO は温度 0 で勝率約 61%、PPO は最も良い温度(これも 0)で約 57%。もっと目立つ差は温度を上げたときで、PPO は微調整していない GPT-J とほぼ同じところまで落ちていくが、DPO はずっと安定している。著者らは人間による評価も行っており、DPO(温度 0.25)は PPO(温度 0)に対して 58% の割合で好まれた。
三つ目のタスクは Anthropic HH のシングルターンの対話だ。データには約 17 万の対話があり、それぞれの最後に回答が二つと人間の選好がついている。ここには既製の SFT モデルがないので、著者らはまず Pythia-2.8B を選好データの良いほうの回答で微調整して参照モデルとし、それから DPO を行った。
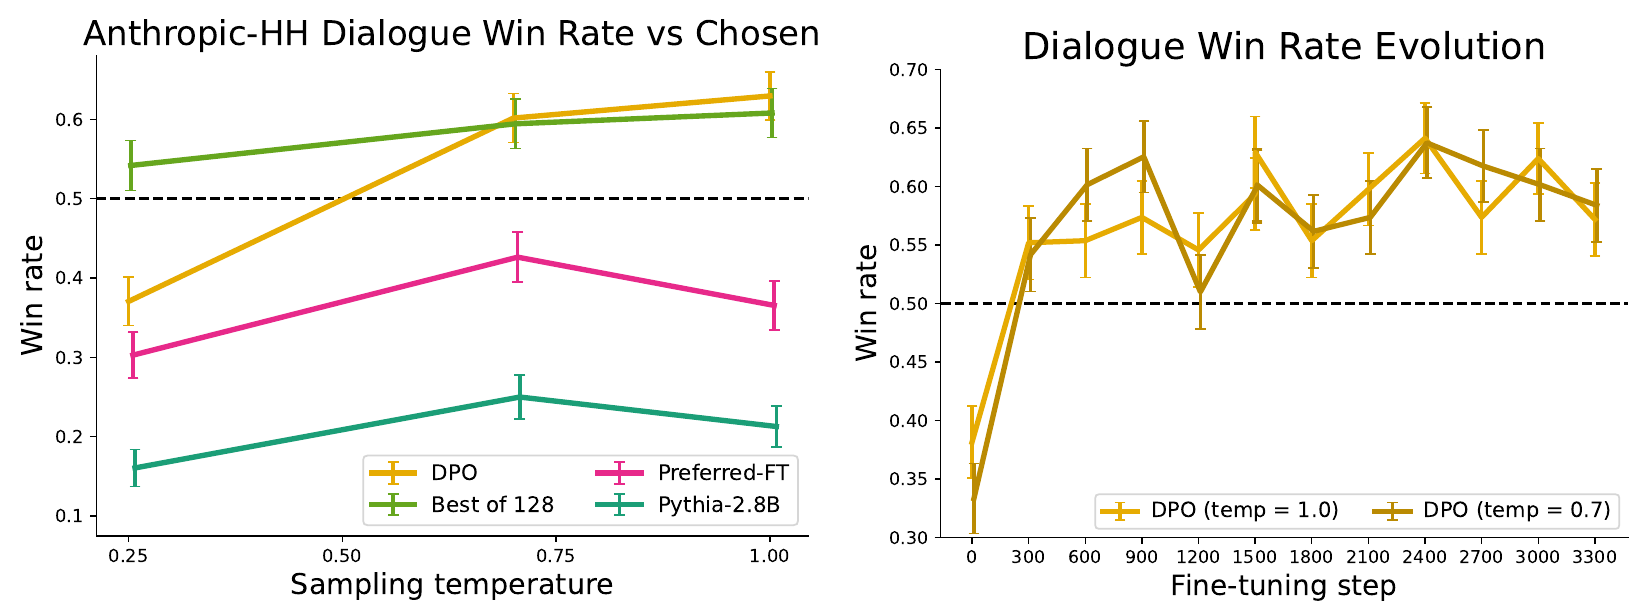
0.5 の破線は、データセットで選ばれた回答と引き分けることを表す。この線を超え、しかも大量のサンプリングを必要としない手法は DPO だけだ。best of 128 も超えてはいるが、問題ごとに 128 個の回答を引いて報酬モデルで選ぶので、推論コストがはるかに高い。著者らは公開されている PPO 版も試したが、元の Pythia-2.8B を上回るプロンプトや温度は一つも見つからなかった。右図からは、DPO が速く収束し、数百ステップで最良の水準の近くに達することがわかる。
見たことのないデータで
著者らは TL;DR で訓練したモデルを、そのまま CNN/DailyMail のニュースの要約に使い、Reddit らしさを覚えただけになっていないかを確かめた。人が書いた要約に対する勝率を GPT-4 で判定すると、温度 0 では DPO が 0.36、PPO が 0.26、温度 0.25 では 0.31 対 0.23 だった。DPO は依然としてリードしている。しかも PPO は、訓練時に Reddit のラベルなしプロンプトを余分に使っている。
GPT-4 の審査は信頼できるか
実験全体が GPT-4 を審査員にしているので、著者らは人間との一致度も調べた。最も簡単なプロンプトで「どちらの要約が要点をうまく押さえているか」と聞くと、GPT-4 は人間よりも長くて繰り返しの多い要約を好む。簡潔さもあわせて求めるプロンプトに変えると、GPT-4 の判断は人間に近づく。三つの比較で、GPT-4 と人間の一致率は 67%~86%、人間どうしは 65%~87% で、ほぼ同程度だった。
まだ答えの出ていない問い
著者ら自身がいくつか挙げている。
- DPO の方策は、見たことのないデータでも、明示的な報酬モデルで訓練する手法と同じくらい良い性能を保ち続けられるのか? 上のニュース要約の実験は、まだ初期の証拠にすぎない。
- 報酬の過剰最適化は、DPO ではどんな形で現れるのか? 対話の実験で訓練の後半に DPO の勝率がわずかに下がったのは、その一例ではないか?
- 実験は最大でも 6B までだ。何桁も大きいモデルにまで拡張できるのか?
- GPT-4 の採点はプロンプトによって変わる。自動の審査員から信頼できる判断を引き出すにはどうすればよいか?
その後
DPO はすぐに広く採用された。2024 年の Llama 3 の後訓練は SFT と DPO を何ラウンドも重ねたもので、Meta は PPO とも比較し、大規模モデルでは DPO のほうが計算が少なく、指示追従の性能も高いと結論づけた。同じ年の Tülu 3 は、完全に公開された後訓練レシピの一部として、SFT の後に DPO を置いている。
反対の声もある。2024 年の Is DPO Superior to PPO for LLM Alignment? は、DPO が偏った解を見つけ、選好データの分布の外にある回答を利用してしまう可能性があると主張する。モデル自身の出力と選好データの分布が大きく離れているときには、性能がはっきり落ちるという。この研究では PPO をしっかり調整すると、対話でもコード生成でも DPO を上回り、最も難しい競技プログラミングの問題で差が最大になった。
そして 2025 年には、推論モデルが強化学習を呼び戻した。ただし今回は、報酬が人間の選好ではなく、自動で検証できる答えから来ることが多い。
結論
DPO の核心は、一度の変数変換だ。KL 制約のもとでの最適方策には閉形式の解がある。それを逆向きにして報酬を方策で表すと、計算しにくい分配関数は Bradley-Terry の引き算の中で消え、RLHF は二値分類の損失一つになる。報酬モデルの訓練も、訓練中のサンプリングも、PPO の山のようなハイパーパラメータも要らない。
手元にペアの選好データがあるなら、まず試すべきは DPO だろう。ただし参照モデルは、そのデータを生成したモデルにできるだけ近づけておくこと。分布が離れすぎると、性能は目減りする。
論文は強化学習なしで済むと言った。一年後、Llama 3 の後訓練は本当に PPO を DPO に置き換えた。