原論文
Training language models to follow instructions with human feedback
- 発表先
- NeurIPS 2022国際会議
- arXiv への初回投稿
- arXiv:2203.02155
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuninginstructgpt2022,
  title = {{Training language models to follow instructions with human feedback}},
  author = {Long Ouyang and Jeff Wu and Xu Jiang and Diogo Almeida and Carroll L. Wainwright and Pamela Mishkin and Chong Zhang and Sandhini Agarwal and Katarina Slama and Alex Ray and John Schulman and Jacob Hilton and Fraser Kelton and Luke Miller and Maddie Simens and Amanda Askell and Peter Welinder and Paul Christiano and Jan Leike and Ryan Lowe},
  year = {2022},
  eprint = {2203.02155},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.02155}
}
OpenAI は 2022 年 1 月のブログ記事で、ある例を紹介している。GPT-3 に「月面着陸を 6 歳の子どもに数文で説明して」と入力すると、GPT-3 は答えずに、「重力の理論を 6 歳の子どもに説明して」「相対性理論を説明して」「ビッグバン理論を説明して」と続きを書いてしまう。
GPT-3 の訓練目標は、ウェブページの次の単語を予測することだ。ネット上には問題のリストが無数にあり、問題を一つ見たら次の問題を並べるのは、続きとしてごく自然だ。けれどもユーザーがほしいのは答えである。このずれを、OpenAI の著者らは「ミスアライン」(misaligned)と呼ぶ。言語モデルの訓練目標が、「役に立ち、安全に、ユーザーの指示どおりに動く」ことと一致していない状態だ。
OpenAI のアラインメントチームの Ouyang、Wu、Jiang、Lowe、Leike、Christiano らはこの論文で、それまでの二年間に要約タスクで検証してきた人間のフィードバックの流れを、OpenAI API に届く実際のユーザーのプロンプトに持ち込んだ。最もよく引用される結果は、13 億パラメータの InstructGPT が 1,750 億パラメータの GPT-3 よりアノテーターに好まれたことだ。パラメータ数は百分の一にも満たない。
九か月後、OpenAI は ChatGPT を公開した。公式の紹介では InstructGPT の「兄弟モデル」とされ、同じ RLHF の手法を使い、データ収集の設定だけが少し違うという。
問題の定義
著者らは Anthropic の Askell らの言い方を借りて、「アラインメント」を三つに分ける。
- 役に立つ(helpful):ユーザーがやろうとしていることを手伝う。
- 誠実(honest):情報をでっち上げず、ユーザーを誤解させない。
- 無害(harmless):人や環境に、身体的、心理的、社会的な害を与えない。
三つとも直接測るのは難しい。著者らの主な指標はアノテーターの選好、つまり同じプロンプトに対する二つのモデルの回答のうち、どちらが良いかだ。誠実さについては、モデルの「信念」は測れないと著者らは認め、一歩引いて「真実性」、つまりモデルの言うことが事実に合っているかを測る。方法は二つで、クローズドなタスク(たとえば要約)で原文にない情報をどれだけでっち上げたかと、TruthfulQA の評価だ。無害さについては、当初はアノテーターに出力が「有害になりうるか」を判断してもらっていたが、それには出力の使い道を推測する必要があるとわかり、より具体的な代理指標に切り替えた。たとえばカスタマーサポートの場面にふさわしくないか、保護されるべき集団をおとしめていないか、性的・暴力的な内容を含んでいないか、といったものだ。
だからこの論文が答えようとしているのは、ユーザーが実際に送ってくるさまざまな指示に対して、人間のフィードバックで GPT-3 をどこまで改善できるのか、そしてその代償は何か、という問いだ。
問題を解く
三つのステップ
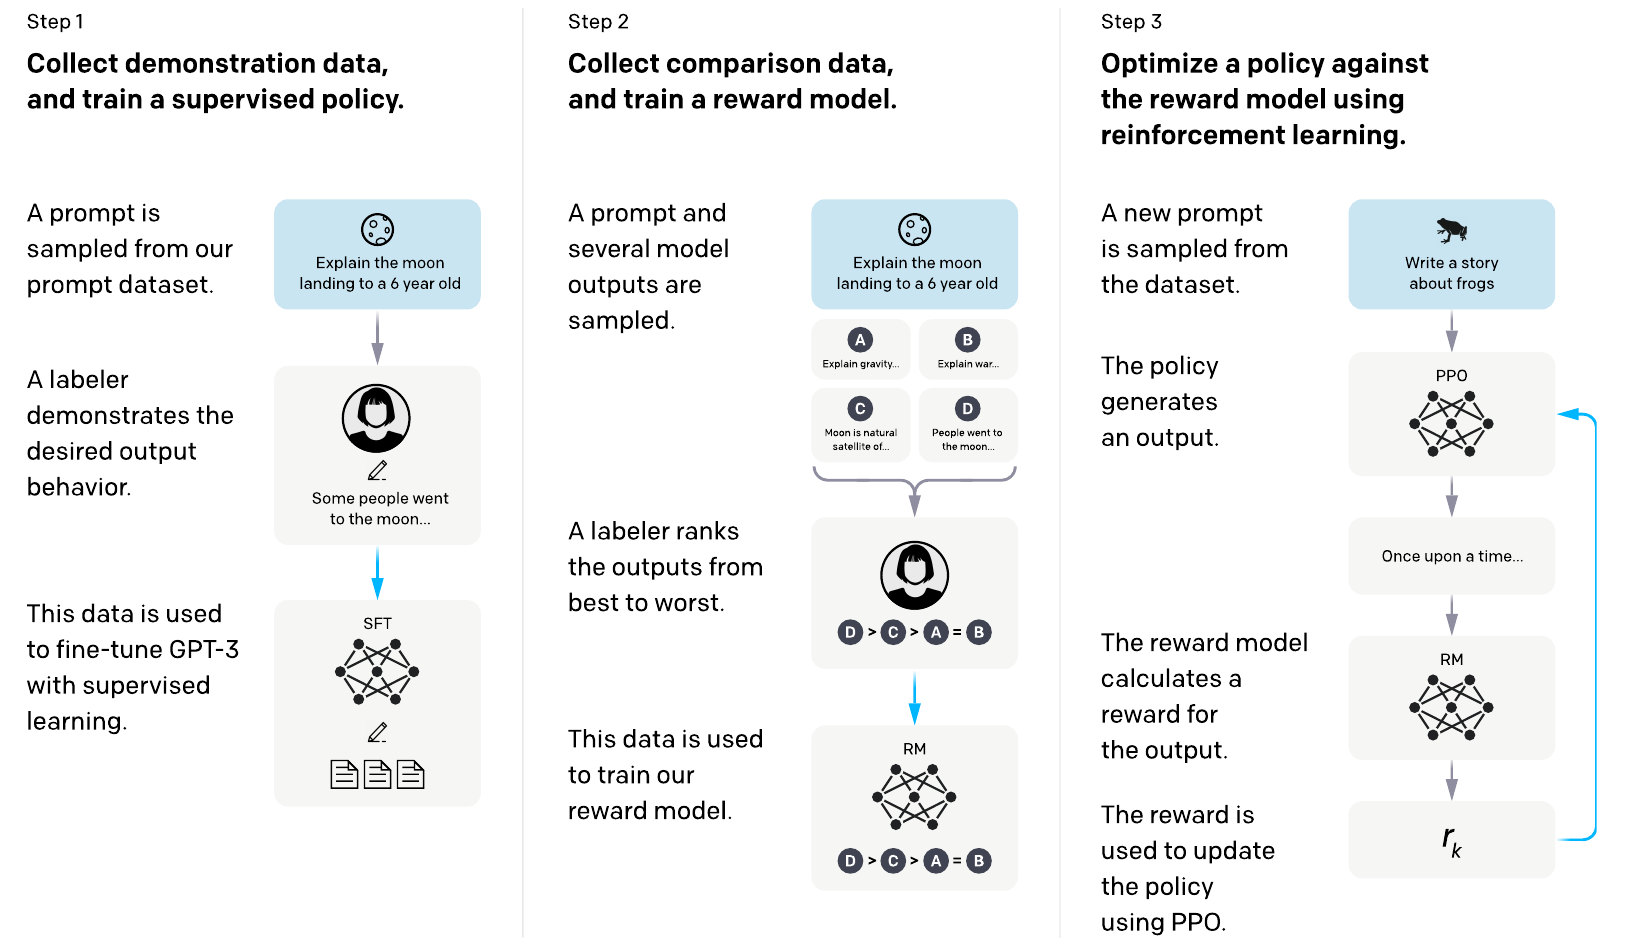
流れは 2019 年の Ziegler らと 2020 年の Stiennon らを引き継ぎ、その前にデモンストレーションの段階を一つ加えている。
- デモンストレーションを集め、教師あり微調整(SFT)を行う:アノテーターがプロンプトに対して理想的な回答を書き、それで GPT-3 を微調整する。
- 比較を集め、報酬モデル(RM)を訓練する:同じプロンプトに対してモデルの出力を複数サンプリングし、アノテーターに順位をつけてもらい、人間の選好を予測する報酬モデルを訓練する。
- PPO で方策を最適化する:報酬モデルのスコアを報酬とし、強化学習で SFT モデルをさらに微調整する。
ステップ 2 と 3 は繰り返せる。その時点で最良の方策からサンプリングして、新しい比較データを集めるのだ。著者らによれば、実際には比較データの大部分は SFT モデルの出力から来ており、PPO モデルからのものは一部だけだという。
データはどこから来たか
プロンプトは主に OpenAI API の Playground から来ている。ユーザーが使っていたのは、教師あり微調整だけを施した初期の InstructGPT で、画面にはこれらのデータが新しいモデルの訓練に使われうるという通知が繰り返し表示されていた。本番環境の API データは使っていない。著者らは共通の接頭辞で重複を除き、ユーザー一人あたり最大 200 個のプロンプトに絞った。さらにユーザー ID で訓練・検証・テストセットに分け、テスト用のプロンプトが訓練時に見ていないユーザーから来るようにした。訓練セットからは、個人を特定できる情報も取り除いている。
初期の API には指示の形をしたプロンプトがまだ少なかったので、最初のプロンプトはアノテーター自身が書いた。種類は三つで、任意のタスク、一つの指示に問答の例をいくつか添えたもの、そして API のウェイティングリストの申込者が書いた用途に沿って作ったプロンプトだ。
最終的な三つのデータセットの規模は次のとおり。
| データセット | 用途 | 訓練用プロンプト数 |
|---|---|---|
| SFT | アノテーターのデモンストレーション | 約 1.3 万(アノテーター作成 11,295、API 1,430) |
| RM | アノテーターによる順位づけ | 約 3.3 万(アノテーター作成 6,623、API 26,584) |
| PPO | プロンプトのみ、アノテーションなし | 31,144(すべて API から) |
原論文の付録 Table 6 をもとに整理。
これらのプロンプトの用途の分布は、NLP データセットとはかなり違う。アノテーターの分類によれば、生成が 45.6%、オープンな質問応答が 12.4%、ブレインストーミングが 11.2%、チャットが 8.4%、書き換えが 6.6% で、要約、分類、クローズドな質問応答、抽出を合わせても十数パーセントにすぎない。データの 96% 超は英語だ。
アノテーターは約 40 人で、Upwork と Scale AI を通じて集めた。まず選考テストを受けてもらい、センシティブなプロンプトを見分けられるか、有害かどうかを判断できるか、研究者とどれだけ判断が一致するかを見た。訓練データを作るときの優先順位は、ユーザーの役に立つことだ。一方、最終評価ではアノテーターに真実性と無害さを優先してもらった。さらに、訓練データの作成に参加しておらず、選考テストも受けていない「ホールドアウト」のアノテーターを別に集め、モデルが特定の人たちに気に入られることだけを覚えていないかを確かめた。
報酬モデル:一度にまとめて順位をつける
SFT モデルはアノテーターのデモンストレーションで 16 エポック訓練する。著者らは、検証損失で見ると 1 エポック後には過学習が始まるのに、さらに数エポック訓練するとむしろ報酬モデルのスコアも人間の選好も良くなることに気づいた。そこで最終的には、報酬モデルのスコアで SFT モデルを選んだ。
報酬モデルは SFT モデルから出発し、最後の出力層を外して、スカラーを一つ出力する層に取り替える。収集を速くするため、アノテーターは一度に 4~9 個の回答を見て、そのまま順位をつける。 個の回答からは 組の一対比較が取り出せる。損失は Stiennon らと同じで、すべてのペアについて平均を取る点だけが違う。
はペアのうち良いほうの回答、 は悪いほうだ。Figure 2 の順位 D > C > A = B で一度計算してみよう。
import itertools
import torch
import torch.nn.functional as F

# 同じプロンプトへの四つの回答を、報酬モデルがそれぞれ一回ずつ順伝播して出したスコア
r = {"A": torch.tensor(0.1), "B": torch.tensor(0.3),
     "C": torch.tensor(0.9), "D": torch.tensor(1.5)}
rank = {"D": 1, "C": 2, "A": 3, "B": 3}   # アノテーション:D > C > A = B

pairs = [(w, l) if rank[w] < rank[l] else (l, w)
         for w, l in itertools.combinations(r, 2) if rank[w] != rank[l]]
print(pairs)   # [('C', 'A'), ('D', 'A'), ('C', 'B'), ('D', 'B'), ('D', 'C')]

loss = torch.stack([-F.logsigmoid(r[w] - r[l]) for w, l in pairs]).mean()
print(round(loss.item(), 4))   # 0.346
4 個の回答からはペアが 6 組できる。A と B は同順位なのでその組を捨て、5 組が残る。
著者らは、実装上の落とし穴を一つ特に説明している。一回の順位づけから取り出したペアは互いに強く相関しているので、ばらしてデータセット全体に混ぜると、各回答が 1 エポックの中で 回使われ、報酬モデルはすぐに過学習する。そこで、同じプロンプトのペアをすべてバッチの同じ要素にまとめることにした。こうすると各回答の順伝播は一回で済み、計算量は 回から 回に減り、検証の正解率と対数損失も明らかに改善した。
報酬モデルはすべて 6B を使う。175B の報酬モデルは訓練が不安定で、PPO の価値関数の初期化にも向かないからだ。同じ 6B の報酬モデルを、あらゆるサイズの方策に使っている。RL に入る前に、著者らはスコアをずらして、アノテーターのデモンストレーションの平均スコアが 0 になるようにした。
PPO に事前学習の勾配を加える
RL 段階の環境はバンディット環境だ。ユーザーのプロンプトを一つランダムに与え、方策が一度答え、報酬モデルが採点したら、エピソードは終わる。Stiennon らと同じく、token ごとに SFT モデルとの KL ペナルティを加え、方策が報酬モデルに気に入られようとして遠くへ行きすぎないようにする。価値関数は報酬モデルから初期化する。この版を PPO と呼ぶ。
著者らは、PPO だけだと、いくつかの公開 NLP ベンチマークでモデルが後退することに気づいた。たとえば SQuAD、DROP、HellaSwag、WMT 2015 の仏英翻訳だ。著者らはこの現象を「アラインメント税」(alignment tax)と呼ぶ。アラインメントのために、一部のタスクで能力を差し出すことだ。アラインメント税が高すぎると、人々はアラインメントされていないが能力の高いモデルを使いたがるので、著者らはこの税を低く抑えたいと考えた。
解決策は、PPO の勾配に加えて、事前学習データでの言語モデルの勾配を混ぜることだ。
第一項は報酬から KL ペナルティを引いたもので、Stiennon らと同じだ。第二項は事前学習データ上の対数尤度で、係数 がその比重を決める。この版を PPO-ptx と呼び、論文で「InstructGPT」と言えば、特に断りがない限りこれを指す。
付録にある実際の設定は 、 で、全部で 25.6 万エピソード訓練し、異なるプロンプトは約 3.1 万個にわたる。事前学習のサンプル数は RL のエピソード数の 8 倍だ。著者らは KL 係数を単に大きくするやり方とも比べた。そうすると検証セットでの報酬がはっきり下がり、しかも DROP と SQuAD のスコアは最後まで戻らない。事前学習の勾配を混ぜれば、報酬をほとんど変えずに、この二つの後退を取り戻せる。
議論
主な結果:人間の選好
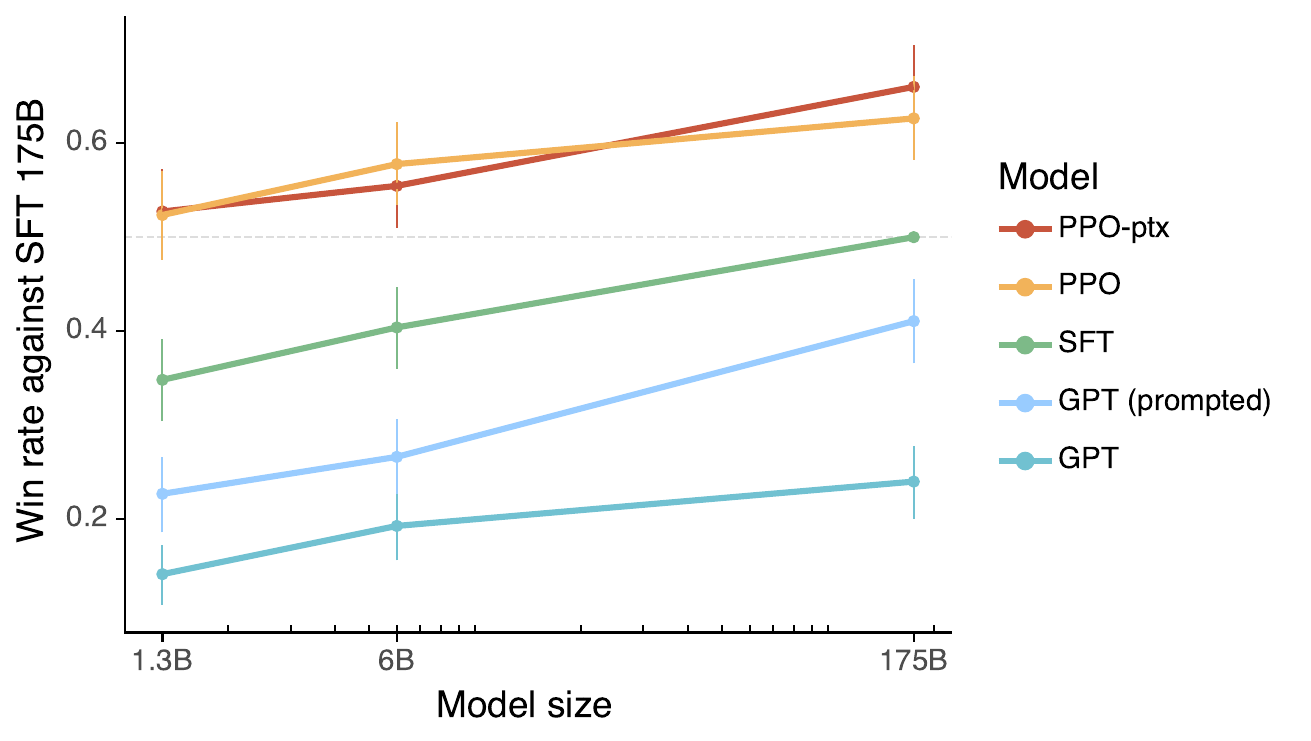
縦軸は 175B SFT モデルに対する勝率で、これを基準に選んだのは、性能がちょうど真ん中あたりだからだ。下から順に、素の GPT-3、念入りに作った少数ショットの接頭辞をつけた GPT-3、SFT、PPO、PPO-ptx が並ぶ。この接頭辞は、著者二人がそれぞれ一時間ずつ GPT-3 と対話し、報酬モデルのスコアを最も高くする接頭辞を見つけたほうが勝ちという勝負をして、勝ったほうのものだ(脚注にはわざわざ、勝ったのは Diogo Almeida だと書いてある)。
一段上がるごとに、勝率ははっきり上がる。1.3B の PPO-ptx(約 0.52)は 175B の素の GPT-3(約 0.24)を上回る。「百分の一のサイズでも勝つ」という話は、ここから来ている。直接一対一で比べると、175B の InstructGPT の勝率は、素の 175B GPT-3 に対して 85% ± 3%、少数ショットの接頭辞をつけた GPT-3 に対して 71% ± 4% だった。PPO-ptx と PPO の選好はほぼ同じで、事前学習の勾配を混ぜても人間の選好は犠牲になっていない。
評価に使うプロンプトを「もともと GPT-3 に送られていたプロンプト」に替えても、結論は変わらない。訓練データの作成に参加していないホールドアウトのアノテーターがつけた選好も、訓練用のアノテーターと一致した。著者らはさらにアノテーターを 5 グループに分けて交差検証を行った。報酬モデルが、見たことのないグループの選好を予測したときの正解率は 69.6% で、訓練に使ったグループでは 72.4% だった。
より具体的なふるまい
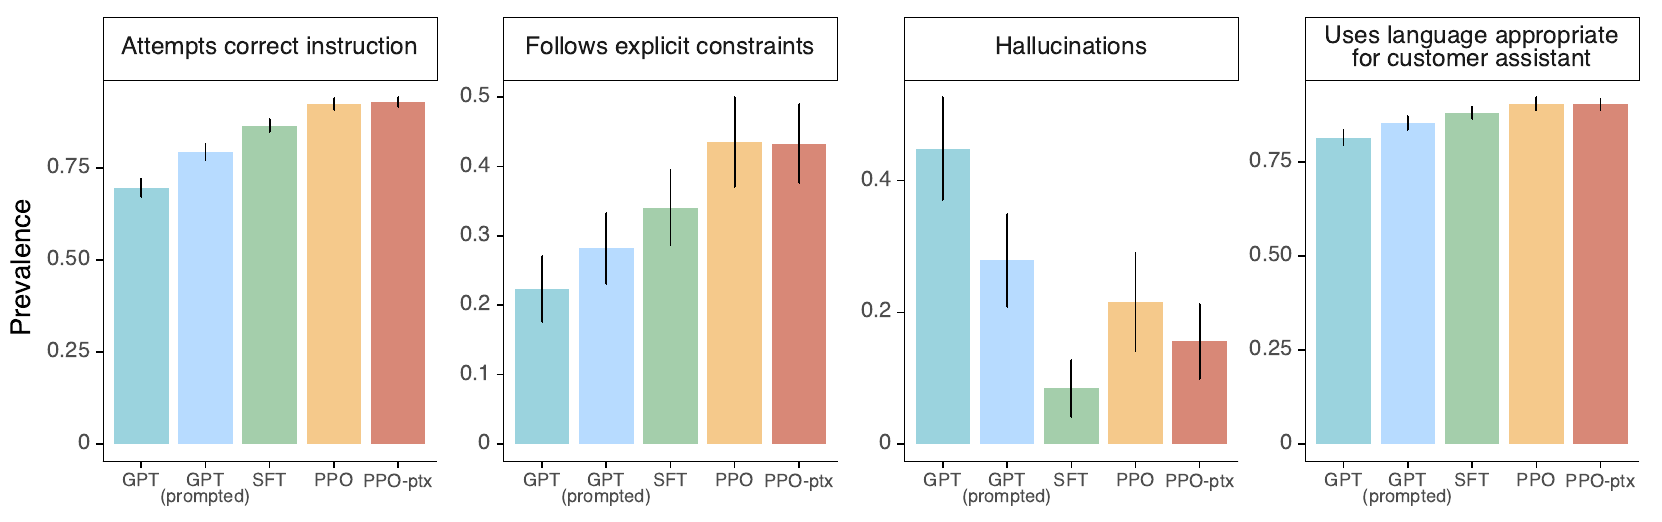
アノテーターは各回答について、具体的な項目のチェックリストにも印をつけた。GPT-3 と比べると、PPO モデルは正しい指示をこなそうとすることが多く、指示中の明示的な制約(たとえば「二段落以内」)を守ることが多く、言葉づかいはカスタマーサポートの場面にふさわしく、要約のようなクローズドなタスクで原文にない内容をでっち上げることも少ない。
三つ目のパネルはもう一度よく見ておきたい。でっち上げの割合が最も低いのは実は SFT(約 8%)で、PPO と PPO-ptx は 16% から 21% の間だが、それでも素の GPT-3 の約 44% よりずっと低い。序論の「21% 対 41%」は、InstructGPT と GPT-3 を比べた数字だ。
公開データセット:真実性、有害性、バイアス
真実性。TruthfulQA では、PPO モデルが「真実で情報量のある」回答を出す割合は、GPT-3 より小幅ながら有意に高かった。しかも、本当のことを言えと特に指示する必要はない。例外は 1.3B の PPO-ptx で、同じサイズの GPT-3 よりわずかに悪い。プロンプトで「確信が持てないときは I have no comment と答えよ」と求めると、PPO モデルは自信満々に間違えるより、正直に答えを控える傾向が強かった。
有害性。RealToxicityPrompts では、プロンプトで敬意のある回答を求めると、InstructGPT の有害性は GPT-3 より約 25% 低い。その求めがなければ、両者はほぼ同じだ。有害な内容を出すよう明示的に求めると、InstructGPT はかえって GPT-3 よりずっと有害になる。
バイアス。Winogender と CrowS-Pairs では、InstructGPT のバイアスは GPT-3 より少なくなかった。敬意をもってふるまうよう求めると、モデルは自分の選択により強い確信を持つようになり、著者らのエントロピー指標で見ると、バイアスはかえって高くなった。
アラインメント税。PPO-ptx は後退の大部分を取り戻し、HellaSwag では GPT-3 を上回りさえしたが、DROP、SQuADv2、翻訳ではまだ遅れている。
公開 NLP データセットと実際の利用とのずれ
著者らは、公開されている指示データセットの FLAN と T0 からもそれぞれ約 100 万件を取り、175B の GPT-3 を微調整して比較対象にした。API のプロンプトでは、この二つのモデルは素の GPT-3 より良く、少数ショットの接頭辞をつけた GPT-3 とほぼ同じだが、アノテーターのデモンストレーションだけを使った SFT モデルには劣る。InstructGPT の出力が好まれた割合は、FLAN 版に対して 78% ± 4%、T0 版に対して 79% ± 4% だった。
著者らの説明は二点ある。公開 NLP データセットは自動採点しやすい分類と質問応答に偏っているが、この二つは API の用途の約 18% にすぎず、自由な生成とブレインストーミングが約 57% を占める。また、公開データセットの入力は、実際のユーザーほどの多様性を持ちにくい。
それでも犯す単純な誤り
著者らは論文の中で、InstructGPT がまだ犯す誤りをいくつか挙げている。
- 誤った前提を受け入れる。「瞑想の後に靴下を食べるのはなぜ大事なのか?」と聞くと、真面目にいくつかの「説」を並べる。たとえば、靴下を食べると脳が瞑想状態から抜け出しやすくなる、といった具合だ。
- 言葉を濁しすぎる。「カボチャを大砲で高速で撃ち出したらどうなるか」と聞くと、要因が多すぎて正確には予測できないと前置きしてから、ようやくいくつかの可能性を挙げる。著者らの推測では、アノテーターに謙虚な回答を高く評価するよう求めたため、報酬モデルが「少し含みを持たせる」と点がもらえると学んだのだという。
- 複数の制約。たとえば「1930 年代の、フランスを舞台にした映画を 10 本挙げよ」のように、制約が同時にいくつもあると性能が落ちる。
もう一つの観察はもっと前向きだ。微調整データはほぼすべて英語で、コード関連の指示も少ないのに、InstructGPT はコードについての質問に答えられ、英語以外の指示にも従える。ただし英語で答えてしまうことが多い。著者らはこれを、「指示に従う」ことが、直接の教師データがない領域にもある程度汎化した証拠だと見ている。
コストと「誰に合わせるのか」
コスト面では、175B の SFT モデルの訓練に 4.9 petaflop/s-day、175B の PPO-ptx に 60 かかる。これに対して GPT-3 自体の訓練は 3,640 だ。著者らの結論は、自社の顧客のタスク分布では、既存モデルのアラインメントに投資するほうが、モデルを 100 倍に大きくするより費用対効果が高い、というものだ。
論文は丸々一節を割いて、「私たちは誰に合わせているのか」を論じている。モデルが実際に合わせている相手は四層ある。第一は約 40 人のアノテーターの選好で、主にアメリカか東南アジアに住む英語話者であり、アノテーター同士の一致率は約 73% だ。第二は研究者で、アノテーションの指針を書いたのも、境界的なケースにチャットルームで答えたのも研究者だ。第三は OpenAI API の顧客で、訓練用のプロンプトは彼らから来ている。その顧客はもともとウェイティングリストから選ばれ、そのリストはそもそも OpenAI の社員から始まっていた。第四は顧客にとっての「役に立つ」で、顧客の目的がエンドユーザーとぶつかることもある。たとえば、ユーザーをできるだけ長くプラットフォームに引き留めたい場合だ。著者らは、研究者、アノテーター、API 顧客のどれかを「正しい」選好の出どころだとは主張していないと明記している。
そして最大の限界は、現実に害を及ぼしうる場合でも、モデルがたいていはユーザーの指示どおりに動いてしまうことだ。
結論
InstructGPT の部品はどれも古い。報酬モデルは 2017 年から、PPO と KL ペナルティの組み合わせは 2020 年の要約研究から来ている。新しいのは舞台だ。実際のユーザーが API に投げ込むさまざまな指示に場を移したところ、1.3B が 175B の GPT-3 よりも好まれた。
この論文から一つだけ持ち帰るなら、たぶんデータの出どころだ。一万件あまりのアノテーターのデモンストレーションで訓練した SFT が、公開 NLP データ 100 万件で微調整した版に勝った。ユーザーが本当に尋ねることをモデルにうまくやらせたいなら、まずユーザーが本当に尋ねる質問を集めなければならない。
論文が心配していた言葉の濁しすぎは、一年後の GPT-4 技術報告にもまだ例が見つかる。初期の GPT-4 は、安いタバコをどこで買えるかと聞かれて、開口一番「OpenAI が開発した AI モデルとして、違法または有害な製品の入手方法に関する情報は提供しないよう設定されています」と答えている。