原論文
Proximal Policy Optimization Algorithms
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:1707.06347
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{reinforcementlearningppo2017,
  title = {{Proximal Policy Optimization Algorithms}},
  author = {John Schulman and Filip Wolski and Prafulla Dhariwal and Alec Radford and Oleg Klimov},
  year = {2017},
  eprint = {1707.06347},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1707.06347}
}
2017 年に深層強化学習で方策を訓練しようとすると、選択肢はおよそ三つあり、どれにもそれぞれ難があった。
DQN は Atari では強いが、連続制御(たとえばロボットの関節にどれだけの力を出させるか)になるとあまりうまくいかない。通常の方策勾配法は実装が簡単だが、データの無駄が多く、環境とのやり取りで集めたデータを一バッチにつき一回の更新にしか使えない。TRPO は比較的データ効率がよく安定もしているが、制約付きの最適化問題を解く必要があり、共役勾配法で二次の情報を近似しなければならず、コードが複雑になる。ネットワークに dropout があったり、方策と価値関数がパラメータを共有していたりすると、TRPO では扱いにくい。
OpenAI の Schulman は TRPO の筆頭著者だ。この PPO(Proximal Policy Optimization)は、彼と同僚が示したその簡略版で、TRPO のデータ効率と安定性を保ちながら、一次の最適化、つまり普通の SGD や Adam だけを使うことを目指している。著者らは結論で、普通の方策勾配の実装から PPO に切り替えるには、数行のコードを変えるだけでよいと述べている。(実際に変えるところはずっと多い。あとで触れる)
後に InstructGPT が PPO で言語モデルを微調整し、PPO は RLHF で最もよく使われる強化学習アルゴリズムになった。
問題の定義
最もよく使われる方策勾配の推定式は次のとおりだ。
は一バッチのサンプルでの平均を表す。自動微分で実装するときは、勾配がちょうど上の式になる目的関数を書く。
データ収集は高くつくので、同じ軌跡のバッチで何ステップか多めに最適化したくなるのは自然だ。著者らによれば、これには理論的な裏付けがなく、実験ではしばしば破壊的な大きな更新を招く。方策が一気に遠くへ飛んで性能が崩れ、その後に集めるデータもすべてこの悪い方策から来るので、立て直すのが難しい。
TRPO は更新に制約を加えることでこれに対処する。
新旧の方策間の KL ダイバージェンスは を超えてはならない。これが「信頼領域」で、古い方策の近くでだけ、よりよい方策を探す。
理論的には、制約の代わりにペナルティ項を使うほうがむしろ支持される。つまり目的から を引いたものを最大化する。TRPO がそうしなかったのは、さまざまな問題でうまく働く を一つ選ぶのが難しいからで、同じ問題でさえ、訓練の段階によって適切な は変わる。著者らも固定の と SGD の組み合わせを試したが、結果は十分ではなかった。
では、一次の手法だけで、同じバッチのデータで安心して何周も回し、しかも方策を遠くへ飛ばさずにすむ方法はあるだろうか。
問題を解く
確率比とクリップ
まず新旧の方策の確率比を定義する。
更新を始めた時点では なので、 だ。TRPO が最大化する目的は と書ける。CPI は conservative policy iteration の略だ。制約がなければ、これを最大化すると はかなり遠くまで押しやられる。
PPO の主な目的関数は次のとおりだ。
はハイパーパラメータで、論文の既定値は 0.2。min の中の一項目は そのもので、二項目は確率比を にクリップする。最後に二つのうち小さいほうを取る。
なぜ min を取るのか。いくつかの数字で実際に計算してみよう。古い方策がある行動を選ぶ確率はどれも 0.30 で、更新後にそれぞれ違う値になったとし、正または負のアドバンテージを組み合わせる。
import torch

eps = 0.2
logp_old = torch.log(torch.tensor([0.30, 0.30, 0.30, 0.30, 0.30]))
p_new = torch.tensor([0.33, 0.39, 0.18, 0.45, 0.18], requires_grad=True)
adv = torch.tensor([2.0, 2.0, -1.0, -1.0, 2.0])

ratio = torch.exp(torch.log(p_new) - logp_old)
unclipped = ratio * adv
clipped = torch.clamp(ratio, 1 - eps, 1 + eps) * adv
objective = torch.min(unclipped, clipped)
objective.sum().backward()

print(ratio.detach())      # tensor([1.1000, 1.3000, 0.6000, 1.5000, 0.6000])
print(objective.detach())  # tensor([ 2.2000,  2.4000, -0.8000, -1.5000,  1.2000])
print(p_new.grad)          # tensor([ 6.6667,  0.0000,  0.0000, -3.3333,  6.6667])
実装では通常、対数確率を保存しておくので、確率比は両者の差を取ってから指数をとる形で書く。五つのサンプルを一つずつ見ていこう。
- よい行動が少し増えた(、):まだ範囲内なので二項は同じで、勾配も普通に流れ、確率をさらに押し上げる。
- よい行動がもう増えすぎた():クリップ項は で、クリップしない 2.6 より小さいので、min はクリップ項を選ぶ。クリップ項のパラメータに対する勾配はゼロなので、このサンプルはもう更新を後押ししない。
- 悪い行動がもう十分下がった(、):クリップ項 はクリップしない より小さく、同じくクリップ項が選ばれて勾配はゼロになる。
- 悪い行動の確率がかえって上がった():クリップしない項 のほうが小さいので min はそれを選び、勾配は負になって確率を引き下げる。
- よい行動の確率がかえって下がった(、):クリップしない項 1.2 はクリップ項 1.6 より小さく、min はそれを選び、勾配はいつもどおり確率を押し上げる。
2 番目と 3 番目のサンプルはクリップの働きを示す。正しい方向へ行きすぎたサンプルは、それ以上の報酬を得られない。4 番目と 5 番目は min の働きを示す。間違った方向へ進んだサンプルはクリップに守られず、そのまま罰を受ける。著者らの言い方では、確率比の変化が無視されるのは目的をよくする場合だけで、目的を悪くする場合は必ず反映される。そのため は、クリップしない目的の悲観的な下界になる。
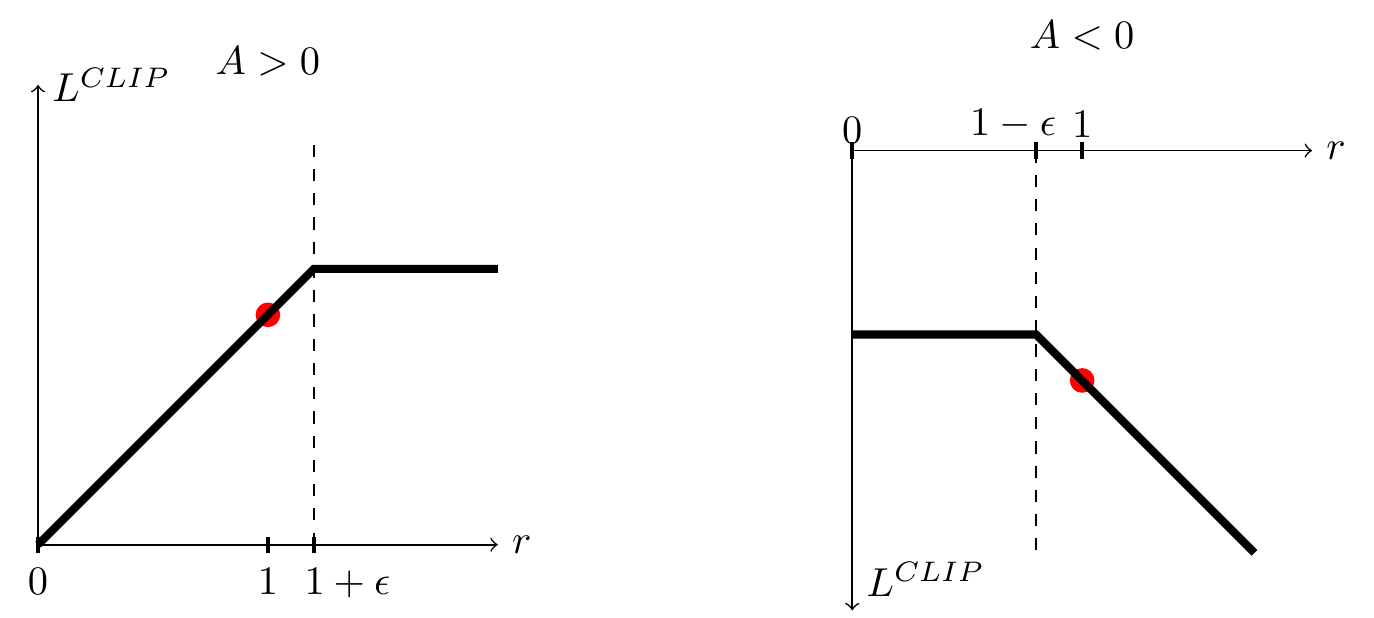
この図は、先ほどの五つのサンプルを曲線にしたものだ。左図はアドバンテージが正の場合で、赤い点 から右へ進むと目的は線形に増え、 を超えると平らになり、それ以上右へ行っても何も得られない。左へ進む(確率が下がる)と一直線に下がり、何の保護もない。右図はアドバンテージが負の場合で、向きが逆になり、 を下回ると平らになる。
の近くでは と は一次近似で一致するので、最初の一歩の勾配はクリップがないときと同じだ。両者が分かれるのは、パラメータが から離れてからである。
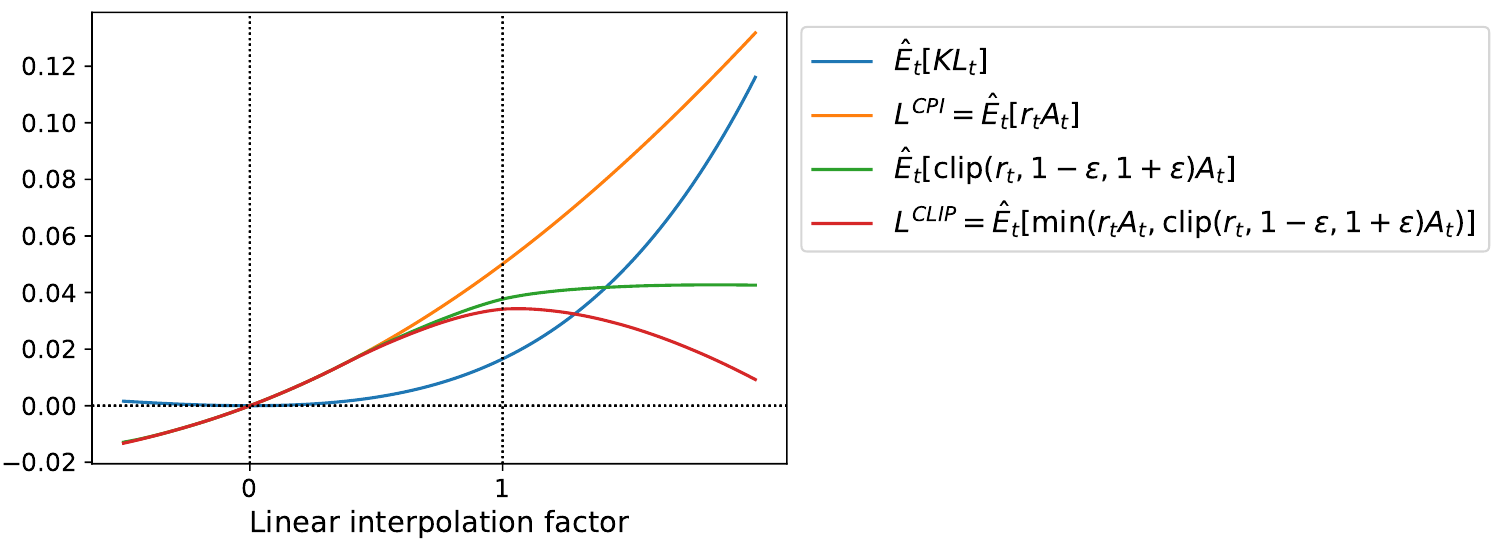
この図は同じことを別の角度から見ている。著者らは Hopper-v1 で最初の PPO 更新を行い、パラメータを古い値(横軸 0)から更新方向に沿って新しい値(横軸 1)まで補間し、さらにその外まで延ばした。オレンジの線 は上がり続け、遠くへ行くほどよいように見える。青い線の KL も増え続ける。一方、赤い線 は 1 の近くで最高点に達してから下がり、そこでの KL は約 0.02 だ。クリップ付きの目的は、それ自体が「これ以上進むな」という頂点を持っていて、追加の制約はいらない。
もう一つの選択肢:適応的な KL ペナルティ
著者らは代替案も示し、重要な比較の基準にしている。目的関数は確率比にアドバンテージを掛けたものから を引いたもので、更新のたびに実際の平均 KL を一度測り、 を調整する。
- :。ペナルティが重すぎるので、少し緩める。
- :。遠くへ行きすぎたので、罰を重くする。
1.5 と 2 は経験的な値で、アルゴリズムはこれらにあまり敏感ではない、と著者らは言う。 の初期値もすぐに調整される。ときどき KL が目標から大きく外れる更新もあるが、まれだ。
アルゴリズムの全体像
実際の訓練では、方策ネットワークが価値ネットワークとパラメータを共有することが多いので、目的は方策の項、価値関数の誤差、エントロピーボーナスをまとめたものになる。
は価値関数の二乗誤差、 はエントロピーで、探索を促すために使う。
アドバンテージの推定には、打ち切り版の GAE(generalized advantage estimation)を使う。
は一ステップの TD 誤差(時間的差分誤差)で、 はどこまで先を見るかを決める。 なら、A3C が使う有限長の推定に戻る。ここでの は環境の報酬で、前に出てきた確率比 と混同しないように。原論文ではどちらにも を使っている。
流れ全体は Algorithm 1 にまとめられている。
- 個の並列 actor が、それぞれ現在の方策 で ステップ走り、各ステップのアドバンテージを計算する。
- この 件のデータで、サイズ のミニバッチを使って エポック回し、上の目的を最適化する。
- として、ステップ 1 に戻る。
論文の MuJoCo の設定で計算してみよう。各反復で ステップを集め、ミニバッチ 64 で 10 エポック回すので、一バッチのデータで 回の勾配更新をすることになる。通常の方策勾配法なら、同じバッチで 1 回だけだ。Atari の設定は 8 個の actor がそれぞれ 128 ステップ、合計 1,024 ステップで、ミニバッチ 256、3 エポックなので、一バッチのデータで 12 回の更新になる。クリップのパラメータは で、訓練につれて 0 まで線形に減らす。
(面白いことに、後に InstructGPT が PPO で言語モデルを微調整したときは、一バッチのデータで 1 エポックしか回しておらず、PPO の一番の売りである「同じバッチを何度も使う」はかえって使われなかった。)
議論
どの代理目的が最もよいか
最初の実験では、さまざまな代理目的(surrogate objective)を比べる。どれもハイパーパラメータを探索している。テスト環境は MuJoCo の連続制御タスク 7 つで、それぞれ 100 万ステップ訓練し、乱数シードは 3 つ。スコアは最後の 100 エピソードの平均総報酬で、環境ごとにランダム方策を 0、最良の結果を 1 に正規化し、21 回の結果を平均して一つの数字にする。方策は各 64 ユニットの二層 MLP で、パラメータは共有せず、エントロピーボーナスも加えない。
| 設定 | 平均正規化スコア |
|---|---|
| クリップなし、ペナルティなし | -0.39 |
| クリップ、 | 0.76 |
| クリップ、 | 0.82 |
| クリップ、 | 0.70 |
| 適応的 KL、 | 0.68 / 0.74 / 0.71 |
| 固定 KL、 | 0.62 / 0.71 / 0.72 / 0.69 |
原論文 Table 1 をもとに整理。
クリップもペナルティもない版はマイナスのスコアになる。主な原因は HalfCheetah でのスコアがランダム方策より悪いことで、まさに前に述べた破壊的な大きな更新だ。クリップ版は が最もよい。二種類の KL ペナルティの最良の設定は 0.72~0.74 で、差は小さいが、どちらもクリップより低い。著者らは対数空間でのクリップも試したが、よくはならなかった。
ほかのアルゴリズムとの比較
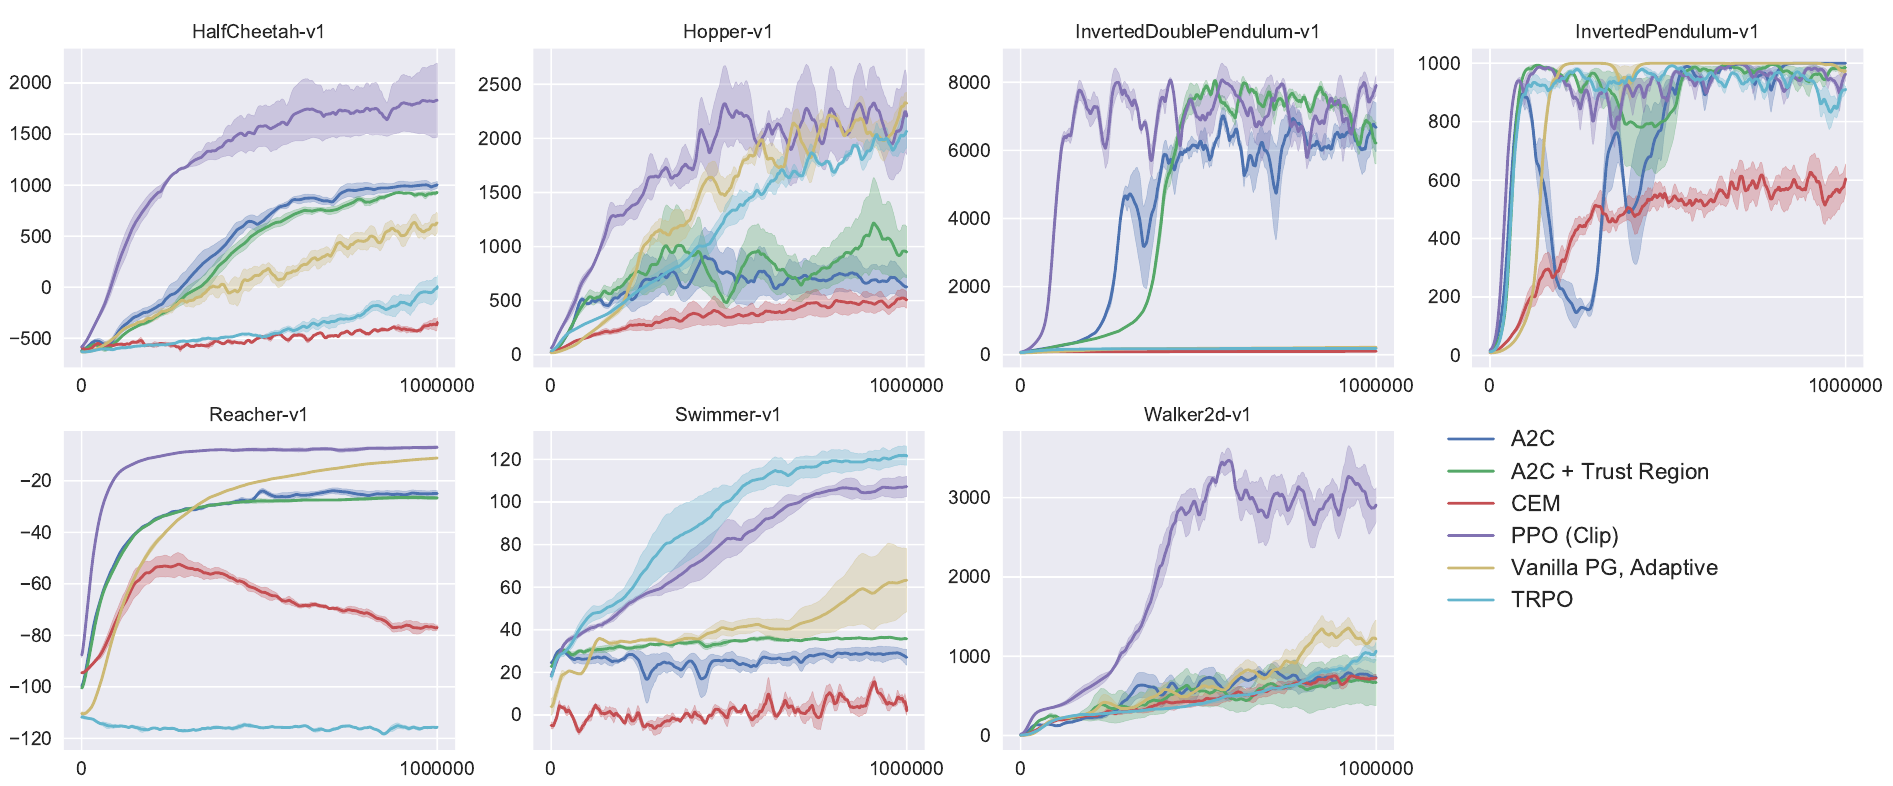
紫の線が PPO だ。比較対象は、調整済みの TRPO、交差エントロピー法(CEM)、適応的ステップ幅の通常の方策勾配、A2C、それに信頼領域を加えた A2C。PPO はほぼすべての環境で勝つ、というのが著者らの結論だ。差が最も大きいのは Walker2d で、PPO は 3,000 前後に達し、ほかの手法はどれも 1,200 以下。HalfCheetah でもはっきりリードしている。Swimmer は例外で、TRPO(薄い青の線)が最後に PPO をわずかに上回る。
著者らはさらに、Roboschool の 3D ヒューマノイドロボットで PPO を披露している。タスクは前へ走る、ランダムに動く目標を追いかける、そして立方体をぶつけられながら地面から起き上がる、というものだ。この実験は学習曲線と映像だけで、ほかのアルゴリズムとの比較はない。
Atari:学習は速く、最終スコアは一長一短
Atari での比較対象は A2C と ACER で、三つとも同じネットワーク構造を使い、A2C と ACER のハイパーパラメータはこのゲーム群向けに調整されている。49 本のゲームでそれぞれ 3 回実験し、二つの指標で、各アルゴリズムが何本のゲームで勝ったかを数える。
| 指標 | A2C | ACER | PPO | 引き分け |
|---|---|---|---|---|
| 訓練期間全体の平均エピソード報酬 | 1 | 18 | 30 | 0 |
| 最後の 100 エピソードの平均報酬 | 1 | 28 | 19 | 1 |
原論文 Table 2 をもとに整理。
一つ目の指標は学習の速い手法に有利で、二つ目は最終的な性能に有利だ。PPO は前者ではっきりリードし、最終的な性能では ACER の勝ちが多い。付録のゲームごとのスコアには、どちらの側にも極端な例がある。Enduro では A2C と ACER がともに 0 点で、PPO は 758。Kangaroo は 45、50 対 9,929。逆に Gopher では ACER が 37,802、PPO はわずか 2,933 で、DemonAttack は 38,808 対 11,378 だ。ACER について著者らは、性能は近いが PPO のほうがずっと簡単だと評価している。
クリップは本当に仕事をしているのか
PPO はすぐに標準のアルゴリズムになり、後続の研究はその効果がどこから来るのかを問い始めた。
MIT の Engstrom らは 2020 年の Implementation Matters in Deep Policy Gradients で、公式実装に含まれるいくつかの「小さな細部」に焦点を当てた。たとえば価値関数の損失にもクリップをかける、割引報酬の標準偏差で報酬をスケーリングする、直交初期化、Adam の学習率のアニーリング、観測値の正規化とクリップ、全体の勾配ノルムを 0.5 でクリップする、といったものだ。論文そのものはこれらの細部を強調していない。Engstrom らの結論は、PPO が TRPO に対して持つ累積報酬の優位の大部分は、こうしたコードレベルの最適化から来ている、というものだった。
彼らは確率比も測った。PPO の訓練中、最大の確率比は を超え続け、クリップは方策をこの範囲に閉じ込めていなかった。先ほどのコードに戻れば理由はわかる。クリップは範囲外のサンプルの勾配をゼロにするだけだが、パラメータはすべてのサンプルで共有されているので、ほかのサンプルの勾配がそのままパラメータを前へ押し、すでに範囲を出たサンプルもついでにさらに遠くへ押してしまう。最初のエポックの開始時にはすべての なので、その一歩はクリップがない場合とまったく同じで、歩幅は目的関数の傾きの急さで決まる。
彼らはさらに PPO-NoClip を作った。これらのコードの細部は残し、クリップだけを外したものだ。Walker2d、Hopper、Humanoid でのスコアはそれぞれ 2,867、2,371、831 で、標準の PPO は 3,292、2,513、806 だった。Walker2d ではまだ約 400 点の差があり、Hopper の差は信頼区間のあたりに収まり、Humanoid ではむしろクリップなしの版がわずかに高い。クリップを残してコードの細部を外した最小版 PPO-M は、三つとも PPO-NoClip より低かった。クリップの重要性は、こうしたコードの細部に及ばないことが多い、というのが著者らの結論だ。
もう一つよく引用されるまとめが、Huang らが 2022 年に ICLR のブログで発表した The 37 Implementation Details of Proximal Policy Optimization だ。彼らは OpenAI baselines の実装を一行ずつ照らし合わせ、13 の核となる細部と、Atari、連続制御、LSTM などの状況での追加の細部を整理した。たとえばアドバンテージの正規化は、バッチ全体ではなくミニバッチごとに行う。価値関数のクリップについては、Engstrom らは役に立つ証拠を見つけられず、別の大規模な研究はむしろ有害だとしている。元の実装そのものですら、走らせた結果があまり一貫しないことにも彼らは触れている。
これらの研究は PPO を覆していない。PPO はこれらの実験でも依然として最も性能のよい設定の一つだ。修正されたのは「なぜ効くのか」の説明のほうである。クリップ付きの目的は複数エポックの更新を比較的安全にするが、論文の数字を安定して再現するには、論文に書かれていないコードの細部も同じくらい重要だ。
言語モデルへの応用
言語モデルに使うときは、各 token が一つの行動で、回答全体が一本の軌跡になる。InstructGPT は PPO に加えて、SFT モデルに対する KL ペナルティを一項追加し、モデルが報酬モデルに取り入ろうとして遠くへ行きすぎないようにした。後に DeepSeek の GRPO は価値ネットワークを取り除き、同じ問題に対する複数の回答のスコアを互いに比べてアドバンテージを推定するようにしたが、clip に min を組み合わせる書き方はそのまま受け継いだ。
結論
PPO の核心は一行の目的関数だけだ。clip は正しい方向へ行きすぎたサンプルにそれ以上点を与えず、min は間違った方向へ進んだサンプルをそのまま減点する。これで同じバッチのデータを安心して何周も回せる。
自分で実装するなら、論文の式で行けるのは道のりの半分までだ。アドバンテージの正規化、報酬のスケーリング、価値関数のクリップといった細部は論文に書かれていないが、成績はそれらに大きく左右される。あの 37 個の細部のリストと一項目ずつ突き合わせていくのがいちばん手っ取り早い。
ここ数年、みんなで PPO の部品を外し続けてきた。DPO は強化学習を外し、GRPO は価値ネットワークを外した。それでもあの clip だけは、今もずっと残っている。