原論文
Learning to summarize from human feedback
- 発表先
- NeurIPS 2020国際会議
- arXiv への初回投稿
- arXiv:2009.01325
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuninglearningtosummarize2020,
  title = {{Learning to summarize from human feedback}},
  author = {Nisan Stiennon and Long Ouyang and Jeff Wu and Daniel M. Ziegler and Ryan Lowe and Chelsea Voss and Alec Radford and Dario Amodei and Paul Christiano},
  year = {2020},
  eprint = {2009.01325},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2009.01325}
}
要約モデルを訓練する標準的なやり方は、人が書いた参照要約で教師あり学習を行い、ROUGE で採点するというものだ。
この二つはどちらも「よい要約」の近似でしかない。最尤推定はモデルに、人が書いたすべての要約に確率を割り振るよう求める。出来の悪い要約も含めてだ。しかも重要な誤りとどうでもいい誤りを区別できず、事実の捏造も同義語の選び間違いも、損失関数の中ではたいして変わらない。ROUGE が数えるのは参照要約と重なる単語で、人間の判断との相関はずっと批判されてきた。
OpenAI の Stiennon、Ouyang、Wu、Ziegler らは 2020 年 9 月にこの論文を発表した。彼らは人に二つの要約を直接比べてもらい、人間の選好を予測する報酬モデルを学習し、それを強化学習で最適化した。その結果、13 億パラメータのモデルが、アノテーターに好まれる割合で 10 倍大きい教師ありモデルを上回り、データセット内の人が書いた参照要約をも上回った。
この流れは 2017 年の Christiano らの「選好から報酬を学ぶ」を受け継ぎ、動画の断片をテキストの要約に置き換えたものだ。チームの責任者はほかならぬ Christiano である。一年半後の InstructGPT は、この三つのステップをほぼそのまま使った。
問題の定義
著者らが要約をテストタスクに選んだのは、研究の歴史が長く、しかも品質がとても主観的で、人の判断に頼らなければ測りにくいからだ。
データセットは Reddit の TL;DR で、約 300 万件の投稿のそれぞれに、投稿者自身が書いた「TL;DR」、つまり長すぎて読まない人向けの要約が付いている。著者らは一般の人には理解しにくいサブレディットを除き、参照要約の長さが 24~48 token の投稿だけを残して、長さが品質の判断に与える影響をできるだけ排除した。最終的に残ったのは 123,169 件だ。(このフィルタ済みデータは後に RLHF の定番の試験問題になり、三年後の DPO 論文の要約実験もこれを使っている。)
より一般的な CNN/DailyMail のニュース要約は、あえて使わなかった。CNN/DM では、記事の冒頭三文をそのまま取る lead-3 ベースラインがかなり強く、アノテーターはデータセットの参照要約より lead-3 のほうを好むほどだ。低温でサンプリングした T5 はすでに参照要約を上回り、しかも原文を大量に丸写ししている。TL;DR では抽出型のベースラインの成績が悪いので、モデルの本当の要約能力が見えやすい。
タスクの定義は、48 token 未満で、できるだけ品質の高い要約を生成することだ。品質の基準は、要約だけを読んで原文を読まない読者が、原文の言っていることをどれだけ忠実に理解できるかにある。
前年、同じチームの Ziegler らは TL;DR と CNN/DM ですでに人間のフィードバックを試していたが、一つの問題にぶつかった。モデルが学んだ「品質」は研究者が求めるものと違っていた、と彼らは報告している。アノテーターがよいと感じた要約は、研究者から見ると品質は並みで、しかもモデルはほとんど原文を丸写しするだけになっていた。では、どうすれば人間のフィードバックに研究者の求める品質を本当に反映させられるのか。
問題を解く
三つのステップ
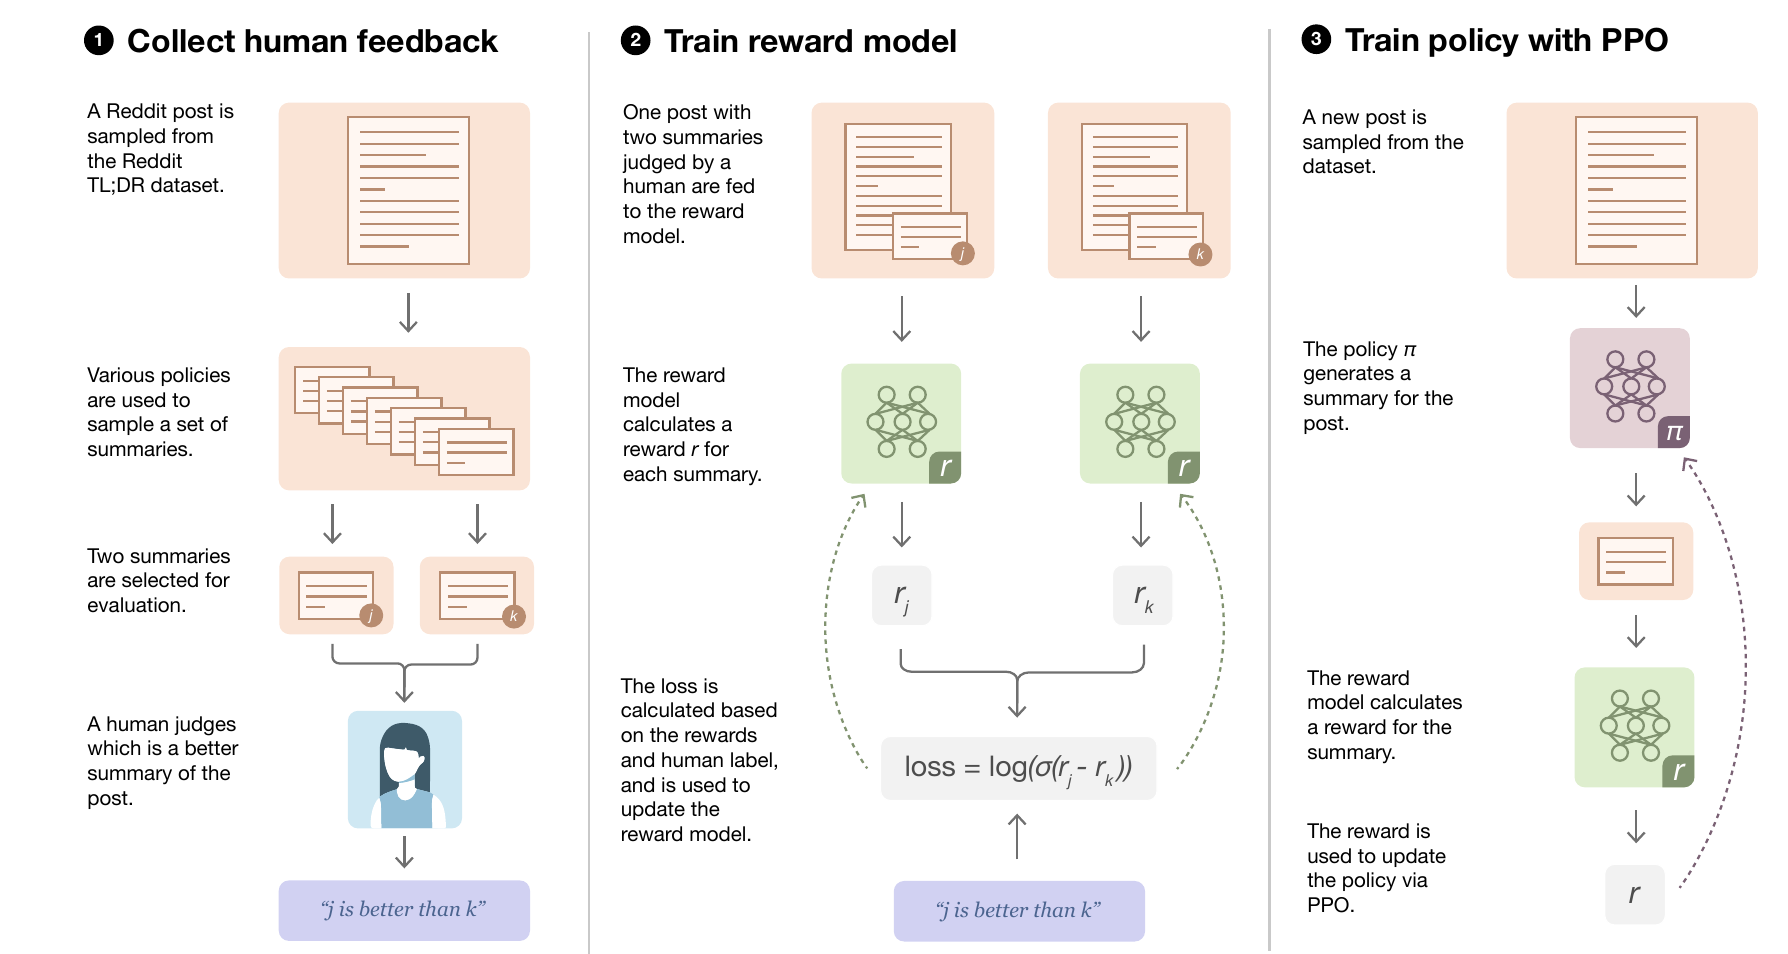
- 人間の比較を集める:各投稿について、現在の方策、初期方策、参照要約、各種ベースラインから要約をサンプリングし、二つずつアノテーターに送って、よいほうを選んでもらう。
- 報酬モデルを訓練する:投稿と一つの要約を与え、その要約が人に選ばれる対数オッズを予測する。
- PPO で方策を最適化する:報酬モデルの出力を報酬として、強化学習で要約モデルを訓練する。
この三つのステップは繰り返し行うことができ、新しい方策のサンプルをまた人の比較に回せる。ただし著者らは、実際には厳密なラウンド単位では回しておらず、ラベルを積み上げる過程でデータ収集と訓練のやり方を絶えず調整していたと認めている。
すべてのモデルは GPT-3 風の Transformer デコーダで、主な実験では 13 億(1.3B)と 67 億(6.7B)パラメータを使う。出発点は TL;DR で教師あり微調整したモデルで、以下 SFT モデルと呼ぶ。これは最初の比較サンプルの生成と、方策および報酬モデルの初期化に使われ、比較のベースラインでもある。
報酬モデル
報酬モデルは SFT モデルから出発し、最後にランダム初期化した線形層を一つ付けて、スカラー を出力する。 は投稿、 は要約だ。人が を選んだとき、損失は次のとおり。
これは 2017 年の論文の Bradley–Terry 損失と同じもので、二つの軌跡の報酬の合計が、二つの要約それぞれのスコアに置き換わっただけだ。 は sigmoid で、二つの要約のスコア差が大きいほど、人がどちらを選ぶかについてモデルの確信が強くなる。訓練が終わったら、著者らは参照要約の平均スコアが 0 になるよう出力をずらしておく。
方策:PPO に KL ペナルティを加える
方策も SFT モデルから初期化する。BPE token を一つ生成するごとに 1 ステップと数え、要約が一つ終わる(EOS を出力する)と一エピソードになる。報酬モデルは最後に要約全体を一度だけ採点し、割引率は だ。
鍵となる設計は、報酬に KL ペナルティの項を加えることだ。
は訓練中の方策、 は凍結した SFT モデルだ。方策の生成した要約が SFT モデルから見て確率の低いものなら、第二項が大きくなり、差し引かれる点も多くなる。
4 token しかない要約で一度計算してみよう。実装では KL ペナルティを各 token に割り振り、報酬モデルのスコアは最後の token にだけ加えることが多い。
import torch

beta = 0.05
rm_score = torch.tensor(2.0)                       # 報酬モデルによる要約全体のスコア
logp_rl = torch.tensor([-1.2, -0.4, -2.0, -0.7])   # RL 方策が各 token を生成した対数確率
logp_sft = torch.tensor([-1.5, -0.5, -3.1, -0.9])  # 同じ token に対する SFT モデルの対数確率

log_ratio = logp_rl - logp_sft     # tensor([0.3000, 0.1000, 1.1000, 0.2000])
rewards = -beta * log_ratio        # まず各 token から KL ペナルティを引く
rewards[-1] += rm_score            # 報酬モデルのスコアは最後の token にだけ加える
print(rewards)                     # tensor([-0.0150, -0.0050, -0.0550,  1.9900])
print(rewards.sum())               # tensor(1.9150)
合計すると上の になる。三番目の token は RL 方策が SFT モデルよりも好む書き方で、対数比は 1.1 あり、いちばん多く差し引かれている。 は論文の主な実験では 0.05 だ。
著者らによれば、このペナルティには二つの役割がある。一つは、エントロピーボーナスと同じように探索を促し、方策が一種類の書き方に潰れてしまうのを防ぐこと。もう一つは、方策の出力が、報酬モデルが訓練中に見た要約から離れすぎないようにすることだ。報酬モデルは SFT モデルの周辺の要約でしか学習していないので、離れすぎるとそのスコアは信用できない。
PPO の価値関数も独立した Transformer で、方策とはパラメータをまったく共有せず、報酬モデルの重みで初期化する。著者らのアブレーションによれば、パラメータを共有すると、訓練の初期に価値関数の更新が事前学習済みの方策を壊してしまう。代償として、RL の段階ではモデル一つ分のメモリが余計に必要になる。方策、価値関数、報酬モデル、KL を計算するための SFT モデルと、同じ大きさのモデルが四つ並ぶ。
ラベルの品質
前作の問題はラベル付けにあった。著者らは二つの変更を加えた。第一に、収集を完全にオフラインにした。比較を一度に大量にアノテーターへ送り、すべて集まってから、それまでに蓄積したすべてのデータで訓練し直す。訓練しながら集めることはもうしない。第二に、アノテーターと密に協力し続けた。
研究者はまず自分たちで多くの比較を行って食い違いを議論し、ラベル付けのガイドラインを書いた。アノテーターは有給の訓練期間を経る。初期には、研究者がどちらを選んだか、その理由は何かがすぐにわかるようになっていた。速度と一致率の基準を満たした人だけが残る。本番のラベル付けでは、アノテーターはまず原文を見ずに、要約についての自分の「素朴な解釈」を書き留め、それから A が B よりよいとどれだけ確信しているかを 9 段階の尺度で示す。各人には 10~20% の共通問題が割り当てられ、較正に使われる。チームは共有のチャットルームを開いて質問に答え、ときどきアノテーターと一対一のビデオ通話で食い違いを話し合い、成績の最も悪い人を外した。
結果として、アノテーターと研究者の一致率は 77% ± 2% に達し、研究者どうしでは 73% ± 4% にとどまった。比較そのものが主観的で、研究者どうしでもよく意見が割れる。この数字は、アノテーターと研究者の一致の度合いが、研究者どうしの一致と同程度にまで達したことを示している。最終的に公開されたデータセットには、64,832 件の要約比較が含まれる。
議論
主な結果:参照要約を上回る
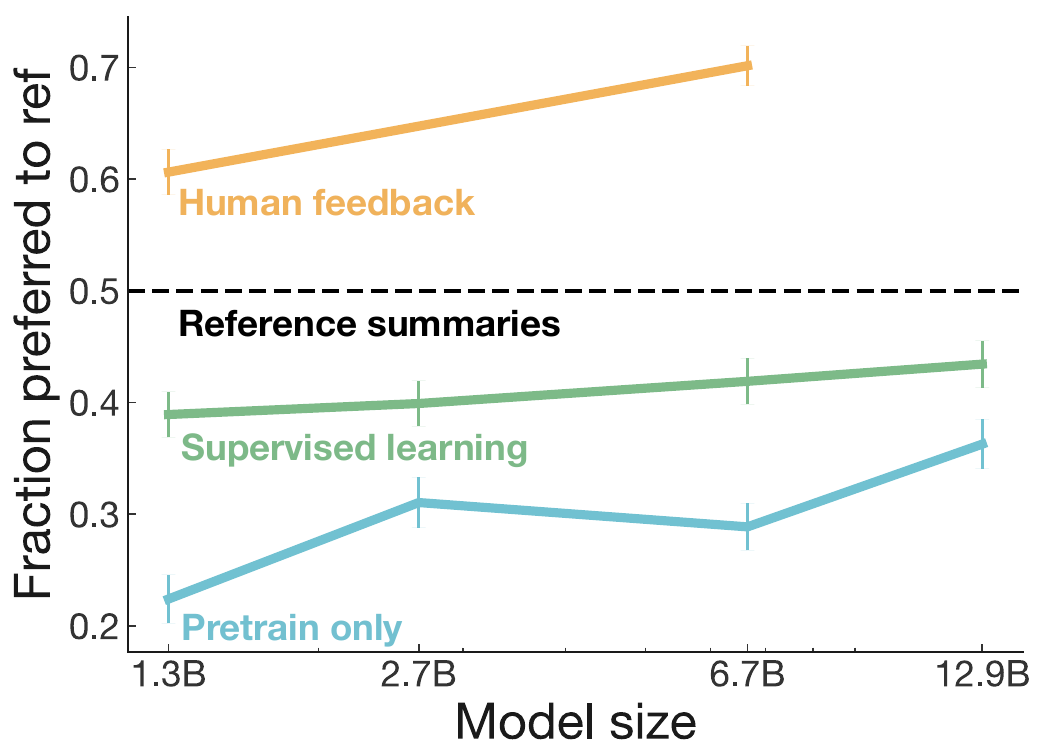
縦軸は、アノテーターがモデルの要約を参照要約より好んだ割合で、0.5 の破線は人が書いた要約と互角であることを表す。三本の線は、事前学習のみ(プロンプトに例を詰め込んだゼロショット)、教師あり微調整、人間のフィードバックで訓練したモデルだ。
1.3B の人間フィードバックモデルが好まれた割合は 61% で、10 倍大きい教師ありモデル(12.9B、43%)より一段高い。6.7B の人間フィードバックモデルではさらに約 70% まで上がり、この手法も規模の恩恵を受けることがわかる。教師ありモデルは 12.9B まで大きくしても、依然として参照要約に負けている。
長さは交絡要因だ。人間フィードバックモデルは長めの要約を書くことを覚えた。48 token の上限の中では、少し多く書くほうがたいてい多くの情報を含められる。著者らがロジスティック回帰で長さを制御すると、人間フィードバックモデルの参照要約に対する選好率は約 5% 下がったが、6.7B モデルはまだ約 65% あった。図のキャプションにも、6.7B では人間フィードバックモデルと教師ありモデルの差のおよそ三分の一が長さで説明されると明記されている。
著者らはさらに、網羅性、正確さ、一貫性、全体的な品質の四つの観点から、7 段階の尺度でアノテーターに採点してもらった。人間フィードバックモデルはどの観点でも教師ありのベースラインを上回り、差が最も大きかったのは網羅性だ。6.7B の PPO モデルでは要約の 45% が全体評価で満点の 7 点を取り、教師ありのベースラインは 20%、参照要約は 23% だった。
ニュースへの転移
Reddit だけで訓練した人間フィードバックモデルを、ニュースに関する微調整を一切せずに、そのまま CNN/DM のニュース要約に使う。同じく TL;DR で訓練した教師ありモデルをはっきり上回り、6.7B 版は CNN/DM で直接教師あり微調整した 6.7B モデルにほぼ追いついた。しかも要約の長さは相手の半分ほどしかない。
ここでの比較には 7 段階の尺度を使う。両者の長さの分布がほとんど重ならないので、二つずつ直接比べるのが難しいからだ。著者らが長さでグループ分けしてみると、人間フィードバックモデルはもっと長く書けばスコアがさらに上がる可能性があることがわかった。
最適化しすぎるとどうなるか
報酬モデルはアノテーターの選好の近似にすぎない。容量には限りがあり、見たことがあるのも範囲の狭い要約の集まりだけだ。では、それに対してどこまで最適化すると、スコアが信用できなくなるのか。
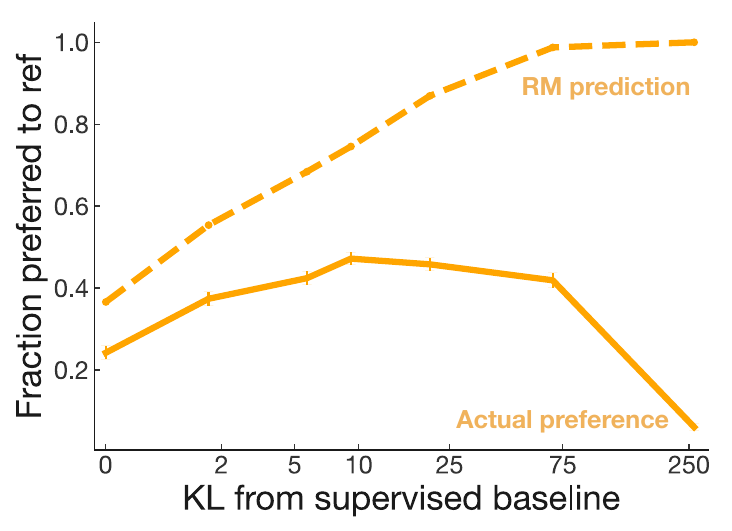
著者らは、少し前のバージョンの報酬モデルを使い、異なる KL 係数 で一連の方策を訓練した。 が小さいほど方策は SFT モデルから遠ざかり、横軸の KL は大きくなる。破線は報酬モデル自身が予測した選好率で、上がり続け、右端では 100% 近くになる。実線はアノテーターの実際の選好だ。軽く最適化するうちは一緒に上がり、KL 約 10 のところで頭打ちになると、そこから下がり始め、KL 250 ではほぼゼロまで落ちる。最終的に、報酬モデルは人の選好と負の相関を示すようになった。
付録には、KL 250 の方策による要約が載っている。体操を習いたい 28 歳男性の投稿は「28yo dude stubbornly postponees start pursuing gymnastics hobby citing logistics reasons despite obvious interest???」と要約され、その後に文法の崩れた、汚い言葉まじりの文がずらずらと続く。付録に載った何本かの要約には、ほぼどれにも同じ「want change this ...」という一句が顔を出す。著者らの評は、これらの要約は長くて奇妙だが、大意はなんとか捉えている、というものだ。
これこそ、先ほどの KL ペナルティが防ごうとしているものだ。OpenAI は 2022 年の Scaling Laws for Reward Model Overoptimization で、固定した「ゴールド」報酬モデルに人間の役をさせてこの曲線を系統的に測り、その形が最適化手法によって異なり、係数は報酬モデルのパラメータ数に応じてなめらかに変わることを見つけた。ROUGE にも同じ問題がある。best-of-N サンプリングで ROUGE に対して最適化すると、報酬モデルに対して最適化するよりも早く品質が頭打ちになり、その頂点もずっと低い。
報酬モデルは何を学んだか
著者らは 7 つの報酬モデルを訓練した。パラメータは 1.6 億から 130 億、データは 8k から 64k 件の比較だ。データを倍にすると検証精度は約 1.1% 上がり、モデルを倍にすると約 1.8% 上がる。全データで訓練した 6.7B の報酬モデルは、精度が単独のアノテーターの水準に近づき始めた。
訓練に使っていない CNN/DM では、1.3B と 6.7B の報酬モデルとアノテーターの一致率はそれぞれ 62.4% と 66.5% で、アノテーターどうしでは 66.9% だった。
細部にも敏感だ。アノテーターに要約を最小限だけ改善してもらうと、6.7B の報酬モデルは 82.8% の確率で改善後の版を選び、別のグループの人間の評価者は 84.1% だった。参照要約の中の二人の人物の役割を入れ替えると、6.7B モデルは 97.2% の確率で元の正しい版を選び直す。
偏りも見つかる。「要約を短くする」という改善に対して、6.7B の報酬モデルが同意する確率は 62.6% しかなく、人間は 76.4% だった。報酬モデルは長い要約を好み、これは先ほどの、人間フィードバックモデルが長めに書く傾向とも呼応している。
ROUGE の成績は、モデルが強くなるほど悪くなる。教師ありモデルの二つのサンプルを比べるとき、ROUGE とアノテーターの一致率は約 57% だが、人間フィードバックモデルの二つのサンプルを比べると約 50% まで落ち、コイン投げと変わらない。教師ありモデルの対数確率を指標にしても同じで、人間フィードバックモデルのサンプルでは 50% を下回るが、報酬モデルはまだ 62% ある。
代償
最も直接的な限界はコストだ。6.7B モデルの RL 微調整には約 320 GPU 日かかった。訓練セットにはアノテーターの数千時間が費やされ、品質を保つには研究者の時間も大量に必要だった。コストが高すぎたため、著者らは重要な対照実験を一つ行えなかった。同じ量の高品質な人間のデモンストレーションで教師あり学習をしたらどうなるか、という比較だ。
2024 年、Huang らはこの流れをゼロから再現し、二十を超える重要な実装上の細部を列挙するとともに、Pythia モデルで、品質がモデル規模とともに上がる傾向を再現した。彼らの 2.8B と 6.9B のモデルは、OpenAI が公開した 1.3B の checkpoint を上回った。
結論
1.3B の人間フィードバックモデルは、10 倍大きい教師ありモデルより好まれ、Reddit の投稿者自身が書いた TL;DR よりも好まれた。採点基準を書けないタスクでも、人に比べてもらい、その比較をモデルに追わせるやり方は通用する。
自分でやるなら、この論文でいちばんそのまままねる価値があるのは、意外にもラベル付けの流れのほうだ。まずガイドラインを書き、まず較正を行い、共通問題を残し、研究者との一致率から目を離さない。そうしてはじめて、報酬モデルは求める品質を学べる。PPO の部分は、それに比べればずっと扱いやすい。
それから、KL ペナルティは絶対に省かないこと。これがないと、モデルはすぐに、報酬モデルは喜ぶが人には読めない文を書くことを覚えてしまう。