原始論文
Arcee's MergeKit: A Toolkit for Merging Large Language Models
- arXiv 首次提交
- arXiv:2403.13257
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingmergekit2024,
  title = {{Arcee's MergeKit: A Toolkit for Merging Large Language Models}},
  author = {Charles Goddard and Shamane Siriwardhana and Malikeh Ehghaghi and Luke Meyers and Vlad Karpukhin and Brian Benedict and Mark McQuade and Jacob Solawetz},
  year = {2024},
  eprint = {2403.13257},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.13257}
}
Hugging Face 上曾經冒出一大批名字很長的模型,時間大約在 2023 年底到 2024 年初。
它們的名字常常帶著 slerp、ties、dare 這類字樣,或者乾脆把兩三個模型的名字串在一起。這些模型沒有經過新的訓練,作者只是把幾個現成的微調模型權重混在一起,就上傳了;其中不少還一度爬上 Open LLM Leaderboard 的前段。
背後的工具多半是同一個,Arcee 的 Charles Goddard 等人開發的開源函式庫 MergeKit。這篇論文是它的正式介紹,篇幅不長,主要在講工具怎麼設計、支援哪些方法,再附上一組醫學領域的合併實驗。
讀這篇的價值,在於看清楚「模型合併」從論文走到社群日常時,實際長成什麼樣子。
定義問題
模型合併的研究已經累積了好幾年,從權重平均、Model Soups、任務算術,到 TIES-Merging 與 DARE。但每篇論文的程式碼各寫各的,大多針對特定模型與資料集,要拿來合併兩個 70B 的語言模型,會遇到很實際的問題:
- 記憶體:兩個 70B 模型以 16 位元存放就是兩三百 GB,一般機器載不下,更別說同時放好幾個。
- 架構差異:Llama、Mistral、Qwen 的權重命名與層結構不同,每種都要個別處理。
- 配方難以重現:哪個模型給多少權重、哪幾層用什麼方法,寫在臨時腳本裡,別人很難照做。
作者想做的,是一個讓不會寫程式的人也能合併模型、讓研究者能方便加入新方法的共用工具。
解決問題
論文怎麼分類合併方法
作者先替合併方法做了一個分類,也標出 MergeKit 支援到哪裡。
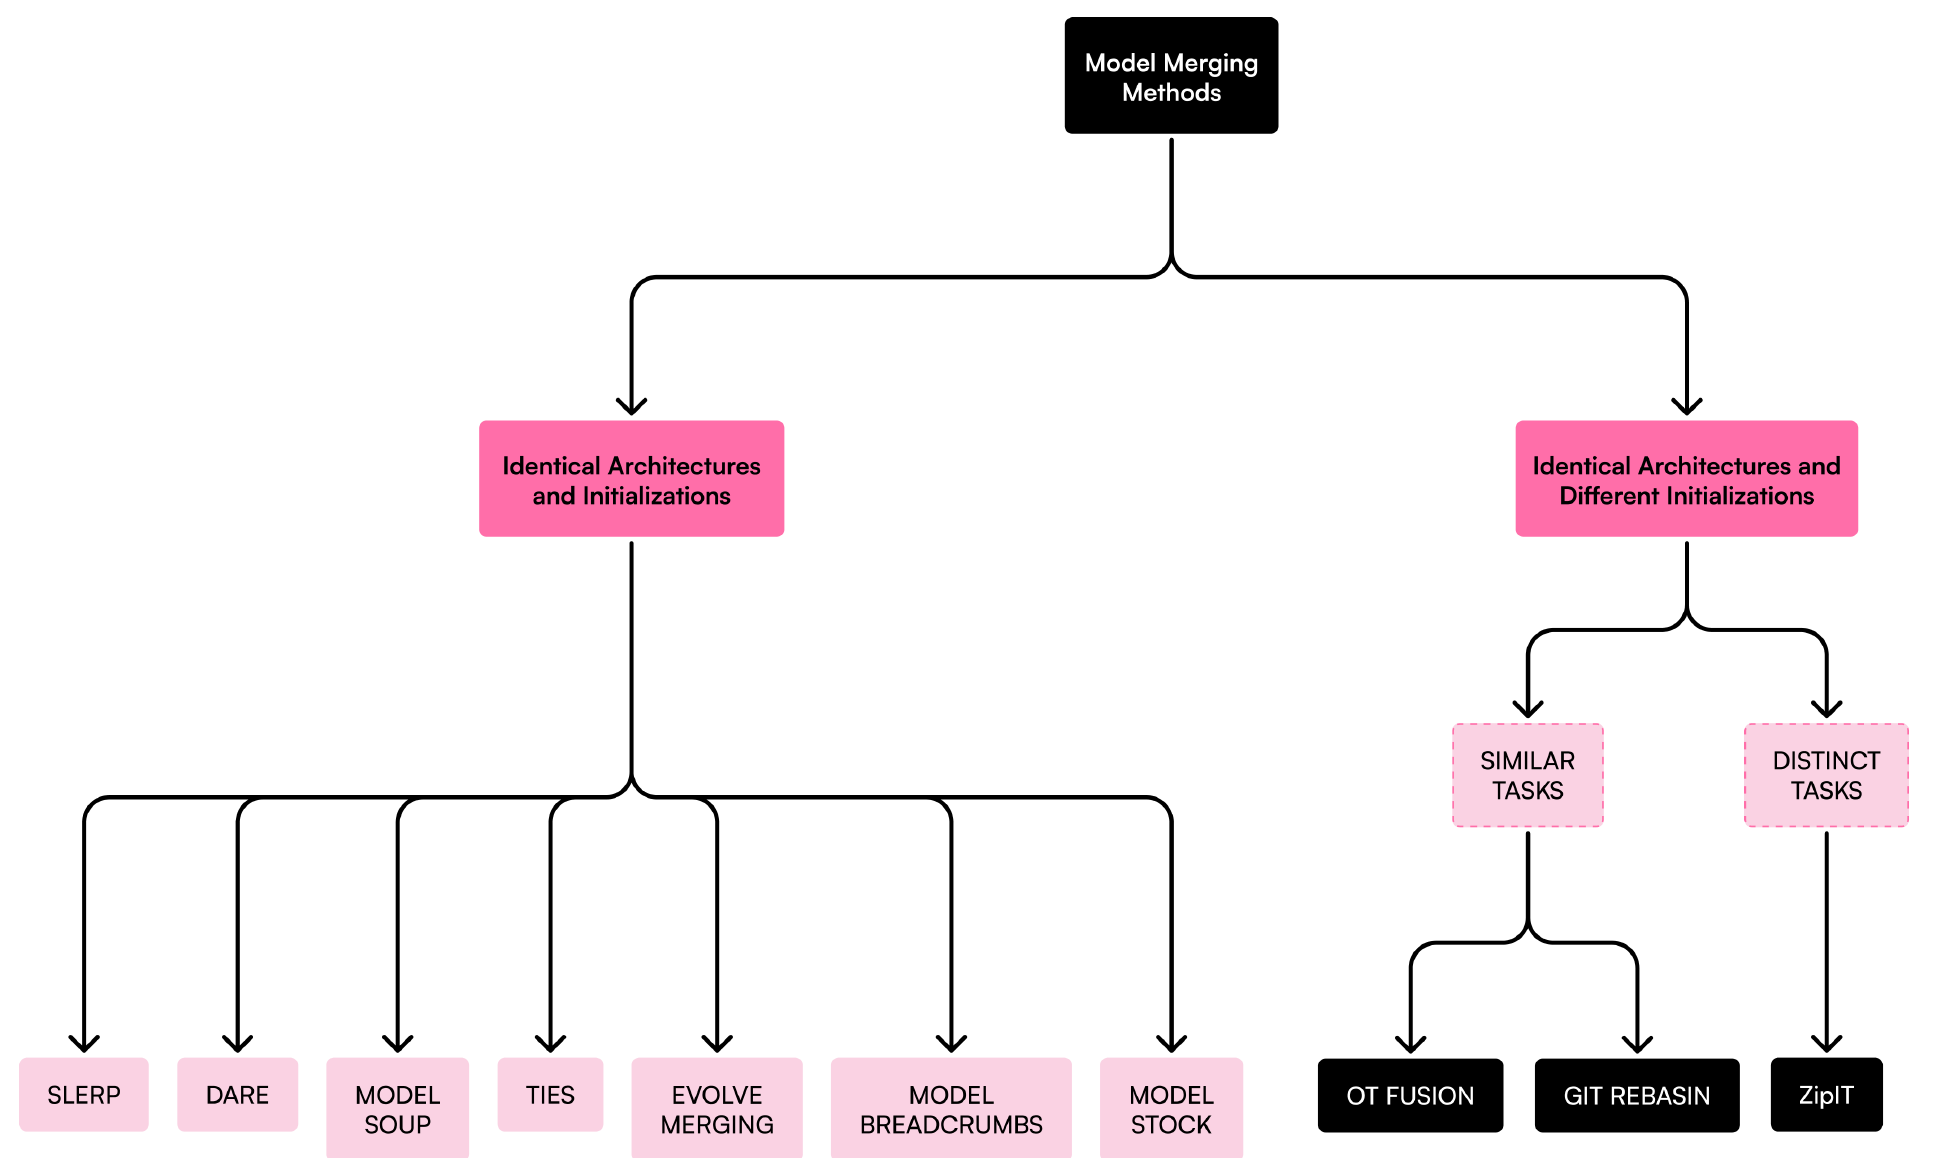
分類的依據是兩件事:模型的架構是否相同,以及是否來自同一個初始化。
左邊那一支是 MergeKit 實際支援的範圍,全部要求「架構相同、從同一個基底模型出發」。這正是線性模式連通與任務算術成立的條件。右邊那一支處理獨立訓練的模型,需要先做神經元對齊,論文寫作時還沒支援。作者也坦白說,右邊這些方法目前還沒有左邊那樣的廣泛使用。
架構完全不同的模型,例如 CALM 用交叉注意力把兩個模型接起來、FuseLLM 對齊兩個模型的輸出分布,都需要額外訓練,作者把它們列為「融合」而不是合併。
合併配方就是一份 YAML
MergeKit 的主要介面是 YAML 設定檔。設定檔裡寫明合併方法、輸入模型,以及方法需要的參數,執行時只要一行指令:
mergekit-yaml path/to/your/config.yml ./output-model-directory
一份 TIES 合併的設定,可以寫成這樣(取自官方 examples/ties.yml):
models:
  - model: psmathur/orca_mini_v3_13b
    parameters:
      density: [1, 0.7, 0.1] # density gradient
      weight: 1.0
  - model: garage-bAInd/Platypus2-13B
    parameters:
      density: 0.5
      weight: [0, 0.3, 0.7, 1] # weight gradient
  - model: WizardLM/WizardMath-13B-V1.0
    parameters:
      density: 0.33
      weight:
        - filter: mlp
          value: 0.5
        - value: 0
merge_method: ties
base_model: TheBloke/Llama-2-13B-fp16
parameters:
  normalize: true
  int8_mask: true
dtype: float16
三個 13B 模型都是從同一個 Llama-2-13B 微調出來的,base_model 指定這個共同基底,任務向量就是各模型和它的差。density 是 TIES 修剪後保留的比例,weight 是每個任務向量的權重。
這份設定檔還用到兩個功能。
第一,參數可以寫成列表。density: [1, 0.7, 0.1] 會沿著層的深度插值成一條「梯度」,淺層保留全部、越深層保留越少。
第二,參數可以用 filter 指定作用範圍。WizardMath 的設定是 MLP 層給 0.5 的權重,其他張量給 0,也就是只取它 MLP 層的改動。
設定檔的好處,是合併配方變成可以分享、重現、改寫的文字。社群裡很多合併模型的模型卡,直接附上了這樣一份 YAML。
SLERP 為什麼常見
MergeKit 支援的方法中,社群最常用的之一是 SLERP(spherical linear interpolation,球面線性插值)。它來自 1985 年的電腦動畫研究,原本用來平滑插值旋轉。
兩個張量 、 之間,一般的線性插值是 。SLERP 則先算出兩者正規化後的夾角 ,再沿著球面走:
兩者差在哪裡?取兩個長度為 1、夾角 90 度的向量,線性插值的中點長度只剩 ;SLERP 的中點長度仍是 1。夾角越大,線性插值把權重「縮短」得越多。
但從同一個基底微調出來的語言模型,權重之間的夾角通常很小。夾角只有 2 度時,線性插值的中點長度是 ,兩種方法幾乎沒有差別。MergeKit 的實作也考慮到這點,當兩個張量的正規化內積超過 0.9995 時,直接退回一般的線性插值。
論文說 SLERP 的成功顯示「球面路徑常常比直線有更低的損失障礙」,這是作者的說法,論文裡沒有提供對應的障礙量測。
另外,SLERP 一次只能合併兩個模型,所以前面的範例改用 TIES。官方 gradient-slerp.yml 範例則示範了 SLERP 的另一種用法,讓 attention 和 MLP 用不同的插值係數,而且係數沿層深度變化,例如 attention 從 漸變到 ,MLP 反過來。
不做加減的兩種合併
MergeKit 還有兩種方法完全不在參數空間做運算。
Passthrough,社群叫它「FrankenMerging」,把不同模型的層直接拼接起來,做出一個層數不尋常的新模型。熱門的 Goliath-120B 把 Xwin 與 Euryale 兩個 Llama-2 70B 微調模型的層段,每段 16 層左右、前後部分重疊地交錯接起來。SOLAR-10.7B 的 Depth Up-Scaling 第一步也是這樣,把同一個 32 層模型複製兩份,一份去掉最後 8 層、一份去掉最前 8 層,接成 48 層,之後再繼續預訓練。
mergekit-moe,社群叫「FrankenMoE」,把幾個稠密模型當成專家,組成一個混合專家(MoE)模型。路由器可以用提示詞的隱藏狀態做語意路由,也可以隨機初始化,之後再訓練。
這兩種方法都不涉及任何對齊或插值的理論,拼出來能不能用,只能靠評測說話。
在筆電上合併 70B 模型
MergeKit 的效率來自「out-of-core」的設計。它不會一次把整個模型載入記憶體,而是只載入當下這個運算需要的張量。
一次合併在內部被表示成一張有向無環圖(DAG),每個節點是一個運算。排程器依照這張圖決定執行順序,讓同一時間需要放在記憶體裡的資料越少越好,用不到的中間結果也會自動釋放。作者說這讓 MergeKit 可以從研究叢集一路縮到沒有 GPU、記憶體有限的筆電上執行。
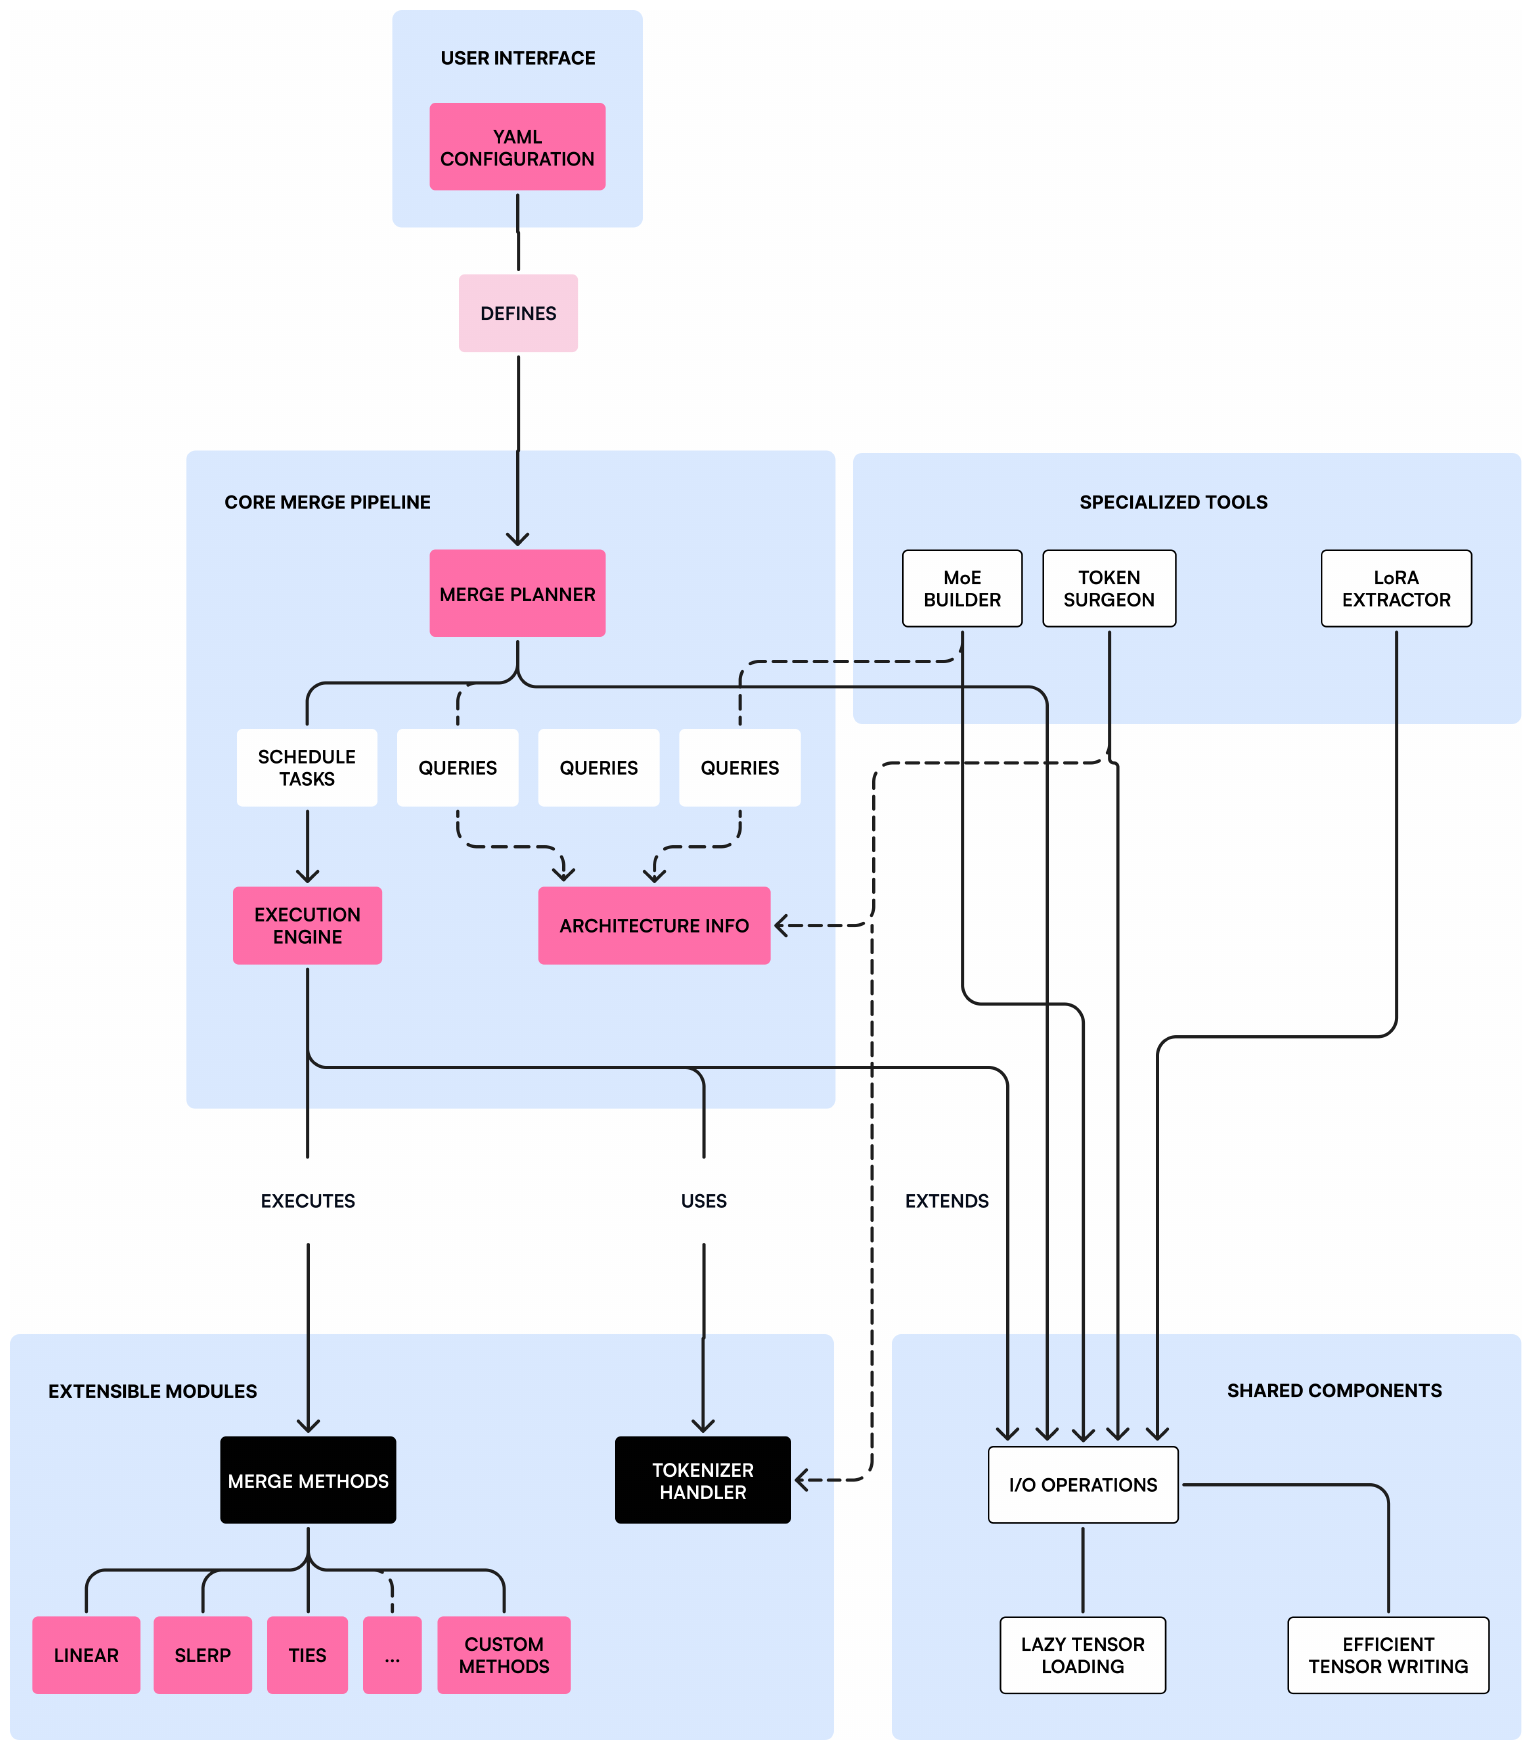
這張架構圖對想加入新方法的人最有用。作者列出幾個要先熟悉的模組:merge_methods/base.py 定義新方法要實作的介面,graph.py 負責排程與資料搬移,plan.py 建立運算圖,architecture.py 描述各種模型的結構,大多數架構只用一個簡單的 JSON 檔定義。
討論
一組醫學實驗
論文唯一的實驗,是把醫學模型 Meditron-7B 和 Llama2-7B-Chat 合併。兩者都從 Llama2-7B 基底出發,Meditron 另外在大量醫學語料上繼續預訓練。
| 模型 | USMLE | MedMCQA | PubMedQA | ARC-C | HellaSwag | MMLU |
|---|---|---|---|---|---|---|
| Llama2-7B-Chat | 35.90 | 35.45 | 73.40 | 44.20 | 55.40 | 46.37 |
| Meditron-7B | 38.40 | 24.07 | 71.40 | 40.20 | 54.50 | 33.06 |
| LERP | 39.10 | 36.65 | 75.60 | 46.76 | 58.66 | 48.44 |
| SLERP | 39.20 | 36.91 | 75.60 | 46.84 | 58.67 | 47.97 |
| DARE-TIES | 36.37 | 27.56 | 72.20 | 42.92 | 54.79 | 41.17 |
| TIES | 38.73 | 32.27 | 75.60 | 45.05 | 58.23 | 45.03 |
前三欄是醫學考題與問答,後三欄是一般能力。
除了 DARE-TIES 在 USMLE 上低於 Meditron-7B(36.37 對 38.40),合併模型在三項醫學題上都比 Meditron-7B 好;LERP 和 SLERP 在一般能力上也超過 Llama2-7B-Chat。作者據此認為醫學領域上 SLERP 最好。
但讀這張表要小心幾件事。第一,LERP 和 SLERP 的差距大多在 0.5 個百分點以內,MMLU 甚至是 LERP 比較高,這和前面算的「夾角很小時兩者幾乎一樣」一致。第二,表中沒有交代合併係數、評測的提示格式與重複次數,也沒有變異數,無法判斷這些差距是否穩定。第三,只有一組模型、一個領域。這組實驗比較像使用範例,不足以拿來比較方法的優劣。
排行榜上的合併熱潮
論文說 MergeKit「促成了數千個模型的合併」。這股熱潮也帶來問題。
2024 年 3 月,有使用者在 Open LLM Leaderboard 的討論區抱怨,排行榜預設隱藏帶有「merge」標籤的模型,讓他們的合併模型失去曝光。維護排行榜的 Hugging Face 人員回覆,隱藏的原因是合併模型的血緣幾乎無法追溯,一層層合併下來,很難知道裡面混進了哪些資料,很容易意外污染評測集;而且這類模型的分數,常常無法轉化成實際使用上的能力(討論串)。
這不是 MergeKit 本身的錯,但它說明了一件事。合併讓產生新模型的成本趨近於零,評測的可信度卻沒有跟著提高。把一堆在排行榜上分數高的模型合在一起,分數也許會更高,但那可能只是把每個模型各自沾到的考題加在一起。
授權的轉折
MergeKit 一開始以 LGPL v3 釋出。2025 年 2 月,Arcee 在發布 v0.1 時改用 Business Source License,理由是要支撐長期開發;同年 10 月 31 日又宣布改回 LGPL v3,舊版的 BSL 釋出保留在版本歷史中。如果你的專案固定在某個舊版本,可以先確認那個版本適用哪一種授權。
結論
MergeKit 這篇論文沒有提出新的合併理論,它的貢獻是工程上的。把各篇論文的方法收進同一個框架,用 YAML 讓合併配方可以分享,用延遲載入讓大模型可以在小機器上合併。
正因為它太好用,模型合併才會在 2024 年從論文變成社群的日常。後來的 Llama 3、Tülu 3 等模型的技術報告裡,也都可以看到合併被寫進正式的訓練流程。
自己動手前,先記得一件事。MergeKit 讓合併只剩一份 YAML 的工夫,評測可不會跟著變簡單。