Article original
Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters
- Publication
- ICLR 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2408.03314
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerstesttimecompute2024,
  title = {{Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters}},
  author = {Charlie Snell and Jaehoon Lee and Kelvin Xu and Aviral Kumar},
  year = {2024},
  eprint = {2408.03314},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.03314}
}
Face à un problème difficile, on prend le temps de réfléchir un peu plus. Un modèle de langage peut-il faire de même, et dépenser un peu plus de calcul avant de répondre pour améliorer sa réponse ?
Mi-2024, les indices sur la question étaient contradictoires. Le vote majoritaire, le best-of-N et les méthodes du même genre fonctionnent bel et bien ; mais certains travaux montraient aussi que, sur des tâches complexes comme le raisonnement mathématique, laisser le modèle réfléchir sur sa réponse et la corriger lui-même n'apportait que très peu, voire dégradait les résultats. Le calcul supplémentaire dépensé à l'inférence en vaut-il la peine, et comment le dépenser ? Personne ne l'avait comparé de façon systématique.
Snell, de UC Berkeley, s'y est attelé pendant un stage chez Google DeepMind, avec Lee, Xu et Kumar. Ils veulent répondre à deux questions. Pour un budget de calcul donné à l'inférence, quelle est la meilleure façon de le dépenser ? Et plutôt que d'agrandir le modèle, vaut-il mieux consacrer le même calcul à l'inférence ?
Définir le problème
Proposeur et vérificateur
Les auteurs regroupent les différentes méthodes appliquées à l'inférence selon deux axes réglables :
- Modifier la distribution de proposition : amener le modèle à produire de meilleures réponses, soit en l'entraînant avec des méthodes comme STaR ou ReSTEM, soit, à l'inférence, en lui faisant relire ses réponses précédentes pour les corriger, encore et encore.
- Sélectionner avec un vérificateur : produire de nombreuses réponses, puis laisser un vérificateur choisir. Le plus simple est le best-of-N, qui échantillonne N réponses complètes et garde celle qui a le meilleur score ; on peut aller plus loin avec un modèle de récompense de processus (PRM) qui note chaque étape, pour faire une recherche arborescente au fil du raisonnement.
Ce que « optimal » veut dire
Les auteurs définissent la « stratégie optimale d'allocation du calcul à l'inférence » comme le choix, pour un problème et un budget de calcul , de la configuration qui maximise la probabilité de bonne réponse :
Ici, peut indiquer s'il faut chercher ou non, quel type de recherche employer, combien de révisions faire, combien d'échantillons tirer en parallèle.
Optimiser chaque problème séparément n'est pas réaliste ; les auteurs se rabattent sur une approximation par la difficulté du problème. La difficulté est définie par rapport au modèle lui-même : on échantillonne 2 048 réponses par problème, on calcule le taux de réussite d'une seule tentative, puis on répartit tous les problèmes en cinq quantiles, du plus facile au plus difficile. On cherche sur le jeu de validation la meilleure stratégie pour chaque niveau de difficulté, puis on l'applique aux problèmes de test.
Cette définition de la difficulté suppose de connaître la bonne réponse ; les auteurs parlent de difficulté oracle. En déploiement réel, la réponse n'est pas disponible ; il existe donc aussi une « difficulté prédite par le modèle », qui classe les problèmes d'après le score moyen attribué par le vérificateur aux mêmes 2 048 réponses. Les auteurs reconnaissent que l'estimation de la difficulté coûte elle-même beaucoup de calcul, et que leurs expériences ne l'incluent pas.
Dispositif expérimental
- Données : MATH, avec le découpage de Lightman et al., 12 000 problèmes d'entraînement et 500 de test.
- Modèle : PaLM 2-S* (Codey). Il obtient des résultats honorables sur MATH sans être saturé, ce qui en fait un bon sujet d'étude.
- Fine-tuning : demander directement au modèle existant de réviser ses réponses ou de vérifier des étapes ne donne pas de bons résultats ; les deux capacités font donc chacune l'objet d'un fine-tuning dédié. Les auteurs s'attendent à ce que les futurs modèles acquièrent ces capacités dès le préentraînement.
Résoudre le problème
1. Chercher avec un PRM
Entraîner le PRM : les auteurs ont d'abord utilisé PRM800K, publié par Lightman et al., mais le PRM ainsi entraîné se laissait facilement exploiter ; même le plus simple des best-of-N trouvait des réponses qui le trompaient. Ils supposent que c'est parce que les solutions de PRM800K ont toutes été écrites par GPT-4 et diffèrent trop des sorties de PaLM 2.
Ils adoptent donc l'approche de Math-Shepherd, qui se passe d'annotation humaine. À partir de chaque étape d'une solution, on laisse le modèle terminer la solution plusieurs fois, et la proportion de parcours qui aboutissent à la bonne réponse sert de score à l'étape. Le PRM ainsi entraîné prédit en fait, à chaque étape, « la probabilité de finir par trouver la bonne réponse à partir d'ici ». Comparé à l'ORM, qui ne regarde que la réponse finale, le PRM fait toujours mieux.
Agréger les scores : pour le score global d'une solution, Lightman et al. utilisaient le produit des scores des étapes ; ici, on prend la prédiction du PRM à la dernière étape, qui donne les meilleurs résultats selon les auteurs. Entre plusieurs solutions, on utilise le « best-of-N pondéré » ; on additionne les scores des solutions qui aboutissent à la même réponse finale et l'on retient la réponse au total le plus élevé.
Ne regarder que la solution la mieux notée, c'est risquer de se laisser piéger par une mauvaise réponse au score gonflé ; la pondération prend en considération à la fois le nombre de voix et les scores.
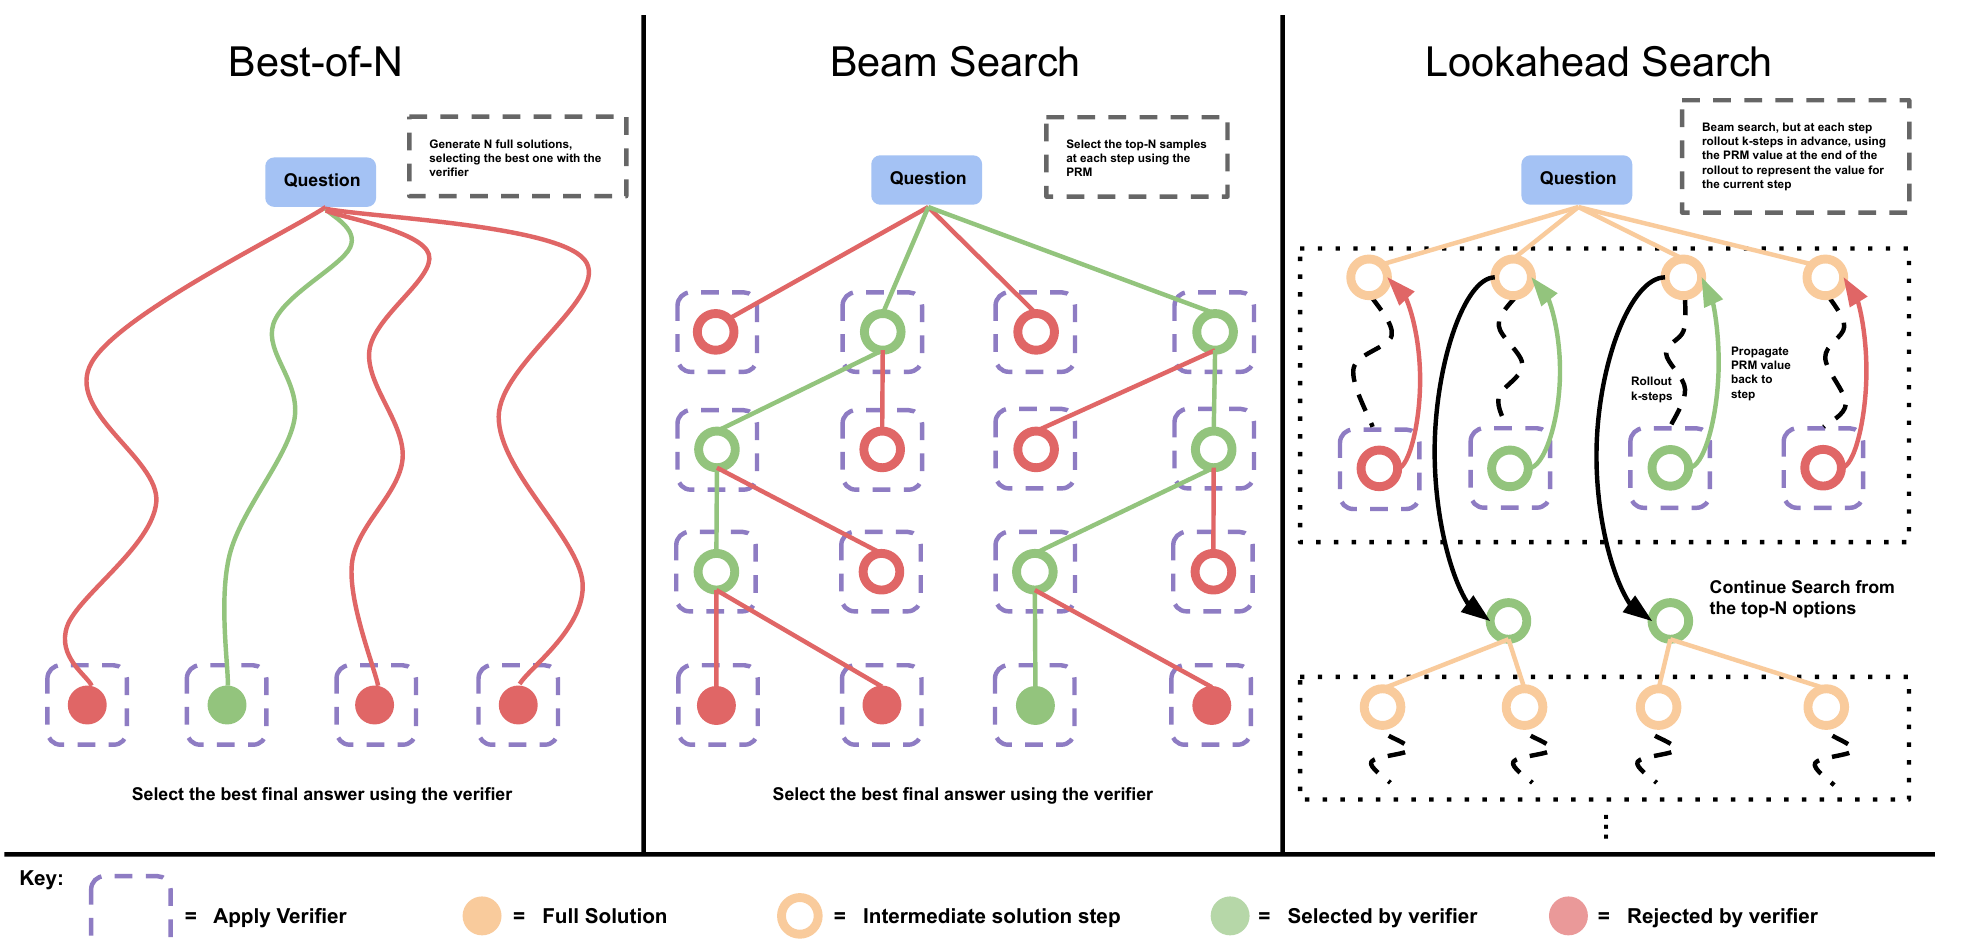
Trois méthodes de recherche :
- Best-of-N pondéré : on échantillonne indépendamment N solutions et l'on choisit avec la pondération décrite plus haut.
- Recherche en faisceau : on maintient N candidates, avec une largeur de faisceau M. À chaque étape, on produit d'abord N étapes candidates, le PRM les note, on garde les N/M meilleures, et chacune est développée en M nouvelles étapes ; on répète jusqu'à la fin de la solution, sur 40 tours au maximum.
- Recherche par anticipation : comme la recherche en faisceau, mais pour évaluer chaque étape, on déroule d'abord jusqu'à k étapes en avant à température 0, et le score PRM au bout du déroulement représente l'étape. L'estimation de la valeur est plus précise, au prix de plus de calcul ; le coût est compté comme échantillons. Les auteurs remarquent qu'on peut y voir un MCTS privé de son exploration aléatoire ; le PRM étant déjà entraîné, ce qu'il faut à l'inférence, c'est de l'exploitation et non de l'exploration.
2. Laisser le modèle réviser ses réponses
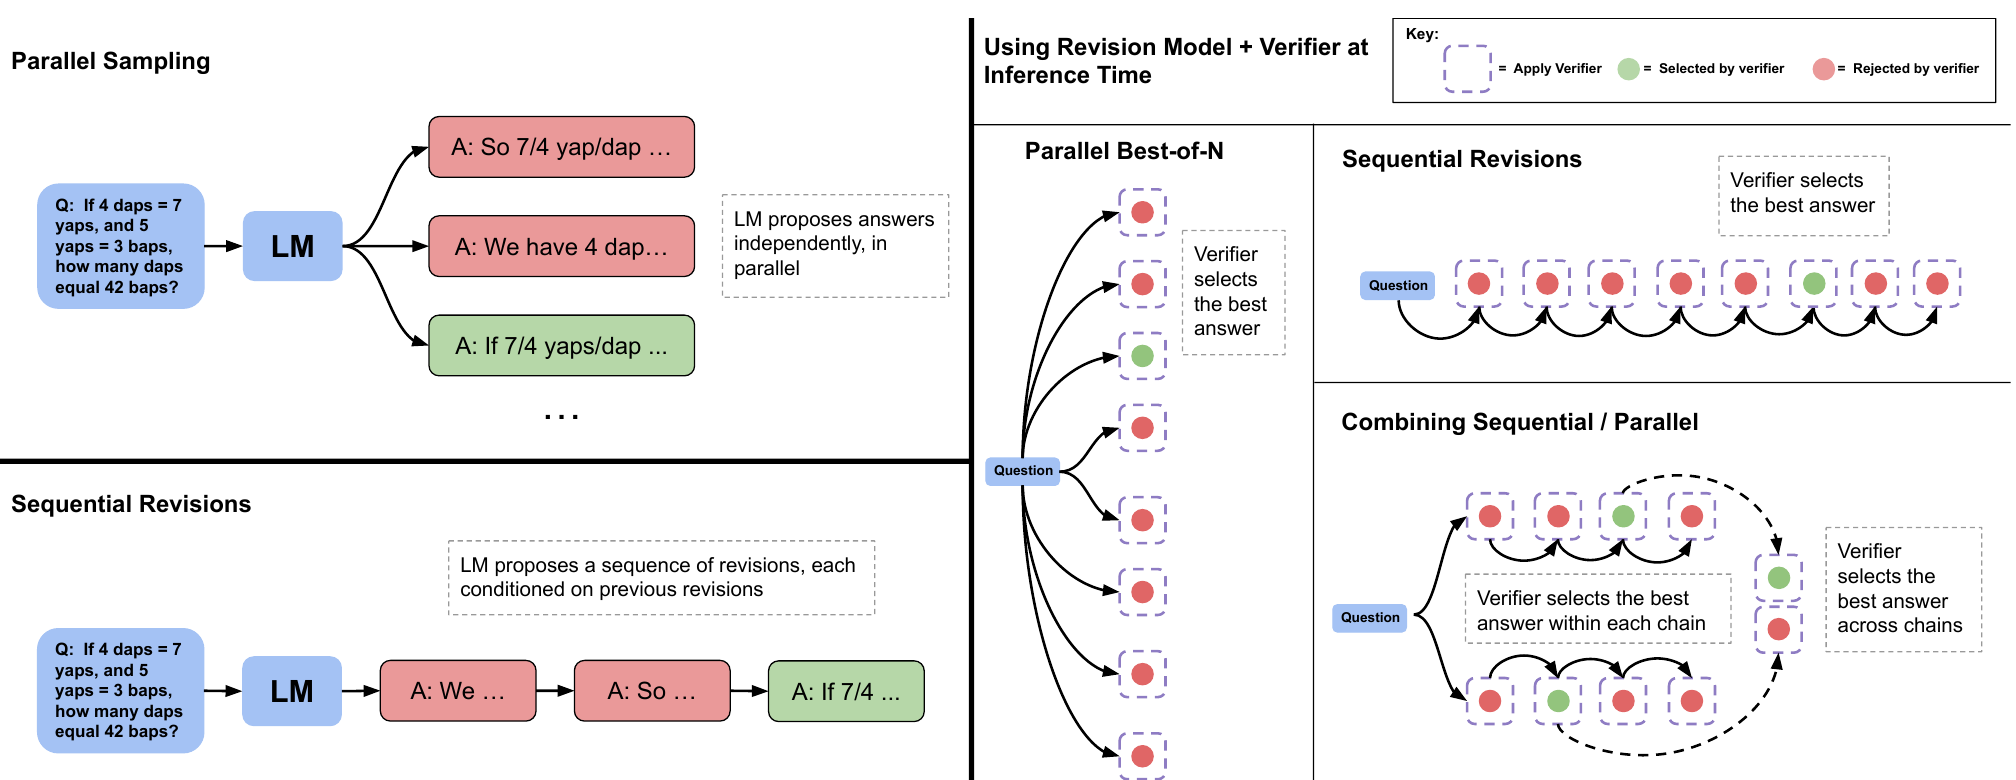
Demander simplement à un modèle existant de corriger ses propres erreurs ne sert presque à rien sur les problèmes de raisonnement ; les auteurs fine-tunent donc un modèle spécialisé dans la révision des réponses.
Données d'entraînement : l'idéal serait une suite de mauvaises réponses suivie d'une bonne, la bonne réponse étant de préférence obtenue en corrigeant les erreurs précédentes plutôt qu'en repartant de zéro. Produire des dialogues à plusieurs tours, tour après tour, coûte trop cher ; les auteurs échantillonnent plutôt 64 réponses en parallèle, puis les assemblent après coup en données à plusieurs tours, en plaçant devant chaque bonne réponse de 0 à 4 mauvaises réponses (nombre tiré au hasard). Pour choisir les mauvaises réponses, ils privilégient, d'après la distance d'édition au niveau des caractères, celles qui sont proches de la bonne réponse, pour que le modèle apprenne à corriger plutôt qu'à réécrire.
Inférence : le modèle n'a été entraîné qu'avec au plus 4 réponses précédentes, mais à l'inférence, il peut continuer à réviser indéfiniment, en ne gardant que les 4 plus récentes comme contexte. Plus le nombre de révisions augmente, plus le taux de réussite d'une seule tentative monte, et il continue de progresser au-delà de 4 révisions.
Il y a pourtant un effet secondaire. À l'entraînement, toutes les réponses précédentes sont fausses ; à l'inférence, une bonne réponse peut déjà figurer parmi elles, et le modèle « corrige » quand même. Environ 38 % des bonnes réponses deviennent fausses à la révision suivante. On ne peut donc pas se contenter de prendre la dernière réponse ; il faut choisir dans toute la chaîne de révisions, par vote majoritaire ou avec un vérificateur.
Discussion
Recherche : utile à petit budget, nuisible sur les problèmes trop simples
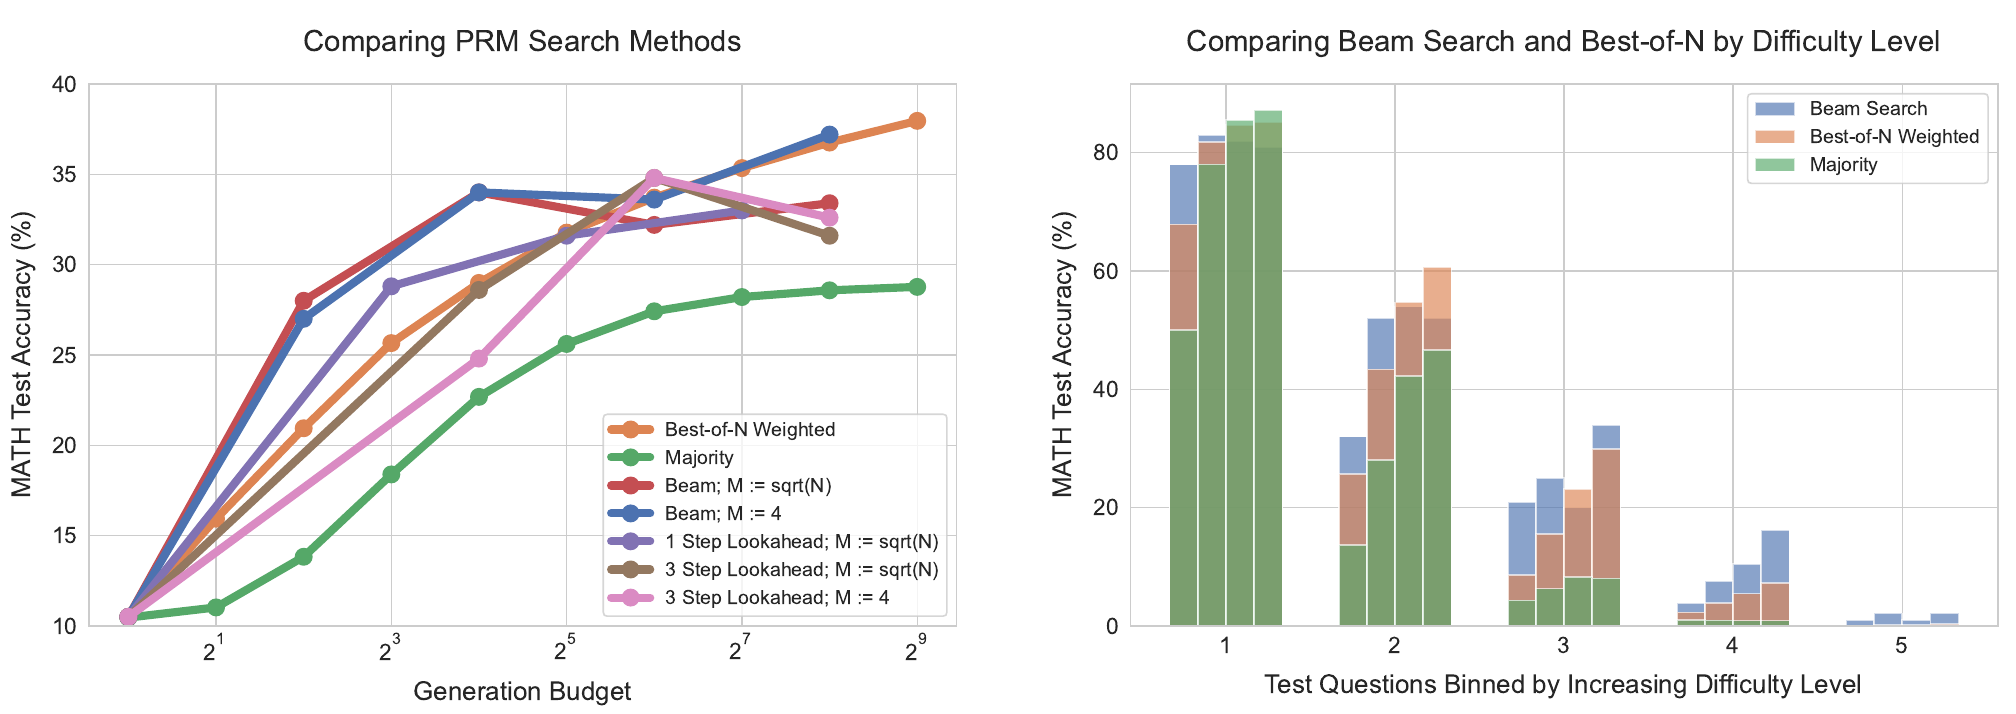
À petit budget, la recherche en faisceau l'emporte nettement sur le best-of-N ; quand le budget grandit, l'avantage disparaît, et la recherche en faisceau fait même souvent moins bien que le best-of-N. La recherche par anticipation fait le plus souvent moins bien à budget égal.
Les auteurs y voient une exploitation des failles du PRM. Plus la recherche est puissante, plus elle trouve facilement des solutions très bien notées par le PRM mais inutiles, par exemple des solutions qui répètent à la fin des étapes sans contenu, ou qui se réduisent à une ou deux étapes. La méthode de recherche la plus puissante finit par donner les moins bons résultats.
Découpés par difficulté, les résultats montrent des tendances tout à fait différentes :
- Problèmes faciles : le modèle écrit déjà facilement une bonne réponse, et le vérificateur juge en général correctement. Optimiser fort avec une recherche en faisceau ne fait qu'amplifier les caractéristiques trompeuses apprises par le vérificateur ; plus le budget est grand, pire c'est.
- Problèmes intermédiaires : le modèle a du mal à trouver la bonne réponse du premier coup ; la recherche peut l'y guider, et la recherche en faisceau reste toujours au-dessus du best-of-N.
- Problèmes les plus difficiles : aucune méthode ne progresse nettement.
En choisissant la meilleure méthode de recherche selon la difficulté, à petit budget, 16 échantillons suffisent pour approcher le score du best-of-N à 64 échantillons, soit près de 4 fois moins de calcul.
Révision : réviser encore et encore sur les problèmes faciles, ouvrir plusieurs chemins sur les difficiles
À nombre d'échantillons égal, la révision séquentielle fait légèrement mieux que l'échantillonnage parallèle. Mais leurs points forts diffèrent ; l'échantillonnage parallèle s'apparente à une recherche globale, qui peut essayer des approches complètement différentes, tandis que la révision séquentielle s'apparente à une correction locale, adaptée à une réponse qui va déjà à peu près dans la bonne direction.
Les auteurs consacrent donc une partie du budget au parallèle et une partie au séquentiel, en balayant différentes proportions. Pour chaque budget, il existe une proportion optimale, qui dépend de la difficulté. Pour les problèmes faciles, mieux vaut tout consacrer à la révision séquentielle ; pour les problèmes difficiles, il faut trouver un équilibre entre parallèle et séquentiel.
En choisissant la proportion selon la difficulté, 64 échantillons suffisent pour dépasser le best-of-N à 256 échantillons ; là encore, on économise un facteur 4.
Le calcul à l'inférence peut-il remplacer un modèle plus grand ?
Dernière question. À FLOPs égaux, vaut-il mieux agrandir le modèle, ou laisser un petit modèle calculer davantage à l'inférence ?
Les auteurs utilisent l'approximation habituelle : le calcul de préentraînement vaut et celui de l'inférence , où est le nombre de paramètres. Si l'on multiplie par les paramètres du modèle, le calcul de préentraînement comme celui d'inférence est multiplié par . Si l'on consacre plutôt ce calcul à l'inférence d'un petit modèle, la quantité d'inférence peut être multipliée par :
Le facteur dépend du rapport entre le nombre de tokens d'inférence et le nombre de tokens de préentraînement, . Face à un modèle environ 14 fois plus grand (), les auteurs testent trois valeurs de , 0.16, 0.79 et 22. Quand l'inférence est peu volumineuse (par exemple dans un pipeline d'entraînement par auto-amélioration), l'économie sur le préentraînement est importante, et à FLOPs égaux, le petit modèle peut faire environ 258 fois plus d'inférence ; quand inférence et préentraînement sont du même ordre, environ 63 fois ; quand l'inférence dépasse de loin le préentraînement (par exemple un service en production à grande échelle), il ne reste qu'un facteur d'environ 16.
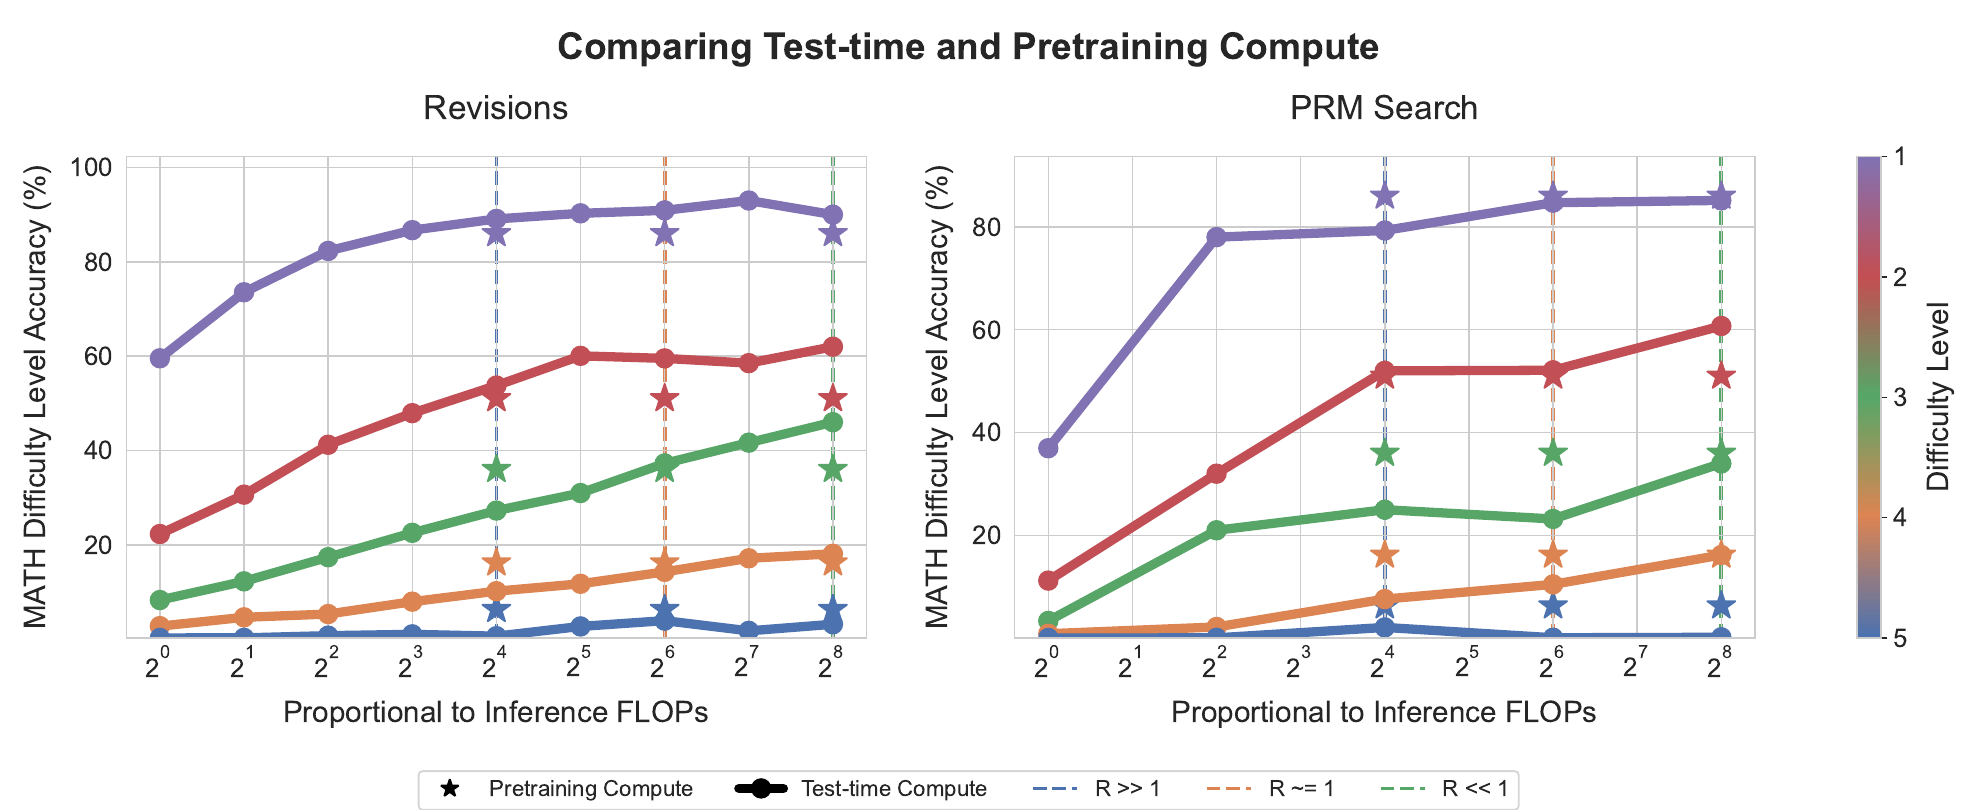
La conclusion est que les deux ne s'échangent pas un pour un. Pour les problèmes faciles et intermédiaires, ou quand la demande d'inférence est modeste, consacrer le calcul à l'inférence fait souvent mieux qu'un modèle 14 fois plus grand ; pour les problèmes très difficiles, ou quand la demande d'inférence est forte, agrandir le modèle reste plus efficace.
Limites
- Estimer la difficulté coûte cher : il faut 2 048 échantillons par problème pour le classer, et ce calcul n'est pas compté dans les expériences. Les auteurs suggèrent de faire prédire directement la difficulté par le modèle, ou d'alterner dynamiquement entre estimation de la difficulté et résolution.
- Aucun progrès sur les problèmes les plus difficiles : ni la recherche ni la révision n'aident au niveau le plus difficile.
- Pas de combinaison des méthodes : la révision est associée à un vérificateur, mais pas à la recherche arborescente avec PRM.
- Un seul cadre testé : uniquement MATH et PaLM 2-S*, et les capacités de révision et de vérification demandent chacune un fine-tuning dédié.
Les auteurs évoquent aussi la possibilité de distiller dans le modèle lui-même les réponses obtenues grâce au calcul supplémentaire à l'inférence, pour former une boucle d'auto-amélioration continue.
La suite
Un mois après la mise en ligne de cet article sur arXiv, le 12 septembre 2024, OpenAI présente o1. Entraîné par apprentissage par renforcement, o1 écrit une longue chaîne de pensée interne avant de répondre ; selon le billet d'OpenAI, ses performances progressent régulièrement avec le calcul d'entraînement (l'apprentissage par renforcement) et avec le calcul à l'inférence (le temps de réflexion). La « révision séquentielle » comparée dans cet article devient chez o1 une autovérification et une autocorrection au sein d'une même chaîne de pensée, sans qu'il faille fine-tuner à part un modèle de révision.
DeepSeek-R1 a suivi une voie semblable, en documentant explicitement l'échec, chez eux, du PRM et du MCTS.
L'idée d'allouer le calcul à l'inférence selon la difficulté a, elle, été poussée encore plus loin. En février 2025, Can 1B LLM Surpass 405B LLM? montre qu'avec la stratégie optimale à l'inférence, un modèle de 1B peut dépasser un modèle de 405B sur MATH-500, et qu'un modèle de 0.5B peut dépasser GPT-4o sur MATH-500 et AIME24 ; ses auteurs constatent eux aussi que la meilleure stratégie dépend du modèle utilisé, du PRM et de la difficulté des problèmes.
Quant à la façon d'amener un modèle, avec un minimum d'entraînement, à réfléchir de lui-même plus longtemps dans une même chaîne de pensée, voyez s1.
Conclusion
Il n'existe pas de recette universelle pour dépenser le calcul à l'inférence. Sur les problèmes faciles, il faut laisser le modèle réviser ses propres réponses, car une recherche agressive amplifie au contraire les erreurs du vérificateur ; sur les problèmes intermédiaires, la recherche est la plus efficace ; sur les plus difficiles, aucune méthode actuelle n'aide. Une allocation selon la difficulté permet d'économiser jusqu'à un facteur 4 en calcul.
Face à un modèle 14 fois plus grand, consacrer le même calcul à l'inférence fait souvent mieux sur les problèmes faciles et intermédiaires, alors que les problèmes difficiles demandent toujours un modèle plus grand. Calcul d'inférence et calcul de préentraînement ne s'échangent pas un pour un.
Dans leur introduction, les auteurs écrivent que cela laisse entrevoir un avenir où l'on dépenserait un peu moins au préentraînement et un peu plus à l'inférence. Un mois plus tard sortait o1, et le calcul à l'inférence devenait le terrain de la compétition, par un chemin plus direct encore que celui qu'imaginait l'article ; au lieu de greffer de l'extérieur une recherche et un vérificateur, on apprend au modèle à réfléchir lui-même un peu plus longtemps.