Article original
STaR: Bootstrapping Reasoning With Reasoning
- Publication
- NeurIPS 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2203.14465
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningstar2022,
  title = {{STaR: Bootstrapping Reasoning With Reasoning}},
  author = {Eric Zelikman and Yuhuai Wu and Jesse Mu and Noah D. Goodman},
  year = {2022},
  eprint = {2203.14465},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.14465}
}
Début 2022, bien des indices montraient déjà qu'un modèle répond mieux quand il écrit son raisonnement avant la réponse. Mais comment apprendre au modèle à écrire ce raisonnement ?
Deux voies existaient alors. La première consiste à préparer un grand jeu d'entraînement dont chaque exemple est accompagné de son raisonnement, puis à fine-tuner. Soit des humains rédigent ces raisonnements un par un, comme dans CoS-E, le jeu d'explications humaines de CommonsenseQA ; soit on les génère automatiquement à partir de gabarits, ce qui ne marche que pour des problèmes dont la solution est connue et se laisse écrire sous forme de règles.
La seconde est le prompting par chaîne de pensée ; on place dans le prompt quelques exemples accompagnés de leur raisonnement, sans aucun entraînement. C'est bon marché, mais en général moins efficace qu'un modèle entraîné sur beaucoup de données à « ne sortir que la réponse ». Avec GPT-J 6B, le modèle utilisé dans cet article, la chaîne de pensée few-shot n'obtient que 36.6 % sur CommonsenseQA, contre 60.0 % pour un fine-tuning qui fait sortir directement la réponse.
Zelikman et al., à Stanford, cherchent une voie intermédiaire. Ils ne préparent qu'une dizaine d'exemples avec raisonnement, plus un grand nombre de questions qui n'ont qu'une réponse, sans raisonnement, et laissent le modèle écrire lui-même les raisonnements sur lesquels il va s'entraîner.
Définir le problème
On dispose d'un modèle préentraîné , d'un jeu de données qui ne contient que des questions et des réponses, et d'un petit ensemble d'exemples avec raisonnement , soit environ 10 exemples.
L'objectif est d'entraîner un modèle qui écrit d'abord un raisonnement , puis une réponse , et qui soit plus précis qu'un modèle qui ne sort que la réponse.
Toute la méthode repose sur l'hypothèse qu'un raisonnement qui mène à la bonne réponse est de meilleure qualité qu'un raisonnement qui mène à une mauvaise. Ce n'est pas toujours vrai, nous y reviendrons.
Résoudre le problème
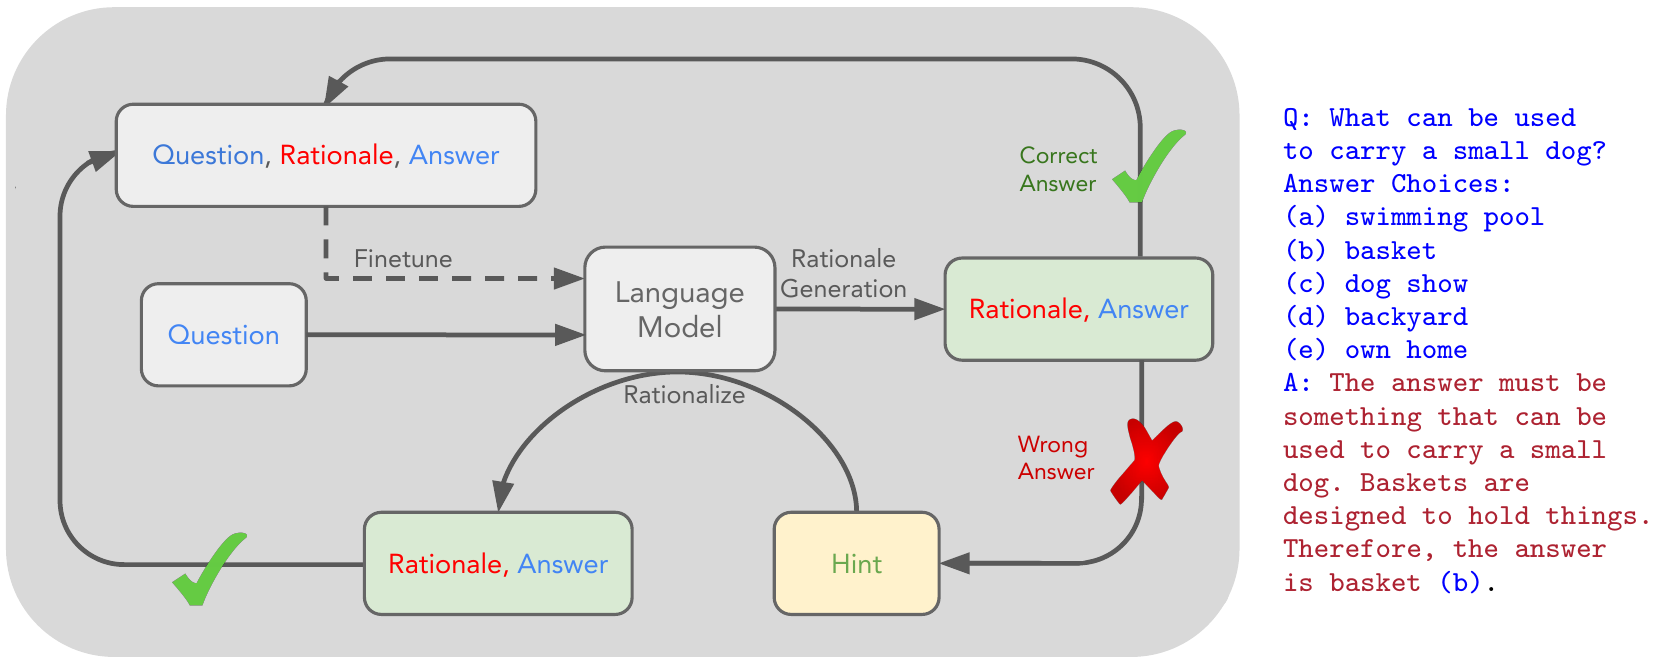
Écrire ses propres raisonnements, ne garder que les bons
La première étape est simple. Avec la dizaine d'exemples comme prompt, on demande au modèle d'écrire un raisonnement et une réponse pour chaque question du jeu de données. Si la réponse correspond à la réponse de référence, on la garde avec son raisonnement ; sinon, on la jette.
On fine-tune ensuite le modèle sur les données conservées, puis le modèle fine-tuné répond à nouveau à toutes les questions ; on filtre, on fine-tune, et l'on recommence jusqu'à ce que les scores cessent de progresser.
Chaque tour de fine-tuning repart du modèle préentraîné d'origine plutôt que du modèle du tour précédent, pour éviter le surapprentissage. Le premier tour ne compte que 40 pas d'entraînement, puis ce nombre augmente de 20 % à chaque tour ; les auteurs ont constaté qu'un entraînement plus lent au départ donne de meilleurs résultats au final.
Pour les problèmes ratés, on montre la réponse
Ne garder que les réussites a un défaut évident. Les problèmes que le modèle ne sait pas résoudre n'entrent jamais dans les données d'entraînement ; une fois qu'il a appris tout ce qu'il savait déjà faire, il n'a plus rien de nouveau à apprendre.
La parade des auteurs s'appelle la rationalization. Pour les problèmes ratés, on donne directement la bonne réponse au modèle dans le prompt, et on lui demande d'écrire le raisonnement :
Q: Where do you put your grapes just before checking out?
Answer Choices:
(a) mouth
(b) grocery cart (CORRECT)
(c) super market
(d) fruit basket
(e) fruit market
A: The answer should be the place where grocery items are placed before
checking out. Of the above choices, grocery cart makes the most sense for
holding grocery items. Therefore, the answer is grocery cart (b).
Exemple de prompt de la Figure 2 de l'article ; « (CORRECT) » est l'indice donné au modèle.
Quand on connaît la réponse, il est bien plus facile de remonter à une justification qui tient debout. Ensuite, quand ce raisonnement rejoint les données d'entraînement, l'indice est retiré ; en entrée, il ne reste que la question d'origine, comme si le modèle avait trouvé le raisonnement tout seul.
Ainsi, même les problèmes difficiles que le modèle ne savait pas résoudre entrent dans les données d'entraînement, qui grossissent d'autant.
L'algorithme complet comporte deux boucles imbriquées :
- Avec le modèle courant , écrire un raisonnement et une réponse pour chaque question.
- Pour les questions ratées, ajouter la bonne réponse comme indice et recommencer.
- Garder les réponses justes de l'étape 1, ainsi que celles de l'étape 2 qui aboutissent à la bonne réponse grâce à l'indice.
- Repartir du modèle d'origine et le fine-tuner sur ces données pour obtenir , puis revenir à l'étape 1.
En réalité, c'est de l'apprentissage par renforcement
Les auteurs font remarquer que STaR peut se voir comme une approximation de l'apprentissage par renforcement. Si l'on traite le raisonnement comme une variable latente, avec une récompense de 1 pour une bonne réponse et de 0 pour une mauvaise, la récompense espérée sur tout le jeu de données et son gradient s'écrivent :
C'est le gradient de politique standard. Pour un échantillon faux, la récompense vaut 0 et le gradient disparaît, ce qui correspond au « ne garder que les bonnes réponses » de STaR ; pour un échantillon juste, le gradient est celui de la log-vraisemblance ordinaire, ce qui revient à un fine-tuning supervisé sur cet échantillon.
Par rapport à un vrai gradient de politique, STaR fait deux simplifications. Il remplace l'échantillonnage aléatoire par le décodage glouton, ce qui réduit la variance au prix d'une exploration moindre, et il enchaîne de nombreux pas de gradient sur le même lot de données. La rationalization, elle, revient à échantillonner selon une autre distribution, , autrement dit à faire une estimation hors politique (off-policy).
À l'époque, cette dérivation n'était qu'une remarque en passant ; elle est pourtant devenue plus tard un angle commode pour comprendre l'entraînement des modèles de raisonnement.
Dispositif expérimental
- Modèle : GPT-J 6B, parce que ses poids et son code de fine-tuning sont publics, et qu'il est assez grand pour écrire des raisonnements d'une qualité correcte. Les lots comptent 8 séquences de longueur 1024, le taux d'apprentissage est de , et l'entraînement comme l'échantillonnage tournent sur un nœud TPU v3.
- Addition : additionner deux nombres de chiffres, en écrivant l'addition chiffre par chiffre au format scratchpad de Nye et al. On génère d'abord 50 000 problèmes, et l'on en tire 10 000 à chaque tour ; chaque longueur, de 1 à 5 chiffres, a 10 exemples.
- CommonsenseQA : questions de sens commun à cinq choix, avec 9 741 questions dans le jeu d'entraînement. Le prompt reprend les 10 questions de l'article sur la chaîne de pensée ; les auteurs y corrigent une réponse fausse et font en sorte que les raisonnements citent plus explicitement les connaissances utiles.
- GSM8K : problèmes de mathématiques de niveau primaire, 7 473 dans le jeu d'entraînement et 1 319 dans le jeu de test.
Pour l'addition, le raisonnement suit le format de la Figure 3 de l'article ; on additionne chiffre par chiffre en partant des unités, et C est la retenue. Par exemple, pour 624 + 259 :
<scratch>
6 2 4 + 2 5 9 , C: 0
2 + 5 , 3 C: 1
6 + 2 , 8 3 C: 0
, 8 8 3 C: 0
0 8 8 3
</scratch>
8 8 3
Chaque ligne donne la prochaine paire de chiffres à additionner, le résultat accumulé jusque-là et la retenue. Le modèle doit apprendre à écrire lui-même tout ce qui va de <scratch> à la réponse finale ; pour la rationalization, la bonne réponse est placée dans le prompt après « Target: ».
Dans ce format, raisonnement et réponse sont étroitement liés ; une seule étape fausse, et la réponse est presque toujours fausse. Ce point aura son importance plus loin.
Discussion
Addition : grimper un chiffre à la fois
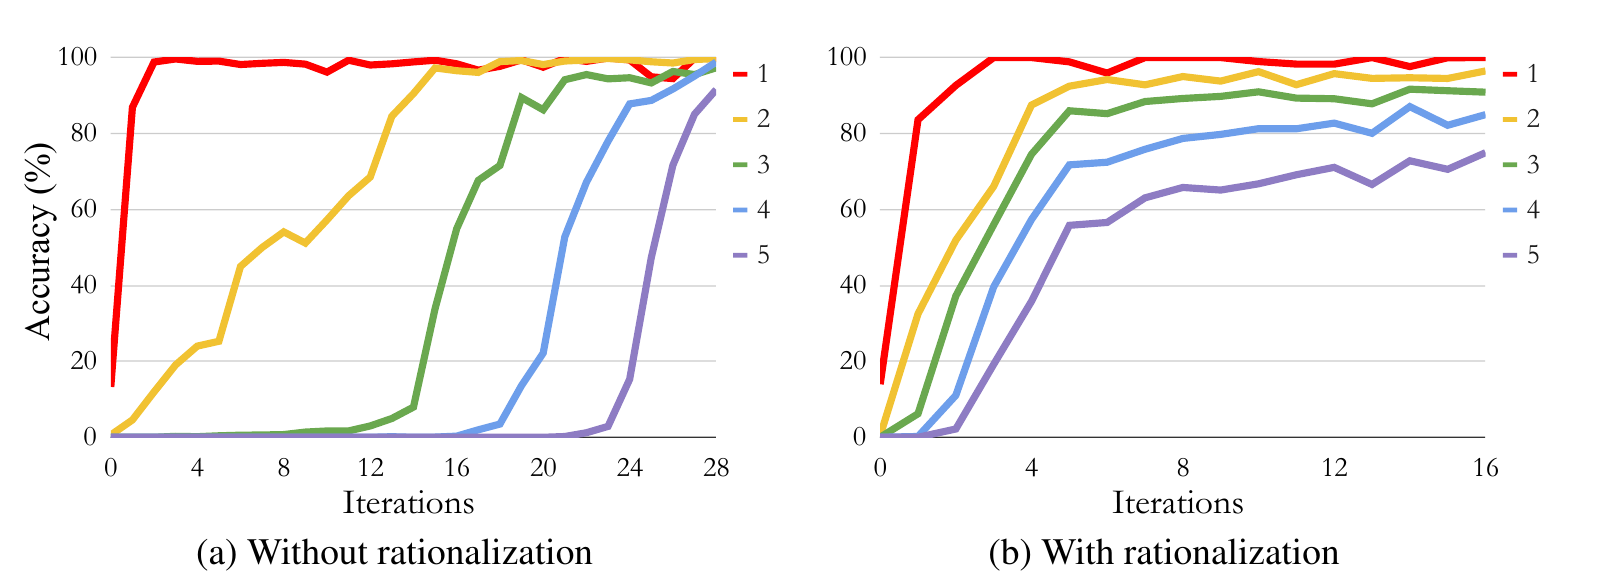
Le point de départ est très bas. En prompting few-shot, GPT-J résout moins de 1 % des additions à deux chiffres, et presque aucune au-delà.
Sans rationalization (à gauche), la progression se fait par paliers. Le modèle doit d'abord maîtriser les nombres à chiffres avant de commencer à progresser sur ceux à chiffres ; pour 5 chiffres, il faut attendre la 23e itération environ. C'est logique, puisque seuls les problèmes réussis entrent dans les données d'entraînement ; le modèle doit d'abord réussir de temps en temps quelques additions à chiffres pour avoir de quoi apprendre.
Avec rationalization (à droite), toutes les longueurs progressent presque ensemble, avec des précisions différentes. Après un seul tour de fine-tuning, les additions à deux chiffres passent de moins de 1 % à 32 %. Comme l'indice permet de résoudre beaucoup de problèmes dès le prompting few-shot, cette configuration commence l'entraînement à 300 pas et en ajoute 20 à chaque tour.
L'article rapporte une précision globale de 89.5 % après 16 itérations. À titre de comparaison, un modèle entraîné pendant 5 000 pas sur 10 000 problèmes, sans raisonnement, atteint 76.3 %.
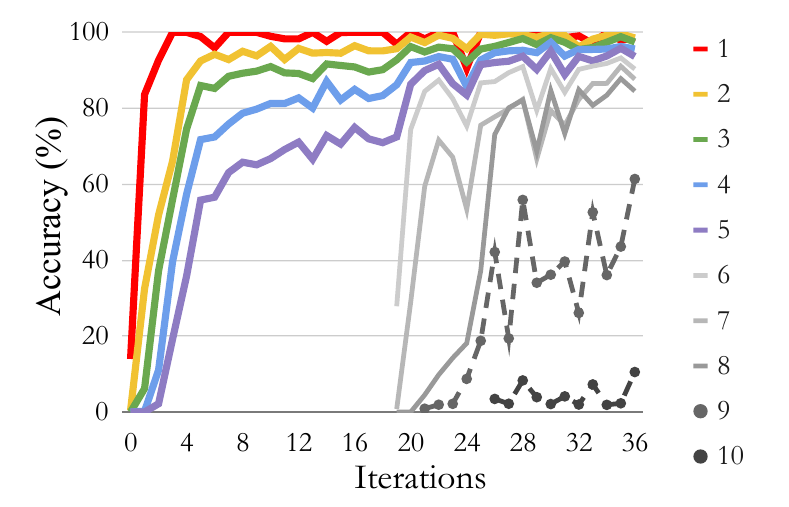
Les auteurs ajoutent aussi, vers la 20e itération, des problèmes avec plus de chiffres, sans changer le nombre total de problèmes d'entraînement. Contre toute attente, les additions de 1 à 5 chiffres progressent alors encore plus vite, et le modèle résout même une partie des problèmes à 9 et 10 chiffres, qu'il n'a jamais vus à l'entraînement. En contrepartie, l'entraînement devient instable, sans que les auteurs sachent bien expliquer pourquoi.
CommonsenseQA : un 6B au niveau d'un 175B
| Méthode | Précision | Données utilisées |
|---|---|---|
| GPT-3 175B fine-tuné, réponse directe | 73.0 | 100% |
| GPT-J few-shot, réponse directe | 20.9 | env. 0 |
| GPT-J, chaîne de pensée few-shot | 36.6 | env. 0 |
| LaMDA 137B, chaîne de pensée few-shot | 55.6 | env. 0 |
| GPT-J fine-tuné, réponse directe | 60.0 | 100% |
| STaR (sans rationalization) | 68.8 | 69.7% |
| STaR (avec rationalization) | 72.5 | 86.7% |
D'après la Table 1 de l'article ; précision en % sur le jeu de validation. Sur les 86.7 % de la dernière ligne, 78.2 % viennent de questions que le modèle a résolues lui-même et 8.5 % de la rationalization.
Quelques comparaisons valent la peine dans ce tableau :
- Avec les seuls raisonnements écrits par GPT-J lui-même, on gagne 8.8 points sur le fine-tuning direct qui utilise toutes les données, alors que STaR n'utilise qu'environ 70 % des questions.
- Avec la rationalization, on atteint 72.5 %, à 0.5 point seulement des 73.0 % de GPT-3 fine-tuné, un modèle près de 30 fois plus grand.
- La chaîne de pensée few-shot du petit modèle plafonne à 36.6 % ; STaR la dépasse de 35.9 points, et fait aussi mieux que la chaîne de pensée few-shot de LaMDA 137B.
Sur des questions à cinq choix, répondre au hasard donne déjà 20 %, et les auteurs notent que de simples heuristiques, comme la similarité sémantique, suffisent pour atteindre environ 30 %.
Autre constat, inclure aussi les quelques exemples few-shot dans les séquences d'entraînement pendant le fine-tuning améliore nettement les scores, de 60.9 % à 68.8 % sans rationalization et de 69.9 % à 72.5 % avec.
La qualité des raisonnements
Pour l'addition, on peut comparer directement le raisonnement à la procédure de référence ; pour le sens commun, seul un humain peut juger. Les auteurs tirent au hasard 50 questions auxquelles la chaîne de pensée few-shot et STaR ont toutes deux bien répondu, et y joignent les explications rédigées par des humains dans CoS-E. Ils confient ensuite 10 questions à chacun de 20 travailleurs du crowdsourcing, qui classent les trois types de raisonnement.
Les raisonnements de STaR ont 30 % de chances en plus d'être classés devant ceux du prompting few-shot (), et 74 % de chances en plus d'être classés devant les explications humaines (). Les auteurs précisent que ce résultat reflète surtout la difficulté d'obtenir d'humains des explications de qualité ; le modèle n'écrit pas encore ses raisonnements au niveau d'un humain.
Une bonne réponse peut cependant s'appuyer sur un raisonnement creux. L'annexe recense plusieurs types de raisonnements qui ne tiennent pas debout malgré une réponse juste ; le plus courant consiste à reformuler la question et à présenter cette reformulation comme une justification :
Q: What might someone get from learning about science?
Answer Choices:
(a) headache
(b) see things differently
(c) increased knowledge
(d) accidents
(e) appreciation of nature
A: The answer must be something that someone would get from learning about
science. Learning about science would increase knowledge. Therefore, the
answer is increased knowledge (c).
Exemple tiré de l'annexe A.1 de l'article.
« Apprendre les sciences augmente les connaissances, donc la réponse est l'augmentation des connaissances » ; ce n'est pas faux, mais cela n'explique pas pourquoi la réponse n'est pas « appreciation of nature ». Parmi les autres types, on trouve le raisonnement circulaire, l'absence pure et simple de justification, ou encore le fait de traiter un prénom de l'énoncé comme une personne réelle, avec des raisonnements du genre « James s'enthousiasme quand il est en hauteur ».
GSM8K : des scores absolus très bas, mais doublés
| Méthode | Précision (test) | Données utilisées |
|---|---|---|
| GPT-J few-shot, réponse directe | 3.0 | env. 0 |
| GPT-J, chaîne de pensée few-shot | 3.1 | env. 0 |
| GPT-J fine-tuné, réponse directe | 5.8 | 100% |
| STaR (sans rationalization) | 10.1 | 25.0% |
| STaR (avec rationalization) | 10.7 | 28.7% |
D'après la Table 2 de l'article ; valeurs en %.
Les maths de primaire donnent du fil à retordre à GPT-J 6B ; STaR ne monte qu'à 10.7 %, mais c'est presque le double des 5.8 % du fine-tuning direct, avec environ un quart des questions seulement. Ici, la rationalization n'aide presque pas ; sur les 28.7 % de données utilisées, 0.5 % seulement viennent de la rationalization. Il a aussi fallu plafonner le nombre de pas d'entraînement, faute de quoi l'entraînement aurait été trop long ; au final, STaR a tourné 36 itérations, plus 10 itérations avec rationalization.
Les auteurs comparent le nombre d'étapes de calcul du modèle et de la solution de référence ; ils coïncident dans 53 % à 57 % des cas. Quand ils diffèrent, le modèle en utilise généralement moins. Parfois il saute des étapes, parfois il trouve une autre solution ; l'annexe montre un problème dont la solution de référence compte 7 étapes, et que le modèle, en ignorant les informations superflues, résout en une seule.
Pourquoi ne pas simplement échantillonner davantage
Pour agrandir les données d'entraînement, l'idée la plus intuitive est d'augmenter la température et d'échantillonner plusieurs fois ; il y aura bien quelques bonnes réponses. Les auteurs ont essayé, et c'est pire.
Dès que la température monte, les échantillons « raisonnement faux, mais réponse juste par chance » se multiplient, et un modèle entraîné sur ce genre de données n'apprend rien qui se généralise. C'est particulièrement visible sur l'addition ; les scratchpads appris par échantillonnage à haute température perdent peu à peu tout sens, et le modèle se retrouve bloqué. Avec une température de 0.5 ou 0.7, les résultats sont systématiquement moins bons que ceux de STaR sans rationalization. En outre, échantillonner 10 fois est environ 10 fois plus lent, ce qui coûte bien plus cher que la rationalization.
La part des « bonnes réponses par chance » dépend beaucoup de la probabilité de deviner juste selon le type de question. Si une proportion des raisonnements du modèle est réellement correcte, et qu'un raisonnement faux a encore une probabilité de tomber sur la bonne réponse, alors, parmi les données qui passent le filtre « réponse juste », la part de raisonnements en réalité faux vaut
Pour une addition à plusieurs chiffres, deviner la réponse est quasi impossible ; est proche de 0, et le filtre est très propre. Pour CommonsenseQA, à cinq choix, si l'on prend , la probabilité d'une réponse au hasard, environ 64 % des données conservées sont des réussites par chance au départ, quand ; quand monte à 0.6, on tombe à environ 12 %. Pour une question oui/non, , et c'est pire encore. La proportion baisse à mesure que le modèle progresse, mais c'est au démarrage que les données sont de la plus mauvaise qualité, et c'est justement là qu'elles comptent le plus.
Limites
Les auteurs relèvent les points suivants dans leur conclusion et en annexe :
- Un point de départ pas trop faible : pour que le premier tour réussisse, les performances few-shot doivent dépasser le hasard, ce qui suppose un modèle déjà un peu capable de raisonner. Les auteurs ont essayé GPT-2, qui n'a même pas réussi à amorcer l'apprentissage sur l'addition.
- Tâches où l'on devine facilement : sur des tâches comme les questions oui/non, beaucoup de mauvais raisonnements passent le filtre, et l'on ne sait pas encore comment les écarter.
- Biais amplifiés : STaR amplifie les raisonnements « qui mènent à la bonne réponse » ; si les biais du jeu de données aident à bien répondre, ils sont amplifiés eux aussi. La rationalization peut même « extraire » du modèle des réponses biaisées qu'il n'aurait pas données spontanément.
- Raisonnement pas forcément fidèle : le modèle peut choisir sa réponse d'abord et inventer une justification ensuite ; un tel raisonnement n'a rien à voir avec ce sur quoi le modèle se fonde réellement, et STaR n'a aucun moyen de le vérifier.
- Un indice pas toujours facile à fournir : ici, l'indice est simplement la bonne réponse, mais dans d'autres contextes, la façon de le donner n'a rien d'évident.
Les auteurs envisagent aussi d'échantillonner plusieurs raisonnements à haute température, de faire voter les réponses et de prendre la réponse majoritaire comme référence, ce qui permettrait de s'entraîner même sur des questions sans réponse.
La suite
La boucle de STaR a depuis été agrandie à plusieurs reprises. En décembre 2023, ReSTEM, de Google DeepMind, applique la même démarche à PaLM 2, sur MATH et sur les problèmes de programmation d'APPS ; on échantillonne, on filtre selon la justesse de la réponse, on fine-tune, et l'on répète sur quelques tours. Les auteurs la redérivent sous l'angle de l'espérance-maximisation (EM), et le résultat dépasse un fine-tuning sur les seules données écrites par des humains.
En mars 2024, les auteurs de STaR proposent eux-mêmes Quiet-STaR, qui transpose le « réfléchir avant de parler » au préentraînement ; sur du texte web ordinaire, le modèle produit après chaque token un court raisonnement interne qui l'aide à prédire la suite. Après un préentraînement prolongé sur OpenWebMath et C4, Mistral 7B passe, sans aucun fine-tuning sur la tâche, de 5.9 % à 10.9 % sur GSM8K et de 36.3 % à 47.2 % sur CommonsenseQA.
Quant à la dérivation par gradient de politique, elle est devenue un véritable apprentissage par renforcement chez les modèles de raisonnement. Les récompenses de DeepSeek-R1 sont précisément des règles du type « la réponse est-elle juste ? » ; après l'apprentissage par renforcement, pour collecter des données de fine-tuning supervisé, il échantillonne plusieurs réponses par prompt et ne garde que les bonnes, soit environ 600 000 exemples de raisonnement au total. C'est le même filtrage que celui de STaR, à une échelle supérieure de plusieurs ordres de grandeur.
Conclusion
Avec seulement 10 exemples accompagnés de leur raisonnement et un lot de questions qui n'ont que leur réponse, STaR amène GPT-J 6B à écrire lui-même des milliers de raisonnements pour s'entraîner. Il obtient 72.5 % sur CommonsenseQA, à 0.5 point seulement de GPT-3 fine-tuné directement, un modèle près de 30 fois plus grand.
Le plus astucieux, c'est la rationalization. Pour les questions qu'il ne sait pas résoudre, on donne la réponse au modèle, on le laisse remonter jusqu'à une justification, puis on cache la réponse à l'entraînement ; les problèmes difficiles entrent ainsi dans les données, et toutes les longueurs d'addition progressent ensemble, sans attendre palier après palier.
Sa faiblesse est tout aussi claire, puisque le filtre ne regarde que la réponse. Sur les questions où l'on devine facilement, plus de la moitié des raisonnements conservés peuvent avoir été bricolés, et l'article, jusqu'au bout, ne résout pas ce problème. Les modèles de raisonnement qui ont suivi ont fait tourner cette boucle de plus en plus grand, avec des modèles plus gros, plus d'échantillons et des vérifications plus strictes ; le problème initial, lui, est toujours là.